
ระบบล่มเป็นวงกว้าง กระทบบริการหลัก
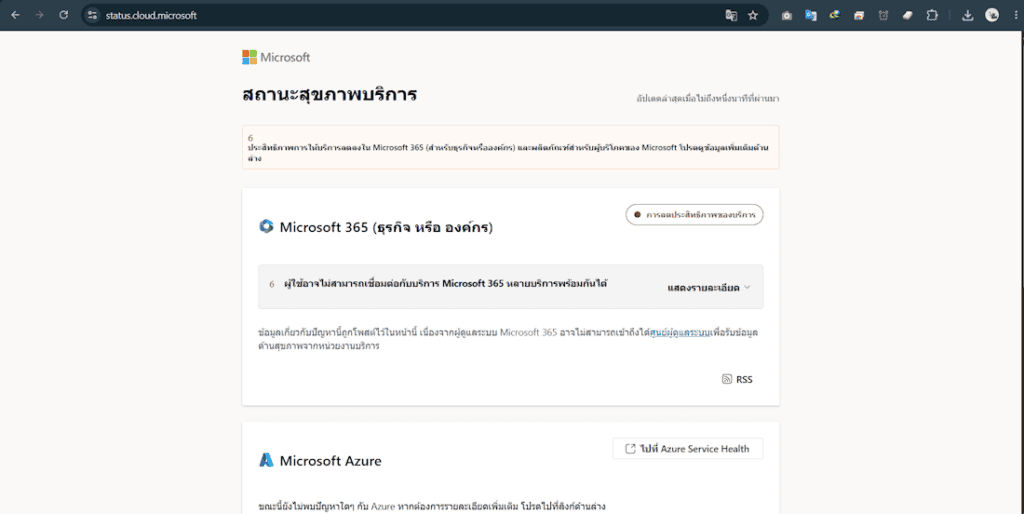
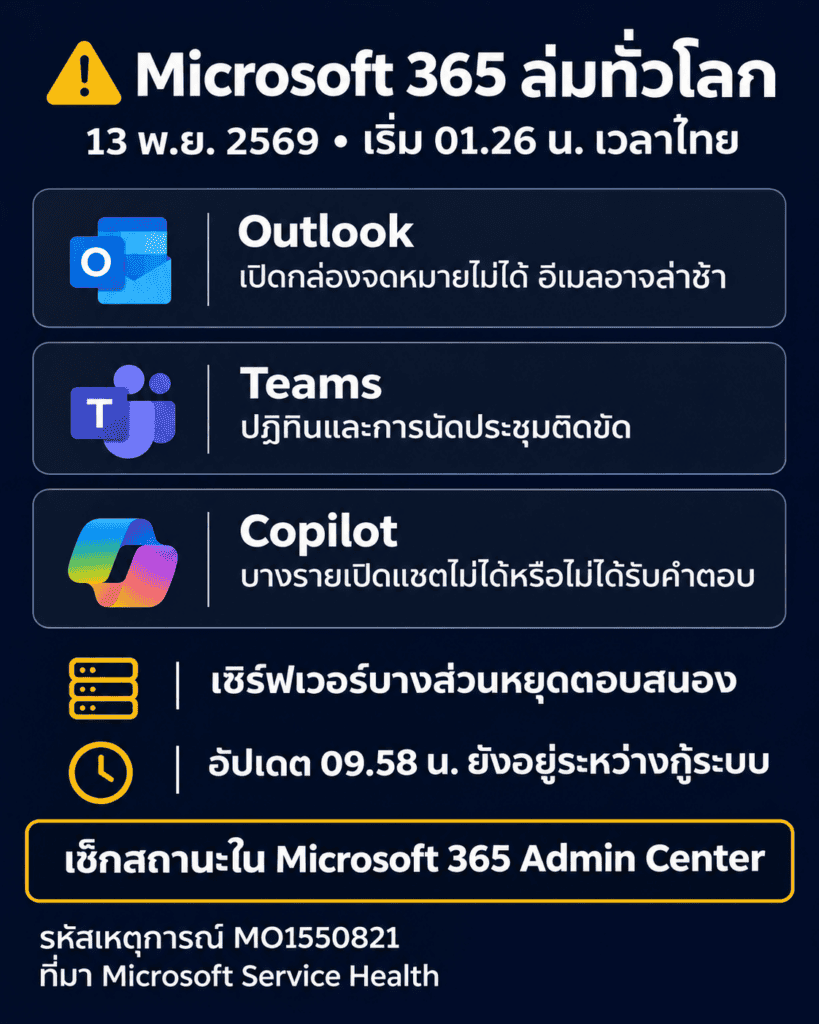
Microsoft 365 ล่ม คือเหตุขัดข้องของบริการคลาวด์และแอปทำงานจาก Microsoft ที่ทำให้ผู้ใช้บางส่วนเข้าอีเมล ประชุมออนไลน์ และเครื่องมือช่วยงานไม่ได้หรือใช้งานติดขัดพร้อมกัน โดยเหตุครั้งนี้เริ่มเมื่อเวลา 01.26 น. วันที่ 13 พฤศจิกายน และกระทบผู้ใช้หลายภูมิภาค
ผลกระทบไม่ได้หยุดอยู่ที่แอปเดียว เพราะ Outlook, Teams และ Copilot รวมถึง OneDrive และ Azure ต่างถูกรายงานว่ามีปัญหาในช่วงเดียวกัน รายงานปัญหา Outlook บน Downdetector พุ่งสูงสุดกว่า 138,000 ครั้ง ตัวเลขนี้นับรายงานที่ระบบติดตามได้รับ ไม่ใช่จำนวนผู้ใช้ที่ได้รับผลกระทบทั้งหมด ภาพรวมจึงชี้ให้เห็นความเสี่ยงของการพึ่งพาระบบคลาวด์ร่วมกัน เมื่อโครงสร้างพื้นฐานส่วนหนึ่งสะดุด ผลกระทบย่อมลามไปถึงงานประจำวันและการทำงานขององค์กร
อีเมล ประชุม และ Copilot ทำงานผิดปกติ
สำหรับผู้ใช้ทั่วไป อาการที่เห็นชัดคือ Outlook ใช้งานไม่ได้ในบางช่องทาง ผู้ใช้บางรายเปิดกล่องจดหมายผ่านเว็บหรือแอปเดสก์ท็อปไม่สำเร็จ และอีเมลอาจส่งถึงช้ากว่าปกติ ต่อมาในรายงานเวลา 11.59 น. ยังมีผู้ใช้บางส่วนเข้า Exchange Online รวมถึง Outlook บนเว็บไม่ได้ จึงไม่ควรตีความว่าการกู้ระบบช่วงแรกหมายถึงบริการกลับมาปกติแล้ว
Teams ขัดข้องในส่วนปฏิทิน การสร้างหรือแก้ไขนัด และการส่งคำเชิญประชุม แต่การเข้าร่วมประชุมและแชตกลุ่มส่วนใหญ่ยังใช้ได้ตามรายงานของ Microsoft ส่วนผู้ใช้ Copilot Chat บางรายเปิดบริการหรือรับคำตอบไม่ได้ และระบบอาจดึงข้อมูลจากอีเมล ปฏิทิน หรือไฟล์งานไม่สำเร็จ ปัญหาเหล่านี้ทำให้ความต่อเนื่องของงานสะดุด แม้บางฟังก์ชันยังพอใช้ทดแทนกันได้
เซิร์ฟเวอร์หยุดทำงาน จุดชนวนภาระโหลดลูกโซ่
คำอธิบายจาก Microsoft ระบุว่าเซิร์ฟเวอร์บางส่วนหยุดให้บริการกะทันหัน เครื่องที่ยังทำงานจึงต้องรองรับการเชื่อมต่อเพิ่มขึ้น ขณะที่กระบวนการสร้างการเชื่อมต่อแบบปลอดภัยบนเซิร์ฟเวอร์ที่มีปัญหารับภาระมากจนหยุดตอบสนอง กลไกที่ควรช่วยให้บริการเชื่อมต่อกันได้จึงกลายเป็นจุดเปราะบางซ้ำเติมเหตุขัดข้อง
เมื่อกำลังรองรับหายไป โครงสร้างพื้นฐานที่เหลือต้องรับปริมาณการเชื่อมต่อมากขึ้นจนเกิดโอเวอร์โหลด และบริการที่ใช้ระบบเบื้องหลังร่วมกันก็ได้รับผลกระทบต่อเนื่อง รายงานระบุว่าปริมาณการใช้งานที่เพิ่มขึ้นไม่ใช่สาเหตุโดยตรงของเหตุครั้งนี้ แต่เป็นภาระที่เกิดหลังเซิร์ฟเวอร์บางส่วนหยุดทำงาน การแยกสาเหตุสองส่วนนี้สำคัญ เพราะชี้ว่าการฟื้นฟูต้องแก้ทั้งกำลังประมวลผลและการกระจายการเชื่อมต่อ ไม่ใช่เพียงรับมือจำนวนผู้ใช้ที่มากขึ้น
ทยอยกู้ระบบ แต่ยังไม่มีเวลาฟื้นตัวครบทุกบริการ
Microsoft พยายามกู้ระบบด้วยการย้ายการเชื่อมต่อไปยังระบบสำรอง เปลี่ยนเส้นทางการรับส่งข้อมูล เพิ่มทรัพยากรให้เครื่องเสมือน และทยอยรีสตาร์ตเซิร์ฟเวอร์ที่ได้รับผลกระทบ บริษัทกำลังเพิ่มขีดความสามารถเพื่อลดภาระการประมวลผล พร้อมตรวจสอบสาเหตุ แต่เครื่องเสมือนบางส่วนยังรับการตั้งค่าเครือข่ายใหม่ไม่ได้ตามที่คาด จึงยังมีผู้ใช้เข้า Exchange Online ไม่ได้ในรายงานช่วงสาย
แม้เซิร์ฟเวอร์บางส่วนกลับมาเสถียร การปรับปรุงในช่วงแรกยังให้ผลต่ำกว่าที่คาด และยังไม่มีการยืนยันว่าบริการทั้งหมดกลับสู่ภาวะปกติหรือกำหนดเวลาฟื้นตัวที่แน่ชัด ผู้ดูแลระบบองค์กรควรตรวจสอบสถานะบริการในศูนย์ผู้ดูแลระบบ Microsoft 365 ส่วนผู้ใช้ควรเตรียมช่องทางสื่อสารสำรองและหลีกเลี่ยงการส่งคำเชิญซ้ำโดยไม่ตรวจสอบสถานะก่อน บทเรียนสำคัญคือการกู้ระบบไม่ได้จบเมื่อเซิร์ฟเวอร์เริ่มตอบสนอง แต่ต้องยืนยันด้วยว่าบริการปลายทางกลับมาใช้งานได้จริง