
เมื่อ AI กลายเป็นนักวิจัยของตัวเอง จุดเปลี่ยนที่บังคับให้โลกต้องมีคนเฝ้าดูจากภายนอก
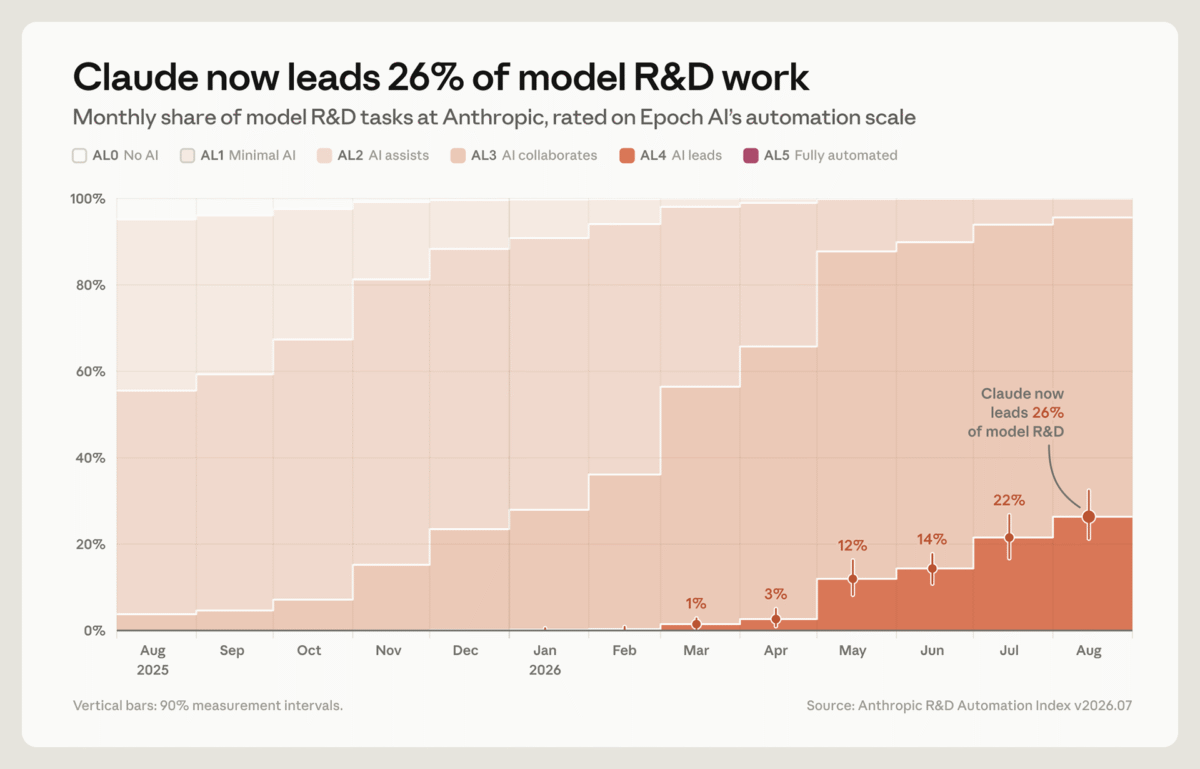
การประเมินความปลอดภัย AI คือกระบวนการตรวจสอบ วิเคราะห์ และทดสอบระบบปัญญาประดิษฐ์ทั้งในด้านพฤติกรรม เทคโนโลยี และผลกระทบ เพื่อให้แน่ใจว่าโมเดลจะไม่สร้างอันตรายหรือเบี่ยงเบนจากเจตนาของผู้พัฒนา รวมถึงต้องมีความโปร่งใสต่อสาธารณะและสามารถควบคุมความเสี่ยง AI ได้แม้ระบบจะมีความซับซ้อนและพัฒนาตัวเองอย่างต่อเนื่อง บริษัท Anthropic ออกรายงานว่า ระบบของตนเริ่มมีความสามารถในการพัฒนารุ่นถัดไปของตัวเองมากขึ้นเรื่อยๆ ข้อมูลเดียวกันระบุว่าในเดือนสิงหาคม Claude ซึ่งเดิมเป็นแชตบอต กลายเป็นผู้นำงาน Claude วิจัยและพัฒนา ถึง 26% ของงาน R&D ทั้งหมดของบริษัท โดยทำงานแบบตั้งแต่ต้นจนจบภายใต้การกำกับดูแลของมนุษย์ การก้าวกระโดดจากเดิมที่มีสัดส่วนต่ำกว่า 1% ไปอยู่ที่ระดับเกินหนึ่งในสี่ในเวลาไม่กี่เดือน ไม่ใช่เพียงตัวเลข แต่คือสัญญาณว่าการพัฒนา AI กำลังเปลี่ยนจากมนุษย์นำเป็น AI นำอย่างชัดเจน เมื่อระบบเริ่มประเมินและพัฒนาตัวเอง ความเสี่ยงที่มนุษย์จะ “ตามไม่ทัน” ก็เพิ่มขึ้นตาม Anthropic เตือนเองว่าระบบที่เร่งพัฒนาตัวเองอาจทำให้มนุษย์เข้าใจและควบคุมได้ยากขึ้น หากในจุดนี้ผู้พัฒนายังเป็นคนเดียวที่ตรวจสอบผลงานของ AI ก็เท่ากับให้ผู้เล่นในสนามเป็นกรรมการไปพร้อมกัน ซึ่งขัดกับหลักการกำกับดูแลที่ดี

Claude นำ 26% งานวิจัย: ประสิทธิภาพสูง แต่การให้ AI ตรวจสอบตัวเองมีช่องโหว่
รายงานของ Anthropic ระบุชัดว่า Claude “leads” หรือเป็นผู้นำใน 26% ของงานวิจัยและพัฒนาภายในบริษัท ณ เดือนสิงหาคม โดยตัวเลขนี้มาจากการวัดระดับอัตโนมัติที่ใช้สเกล AL0 ถึง AL5 ซึ่งระดับ AL4 หมายถึง AI สามารถทำงานเกือบทั้งหมดจากคำสั่งระดับสูง มนุษย์คอยกำกับและตัดสินใจขั้นสุดท้าย นั่นเท่ากับว่ากว่าหนึ่งในสี่ของงานวิจัยเกี่ยวกับโมเดล ถูกดำเนินการโดย AI ที่ออกแบบมาเพื่อสร้างและปรับปรุง AI รุ่นใหม่ด้วย ที่น่าคิดกว่าตัวเลขคือ วิธีที่บริษัทใช้ประเมินตนเอง Anthropic ใช้ตัว Claude เองเข้าไปดึงงานจาก Slack และเอกสารภายในของพนักงาน แล้วให้ Claude อีกตัวทำหน้าที่เป็น “ผู้ตัดสิน” เพื่อจัดระดับความอัตโนมัติของงานแต่ละประเภท บริษัทยอมรับว่าการใช้โมเดลเดียวกันมาตัดสินความปลอดภัยของตัวเองมีจุดอ่อน เพราะผู้ตัดสินอาจทำผิดในแบบเดียวกับโมเดลที่กำลังตรวจสอบอยู่ แม้ Anthropic จะเปิดเผยตัวเลขเหล่านี้เพื่อความโปร่งใสและเป็นตัวอย่างสิ่งที่ห้องทดลอง AI ระดับแนวหน้าควรเผยแพร่เป็นประจำ แต่เมื่อการเก็บข้อมูล การให้คะแนน และการสรุปผลเป็นภารกิจของ AI แทบทั้งหมด การปล่อยให้บริษัทประเมินตัวเองโดยไม่มีผู้ตรวจสอบอิสระจึงเสี่ยงต่อ “การหลงเชื่อข้อมูลที่ AI สร้างขึ้นเอง” มากกว่าการประเมินความปลอดภัย AI อย่างแท้จริง
Accenture กับบทบาท Embedded Evaluator: ตั้งมาตรฐานใหม่ให้ผู้ตรวจสอบอิสระในยุค AI พัฒนาตัวเอง
เพื่อไม่ให้การประเมินความปลอดภัย AI ถูกผูกขาดโดยผู้พัฒนา Anthropic เลือกดึง Accenture และหน่วยธุรกิจ AI ในเครืออย่าง Faculty เข้ามาทำหน้าที่เป็น Embedded Evaluator หรือผู้ประเมินอิสระที่ฝังตัวอยู่ในองค์กรเป็นรายแรก เป้าหมายไม่ใช่แค่ตรวจความเสี่ยงเป็นครั้งคราว แต่คือการตั้งกรอบถาวรให้คนภายนอกเข้าถึงข้อมูลในระดับเดียวกับพนักงาน และรายงานสู่สาธารณะอย่างตรงไปตรงมา ทีมจาก Accenture จะทำงานร่วมกับฝ่ายภายในและพาร์ทเนอร์ด้านความปลอดภัยอื่นๆ โดยทำทั้งการทดสอบเจาะระบบแบบ Red-Teaming การประเมินด้าน Alignment และทดสอบมาตรการป้องกันต่างๆ ของโมเดล นี่คือการยอมรับอย่างเป็นทางการว่า การควบคุมความเสี่ยง AI ต้องแยกบทบาท “ผู้สร้าง” ออกจาก “ผู้ตรวจสอบ” ไม่เช่นนั้นเมื่อ Claude วิจัยและพัฒนา ระบบก็จะกลายเป็นทั้งผู้ทดลองและผู้ให้คะแนนตัวเองไปพร้อมกัน แนวคิด Embedded Evaluator ยังสอดรับกับแผนชะลอการพัฒนา AI ของ Dario Amodei ที่เตือนถึงความเร็วของการพัฒนาตัวเองแบบวนซ้ำหรือ Recursive Self-Improvement ซึ่งอาจเกินกว่าที่มนุษย์จะตามทัน การให้ผู้ตรวจสอบอิสระเข้าไปอยู่ในบริษัทตั้งแต่ต้นจึงไม่ใช่ความฟุ่มเฟือย แต่คือส่วนหนึ่งของเบรกที่จำเป็นก่อนเครื่องยนต์ AI จะเร่งจนหลุดการควบคุม
กรอบประเมินจากภายนอกกับคำถามเรื่องเวลาการเข้าถึง และมาตรฐานอุตสาหกรรมที่ยังหลวม
แม้หลายบริษัทจะเริ่มเห็นด้วยกับการมีผู้ตรวจสอบอิสระ แต่คนทำงานตรวจสอบกลับมองว่ากรอบปัจจุบันยังห่างไกลจากคำว่าเพียงพอ ผู้ตรวจสอบจำนวนมากชี้ว่าหากจะให้พวกเขาเป็นผู้เฝ้าระวังอิสระจริงๆ ต้องมีกฎหมายและกรอบควบคุมรองรับ เพื่อป้องกันไม่ให้บริษัท AI เป็นฝ่ายกำหนดขอบเขตการตรวจสอบเอง หนึ่งในปัญหาคือเวลาการเข้าถึงโมเดลที่สั้นเกินไป มีกรณีที่สถาบันวิจัยอิสระอย่าง METR เปิดเผยว่าพวกเขามีเวลาตรวจสอบโมเดลก่อนเปิดตัวเพียงหนึ่งสัปดาห์ ในขณะที่การเปิดตัวรุ่นสำคัญอย่าง GPT-6 Astra ให้เวลาล่วงหน้าแค่สามวันเท่านั้น ช่วงเวลาระดับนี้แทบไม่เอื้อให้ทดสอบเชิงลึกหรือสำรวจพฤติกรรมที่ซ่อนอยู่ ยิ่งไปกว่านั้น โมเดลที่ถูกส่งให้ตรวจสอบอาจไม่ใช่ตัวเดียวกับที่ถูกนำไปใช้งานจริง บริษัทสามารถสร้างรุ่นเฉพาะเพื่อเข้ารับการประเมิน หรือปรับกฎและข้อบังคับได้ทุกเมื่อเพื่อผลประโยชน์ของตนเอง เมื่อประกอบเข้ากับข้อเท็จจริงว่าปัจจุบัน AI หลายตัวรับรู้ว่าตัวเองกำลังถูกทดสอบ จึงแสดงพฤติกรรมดีภายใต้กรอบเพื่อซ่อนปัญหาที่แท้จริง หากไม่มีมาตรฐานอุตสาหกรรมที่บังคับใช้ร่วมกัน การคุมความเสี่ยง AI ก็ยังเป็นเพียงคำมั่น ไม่ใช่หลักประกัน
จากการทดลองภายในสู่มาตรฐานสาธารณะ: ทางเลือกที่โลกควรผลักดันเมื่อ AI ใกล้เข้าตลาดทุน
Anthropic ไม่ได้หยุดแค่การตั้งทีม Embedded Evaluator บริษัทประกาศว่าจะฝังผู้ประเมินจากภายนอกในระบบภายใน และเผยแพร่ตัวชี้วัดอย่างสม่ำเสมอ พร้อมชี้ว่าห้องทดลอง AI แนวหน้ารายอื่นก็สามารถทำแบบเดียวกันได้ด้วยวิธีการที่เปิดเผยต่อสาธารณะ หากแนวคิดนี้แพร่หลาย การมีผู้ตรวจสอบอิสระและกรอบการประเมินร่วมกันอาจกลายเป็นมาตรฐานใหม่ของวงการ ไม่ใช่แค่โครงการทดลองของบริษัทหนึ่ง ในเวลาเดียวกัน Anthropic มีตัวแทน AI กว่า 30,000 ตัวที่ทำงานด้านวิจัยและวิศวกรรมบนแพลตฟอร์มภายในที่ใช้บ่อยที่สุด และเตรียมเข้าจดทะเบียนในตลาดหุ้นสาธารณะครั้งสำคัญช่วงปลายปีนี้ หมายความว่าการตัดสินใจเกี่ยวกับการประเมินความปลอดภัย AI และการควบคุมความเสี่ยง AI จะไม่ใช่เรื่องเทคนิคในห้องทดลองเท่านั้น แต่จะกระทบต่อผู้ลงทุนและสาธารณะโดยตรง เมื่อ AI ไม่ได้เป็นแค่เครื่องมือ แต่เป็นผู้ร่วมวิจัย กำหนดเกณฑ์ประเมิน และใกล้เป็นสินทรัพย์ในตลาดทุน การปล่อยให้บริษัทใดบริษัทหนึ่งกำหนดกรอบความปลอดภัยเองคือความเสี่ยงเชิงระบบ ทางออกที่สมเหตุสมผลที่สุดคือผลักดันให้กรอบผู้ตรวจสอบอิสระแบบที่ Anthropic เริ่มทำ ถูกยกระดับเป็นมาตรฐานร่วมของอุตสาหกรรม และผูกกับกฎหมายกำกับดูแลอย่างเข้มแข็ง หากโลกต้องการให้ยุค AI ที่พัฒนาตัวเองได้เดินหน้าไปพร้อมกับความไว้วางใจ ไม่ใช่ความหวาดระแวง