
AI agents ใน production คืออะไร และทำไมแนวคิดแบบเว็บแอปถึงใช้ไม่ได้
AI agents ใน production คือระบบซอฟต์แวร์ที่ใช้โมเดลภาษาและเครื่องมือภายนอกเพื่อทำงานแทนมนุษย์อย่างต่อเนื่องในสภาพแวดล้อมจริง รับอินพุตจากผู้ใช้หรือระบบ แต่สามารถตัดสินใจ เรียกบริการอื่น เขียนอ่านข้อมูล และรันกระบวนการของตนเองโดยไม่ต้องมีคนคอยสั่งงานตลอดเวลา จึงต้องออกแบบให้ควบคุมพฤติกรรม ตรวจสอบข้อผิดพลาด และหยุดความเสียหายได้แม้กำลังทำงานแบบอัตโนมัติ
วิธีคิดแบบเว็บแอปดั้งเดิมคือคอนเทนเนอร์ไร้สถานะ อยู่หลังโหลดบาลานเซอร์ มี autoscale ตามโหลด และ CI/CD ปล่อยอิมเมจใหม่เมื่อมีเวอร์ชันล่าสุด โมเดลนี้ทำงานได้ดีมานาน แต่เมื่อเอาไปใช้กับ AI agents ที่รันเป็น gateway แบบ background ไม่ได้เกิดจากคำขอของผู้ใช้โดยตรง การคิดว่าเป็นแค่เว็บแอปที่เรียก LLM จึงพังใน production ภายในเวลาไม่นาน เพราะภาระงานไม่ผูกกับ request rate และต้นทุนเกิดจากความลึกในการ reasoning ที่คาดเดาไม่ได้
ผลกระทบคือองค์กรที่พยายาม deploy AI agents แบบบริการปกติจะพบ incident ที่คู่มือเว็บแอปตอบไม่ได้ เช่น gateway เดียวล่มแล้วทุกช่องทางดับพร้อมกัน ซึ่งเป็นรูปแบบ outage ที่ผู้ใช้ปลายทางสัมผัสได้ตรงๆ แนวทางที่ถูกจึงไม่ใช่แค่เพิ่มสเปกเซิร์ฟเวอร์ เพราะปัญหาอยู่ที่สถาปัตยกรรม ไม่ใช่ทรัพยากร
กฎแบบเขียนยาวไม่รอด ต้องเปลี่ยนเป็น governance แบบบังคับด้วยโครงสร้าง
หลายทีมเริ่มจากการเขียนคู่มือและกฎพฤติกรรมของ AI agents ยาวเป็นพันบรรทัดแล้วหวังว่าโมเดลจะทำตาม แต่เมื่อกฎสะสมเป็นไฟล์ 18 ไฟล์รวมกว่า 5,000 บรรทัด ผลคือเอเจนต์ยังผลิตฟีเจอร์ที่ไม่ตามสัญญา API ไม่ใช้ client ที่มีอยู่ และละเมิดมาตรฐานโค้ดเหมือนทีมจูเนียร์หลายคนทำงานปะปนกัน การฝากชีวิตไว้กับ prose แบบนี้จึงเป็นความเสี่ยงมากกว่าปลอดภัย
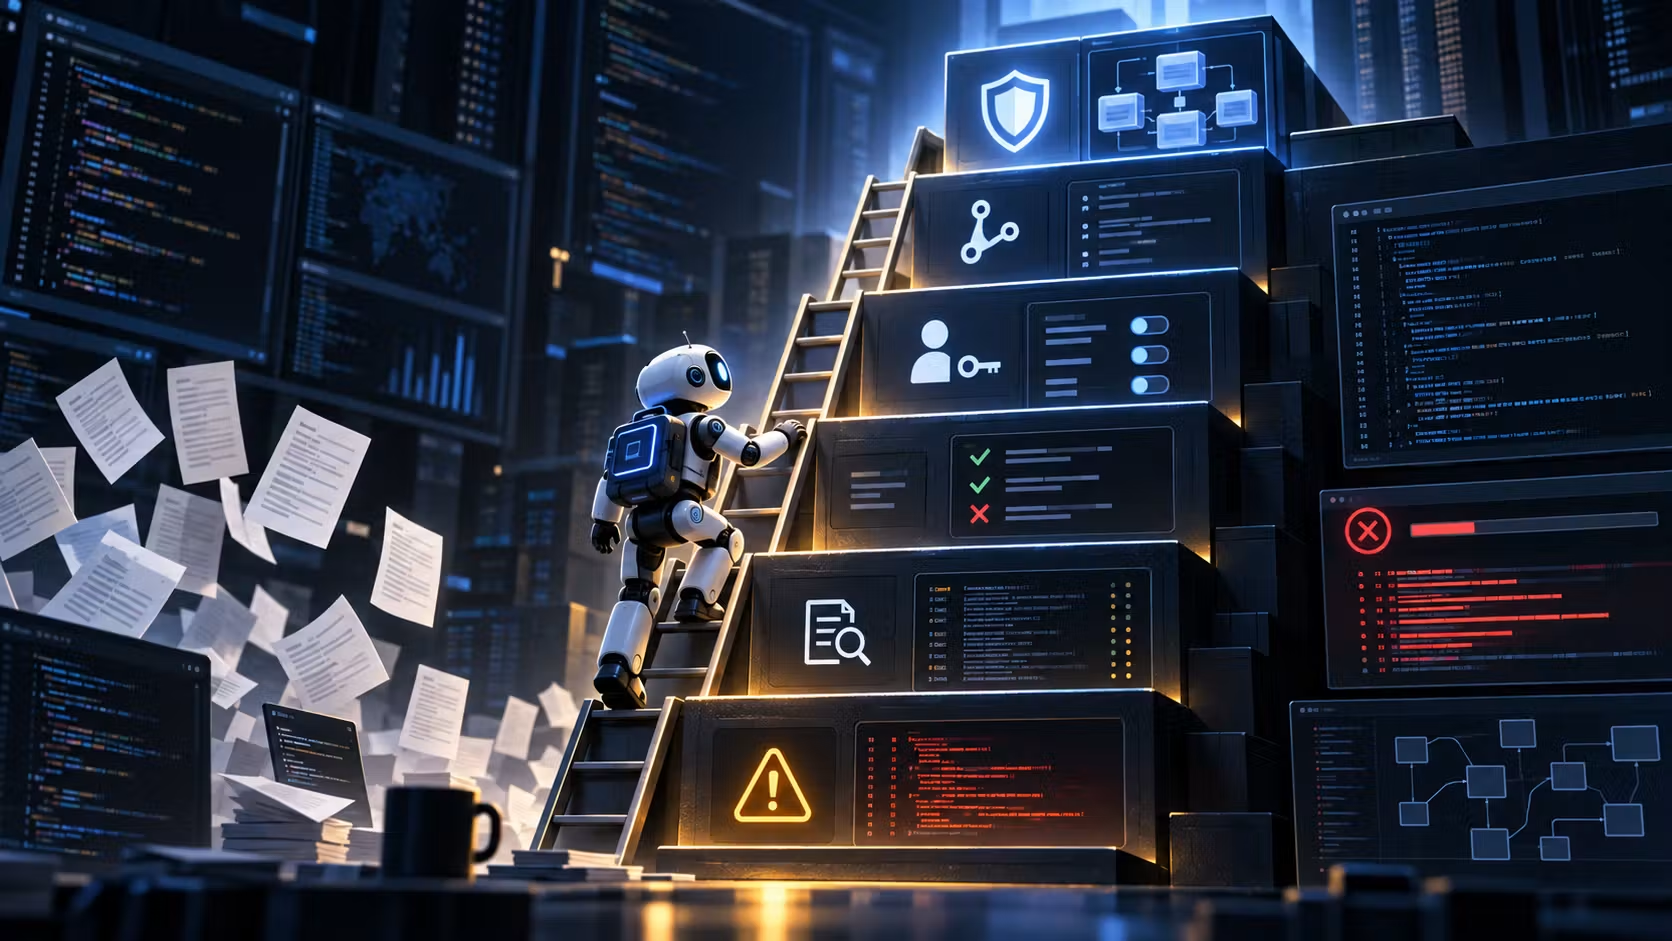
คำตอบที่เกิดจากการลองผิดลองถูกคือบันไดลดขั้นหรือ demotion ladder ทุกกฎเริ่มจากการเขียนเป็นข้อความ แล้วเมื่อถูกละเมิดบ่อยก็ถูกลดขั้นให้กลายเป็นกลไกที่ข้ามได้ยากขึ้นและมีต้นทุนสูงขึ้น เช่น การแบ่งสิทธิ์เขียนตามบทบาท โดยเปิดให้อ่านทุกอย่างได้แต่จำกัดการเขียนเพราะจุดเสียหายมักอยู่ที่การเขียนข้อมูล หรือขยับขึ้นไปถึงขั้นที่โครงสร้างบังคับ เช่นให้ generated client เป็น client เดียวที่คอมไพล์ได้ ทำให้สถานะผิดกลายเป็นสิ่งที่แทนไม่ได้ในระบบ
แนวคิดนี้สะท้อนคำแนะนำที่ว่า prose เป็นเพียงคำแนะนำ ส่วน hook และการตรวจตอน build คือกฎจริง การทดสอบที่กลายเป็น definition of done จะถูกเขียนก่อนงานโดยคนที่ไม่ใช่ผู้พัฒนา และแม้ตั้งยากแต่กลายเป็นขั้นบนสุดของบันไดเพราะมีค่าสูงที่สุด องค์กรที่ยังติดกับการออก memo ให้เอเจนต์จึงควรถอยหนึ่งก้าว เปลี่ยนทรัพยากรที่ใช้เขียนเอกสารไปสร้าง governance layer ที่บังคับได้ในระดับระบบ
Feature flags และ observability คือโครงสร้างพื้นฐาน ไม่ใช่ if เฉพาะกิจ
ในโลกของ AI agents production deployment การควบคุม AI behavior แบบเรียลไทม์กลายเป็นเรื่องอยู่รอด การใช้ feature flags แบบ if เล็กๆ ในโค้ด เช่นเลือกหน้าชำระเงินเก่าใหม่ เป็นเพียงจุดเริ่มต้น เมื่อระบบโตขึ้น flag เหล่านี้จะครอบคลุม flow การซื้อ การทดลองราคา onboarding การย้าย API การเปลี่ยน navigation วิธีจ่ายเงิน และปุ่มหยุดระบบฉุกเฉิน
เมื่อถึงจุดนั้น feature flags ไม่ใช่แค่เงื่อนไขในโค้ด แต่กลายเป็น production infrastructure เต็มรูปแบบ การสลับ flag อาจเสี่ยงเท่าการ deploy โค้ดใหม่ เพราะสามารถเปิด flow การจ่ายเงินที่ยังไม่สมบูรณ์ให้ผู้ใช้ทั้งหมดโดยไม่มี deployment ใหม่เลย ดังนั้นองค์กรต้องให้ ownership สิทธิ์จัดการ ระบบเฝ้าดู log แผน rollback และแผนเก็บกวาดเหมือนดูแลส่วนอื่นของโครงสร้างพื้นฐาน production
เพื่อให้ทดสอบ AI agents ในระบบจริงได้อย่างปลอดภัย ต้องมี observability ที่ผูกกับ flag ด้วย เหตุการณ์ผิดพลาดควรมี context เช่น feature ไหนเปิดอยู่ variant ใด cohort ไหนกำลัง rollout เพราะคำถามหลัง incident ของเอเจนต์ไม่ใช่ว่าระบบล่มหรือไม่ แต่คือเหตุใดมันตัดสินใจแบบนั้น และเกิดขึ้นภายใต้ combination ของ flags ใด ตรงนี้คือเหตุผลว่าทำไม feature flags infrastructure ที่มี monitoring และ audit ถึงเป็นอาวุธหลักของทีมที่ต้องควบคุม agent behavior
การทดสอบที่วัดผลลัพธ์ธุรกิจ ไม่ใช่แค่โค้ดถูก และบทเรียนจาก Pixbu
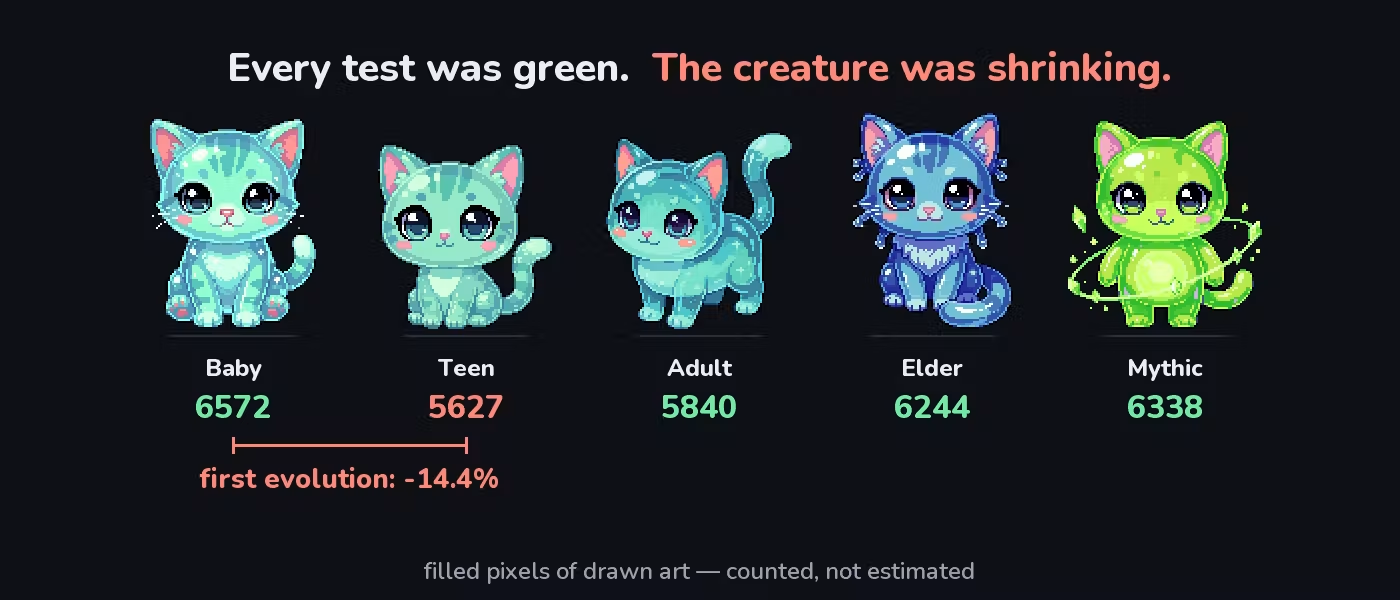
AI reliability testing ที่ใช้ได้ใน production ต้องเลิกหมกมุ่นแค่ผ่านไม่ผ่านเชิงเทคนิค แต่วัดว่าพฤติกรรมของเอเจนต์ทำให้ผลลัพธ์ธุรกิจดีขึ้นหรือแย่ลง ตัวอย่างที่ชัดคือแอปดูแลตัวเองที่มีสิ่งมีชีวิตแบบพิกเซลค่อยๆ โตขึ้นตามการดูแล ผู้พัฒนาเดี่ยวคนนี้ปล่อยระบบพร้อมอัตโนมัติเทสต์ 1,889 รายการ และให้สิ่งมีชีวิตพัฒนาผ่าน 6 ระยะ พร้อมรองรับ 6 ภาษา
เมื่อเปลี่ยนชุดภาพทั้งหมด เทสต์ยังเขียว จนกระทั่งนับจำนวนพิกเซลจริง ปรากฏว่าในช่วง baby ไป teen ขนาดลดลงจาก 6,572 เหลือ 5,627 พิกเซล ทำให้สิ่งมีชีวิตหดตัว 14 เปอร์เซ็นต์ในช่วงวิวัฒนาการแรกที่ผู้ใช้เห็นมากที่สุด นั่นคือ “ช่วงเดียวที่แอปมีอยู่เพื่อมอบประสบการณ์ กลับเดินถอยหลัง” สาเหตุเพราะเทสต์ตรวจ metadata ที่ไม่ได้อัปเดต ไม่ได้วัดประสบการณ์ที่เราสนใจ
บทเรียนคือการทดสอบที่วัดสิ่งผิดจะให้สัญญาณผิดเสมอ นักพัฒนาคนเดิมจึงเริ่ม mutate guard ทุกตัว ถ้าเทสต์ไม่มีทางล้ม มันไม่ใช่เทสต์แต่เป็นคอมเมนต์ที่เปลืองเวลารัน CI แนวคิดเดียวกันต้องนำมาใช้กับ AI agents ในระบบจริง การทดสอบควรออกแบบให้สะท้อนเป้าหมาย เช่น conversion การแก้ปัญหาของผู้ใช้ หรือจำนวน incident ไม่ใช่แค่ตรวจว่าโค้ดรันผ่าน sandbox หรือ proxy metric ใด metric หนึ่งเท่านั้น
จากการใช้ AI แบบรายคนสู่ pipeline แบบ AI-native เพื่อความน่าเชื่อถือระยะยาว
หลายองค์กรกำลังมีประสบการณ์เหมือนกัน คือ AI ช่วยเขียนโค้ดเร็วขึ้นมาก แต่ระบบไม่ได้ปล่อยฟีเจอร์เร็วขึ้นเท่าไร เพราะคอขวดอยู่ก่อนและหลังขั้นเขียนโค้ด งานแยก requirement วางแผน ตรวจความพร้อม กำหนดข้อจำกัด รีวิว ทดสอบ และดูแล incident ยังต้องทำด้วยมือเป็นหลัก จึงเกิดแรงกดดันใหม่เมื่อปริมาณโค้ดเพิ่มขึ้นตามความช่วยเหลือของ AI
มีการสำรวจวิศวกรกว่า 1,100 คน พบว่า 94 เปอร์เซ็นต์ของผู้นำวิศวกรรมบอกว่าองค์กรใช้ AI แล้ว แต่ส่วนใหญ่ใช้ช่วยงานเดี่ยว เช่นเขียนโค้ด แก้บั๊ก หรือทำเอกสาร ขณะเดียวกัน 88 เปอร์เซ็นต์ยอมรับว่าต้องการระบบงานด้านวิศวกรรมที่มีการกำกับ AI ชัดเจน แต่เพียง 19 เปอร์เซ็นต์เท่านั้นที่สร้างระบบแบบนั้นได้แล้ว "เมื่อ AI เร่งการเขียนโค้ด งานก่อนและหลังโค้ดจึงสำคัญขึ้น"
ทิศทางต่อไปคือ AI-native delivery pipelines ที่ให้ทั้งทีมและ agents ทำงานบนระบบเดียวกันที่พก context หลักฐาน และ accountability ไปตลอด lifecycle ระบบแบบนี้เปิดทางให้ต่อยอดก้าวต่อไป เช่นให้ AI เสริมกำลังงานทดสอบและคุณภาพ ช่วย observability และ incident triage ซึ่งยังเป็นแนวปฏิบัติของส่วนน้อย เมื่อรวมกับสถาปัตยกรรม deployment ที่เข้าใจพฤติกรรม agents การใช้ feature flags เป็นโครงสร้างพื้นฐาน และ demotion ladder ที่แปลงกฎเป็นการบังคับจริง ทีมจะลดการ rework รอบแล้วรอบเล่า และทำให้ AI agents อยู่ใน production ได้อย่างเชื่อถือได้มากขึ้น