
โมเดลเล็กที่ไม่ได้จำกัดอยู่แค่งานข้อความ
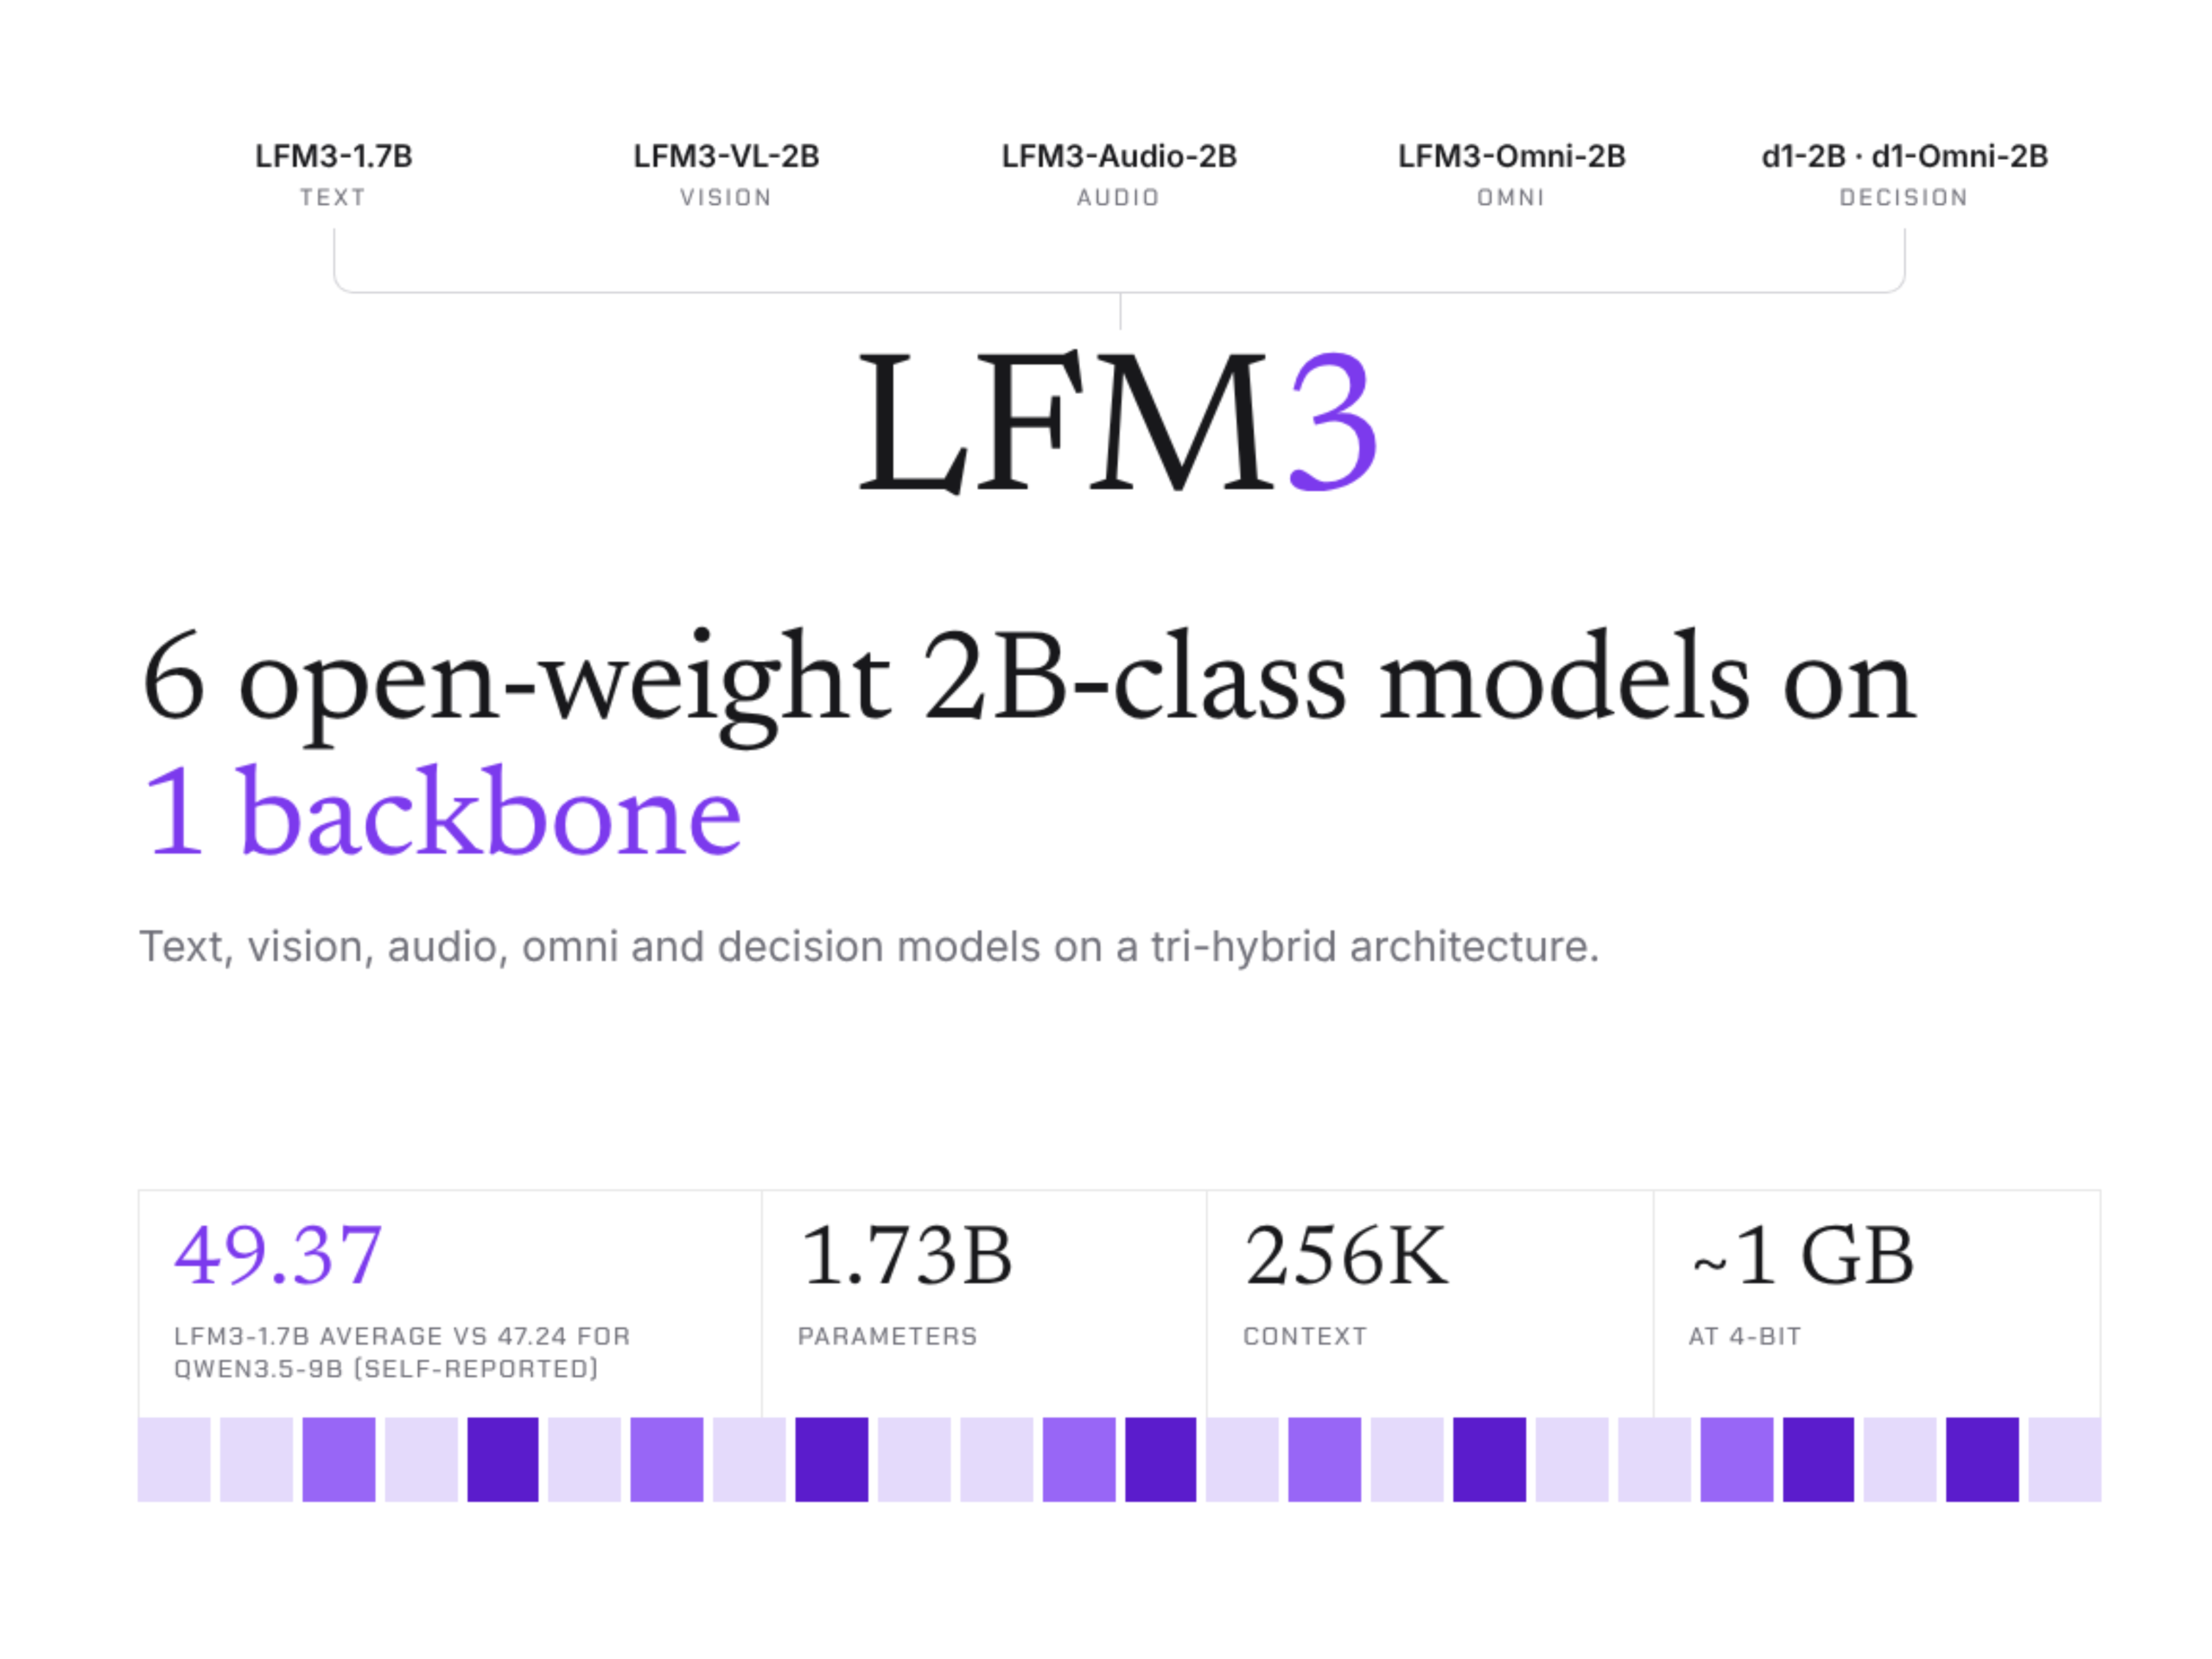
LFM3 Liquid AI คือ ตระกูลโมเดลปัญญาประดิษฐ์แบบเปิดน้ำหนักขนาดกะทัดรัด ซึ่งแตกแขนงจากโครงสร้างหลักเดียวเพื่อจัดการข้อความ ภาพ เสียง วิดีโอ และงานตัดสินใจ ให้เลือกใช้ตามรูปแบบข้อมูลและอุปกรณ์ที่มี
Liquid AI เปิดตัว LFM3 ในปี 2026 โดยมีโมเดล 6 รุ่นระดับ 2B ตั้งแต่โมเดลข้อความ LFM3-1.7B ไปจนถึงรุ่นภาพและวิดีโอ รุ่นเสียง รุ่น Omni ที่รับข้อมูลหลายชนิด และโมเดลตัดสินใจ d1-2B กับ d1-Omni-2B จุดแข็งไม่ใช่การยัดทุกความสามารถลงในโมเดลเดียว แต่คือการสร้างทางเลือกเฉพาะงานบนฐานร่วมกัน จึงไม่จำเป็นต้องแบกโมเดลใหญ่เกินความจำเป็นเมื่อต้องใช้งานบนอุปกรณ์ โมเดลทั้งหมดเป็น Open-weight โมเดลที่เปิดให้นักพัฒนานำไปใช้งานและปรับแต่งได้ แนวทางนี้มีความหมายต่อผู้ใช้ทั่วไปด้วย เพราะมีโอกาสทำให้ผู้ช่วยอัจฉริยะทำงานในเครื่องได้มากขึ้น แทนการส่งทุกคำถามขึ้นระบบคลาวด์
หน่วยความจำต่ำคือข้อได้เปรียบที่จับต้องได้
ข้อเสนอที่น่าสนใจที่สุดของ LFM3 คือการมุ่งแก้ข้อจำกัดด้านทรัพยากร โมเดลข้อความใช้หน่วยความจำเพียง 1 GB เมื่อทำงานที่ความแม่นยำ 4-bit และรองรับ Context Window สูงสุด 256K โทเคน ซึ่งช่วยให้เอเจนต์จัดการข้อมูลประกอบและบทสนทนายาวบนอุปกรณ์ได้โดยไม่ต้องพึ่งเซิร์ฟเวอร์ตลอดเวลา นี่คือภาพของ Edge computing AI ที่มีประโยชน์จริงสำหรับแล็ปท็อป อุปกรณ์พกพา และระบบฝังตัว ไม่ใช่แค่การย่อโมเดลเพื่อให้ตัวเลขดูเล็กลง
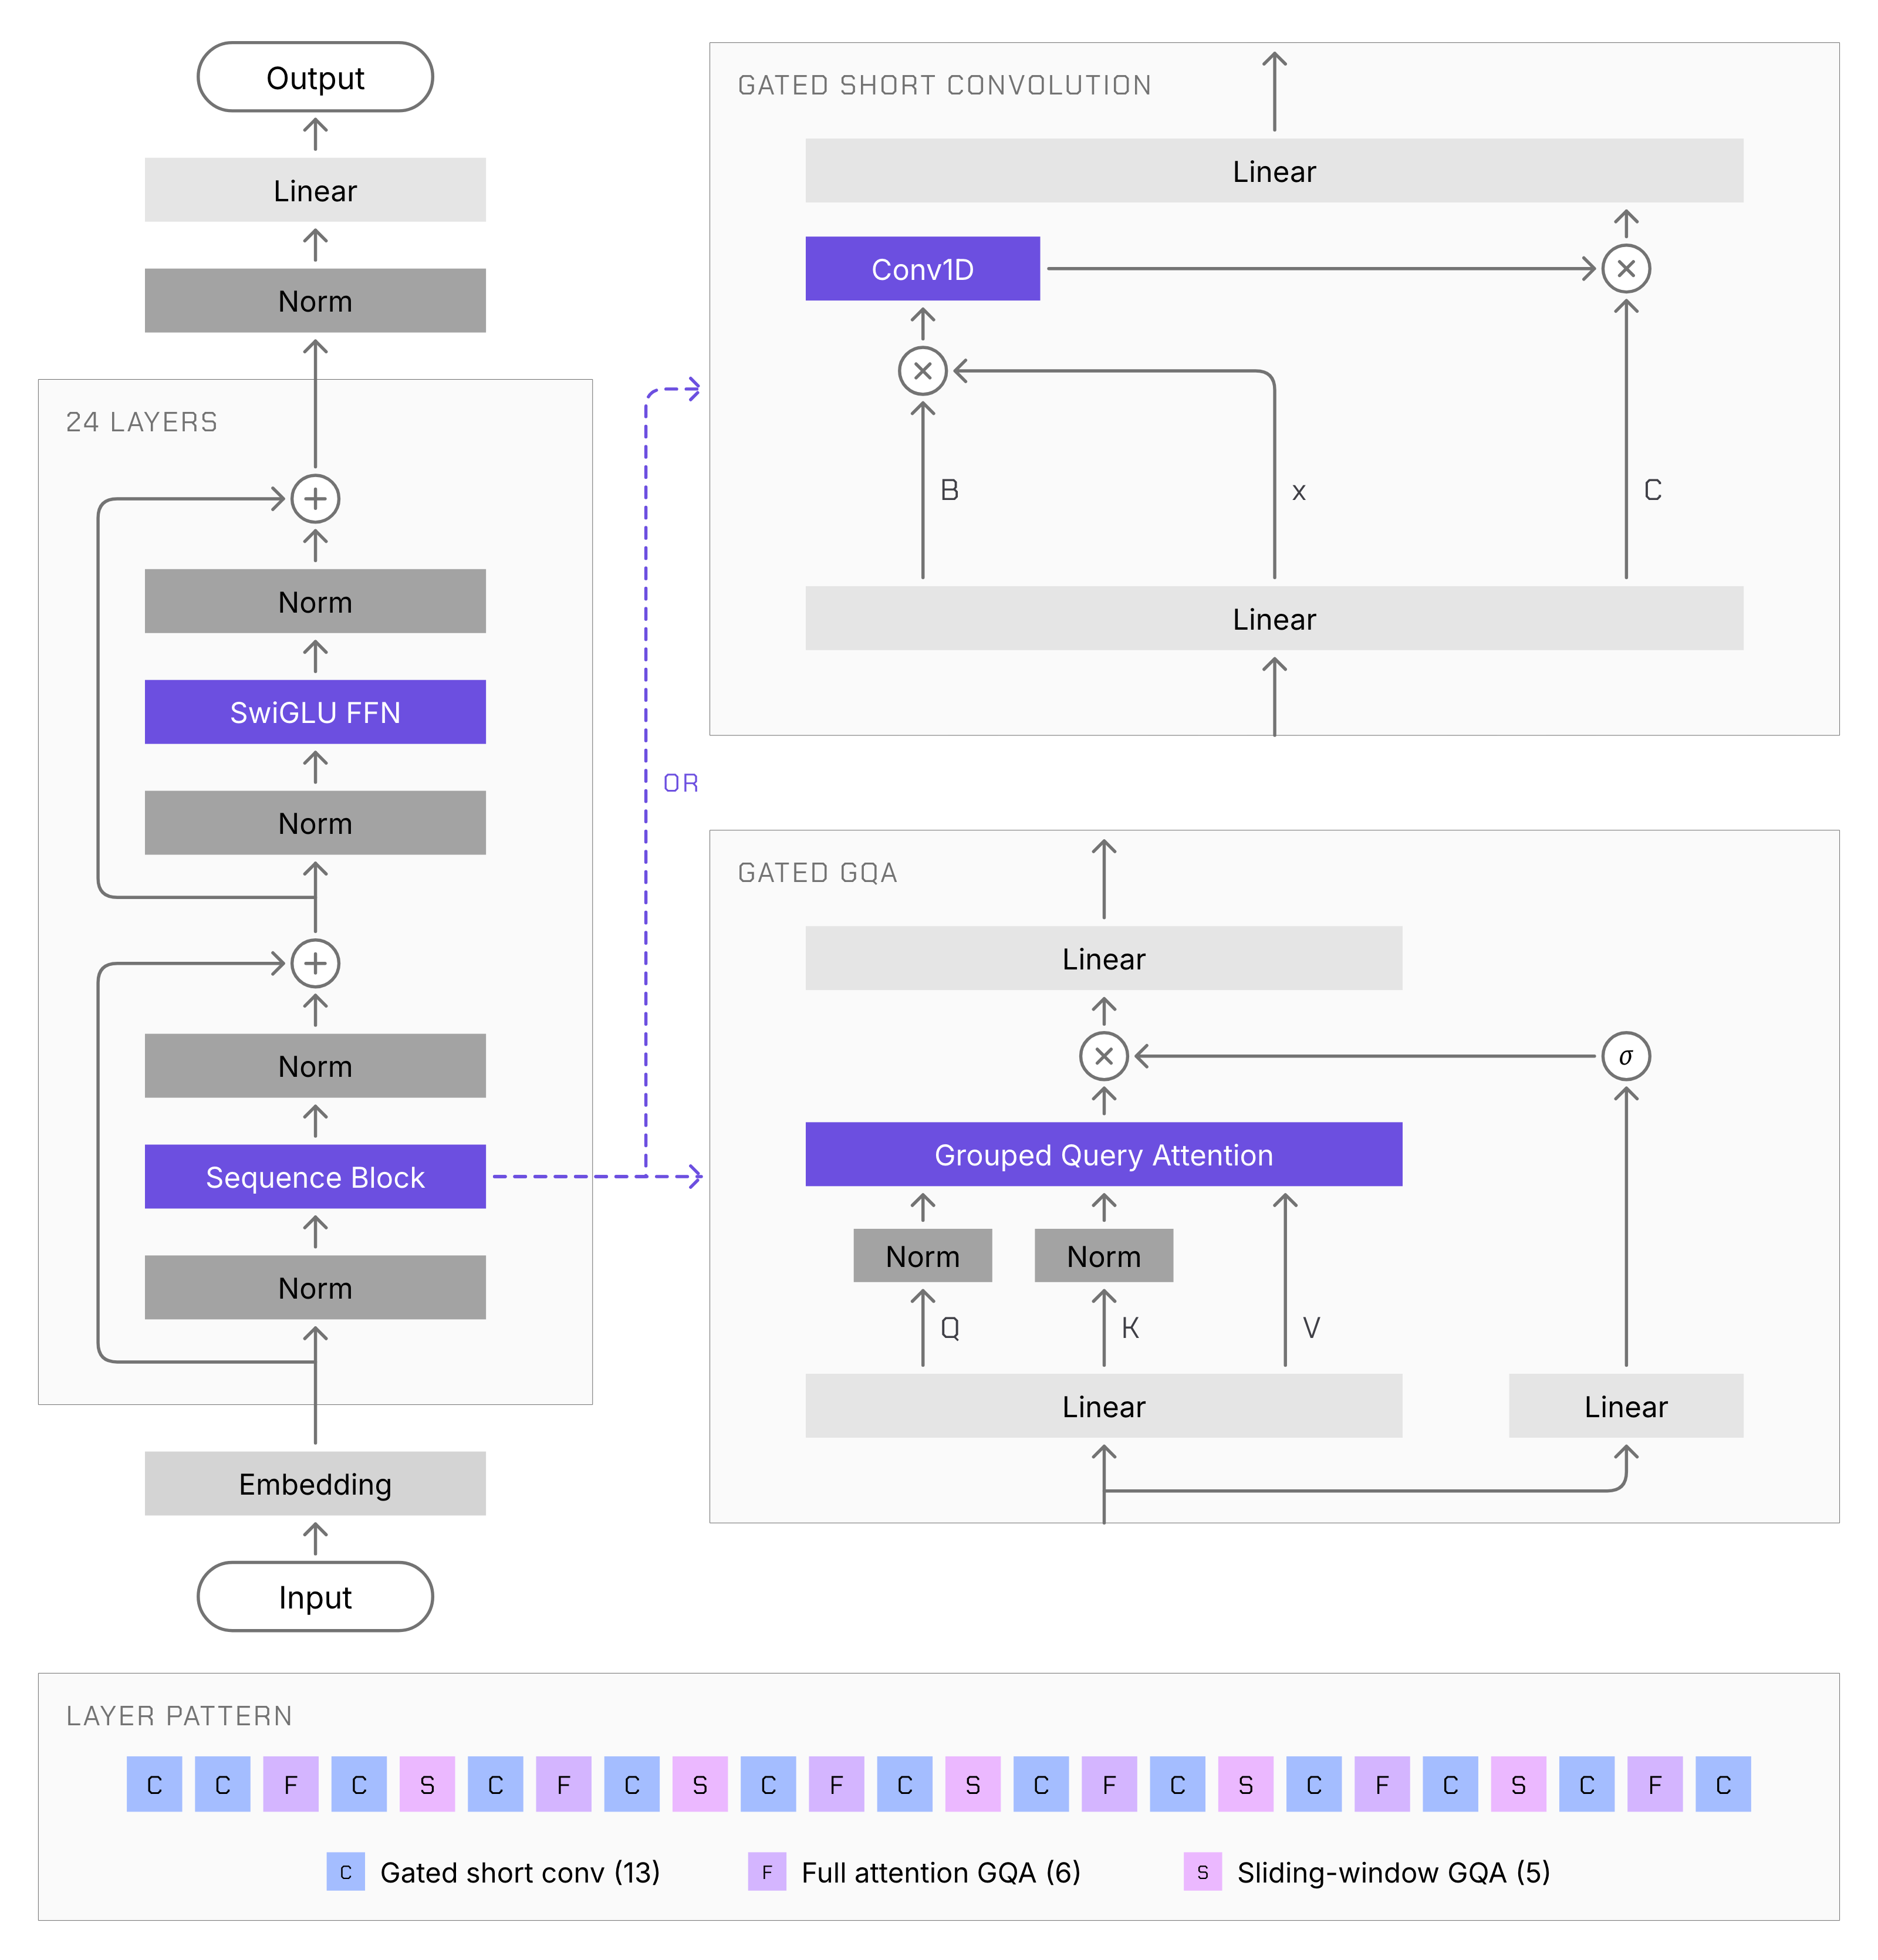
เบื้องหลังคือสถาปัตยกรรมแบบผสมที่ออกแบบโดยคำนึงถึงการทำงานบนฮาร์ดแวร์ และปรับให้เหมาะกับงานเอเจนต์ที่ต้องใช้บริบทยาว จากการประเมินของ Liquid AI เอง LFM3-1.7B ทำคะแนนเฉลี่ย 49.37 จาก 29 เกณฑ์ทดสอบ เทียบกับ 47.24 ของ Qwen3.5-9B ซึ่งเป็นสัญญาณว่าขนาดเล็กไม่จำเป็นต้องแปลว่าทำงานได้ด้อยกว่า อย่างไรก็ดี ตัวเลขนี้มาจากการประเมินของผู้พัฒนา และแหล่งข้อมูลระบุว่ายังมีงานความรู้ทั่วไปบางประเภทที่ตามหลังคู่แข่งอยู่ จึงควรเลือกตามงานจริง ไม่ใช่ดูคะแนนรวมเพียงอย่างเดียว
เปิดน้ำหนัก ปรับแต่งได้ และมีโมเดลคนละโจทย์
LFM3 ให้ความยืดหยุ่นมากกว่าการดาวน์โหลดแล้วทดลองใช้ เพราะโมเดลทั้งหกรุ่นรองรับการปรับแต่งด้วยจีพียูเพียงตัวเดียว นักพัฒนาจึงปรับพฤติกรรมให้เข้ากับข้อมูลเฉพาะและสภาพแวดล้อมที่จะนำไปติดตั้งได้ โดยไม่ต้องมีคลัสเตอร์ขนาดใหญ่ โมเดลเปิดน้ำหนักพร้อมใช้งานแล้ว และดาวน์โหลดน้ำหนักได้ผ่าน Hugging Face, Liquid AI Playground และ Liquid API สำหรับผู้ใช้ นั่นหมายถึงโอกาสได้เครื่องมือที่ตอบโจทย์งานเฉพาะโดยทำงานในเครื่อง ส่วนองค์กรยังมีทางเลือกควบคุมการติดตั้งและข้อมูลได้มากขึ้น
อีกด้านหนึ่ง d3-ultra จากทีม vLLM Semantic Router แสดงให้เห็นว่าโมเดลมัลติโหมดไม่ได้มีไว้สร้างคำตอบเป็นข้อความเท่านั้น โมเดลขนาด 27B นี้เป็นแบบเปิดน้ำหนักภายใต้สัญญาอนุญาต Apache-2.0 รับข้อความหรือข้อมูลในรูปแบบ JSON พร้อมภาพหรือวิดีโอ แล้วประเมินคำถามหลายข้อจากการอ่านข้อมูลครั้งเดียว จึงเหมาะกับงานจัดเส้นทางคำขอ การจำแนก และการตรวจสอบภาพหรือวิดีโอ d3-ultra ไม่ใช่โมเดลขนาดเล็กสำหรับอุปกรณ์ปลายทางเหมือน LFM3 แต่เป็นตัวอย่างของทางเลือกอีกแบบในระบบ Multimodal ข้อความภาพเสียง สรุปแล้ว LFM3 น่าสนใจตรงการนำความสามารถหลายชนิดมาไว้ในขนาดที่ติดตั้งได้จริง ขณะที่ d3-ultra ชี้ให้เห็นพลังของการตัดสินใจจากสื่อหลายรูปแบบ การเลือกโมเดลจึงควรเริ่มจากงานและทรัพยากร ไม่ใช่เลือกจากจำนวนพารามิเตอร์เพียงอย่างเดียว