
AI requirements compiler คืออะไร และทำไมถึงสำคัญกว่าไฟล์ PRD สวยๆ
AI requirements compiler คือระบบที่แปลงความต้องการซอฟต์แวร์จากคำขอ กระดาษโน้ต การสัมภาษณ์ และหลักฐานอื่น ให้เป็นโครงสร้างข้อมูลที่ตรวจสอบได้ เชื่อมโยงแหล่งที่มา เช็กข้อขัดแย้ง และแตกออกเป็นอินเทอร์เฟซและเทสต์เคส โดยมี PRD เป็นเพียงผลลัพธ์รูปแบบหนึ่ง ไม่ใช่ศูนย์กลางของความจริงเพียงจุดเดียว
ยุคก่อน เรามักบอกให้โมเดลข้อความเขียน PRD ให้เสร็จในครั้งเดียว ผลลัพธ์คือ “คำโกหกที่เขียนได้สวย” เต็มไปด้วยโครงเรื่องดูมืออาชีพ แต่ไม่มีใครรู้ว่าตัวเลข กติกา หรือขอบเขตใดมาจากลูกค้า เอกสารเก่า หรือจินตนาการของโมเดล ปัญหาไม่ได้อยู่ที่พรอมป์ไม่ดี แต่คือการเอาเนื้อความร้อยแก้วมาเป็นระบบอ้างอิงหลัก ทั้งที่ข้อกำหนดที่ดีควรทำตัวเหมือนคอมไพเลอร์ คือรับอินพุต ตรวจเงื่อนไข รายงานข้อผิดพลาด แล้วสร้างอาร์ติแฟกต์หลายแบบออกมา แก่นที่ทนทานคือกราฟของข้อกล่าวอ้างและหลักฐาน ไม่ใช่ย่อหน้าเรียงสวย
Jira Planner กับสะพานเชื่อมจากไอเดียสู่สเปกที่เอเจนต์รันได้
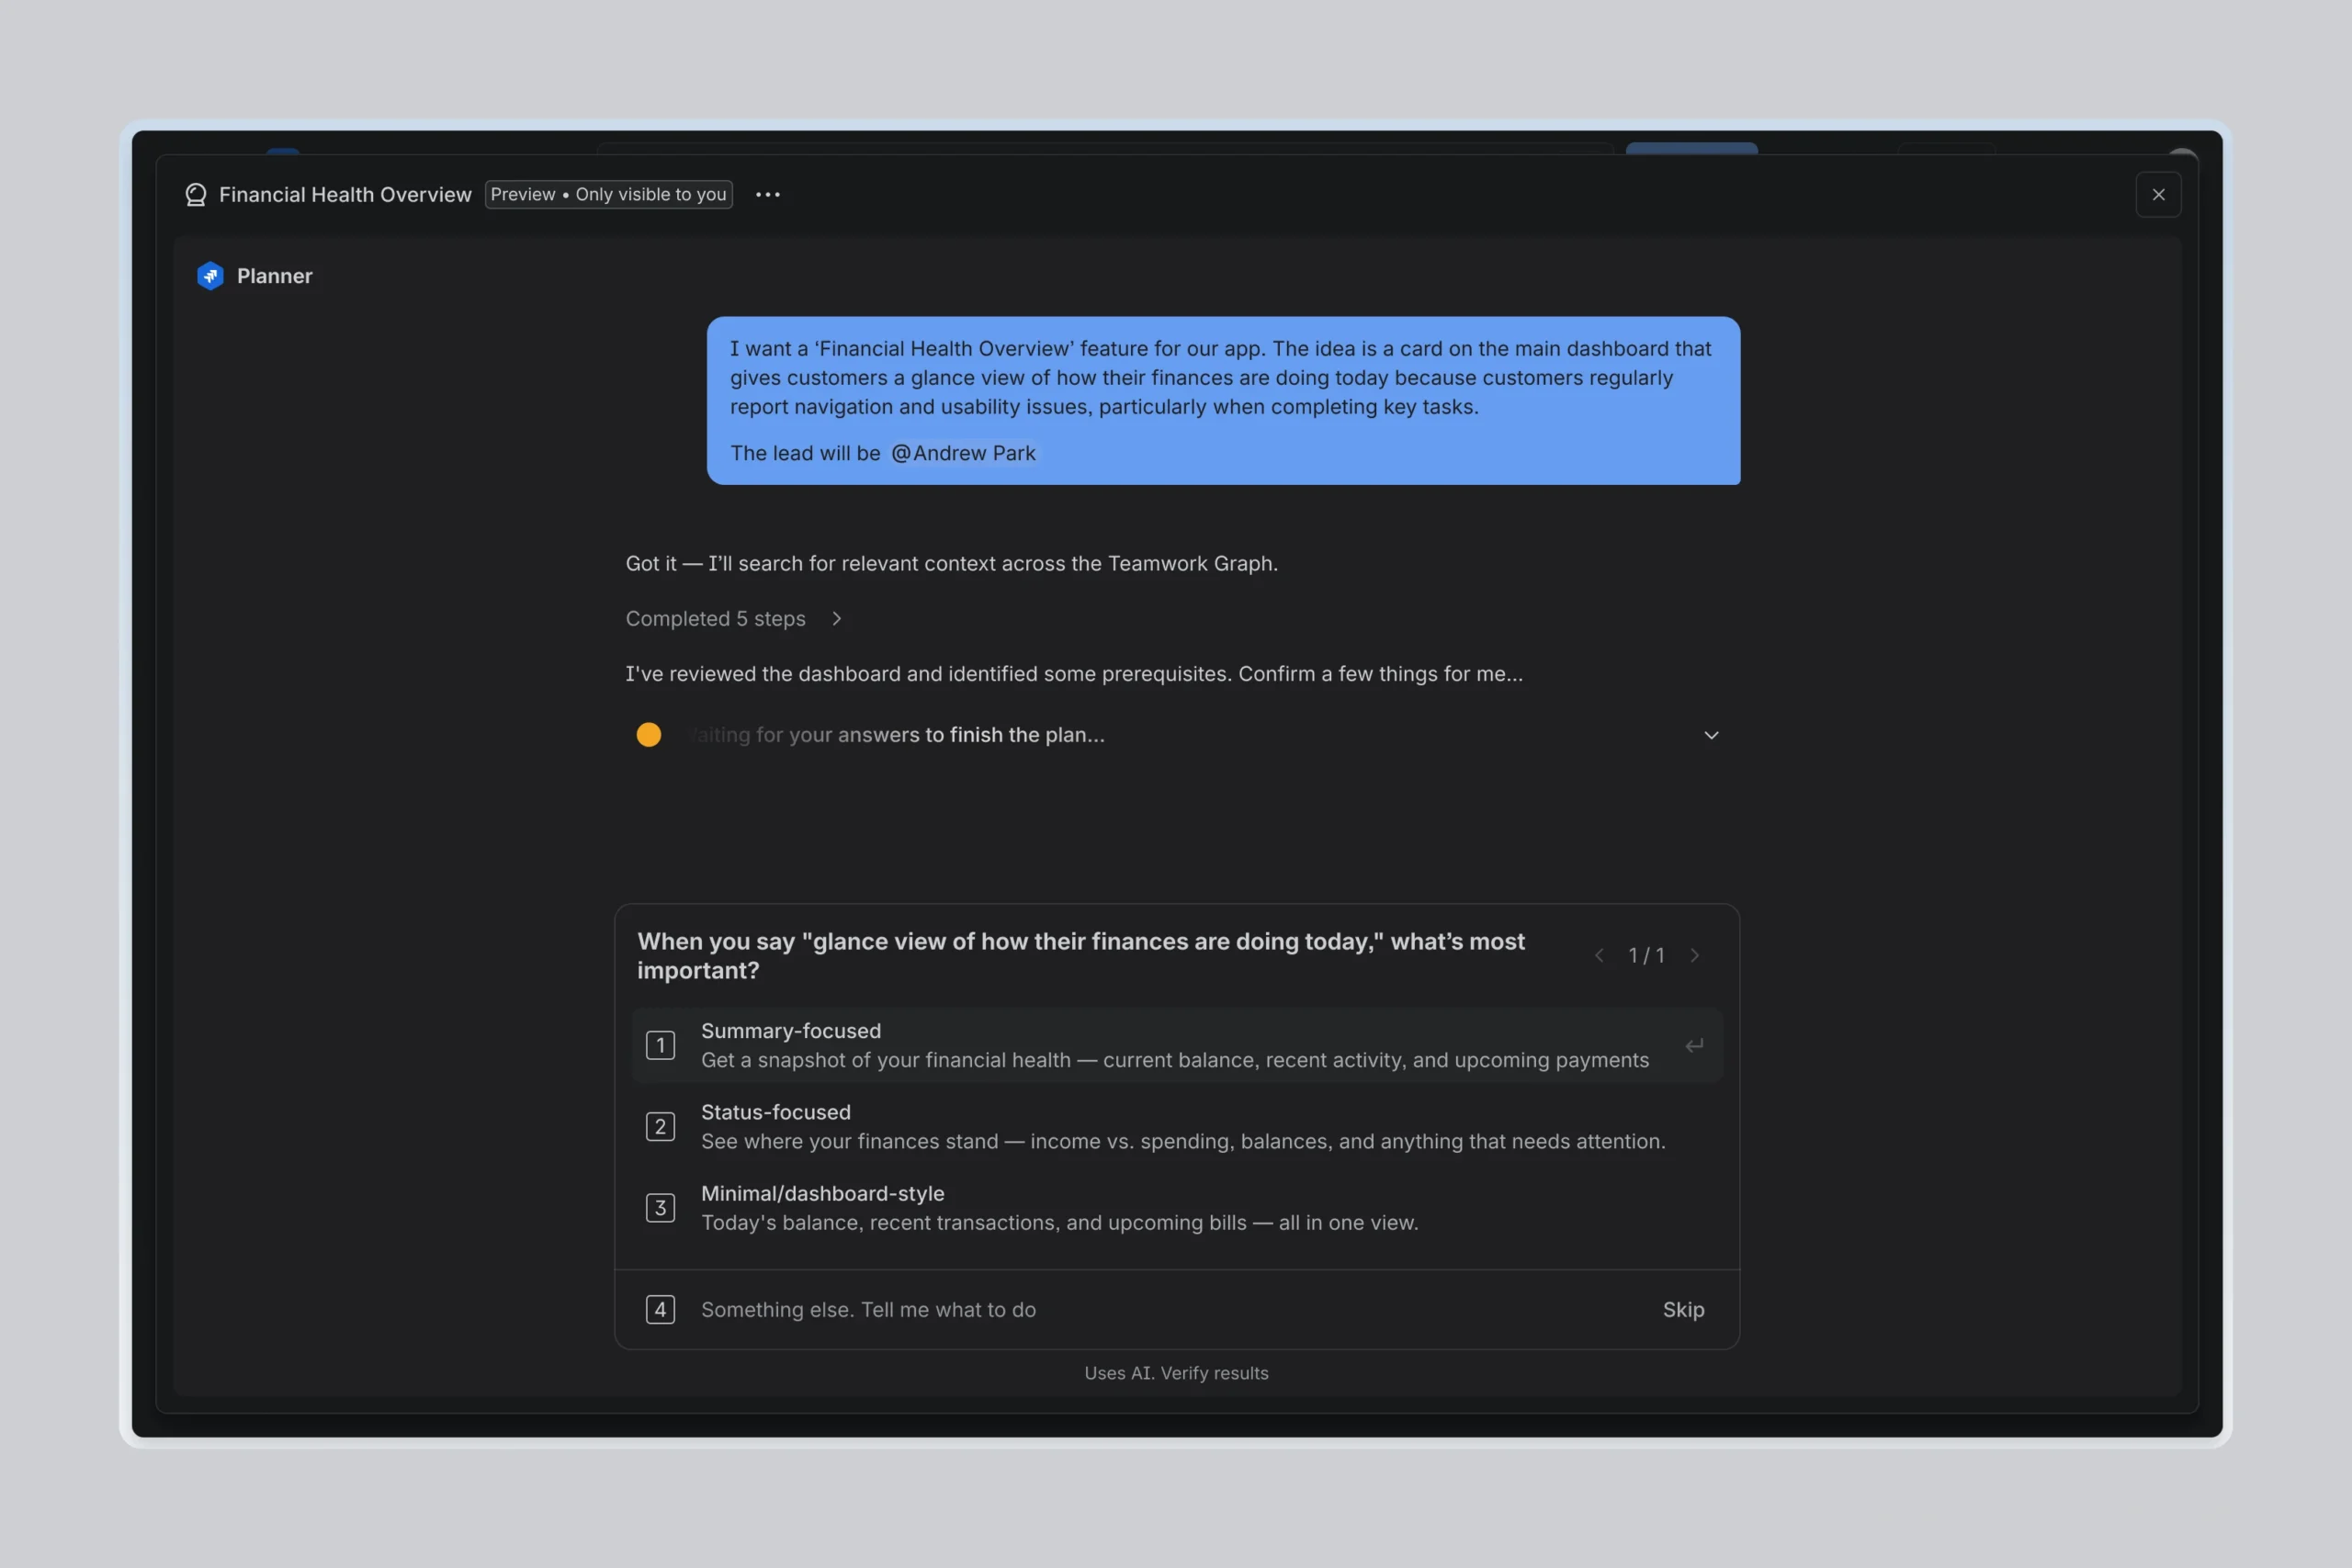
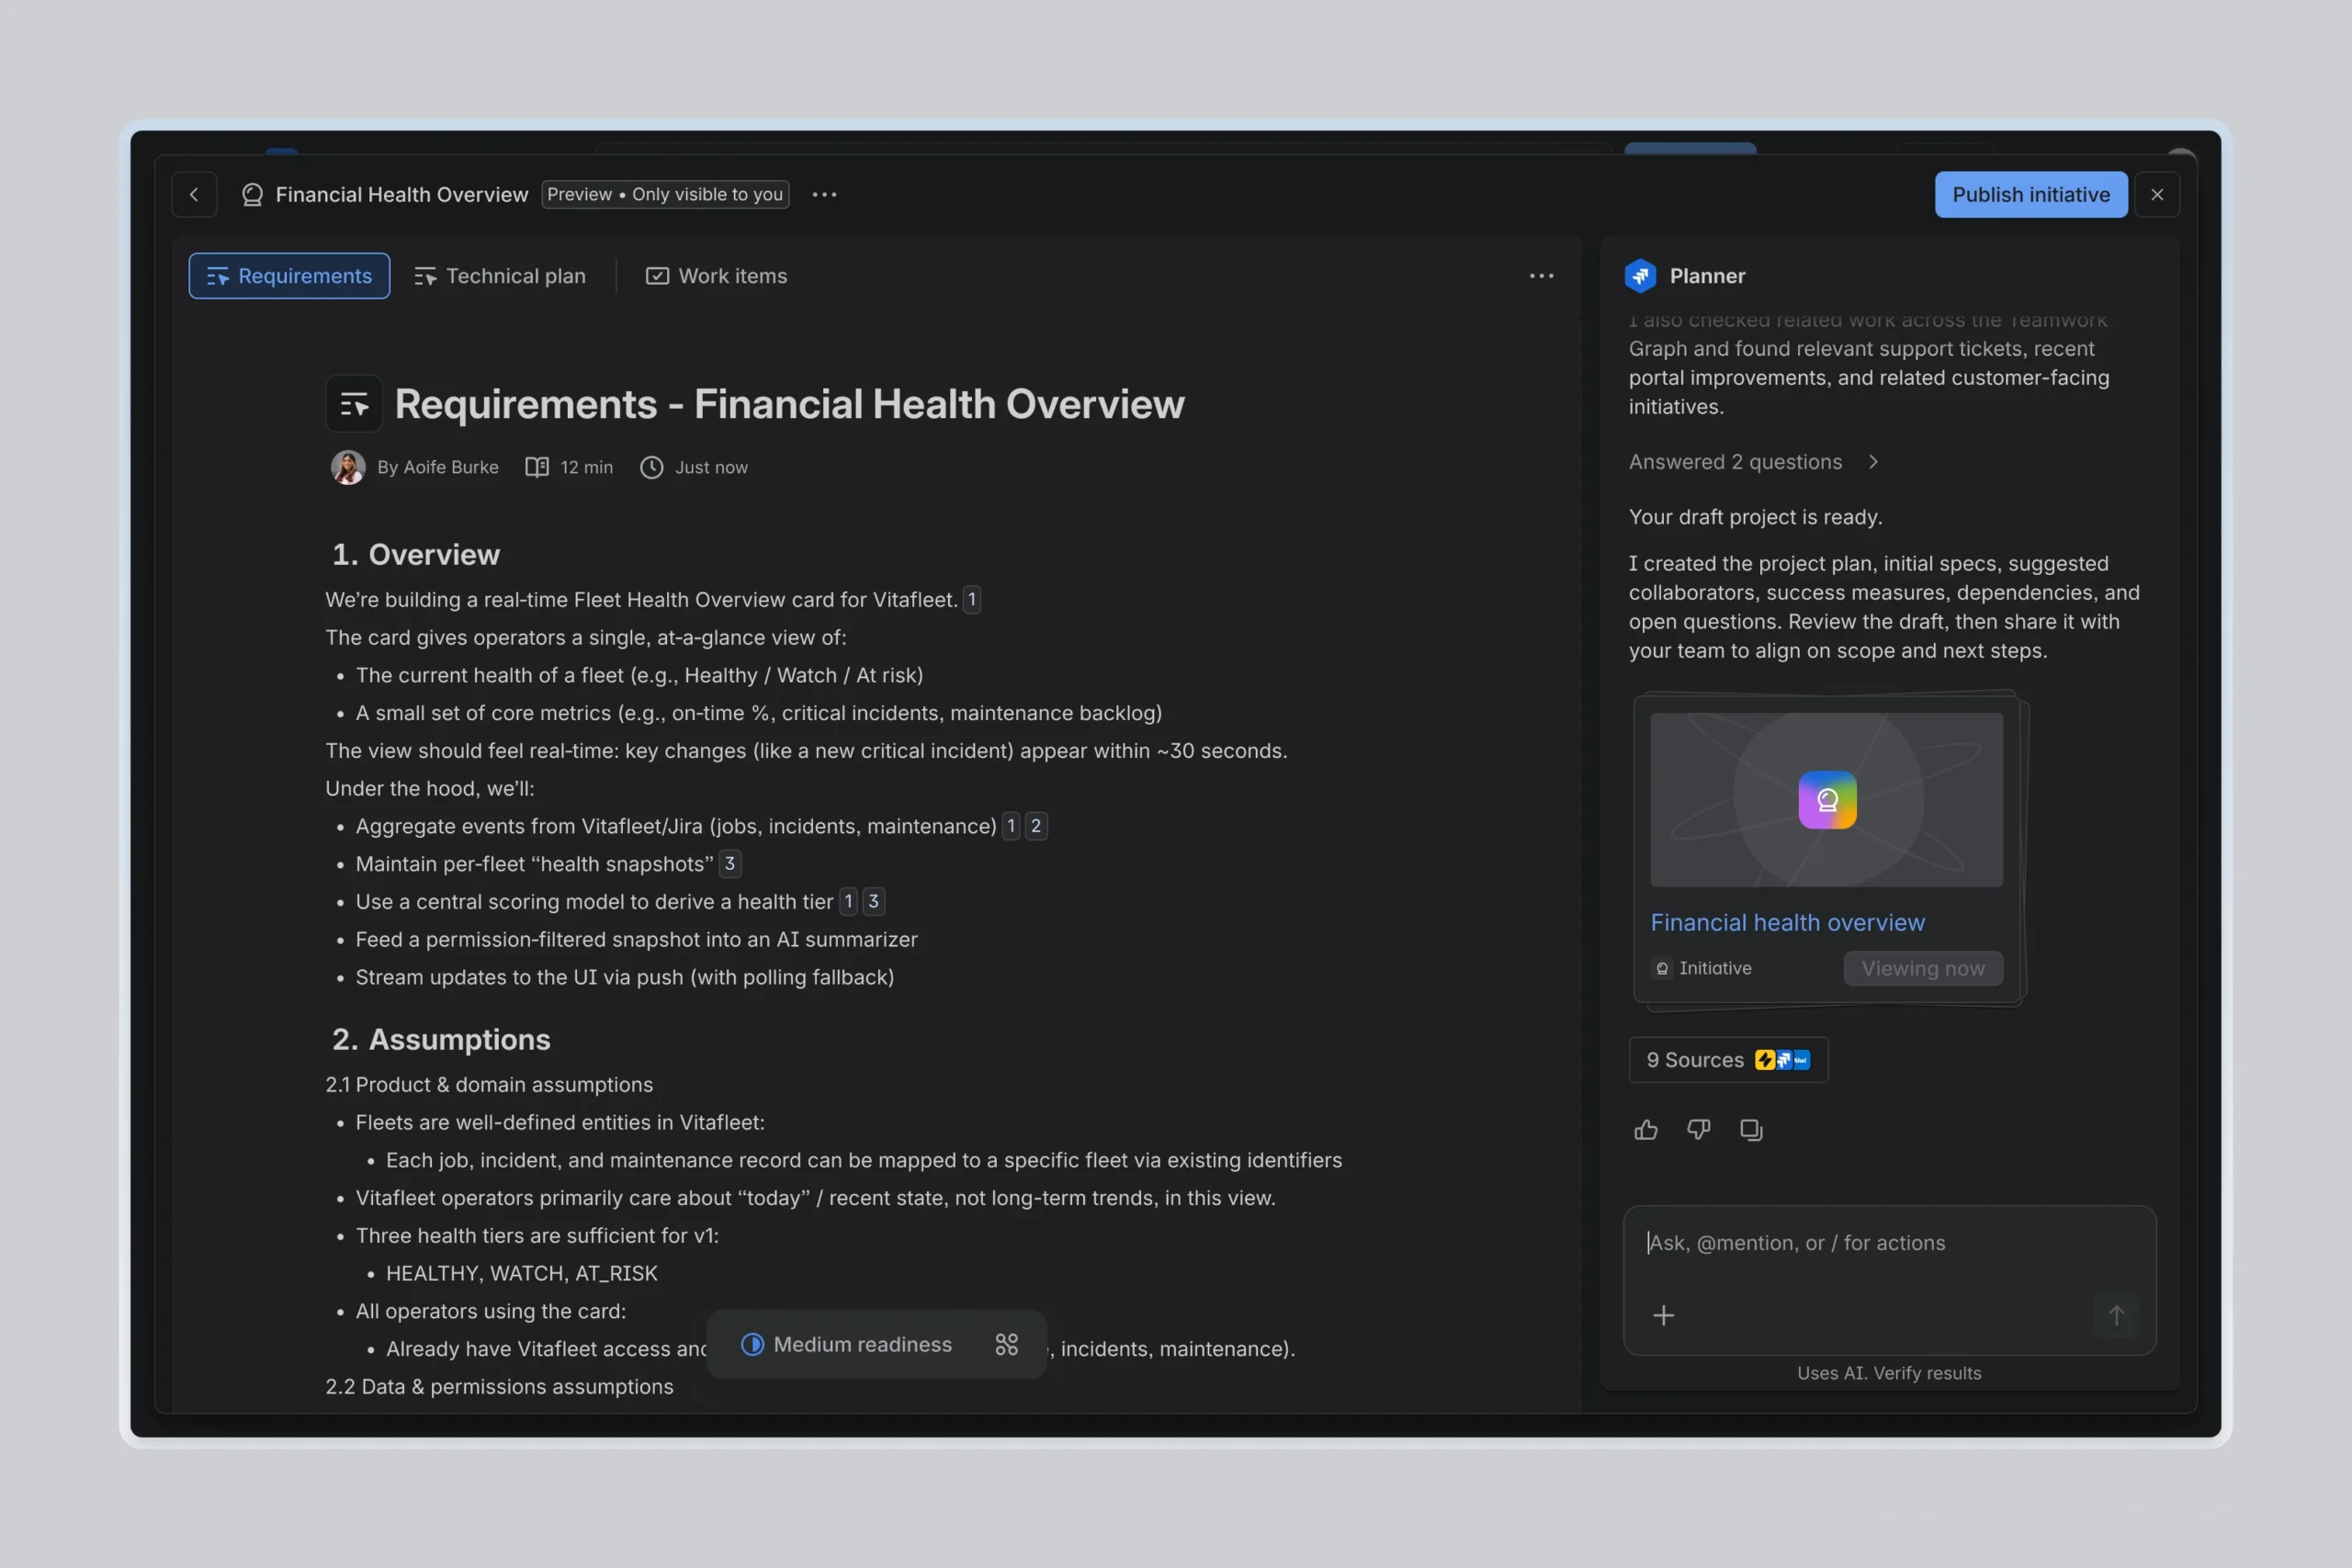
หาก AI requirements compiler คือสมอง Jira Planner ก็คือมือที่หยิบไอเดียดิบๆ มาจัดให้พร้อมใช้งานกับเอเจนต์ ตั้งแต่ต้นน้ำของกระบวนการพัฒนา Jira Planner ถูกออกแบบมาเป็นเลเยอร์ที่ขาดหายไประหว่างสิ่งที่ทีมตัดสินใจจะสร้าง กับวิธีที่เอเจนต์ลงมือทำงานต่อ มันแปลงไอเดียคร่าวๆ ให้เป็นสเปกที่มีโครงสร้าง ผูกกับโค้ดเบส มาตรฐาน และการตัดสินใจในอดีตของทีมอย่างเป็นความหมาย ไม่ใช่สเปกแบบลอยๆ
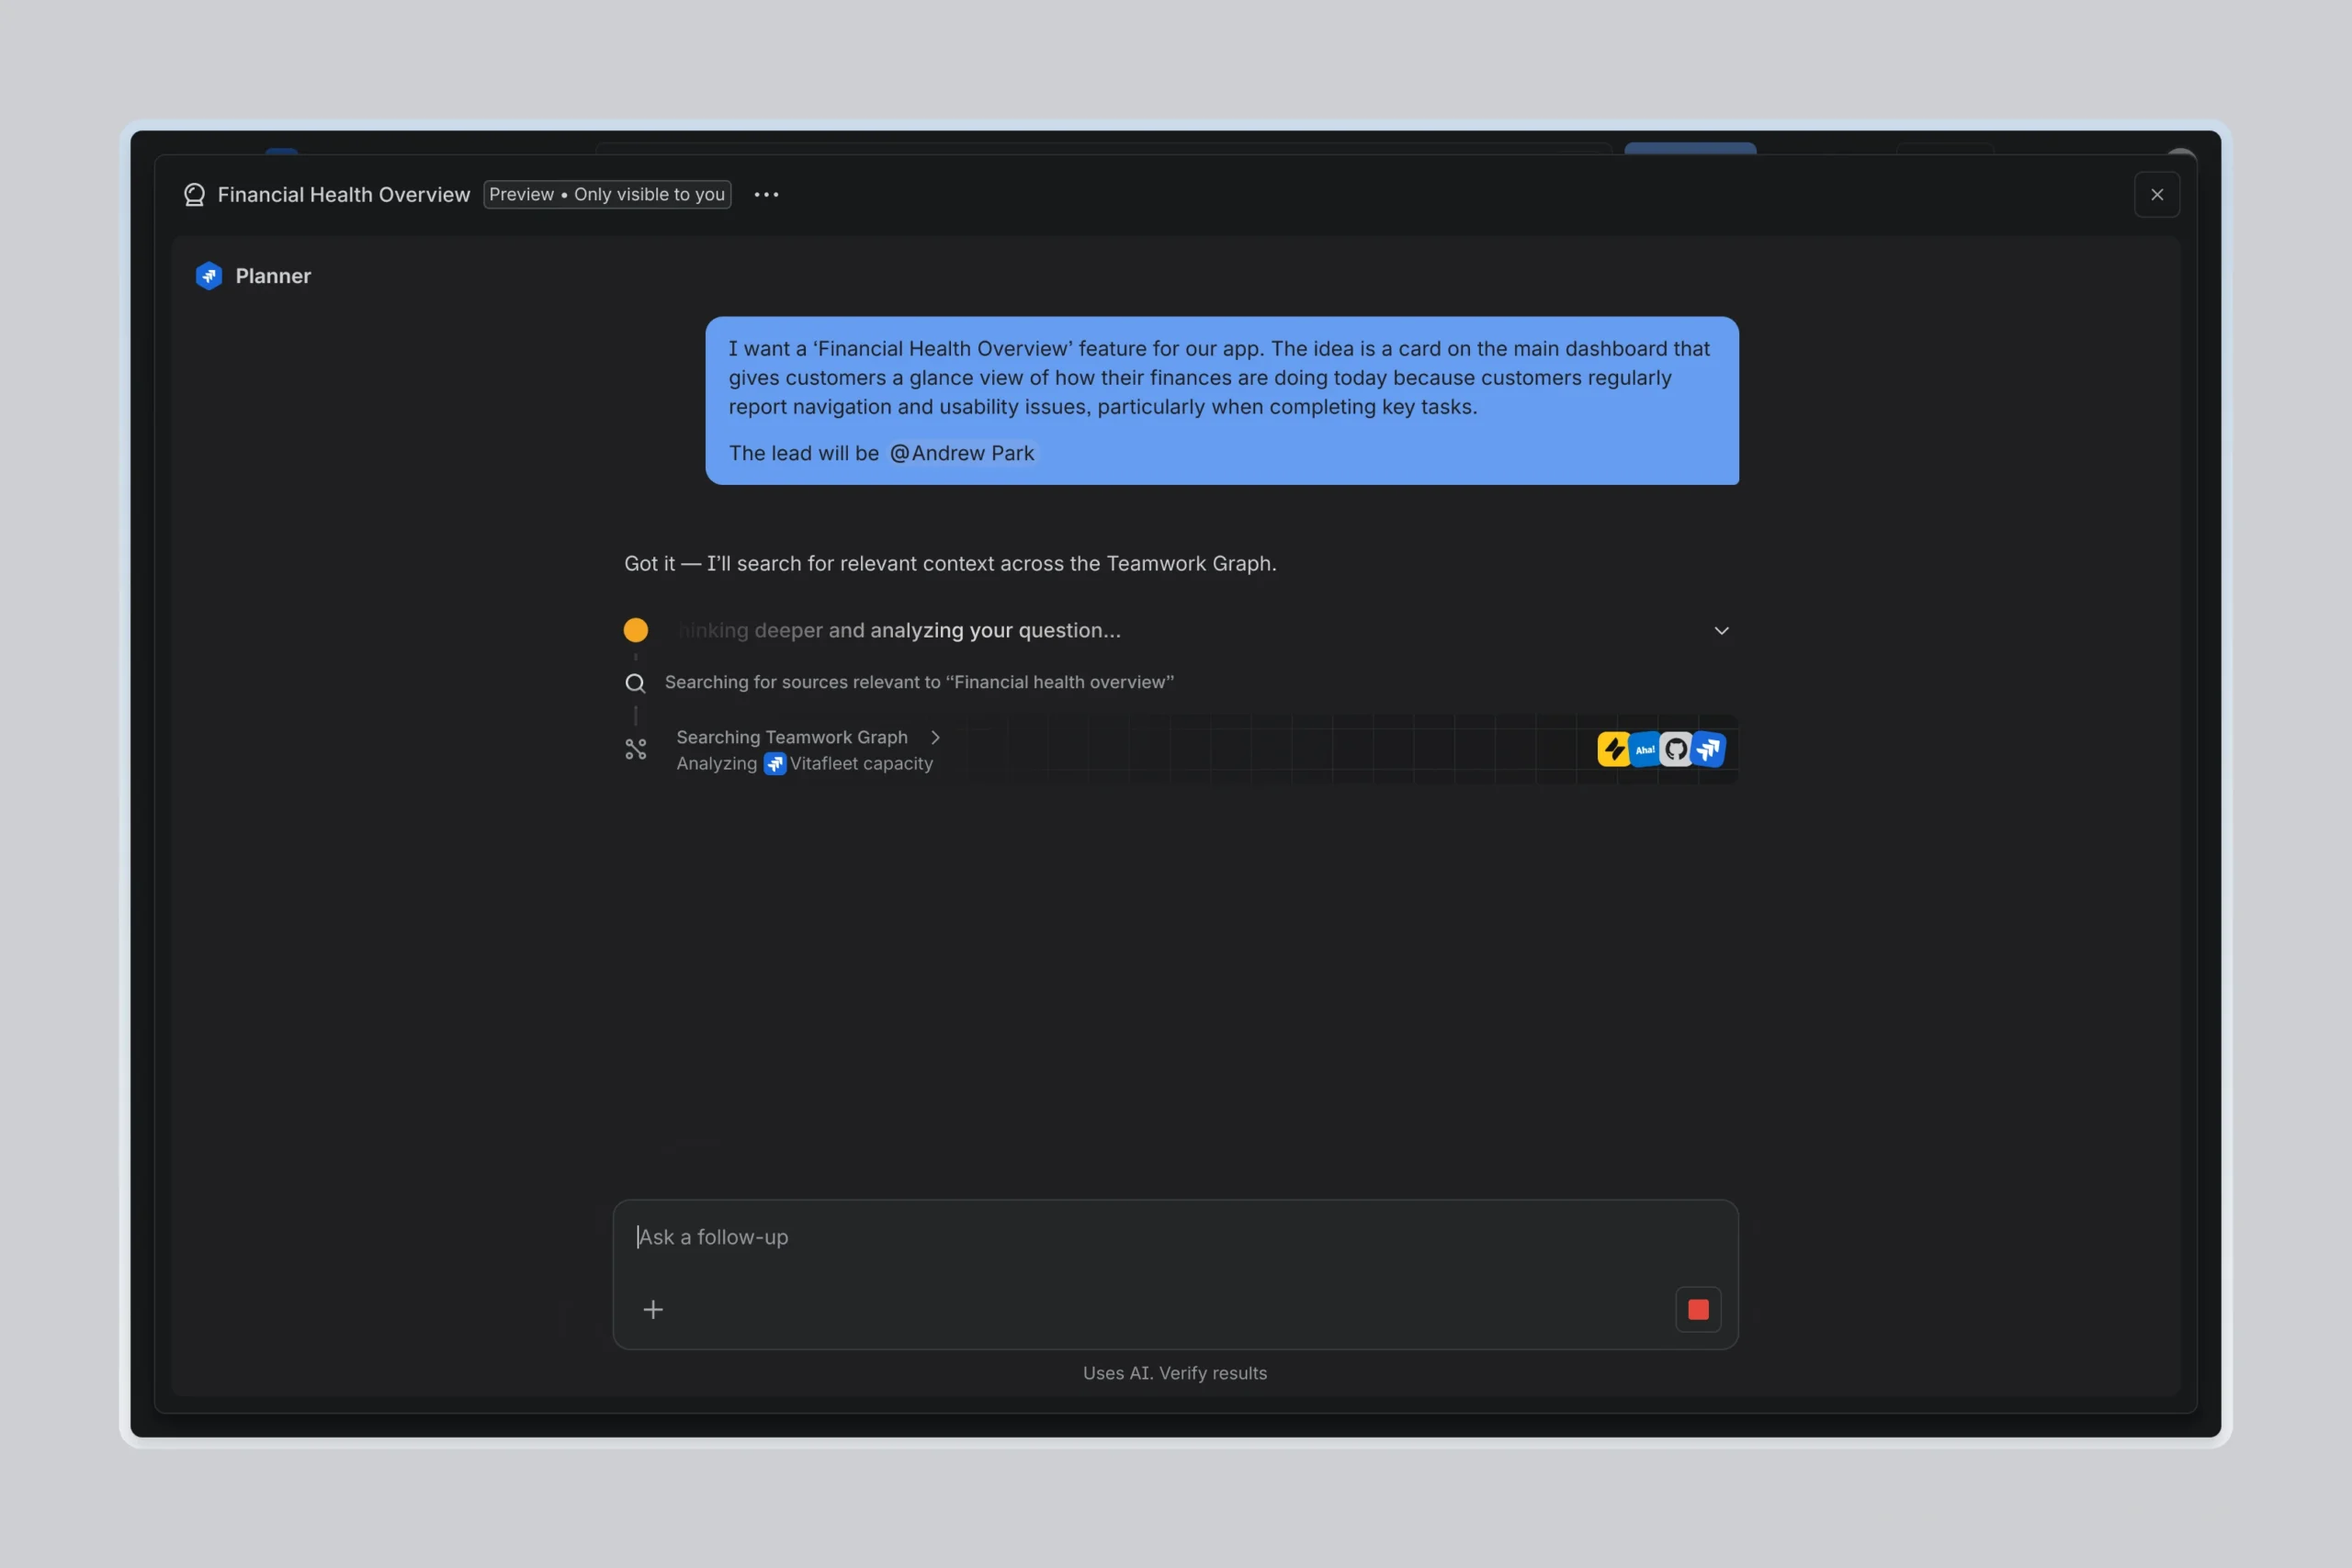
จุดสำคัญคือ Jira Planner เริ่มจากเป้าหมายแบบหยาบได้ แล้วถามคำถามต่อเนื่องเพื่อช่วยขยายขอบเขต ข้อจำกัด และความหมายของคำว่าความสำเร็จ จากนั้นอ่านโค้ดข้ามหลายรีโป ดึงข้อมูลจากกราฟทีมเวิร์ก เพื่อให้แผนสะท้อนโครงสร้างสถาปัตยกรรมและการเป็นเจ้าของงานจริงขององค์กร ไม่ใช่สมมติฐานทั่วไป เมื่อแผนเริ่มเป็นรูปเป็นร่าง มันจะสร้างเอกสารที่แก้ไขร่วมกันได้ เชื่อมกับระบบติดตามงาน ทำให้วิศวกร PM และดีไซเนอร์ถกเถียงและจัดแนวกันขณะสเปกยังเปลี่ยนได้ ไม่ใช่ตอนกำหนดทุกอย่างตายตัวแล้ว
จากกราฟข้อกำหนดสู่เทสต์เคส: เมื่อสเปกทำตัวเหมือนคอมไพเลอร์
หัวใจของ AI requirements compiler คือการเปลี่ยน “คำบอกเล่า” ให้เป็นกราฟของข้อกล่าวอ้างแบบมีชนิดข้อมูล เริ่มจากคำขอและหลักฐานดิบ แปลงเป็นเคลมที่มีโครงสร้าง สร้างโมเดลโดเมนปกติ ตรวจหาช่องว่างและความขัดแย้ง แล้วค่อยแตกออกเป็นอินเทอร์เฟซและเทสต์ยอมรับ ก่อนจะเรนเดอร์เป็นวิวของสเปกหลายแบบ ผลลัพธ์ถาวรจึงเป็นกราฟ ไม่ใช่ย่อหน้าเดียวที่อ่านราบรื่นแต่ตรวจสอบยาก
แต่ละเคลมต้องผูกกับหลักฐานระบุได้ เช่น เซกเมนต์สัมภาษณ์ เวลาอ้างอิง คอมเมนต์ทิกเก็ต เวอร์ชันของนโยบาย หรือสคีมาของ API ที่มีอยู่เดิม พร้อมสถานะความเชื่อมั่น เช่น สนับสนุน คาดเดา ขัดแย้ง หรือไม่มีแหล่งที่มา เมื่อระบบพบข้อกำหนดสองข้อที่ขัดกัน เช่น กติกาตรงข้าม ตัวเลขจำกัดไม่ลงกัน สิทธิ์ซ้อนกัน หรือสเตตแมชชีนไปต่อไม่ได้ มันจะสร้างเรคคอร์ดข้อขัดแย้ง พร้อมคำอธิบายและเจ้าของการแก้ไข แทนที่จะพยายามหาคำกลางมาเบลอปัญหา จากตรงนี้เองที่อินเทอร์เฟซและเทสต์เคสสามารถถูกคอมไพล์ออกมาอย่างเป็นระบบ
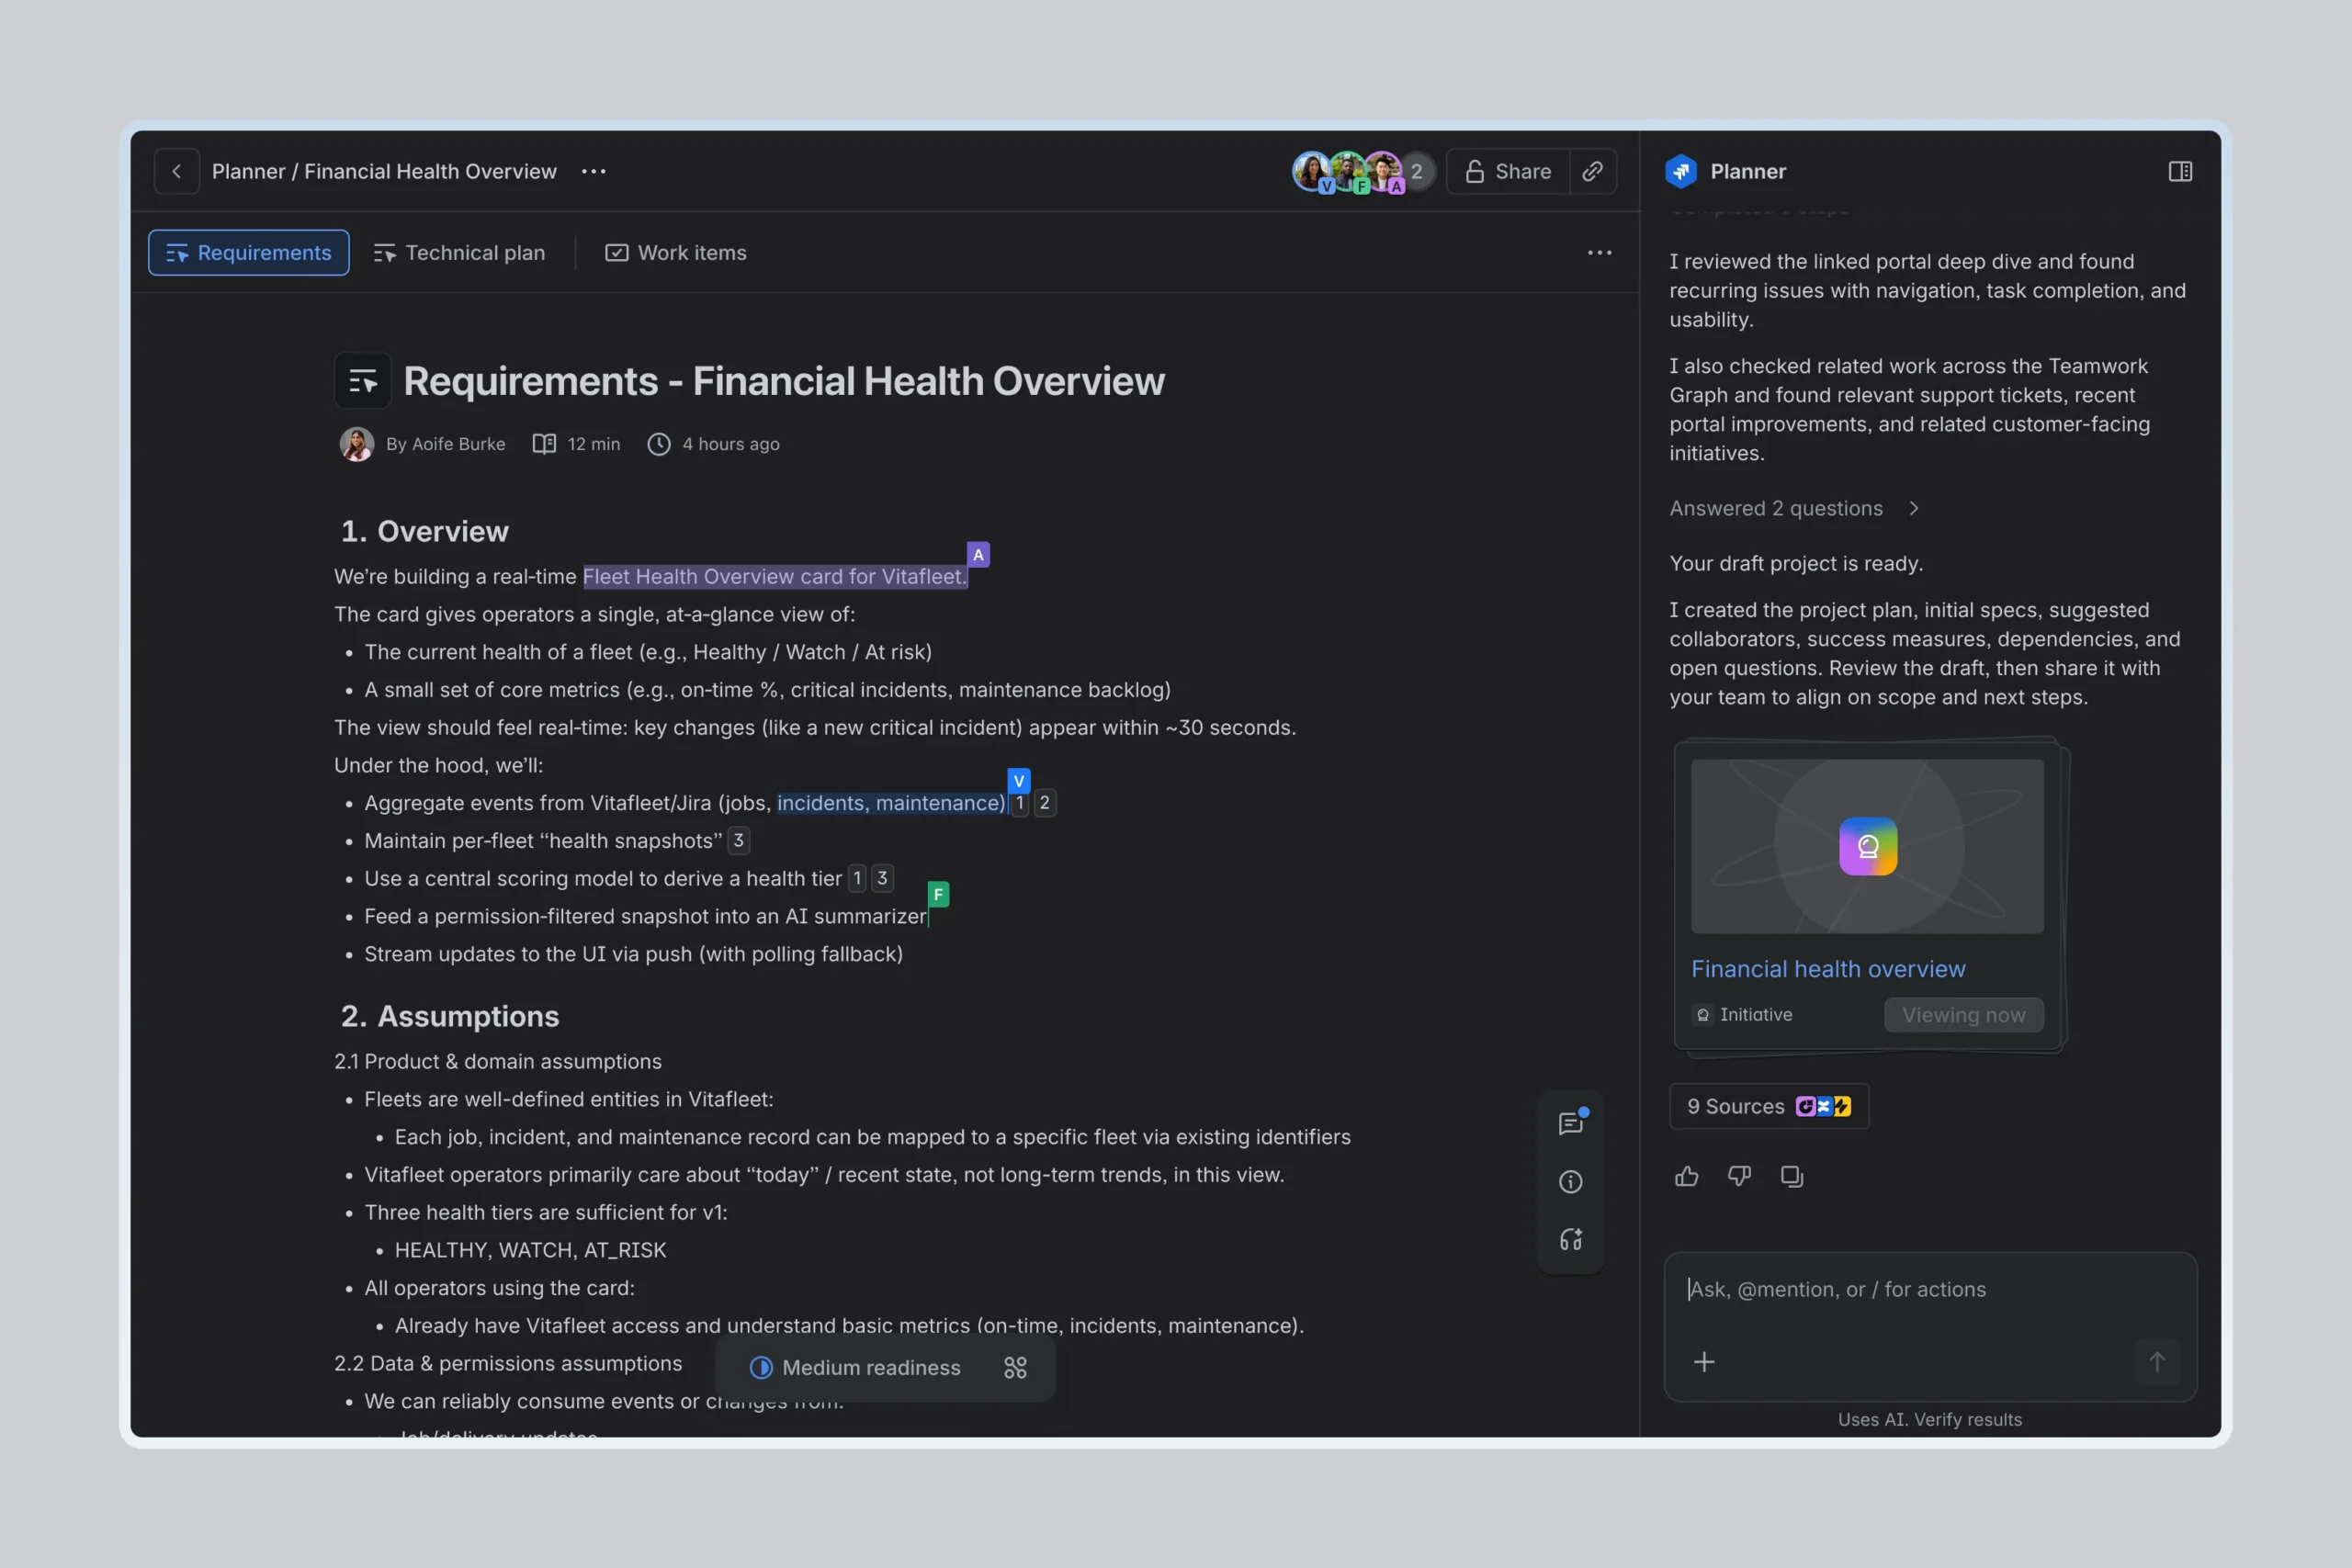
เมื่อการวางแผนซอฟต์แวร์กลายเป็นอัตโนมัติ: จาก Spec สู่งานและเอเจนต์
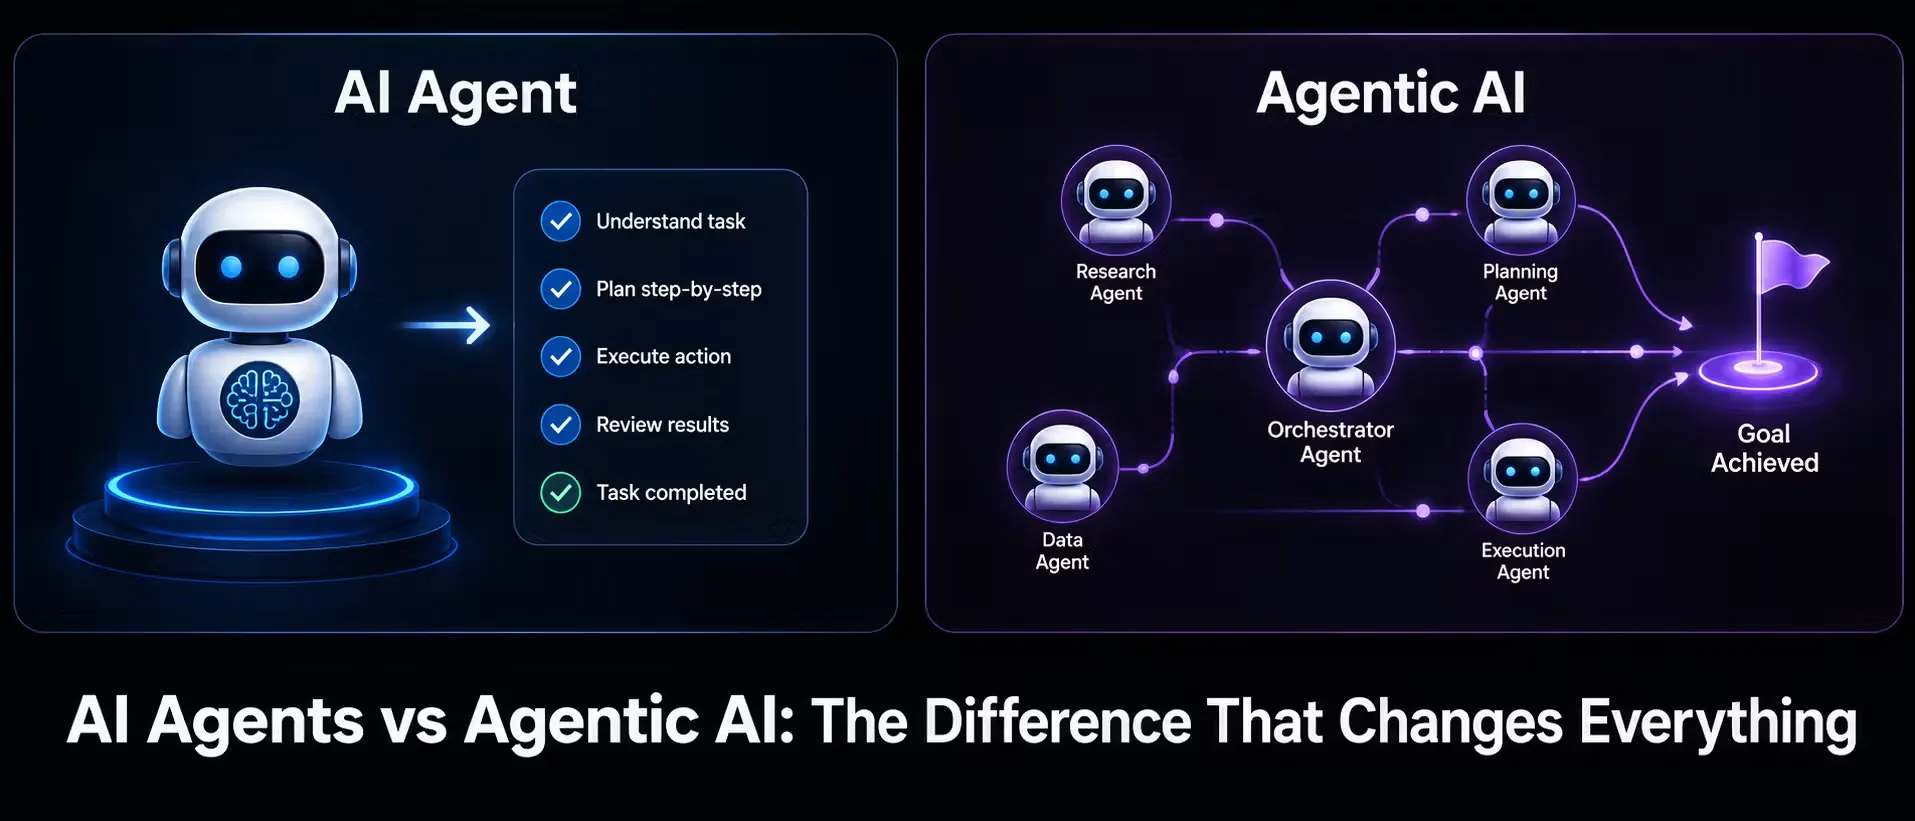
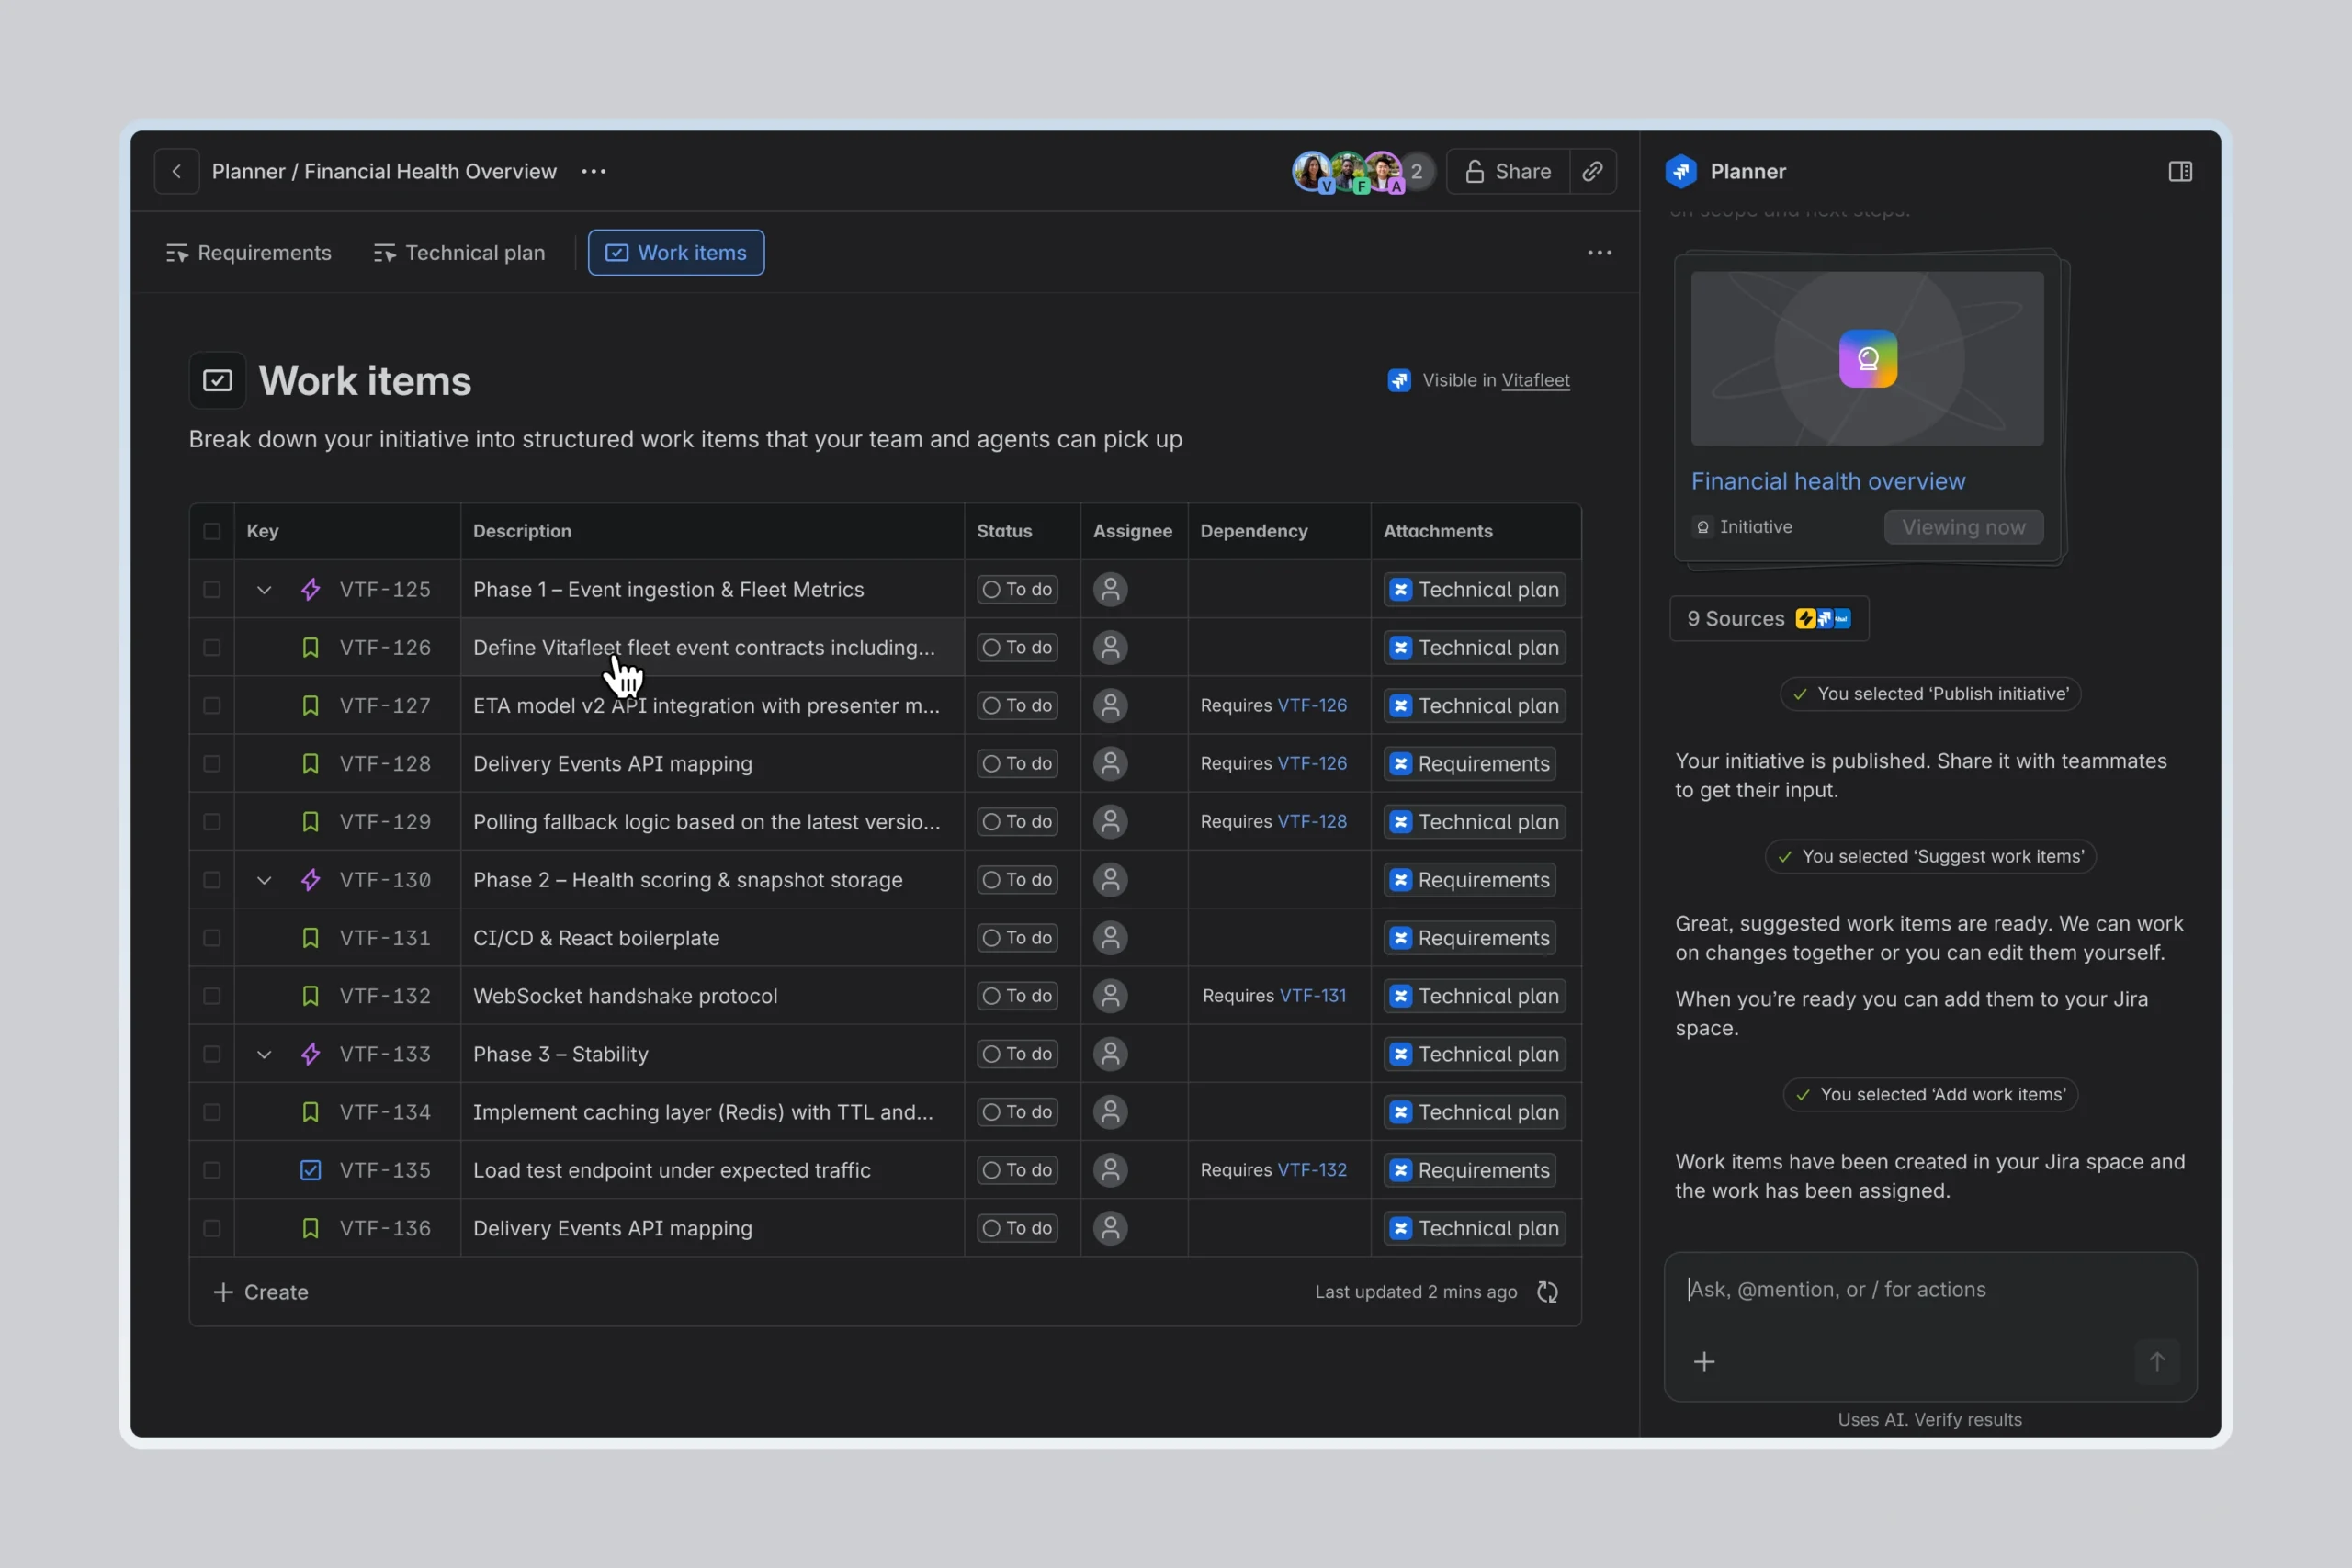
การวางแผนซอฟต์แวร์กำลังไหลจากงานสเปรดชีตและเอกสารยาวเหยียดไปสู่สายพานอัตโนมัติแบบ Spec → Plan → Tasks → Implement ที่รักษาเจตนารมณ์ผ่านทุกขั้นตอน Jira Planner เสริมให้สายพานนี้มีตัวกลางที่แปลงสเปกให้เป็นรายการงานในระบบจัดการงาน โดยมีการจัดลำดับ การพึ่งพา ไมล์สโตน และเงื่อนไขยอมรับแนบไปกับแต่ละงาน พร้อมคอนเท็กซ์จากแผนเต็ม จากนั้นระบบจัดการเอเจนต์สามารถรับช่วงต่อจากจุดที่ขั้นตอนการวางแผนจบลงทันที
ผลคือทีมที่นิยามสิ่งที่จะสร้าง เช่น เทกลีด วิศวกรอาวุโส ผู้จัดการวิศวกรรม และ PM ที่ดูแลงานหลายสปรินต์หรือการตัดสินใจเชิงสถาปัตย์ ได้ความชัดเจนและการมองเห็นงานมากขึ้น โดยไม่ต้องลุยเขียนสเปกด้วยมือจากศูนย์ทุกครั้ง ประโยคที่ควรจำคือ “คอขวดของการพัฒนาซอฟต์แวร์ด้วย AI ไม่ใช่การสร้างโค้ด แต่คือความชัดเจนของเจตนา” และตัวเลขที่สะท้อนแรงขับเคลื่อนคือ 60% ของผู้นำวิศวกรรมกำลังขยับมาสู่แนวทางพัฒนาที่ขับเคลื่อนด้วยสเปก แต่มีไม่ถึง 15% ที่มีเฟรมเวิร์กที่เป็นระบบรองรับ
ทำไม PRD อัตโนมัติแบบมีความไม่แน่นอนจึงดีกว่าด็อกยาวๆ ที่ดูสมบูรณ์
แนวคิดเรื่อง automated PRD generation ที่มีคุณค่าจริงไม่ใช่เอกสารที่ดูสวยครบ แต่คือผลลัพธ์ที่ทำให้ความไม่แน่นอนเด่นชัด แทนที่จะกลบมันด้วยภาษาเรียบเนียน ระบบข้อกำหนดที่ดีควรกล้าแสดงผลลัพธ์ประมาณว่า มีเคลมที่ได้รับการสนับสนุน 17 ข้อ เคลมที่คาดเดาต้องยืนยัน 3 ข้อ ความขัดแย้งด้านนโยบาย 2 รายการ เงื่อนไขยอมรับที่หายไป 5 ข้อ เจ้าของการตัดสินใจด้าน retention ที่ยังไม่ชัด 1 เรื่อง และยังไม่พร้อมปล่อยผลิตภัณฑ์จริงเลยสักเวอร์ชัน ภาพที่ดูไม่ประทับใจนี้มีประโยชน์กว่าด็อกยาวสี่สิบหน้าที่สร้างความมั่นใจผิดๆ มากนัก
ที่สำคัญ Jira Planner เองมีการตรวจความพร้อมของสเปกก่อนลงมือ เพื่อบอกว่ามีจุดกำกวมตรงไหน และควรเติมอะไรให้ละเอียดพอสำหรับลงมือ เมื่อรวมกับฐานคิดของ AI requirements compiler ที่เน้นกราฟข้อกำหนด การเชื่อมหลักฐาน และการแตกอินเทอร์เฟซกับเทสต์จากกติกาที่ตกผลึกแล้ว เราจึงเห็นภาพของ autonomous SDLC ที่ตั้งต้นจากสเปกที่ตรวจสอบได้ แทนการเริ่มเขียนโค้ดจากเจตนาที่เบลอในหัวคน งานที่เคยเป็นการกรอกสเปรดชีตด้วยมือกลายเป็นงานออกแบบกราฟความหมาย แล้วปล่อยให้ระบบอัตโนมัติจัดการรายละเอียดส่วนใหญ่แทน