
วิกฤต AI ที่ไม่คืนทุน แท้จริงคือวิกฤตความเชื่อมั่นในข้อมูล
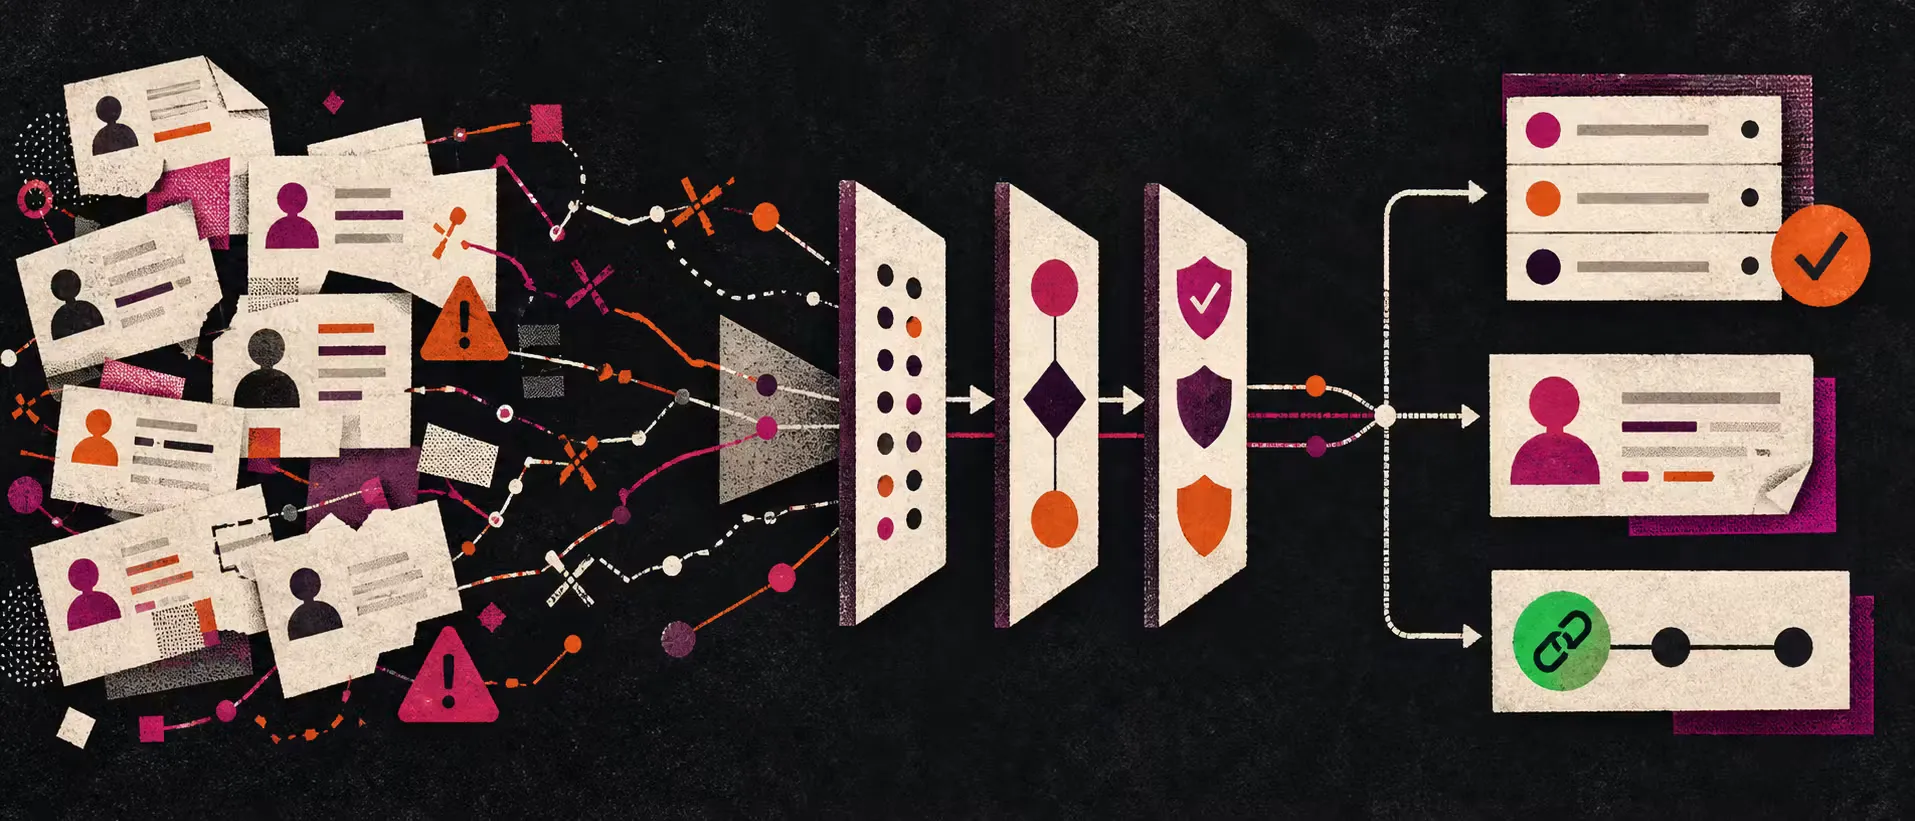
วิกฤตความเชื่อมั่นข้อมูลในโครงการ AI ระดับองค์กร คือสถานการณ์ที่องค์กรลงทุนพัฒนาและใช้งานระบบ AI อย่างแพร่หลาย แต่ไม่สามารถวัดหรือบรรลุผลตอบแทนทางธุรกิจได้ เนื่องจากขาดการทำให้ข้อมูลมีคุณภาพ เชื่อถือได้ และตรวจสอบย้อนกลับได้แบบมีระบบ ส่งผลให้โมเดล AI สร้างผลลัพธ์ที่ดูมั่นใจแต่ผิดพลาด ผู้ใช้ไม่ไว้วางใจ และองค์กรไม่สามารถใช้ข้อมูลและผลลัพธ์เหล่านั้นเพื่อการตัดสินใจหรือสร้างคุณค่าทางธุรกิจอย่างต่อเนื่อง งานวิจัยโครงการ NANDA ของสถาบันหนึ่งพบว่า แม้องค์กรจะทุ่มเงินจำนวนมากให้กับ AI สร้างสรรค์ แต่มีเพียงประมาณ 5% ของการใช้งานระดับองค์กรกว่า 300 รายการเท่านั้นที่ให้ผลตอบแทนทางการเงินที่วัดได้ ตัวเลขนี้ไม่ใช่สัญญาณว่า AI ใช้การไม่ได้ แต่เป็นสัญญาณว่าระบบข้อมูลที่อยู่เบื้องหลังยังไม่น่าเชื่อถือ เมื่อข้อมูลขยะไหลเข้าสู่โมเดล ผลลัพธ์ก็กลายเป็นคำตอบที่ดูมั่นใจแต่ทำให้เกิดเหตุร้ายแทนที่จะเป็นอินไซต์เชิงธุรกิจที่ลงมือใช้ได้จริง วิกฤต AI enterprise failure rate จึงเริ่มต้นจากวิกฤต enterprise data trust มากกว่าจะเป็นเรื่องความเก่งของโมเดล
Data Quality และ Observability จุดแยก AI ที่ใช้การได้กับ AI ที่สร้างความวุ่นวาย
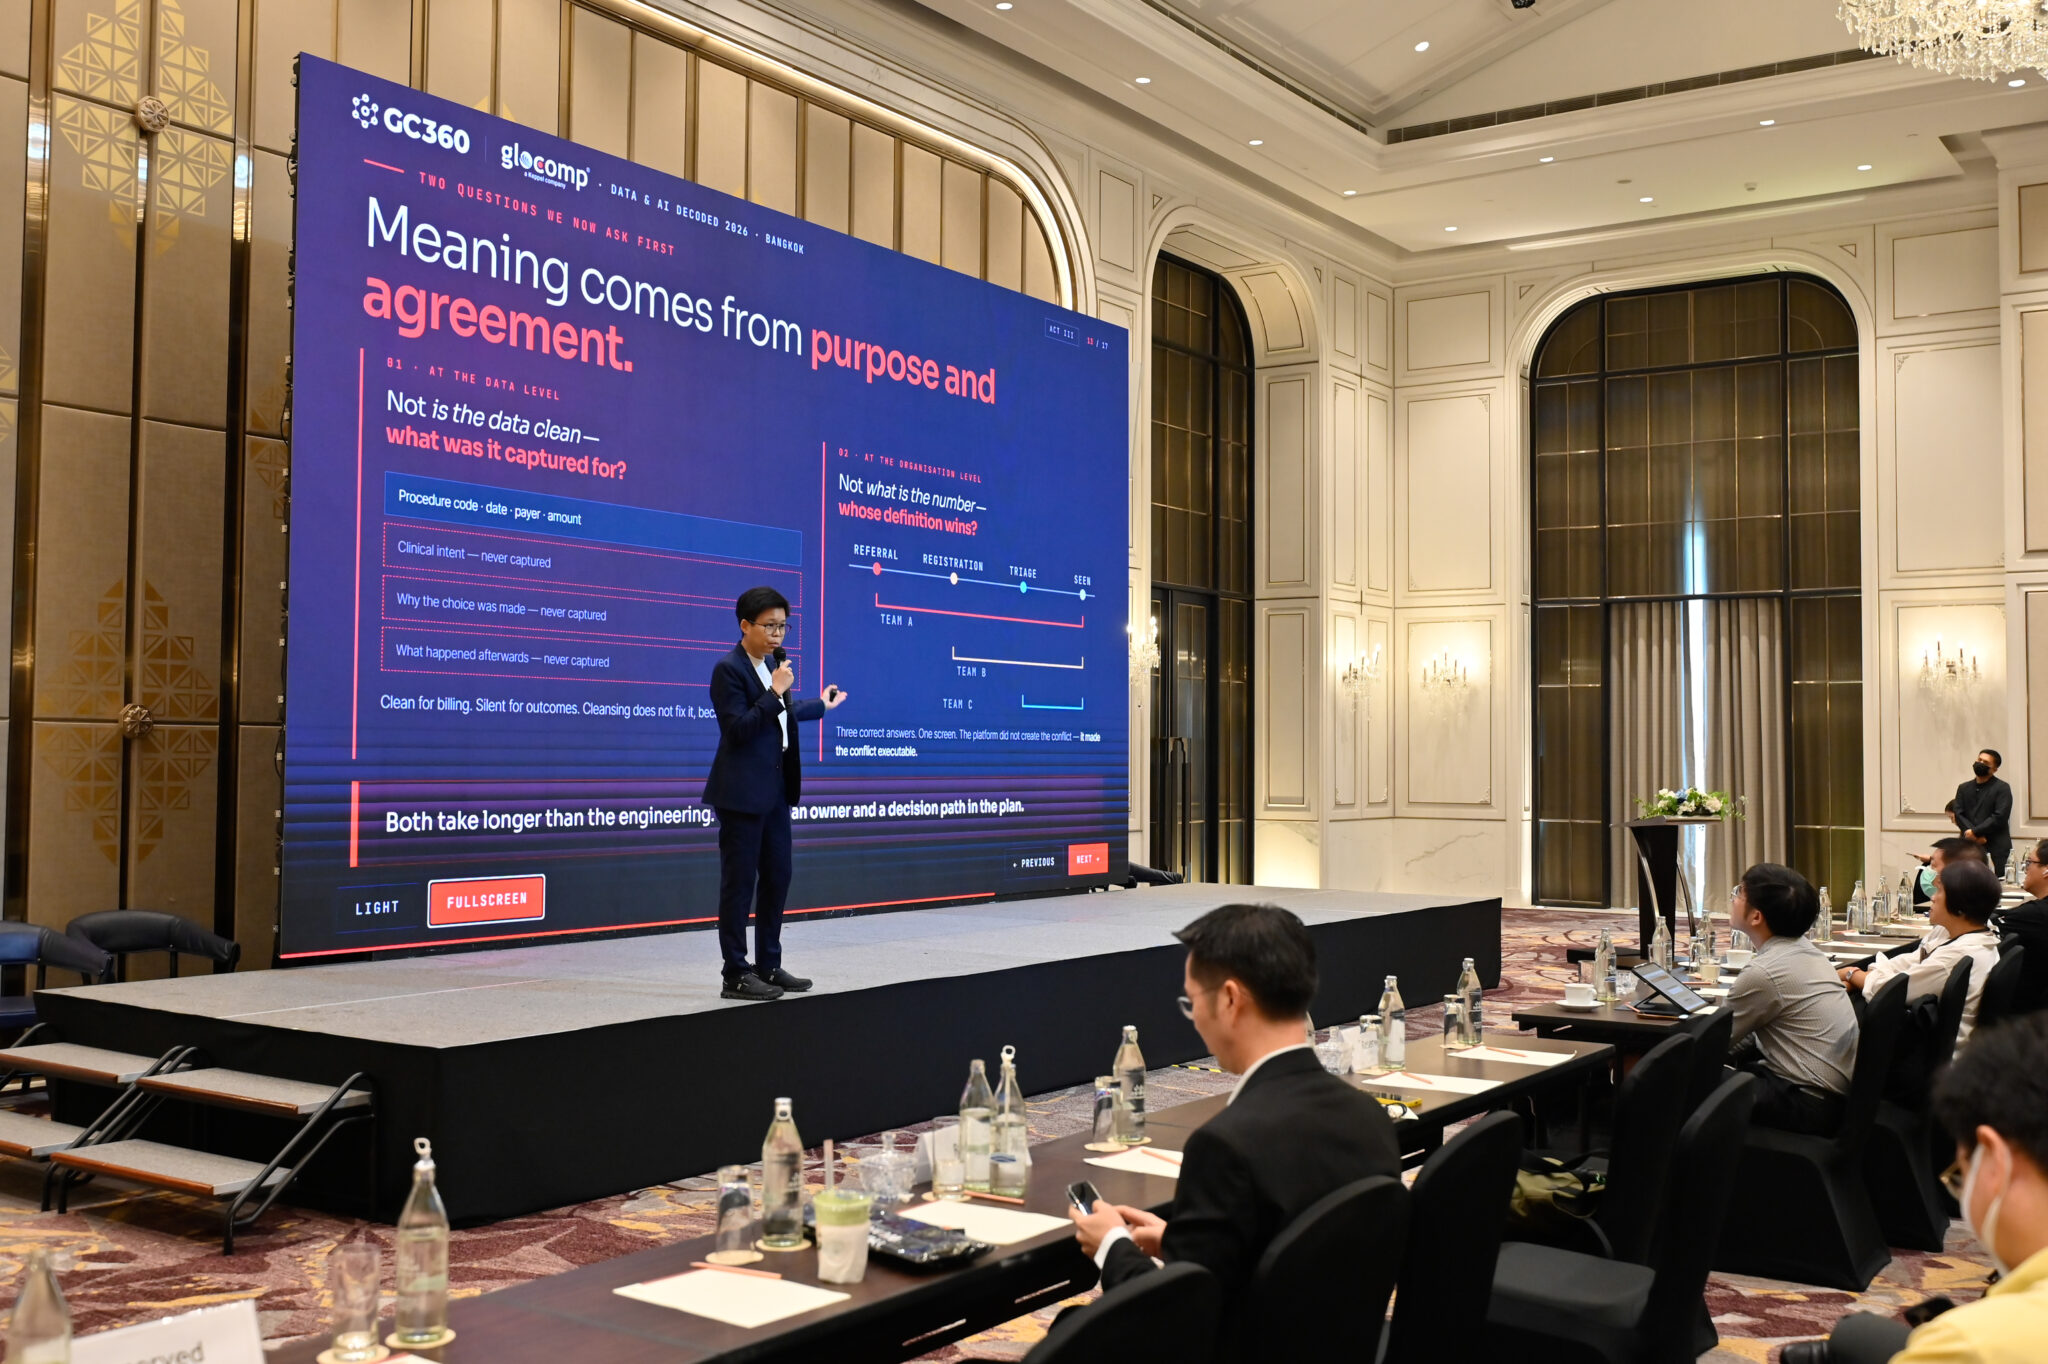
หากต้องอธิบายให้สั้นที่สุดว่าเหตุใด AI enterprise failure rate จึงสูงลิ่ว คำตอบคือองค์กรกำลังปล่อยให้โมเดลเรียนรู้จากข้อมูลที่ไม่รู้จัก ไม่เข้าใจ และไม่เคยตรวจสุขภาพ การไม่มี data quality observability ทำให้ไม่มีใครเห็นว่าในแต่ละปายทางของ data pipeline เกิดความผิดปกติอะไรบ้าง ข้อมูลไหนตกหล่น ผิดรูปแบบ หรือขัดกับกฎธุรกิจ เมื่อโมเดล AIถูกป้อนข้อมูลเหล่านี้ ผลลัพธ์ที่ออกมาจึงไม่สามารถนำไปใช้ตัดสินใจได้อย่างมั่นใจ งานด้าน Data Management และ Governance ในหลายองค์กรชี้ให้เห็นว่า การสร้าง Data Visibility คือหัวใจที่ทำให้องค์กรรู้ว่ามีข้อมูลอะไร อยู่ที่ไหน ใครเป็นเจ้าของ และอยู่ภายใต้กฎใดบ้าง เพื่อเตรียมข้อมูลให้พร้อมสำหรับ Trusted Analytics และ AI ได้อย่างมั่นใจ หากขาดโครงสร้างเช่นนี้ แชทบอทภายในจะตอบคำถามด้วยความมั่นใจจากข้อมูลที่ไม่ดี หรือข้อมูลมืดที่ไม่เคยถูกจัดการ ผู้ใช้จะเลิกเชื่อถือระบบทันที และต้องกลับไปใช้เครื่องมือ AI ส่วนบุคคลเพื่อทำงานแทนระบบองค์กร นี่คือจุดที่ AI Chaos เริ่มลุกลามในระดับปฏิบัติการ
จาก Monitoring สู่ Risk Management แพลตฟอร์ม Observability กำลังเปลี่ยนเกม AI
เมื่อระบบ IT และ AI ซับซ้อนขึ้นครอบคลุมตั้งแต่แอปพลิเคชัน ข้อมูล API คลาวด์ ไปจนถึงความปลอดภัยไซเบอร์ ความสำเร็จของ AI จึงขึ้นอยู่กับความสามารถในการมองเห็นและบริหารทุกชิ้นส่วนร่วมกัน ผู้ให้บริการแพลตฟอร์ม observability รายใหญ่เริ่มขยับจากการมองตัวเองเป็นเครื่องมือ monitoring ที่คอยแก้ปัญหาย้อนหลัง ไปสู่แพลตฟอร์มบริหารความเสี่ยงเชิงคาดการณ์สำหรับ AI workloads โดยมอง AI เป็น product system ที่ต้องดูพร้อมกันทั้งโมเดล data pipeline API cloud capacity security controls และรูปแบบการใช้ข้อมูล งานวิจัยหนึ่งพบว่า ประมาณ 5% ของคำสั่งที่ส่งไปยัง AI ล้มเหลวในการใช้งานจริง และมากกว่า 60% ของข้อผิดพลาดเกิดจากข้อจำกัดด้านกำลังรองรับของระบบ ไม่ใช่จากตัวโมเดล นั่นหมายความว่า failure ของ AI ROI measurement ส่วนใหญ่เกิดจากโครงสร้างพื้นฐานที่ไม่ถูกออกแบบให้โปร่งใสและปรับตัวได้ แพลตฟอร์ม observability รุ่นใหม่จึงเน้นให้ทีมวิศวกรรม ทีมความปลอดภัย และทีมธุรกิจเห็นภาพรวมเดียวกัน ตั้งแต่ประสิทธิภาพโมเดล การใช้โทเคน ไปจนถึงต้นทุนการรันงาน เพื่อให้สามารถจัดการความเสี่ยง ปรับทรัพยากร และป้องกันเหตุขัดข้องก่อนจะกระทบลูกค้า
บทเรียน Data First จากเวทีเทคโนโลยี สู่กลยุทธ์ AI ที่คืนทุนได้
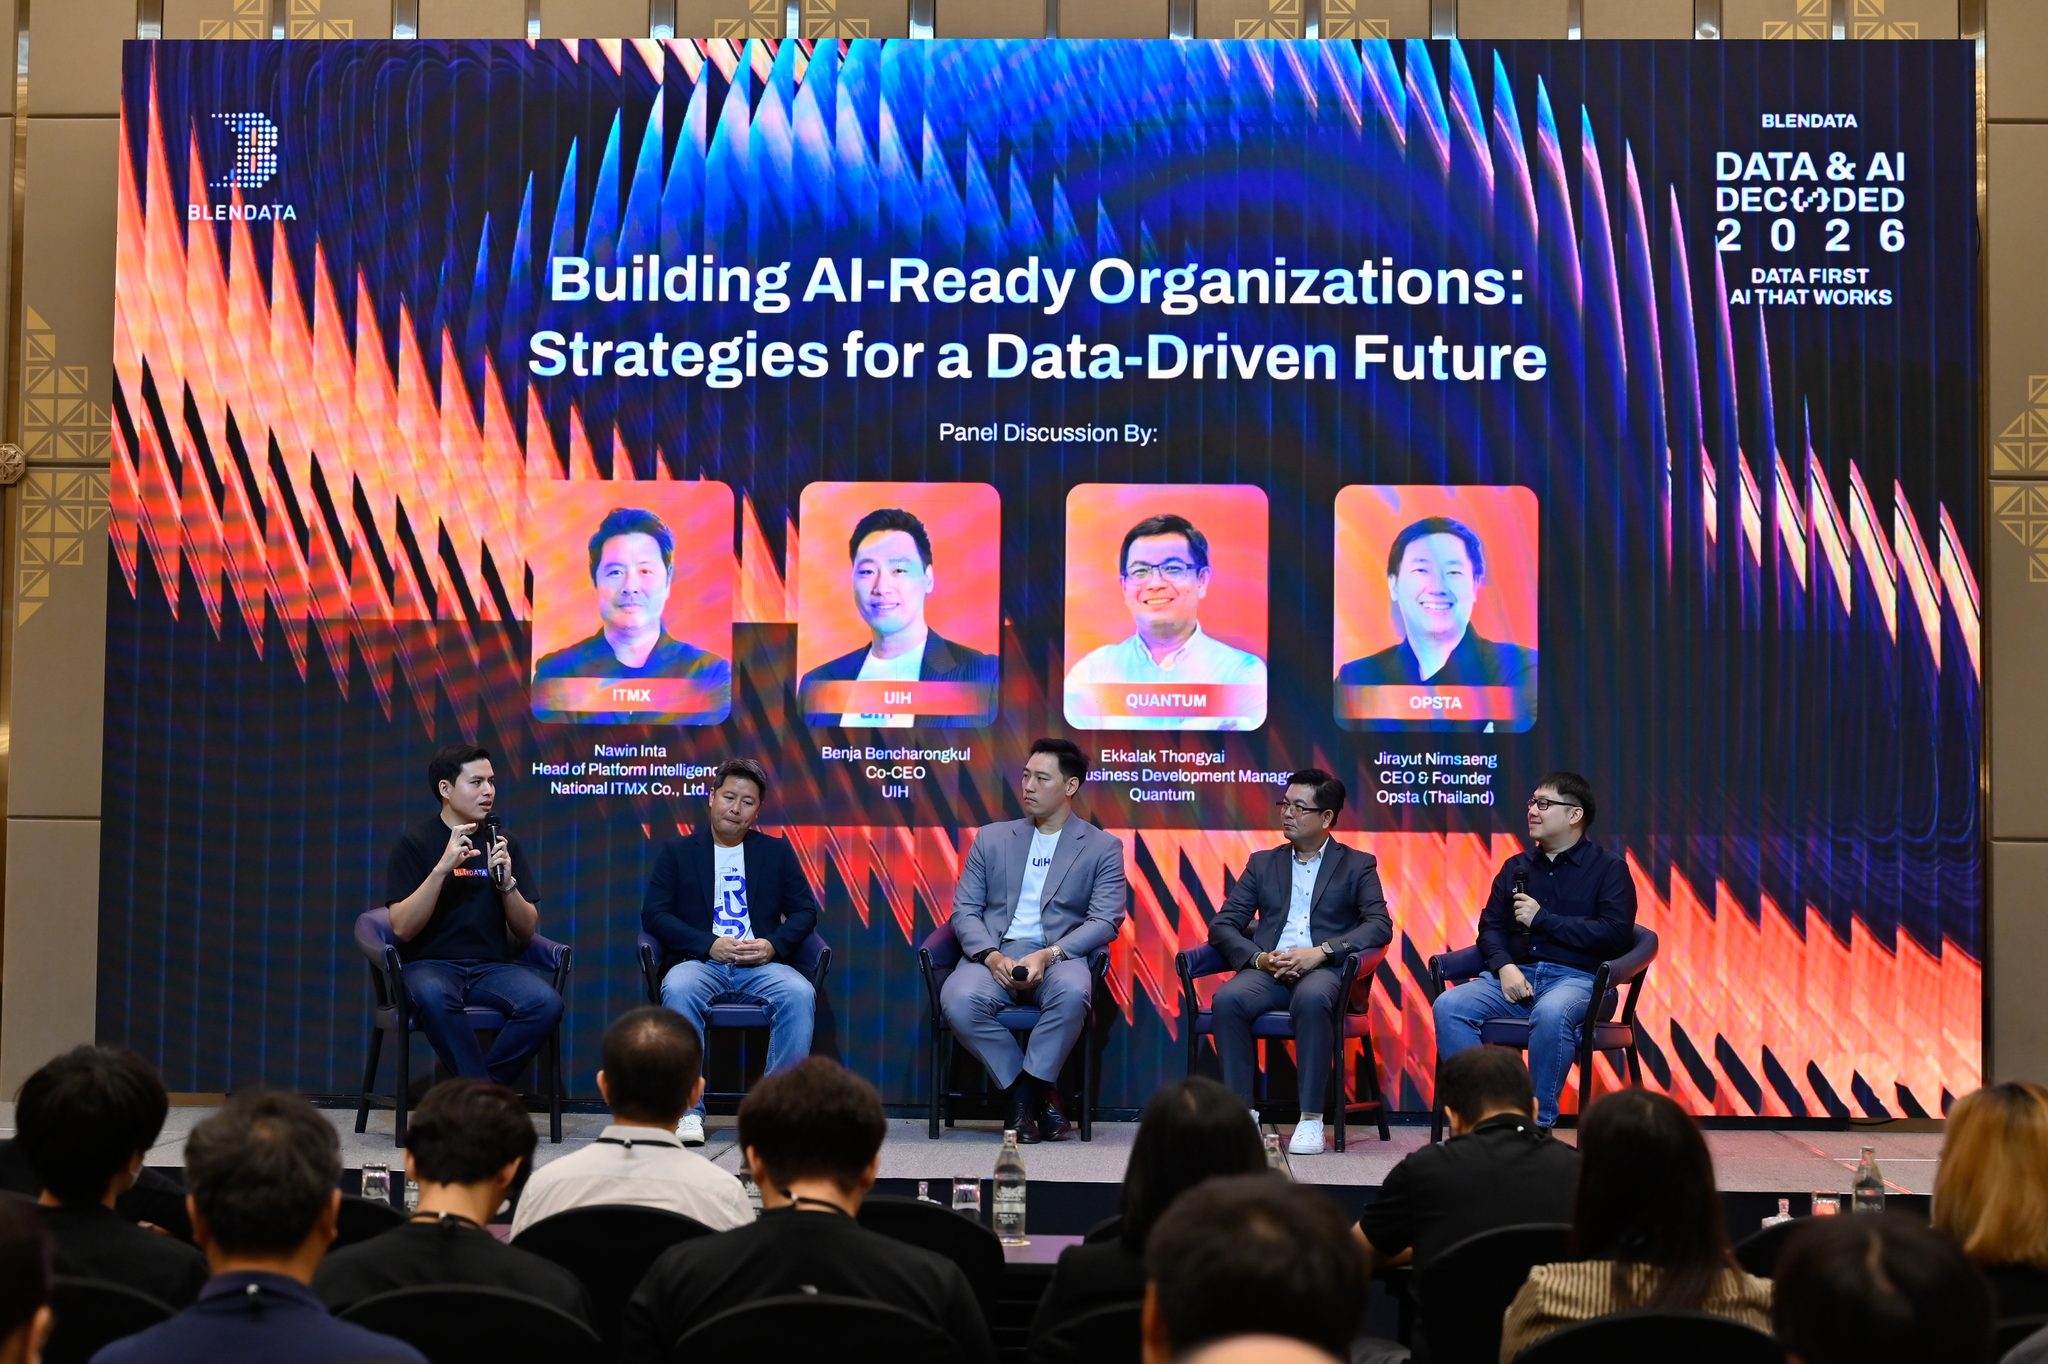
บนเวทีสัมมนาเกี่ยวกับ Data และ AI ที่มีการรวมผู้เชี่ยวชาญด้าน Enterprise IT มีข้อความเดียวที่ส่งเสียงดังที่สุดคือ หากอยากได้ AI That Works ต้องเริ่มจาก Data First เมื่อ Frontier AI Model กลายเป็นสินค้าทั่วไปที่ทุกคนเข้าถึงได้ ปัจจัยชี้ชะตาว่าใครชนะไม่ใช่โมเดล แต่คือ Data Foundation ขององค์กร ซึ่งรวมถึงการทลาย Data Silo ทำให้ข้อมูลเชื่อมโยงกันได้ การนำสถาปัตยกรรมใหม่ที่แยก Compute กับ Storage เพื่อควบคุมต้นทุน และการทำ Active Data Archiving เพื่อดึงข้อมูลเก่ากลับมาใช้กับ AI ได้ทันที ตัวอย่างจากการเปลี่ยนผ่านโครงสร้างข้อมูลในบางองค์กร ทำให้จำนวนฮาร์ดแวร์ลดลงอย่างมากและลดต้นทุนรวมของโครงการได้อย่างมีนัยสำคัญ ที่สำคัญ เมื่อ Data Foundation พร้อมจึงค่อยต่อยอดสู่ Agentic AI และ Multi-Agent System ที่ลงมือทำงานซับซ้อนได้จริง เช่น การตรวจสอบการฟอกเงิน การรวบรวมหลักฐาน และการร่างเอกสารกฎหมายในกระบวนการเดียว เวทีเดียวกันยังตอกย้ำว่าเมื่อ Agentic AI ลงสนามจริงแล้ว องค์กรต้องมีไม้บรรทัดวัด ROI ที่ชัดเจน ไม่ใช่ปล่อยให้โครงการเป็นแค่ตัวทดลองตามกระแส
ยุค FinOps และ Data Governance: เลิกวัฒนธรรม “ลงเร็ว” แล้วหันมาสร้าง AI บนฐานข้อมูลที่ไว้ใจได้
การลงทุนด้านศูนย์ข้อมูล การใช้บริการคลาวด์ขนาดใหญ่ และการเร่งนำ AI มาใช้ในระบบธุรกิจ กำลังผลักให้องค์กรต้องมองโครงสร้าง IT ใหม่ทั้งหมด หากยังยึดวัฒนธรรม “deploy fast” โดยละเลย Data Governance และ FinOps ผลที่ตามมาคือ AI Chaos ทั้งด้านต้นทุนที่บานปลาย ประสิทธิภาพระบบที่ไม่นิ่ง และความเสี่ยงด้านความปลอดภัยที่ยากจะควบคุม กลยุทธ์ Data First จึงไม่ได้เป็นคำสวยหรู แต่เป็นข้อบังคับในการอยู่รอดในตลาดที่ Data Analytics คาดว่าจะเติบโตอย่างมากภายในปี 2030 องค์กรที่จริงจังกับ enterprise data trust ต้องสร้าง Single Source of Truth และระบบกำกับข้อมูลที่เข้มงวด เพื่อให้ทุกทีมใช้ข้อมูลชุดเดียวกันในการทำ Anomaly Detection และใช้ AI ตัดสินใจธุรกิจ ควบคู่ไปกับการวาง FinOps เพื่อเห็นต้นทุนของ AI workloads แบบเรียลไทม์ แบ่งเฟสการย้ายระบบ หลีกเลี่ยงการตัดสินใจแบบครั้งเดียวจบ และกำหนด SLO ที่วัดได้จากประสบการณ์ของลูกค้า เช่น ความสำเร็จของการจ่ายเงินหรือความพร้อมใช้งานของแอป เมื่อทุกชั้นตั้งแต่ข้อมูล โครงสร้างพื้นฐาน ไปจนถึงการวัดผลทางการเงินถูกทำให้โปร่งใสและตรวจสอบได้ AI จึงจะเปลี่ยนจากของเล่นราคาแพง เป็นแรงงานดิจิทัลที่สร้าง ROI ได้อย่างยั่งยืน