
ภาพรวมและข้อสรุปสั้น ๆ ใครควรเลือกตัวไหน
โมเดล AI ราคาประหยัดสำหรับงานประมวลผลข้อมูลเร็ว คือโมเดลภาษาขนาดใหญ่ที่ออกแบบมาให้รองรับปริมาณงานสูง คิดค่าบริการตามจำนวนโทเคน แต่เน้นลดต้นทุนต่องานผ่านความเร็ว การใช้โทเคนอย่างมีประสิทธิภาพ และการออกแบบสถาปัตยกรรมที่เหมาะกับงานอัตโนมัติในองค์กร โดยยังคงคุณภาพการให้เหตุผลและการตอบที่เพียงพอสำหรับงานธุรกิจทั่วไป
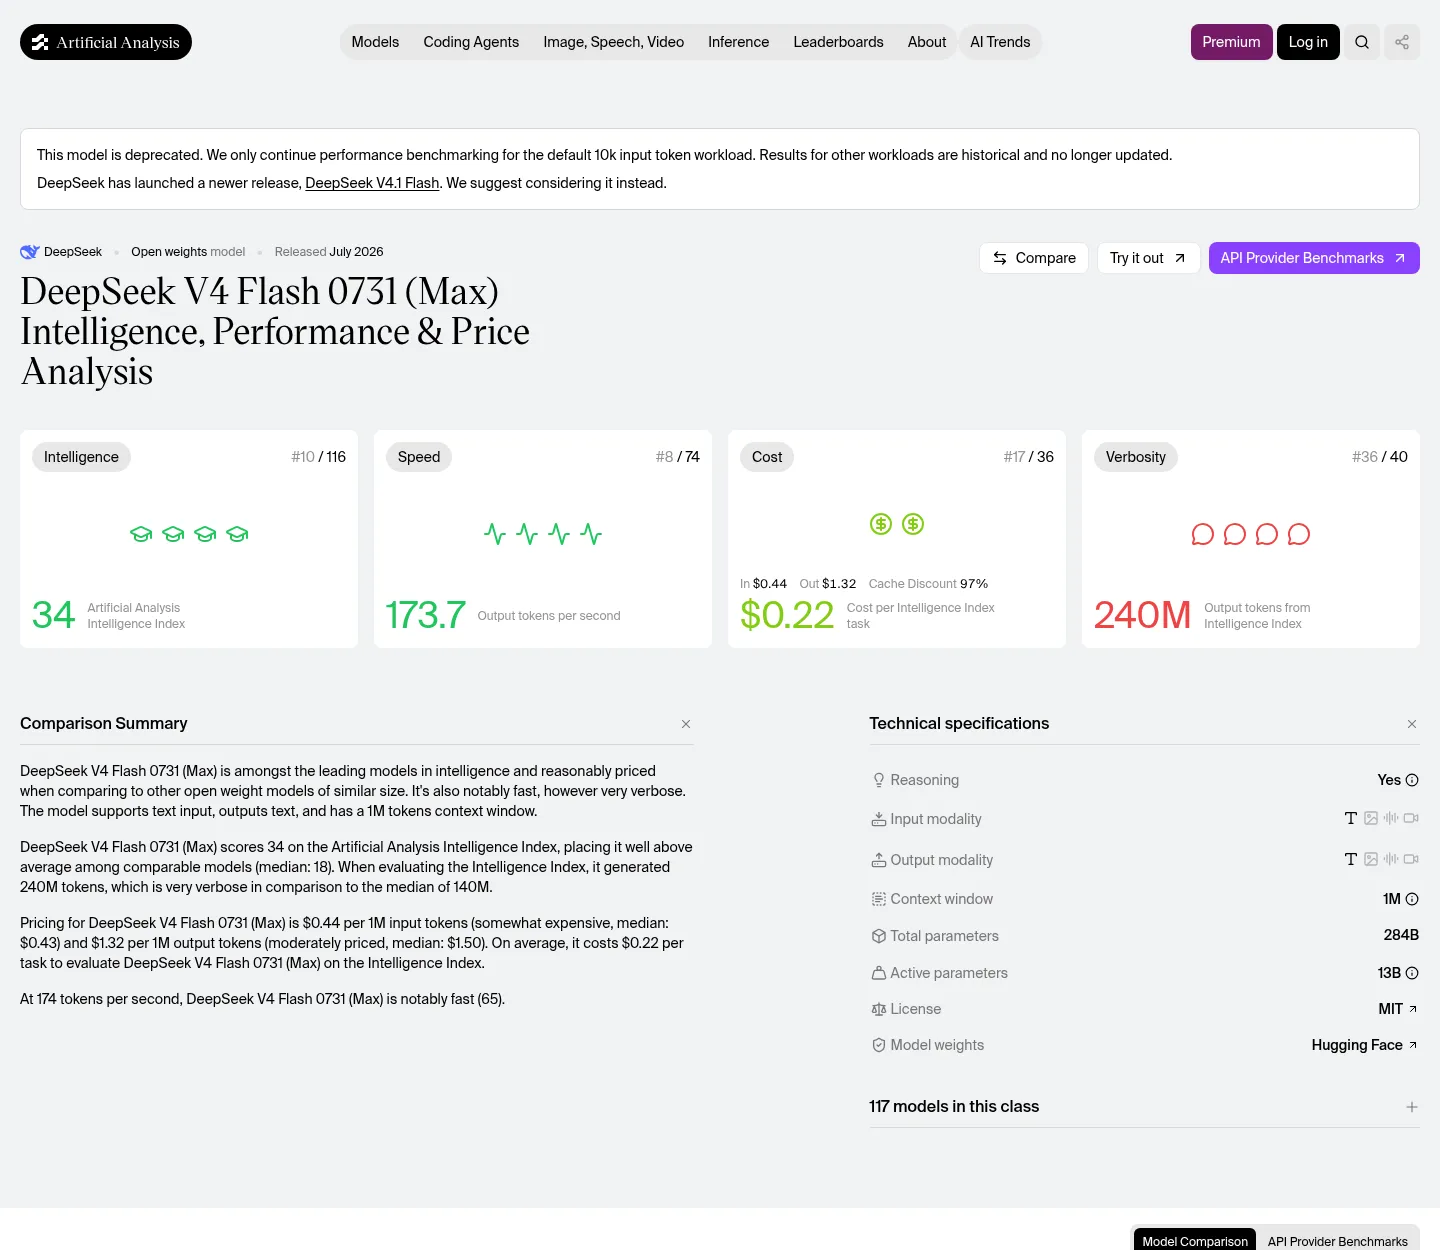
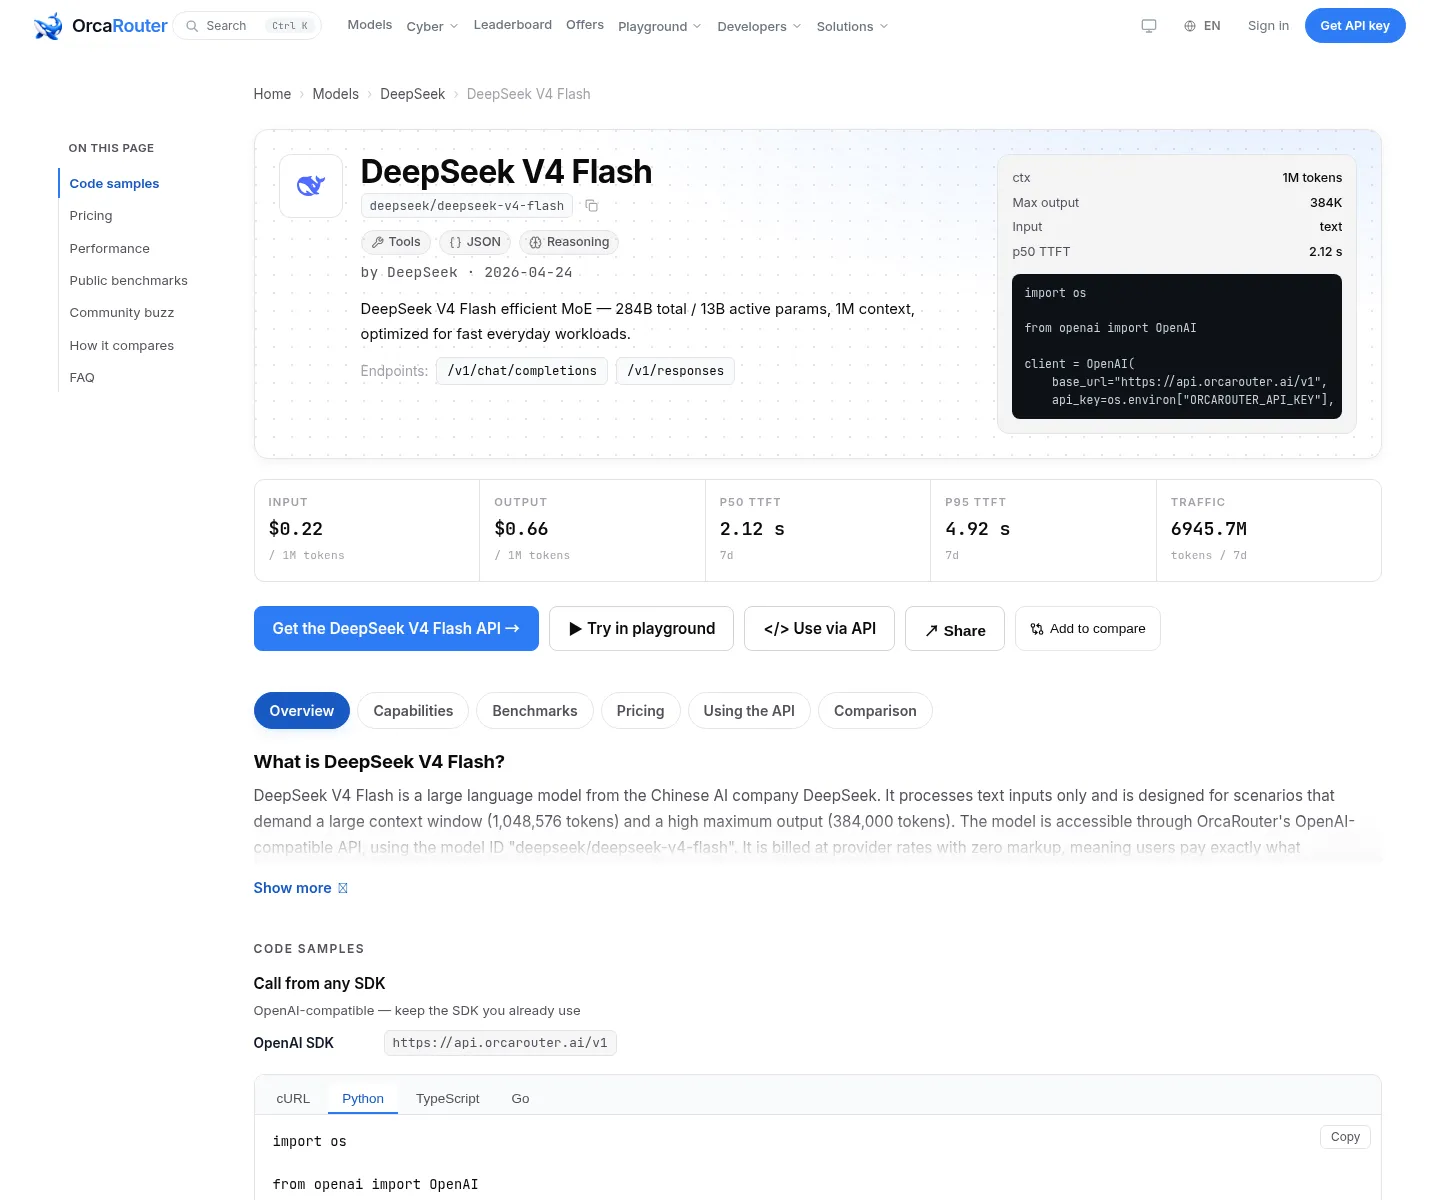
DeepSeek V4 Flash เด่นเรื่องความเร็วและความยืดหยุ่นเพราะเป็นโมเดลแบบ mixture‑of‑experts ที่เปิดน้ำหนักภายใต้สัญญาอนุญาต MIT ทำให้รันได้แทบทุกที่และเหมาะกับทีมที่ต้องการโฮสต์เองหรือผูกกับระบบภายในอย่างลึก ข้อเสียคือมันเขียนเอาต์พุตเยอะ ใช้โทเคนถึง 240 ล้านโทเคนเพื่อทำงาน Intelligence Index หนึ่งงาน ซึ่งสูงกว่าค่ามัธยฐานของคลาสถึง 71 เปอร์เซ็นต์ ฝั่ง Ultramarine 1 Flash เป็นโมเดลปิดที่ต่อยอดจาก GLM‑5.3 Flash และเน้นลดจำนวนโทเคนเอาต์พุตลงประมาณ 6.5 เปอร์เซ็นต์เมื่อเทียบกับฐานเดิม ขณะได้คะแนนสูงขึ้นในทุกเกณฑ์ ถ้าต้องรันน้ำหนักเอง DeepSeek คือคำตอบ แต่ถ้าเรียกผ่าน API ทั้งสองต้องวัดกันที่ต้นทุน AI ต่องานจริงบนเอกสารของคุณเอง

สถาปัตยกรรมและใบอนุญาต DeepSeek เปิด Ultramarine ปิด
การเปรียบเทียบโมเดล AI สองตัวนี้ต้องเริ่มจากโครงสร้างและใบอนุญาต DeepSeek V4 Flash เป็นโมเดลแบบ mixture‑of‑experts ที่สร้างขึ้นใหม่ตั้งแต่ต้น มีพารามิเตอร์รวม 284 พันล้านตัว แต่เปิดใช้งาน 13 พันล้านตัวต่อโทเคน และเผยแพร่น้ำหนักภายใต้สัญญาอนุญาต MIT บนแพลตฟอร์มโอเพ่นโมเดล จุดนี้ทำให้ทีมวิศวกรรมที่ต้องการรันบนโครงสร้างพื้นฐานของตัวเอง หรือปรับแต่งเพิ่มเติม มีทางเลือกที่ยืดหยุ่นกว่า ในขณะที่ DeepSeek V4.1 Flash ซึ่งเป็นรุ่นเร็วในตระกูล V4.1 ก็ยังคงใช้ใบอนุญาต MIT เช่นกัน
Ultramarine 1 Flash เดินคนละทาง มันเป็นโมเดลที่พัฒนาต่อยอดจาก GLM‑5.3 Flash ของ Z.ai ผ่านการเรียนรู้แบบเสริมกำลังขนาดใหญ่บนงานด้านการเงิน กฎหมาย การให้คำปรึกษา และงานปฏิบัติการ น้ำหนักโมเดลยังไม่เปิดให้ใช้งาน และมีเพียงคำประกาศว่า “น้ำหนักโมเดลจะเปิดให้เร็ว ๆ นี้” ซึ่งยังเป็นเพียงเจตนา ไม่ใช่ใบอนุญาตจริง ดังนั้นในมุมการกำกับดูแลข้อมูลและการควบคุมระบบภายใน DeepSeek ให้ความโปร่งใสและอิสระมากกว่า ส่วน Ultramarine เหมาะกับทีมที่ยอมรับโมเดลปิดและเน้นความสะดวกของ API มากกว่าการควบคุมระดับโครงสร้าง
ความเร็ว ปริมาณโทเคน และต้นทุน AI ต่องาน
หัวใจของการเลือกโมเดล AI ราคาประหยัดคือการมองต้นทุน AI ต่องาน ไม่ใช่แค่ราคาต่อโทเคน DeepSeek V4 Flash ถูกจัดว่าเป็นโมเดลที่เร็ว มีความสามารถ และวัดผลได้ดี ซึ่งคุณรันได้แทบทุกที่ แต่ข้อเสียคือมันเขียนเยอะ ในชุดทดสอบ Intelligence Index มันใช้เอาต์พุตถึง 240 ล้านโทเคน เทียบกับค่ามัธยฐาน 140 ล้านโทเคน และถูกจัดอยู่อันดับที่ 36 จาก 40 ในด้านความฟุ่มเฟือยของเอาต์พุต อย่างไรก็ตามด้วยอัตรา 173.7 เอาต์พุตโทเคนต่อวินาที มันเป็นโมเดลที่เร็วอันดับแปดจาก 74 โมเดลในคลาสของมัน ทำให้แม้จะใช้โทเคนมาก แต่โทเคนเหล่านั้นมาถึงอย่างรวดเร็ว ช่วยให้เวลารวมของงานยังสั้นอยู่
Ultramarine 1 Flash เน้นอีกมุมหนึ่ง คือใช้โทเคนน้อยลงต่อผลลัพธ์หนึ่งงาน Paper Instruments รายงานว่าบนเกณฑ์มาตรฐานทั้งหกที่ใช้ทดสอบ มันสร้างโทเค็นน้อยลง 6.5 เปอร์เซ็นต์เมื่อเทียบกับ GLM‑5.3 Flash ที่เป็นฐาน ขณะได้คะแนนสูงกว่าในทุกเกณฑ์ กล่าวคือโมเดลหนึ่งราคาถูกต่อโทเคนแต่แพงต่องานเพราะเขียนเยอะ อีกโมเดลหนึ่งพยายามลดค่าใช้จ่ายต่องานโดยลดจำนวนโทเคนเอาต์พุตลงโดยไม่เปลี่ยนราคา สำหรับองค์กรที่ต้องประมวลผลข้อมูลเร็วและมีงานซ้ำจำนวนมาก การลดโทเคนเอาต์พุตต่อเคสอาจแปลว่าบิลรวมปลายเดือนต่ำกว่า แม้ราคาต่อโทเคนจะใกล้เคียงกัน
| ประเด็นเปรียบเทียบ | DeepSeek V4 Flash / V4.1 Flash | Ultramarine 1 Flash |
|---|---|---|
| สถาปัตยกรรมหลัก | mixture‑of‑experts สร้างใหม่จากศูนย์ | ต่อยอดจาก GLM‑5.3 Flash ด้วย RL |
| สถานะน้ำหนักโมเดล | เปิดน้ำหนัก ใบอนุญาต MIT | โมเดลปิด น้ำหนักยังไม่เปิดใช้ |
| หน้าต่างบริบทสูงสุด | ประมาณ 1,048,576 โทเคนใน V4.1 Flash | อิง GLM‑5.3 Flash แต่ไม่ระบุในแหล่งข้อมูล |
| ความเร็วเอาต์พุต | 173.7 โทเคนต่อวินาที อันดับ 8 จาก 74 | ไม่มีตัวเลขจากเกณฑ์ภายนอกในแหล่งข้อมูล |
| โทเคนเอาต์พุตต่อ Intelligence Index | 240 ล้าน สูงกว่ามัธยฐาน 71 เปอร์เซ็นต์ | ใช้โทเคนน้อยลง 6.5 เปอร์เซ็นต์เทียบกับ GLM‑5.3 |
คุณภาพงานจริง Benchmarks และการใช้งานในองค์กร
เมื่อมองการเปรียบเทียบโมเดล AI ในระดับคุณภาพงานจริง ตัวเลขจากชุดทดสอบหลายชุดช่วยให้เห็นภาพชัดขึ้น ใน AutomationBench ซึ่งโฟกัสงานอัตโนมัติ DeepSeek V4.1 Flash ทำคะแนน 51.3 ขณะที่ Ultramarine 1 Flash ทำได้ 50.2 ทำให้ DeepSeek ชนะเล็กน้อยในชุดนี้ แต่ใน JobBench ซึ่งวัดงานลักษณะคล้ายงานสำนักงาน Ultramarine 1 Flash ทำได้ 62.9 เทียบกับ 60.4 ของ DeepSeek ส่วนใน PI Knowledge Work ช่องว่างยิ่งกว้าง Ultramarine ทำได้ 59.3 ขณะที่ DeepSeek อยู่ที่ 47.9 ส่วนต่าง 11.4 คะแนน ซึ่งเป็นช่องว่างที่กว้างที่สุดในชุดนี้
ข้อได้เปรียบของ DeepSeek V4 Flash คือเป็นโมเดลที่เร็ว มีความสามารถ และวัดผลได้ดี ซึ่งคุณรันได้แทบทุกที่ แต่ข้อเสียคือมันเขียนเยอะและค่าโทเคนเอาต์พุตจะสะท้อนในใบแจ้งหนี้ ข้อได้เปรียบของ Ultramarine 1 Flash คือมันเขียนน้อยกว่าโมเดลฐานของตัวเอง แต่เฉพาะเมื่อเทียบกับ GLM‑5.3 Flash และเฉพาะบนชุดทดสอบที่ผู้ผลิตของมันเองเขียนขึ้น ถ้าคุณจำเป็นต้องรันน้ำหนักเอง การเลือกแทบไม่ต้องคิด DeepSeek V4 Flash คือคำตอบ ส่วน Ultramarine 1 Flash ยังเป็นเพียงคำสัญญาเรื่องการเปิดน้ำหนักในอนาคต แต่ถ้าคุณเรียกใช้ผ่าน API ทั้งสองแข่งขันกันจริง และหลักฐานที่ชี้ขาดคือต้นทุนต่องานบนเอกสารของคุณเอง ไม่ใช่แค่คะแนนเบนช์มาร์ก
สรุปเชิงกลยุทธ์ เลือก Flash ให้ตรงงานและงบ
ในสายผลิตภัณฑ์ของ DeepSeek ระดับ Flash ถูกออกแบบมาเพื่อปริมาณงานเป็นหลัก รองรับการทำงานพร้อมกันสูงและเน้นต้นทุนมากกว่าคะแนนความสามารถสูงสุด โดยค่าใช้จ่ายโทเคนที่คิดเพียงประมาณหนึ่งในสี่ของระดับ Pro จึงเหมาะกับงานที่ต้องการประมวลผลข้อมูลเร็วและจำนวนมากมากกว่างานให้เหตุผลที่ยากที่สุด ส่วนระดับ Pro มีไว้สำหรับงานที่ต้องใช้การให้เหตุผลและการทำงานแบบเอเจนติกที่ยากที่สุด ซึ่งคุณจ่ายเพื่อประสิทธิภาพระดับสูงสุดของช่วงนี้ และยอมรับเพดานปริมาณงานที่จำกัด นี่คือภาพรวมของการเลือกในสาย DeepSeek เอง
เมื่อเพิ่ม Ultramarine 1 Flash เข้ามาในสมการ คุณจะได้สองแนวทางสู่ระดับราคาเดียวกัน โมเดลหนึ่งเน้นความเร็วและความเปิดกว้างของน้ำหนัก อีกโมเดลหนึ่งเน้นลดโทเคนเอาต์พุตเพื่อให้ต้นทุนต่องานต่ำลงโดยไม่เปลี่ยนราคา สำหรับทีมที่ต้องการควบคุมโครงสร้างพื้นฐานและต้องการโมเดลที่สามารถประมวลผลข้อมูลเร็วด้วยหน้าต่างบริบทขนาดใหญ่ DeepSeek V4.1 Flash ที่มีบริบท 1,048,576 โทเคนจึงเป็นตัวเลือกที่สมเหตุสมผล ส่วนทีมที่เน้นคุณภาพงานความรู้และต้องการลดจำนวนโทเคนเอาต์พุตต่อเคส Ultramarine 1 Flash ให้สมดุลที่น่าสนใจ แม้จะต้องยอมรับข้อจำกัดของโมเดลปิดและการรอเปิดน้ำหนักในอนาคต
- Buy the DeepSeek V4 Flash if ทีมของคุณต้องรันน้ำหนักโมเดลเองหรือผูกเข้ากับโครงสร้างพื้นฐานภายในอย่างลึก เพราะใบอนุญาต MIT และน้ำหนักที่เปิดให้ดาวน์โหลดทำให้ควบคุมได้เต็มที่
- Skip the DeepSeek V4 Flash if งานของคุณคิดค่าบริการตามโทเคนเอาต์พุตอย่างเข้มงวดและต้องการข้อความสั้น เพราะโมเดลนี้เขียนเยอะ ใช้เอาต์พุตถึง 240 ล้านโทเคนต่อ Intelligence Index หนึ่งงาน
- Buy the DeepSeek V4.1 Flash if คุณต้องการโมเดล Flash ที่มีหน้าต่างบริบท 1,048,576 โทเคน รองรับงานที่มีพรีฟิกซ์ยาวและเน้นปริมาณงานมากกว่าคะแนนความสามารถสูงสุด
- Skip the DeepSeek V4.1 Flash if งานของคุณต้องการการให้เหตุผลระดับสูงสุดและคุณยอมรับต้นทุนที่สูงกว่าและเพดานปริมาณงานที่ต่ำกว่าในระดับ Pro ได้
- Buy the Ultramarine 1 Flash if โฟกัสของคุณคือการลดต้นทุน AI ต่องานผ่านการใช้โทเคนเอาต์พุตน้อยลง โดยเฉพาะงานความรู้ที่คล้ายชุดทดสอบของผู้ผลิต ซึ่งแสดงว่ามันใช้โทเคนน้อยลง 6.5 เปอร์เซ็นต์เทียบกับ GLM‑5.3 Flash
- Skip the Ultramarine 1 Flash if คุณต้องการโมเดลที่เปิดน้ำหนักแล้ววันนี้ เพราะน้ำหนักของ Ultramarine ยังไม่เปิดใช้และยังเป็นโมเดลปิดที่ต้องเรียกผ่าน API เป็นหลัก