
เข้าใจภาพรวม AI Agent ความเชื่อถือได้ก่อนลงมือออกแบบ
AI Agent ความเชื่อถือได้ คือระบบตัวแทนอัตโนมัติที่ใช้โมเดลภาษาร่วมกับเครื่องมือภายนอกเพื่อทำงานที่มีผลกระทบต่อโลกจริง โดยถูกออกแบบให้ลดความเสี่ยงของการทำงานซ้ำ การคืนผลลัพธ์ผิดรายการ และการเปลี่ยนสถานะธุรกิจโดยไม่ตั้งใจ เน้นการกำหนดข้อตกลงผลข้างเคียง การมีตัวตนของปฏิบัติการที่ชัดเจน การมีการติดตามแบบสังเกตการณ์ และการประเมินผลอย่างเป็นระบบ เพื่อให้ทุกการเรียกใช้เครื่องมือสามารถตรวจสอบ ย้อนดู และกู้คืนได้อย่างปลอดภัย
ก่อนสร้างระบบ AI Agent ปลอดภัย สิ่งที่ต้องมีจริงๆ ไม่ใช่แค่โมเดลดี แต่คือการตอบคำถามให้ครบสำหรับทุกเครื่องมือที่มีผลข้างเคียง เช่น ส่งข้อความ สร้างทิกเก็ต ออกเครดิต หรือคืนเงิน ว่าเป้าหมายทางธุรกิจคืออะไร ผลนั้นเป็นแบบ idempotent ดับเบิลเช็ค หรือไม่สามารถทำซ้ำได้ จุดที่สร้างและเก็บตัวตนของปฏิบัติการอยู่ตรงไหน ข้อผิดพลาดแบบใดคือจบแน่นอน รีเทรย์ได้ หรือไม่รู้ผลลัพธ์ ต้องกระทบกระบวนการอนุมัติหรือไม่ และหลักฐานอะไรยืนยันสถานะภายนอกสุดท้าย ถ้ายังตอบไม่ได้ครบ ถือว่ายังไม่พร้อมเอา agent ไปแตะระบบจริง
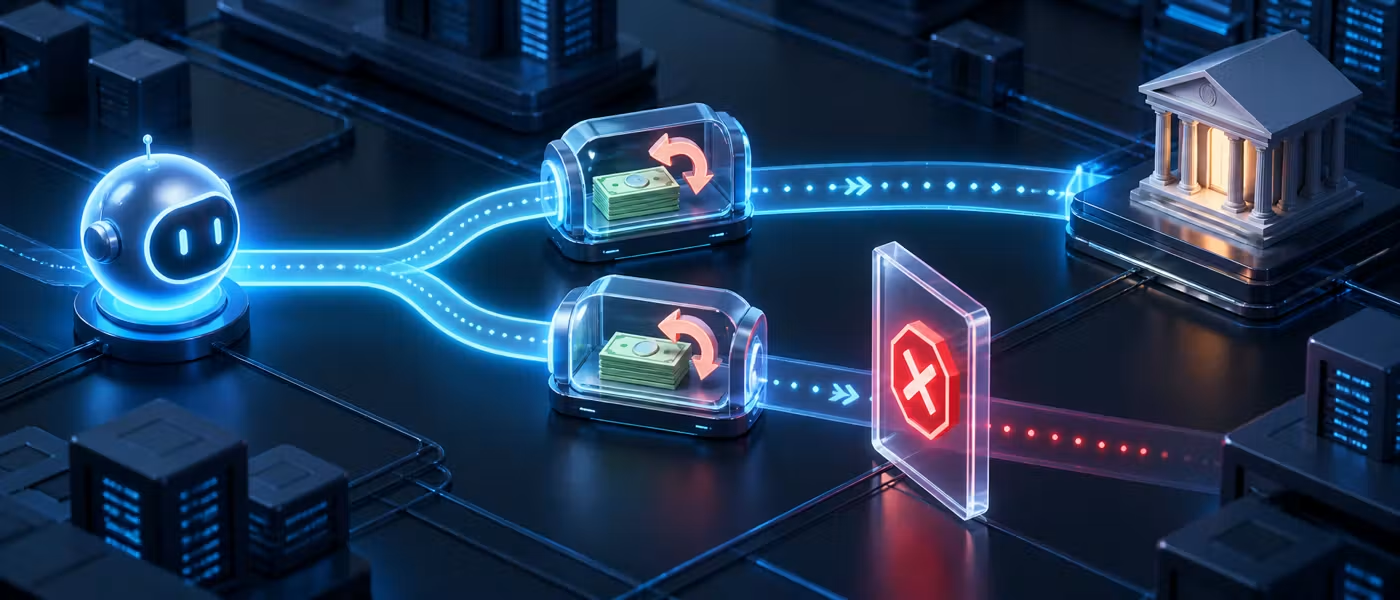
หนึ่งในกับดักที่เกิดขึ้นบ่อยคือการรีเทรย์แบบไม่คิด หาก runtime ปฏิบัติต่อข้อยกเว้นทุกชนิดเหมือนเป็นใบอนุญาตให้เรียกเครื่องมือใหม่ การรักษาตัวเองจะกลายเป็นการทำงานซ้ำโดยไม่ตั้งใจ เช่น agent เรียกส่งคืนเงินครั้งแรก ระบบรับคำขอแต่ตอบกลับหล่นหายเพราะ timeout runtime เห็นข้อยกเว้นแล้วรีเทรย์อีกครั้ง ผลคือทั้งสองคำขอสำเร็จ ลูกค้าได้รับเงินคืนสองครั้ง ทั้งที่ trace ดูเหมือนทุกอย่างผ่านปกติ ตรงนี้ไม่ใช่ปัญหาพรอมต์หรือโมเดล แต่เป็นปัญหาสัญญาเครื่องมือและการออกแบบการรีเทรย์
ออกแบบ Side-effect contracts และตัวตนปฏิบัติการให้ไม่เกิดการทำงานซ้ำ
หัวใจของการออกแบบระบบ AI Agent ความเชื่อถือได้คือการทำ Side-effect contracts ให้ชัดว่าการเรียกแต่ละเครื่องมือมีผลแบบไหนต่อโลกจริง การแบ่งคลาสของผลข้างเคียงออกเป็น read_only idempotent_write deduplicated_write และ non_repeatable_write บังคับให้ทีมต้องคิดให้ครบว่าการเรียกซ้ำจะเปลี่ยนสถานะธุรกิจหรือไม่ ระบบปลายทางรับประกันผลซ้ำกันได้หรือเปล่า และต้องใช้คีย์ตัวตนหรือการค้นหาปฏิบัติการมาช่วยกันซ้ำอย่างไร
สำหรับเครื่องมือที่เขียนข้อมูล สิ่งสำคัญคือการสร้างตัวตนของปฏิบัติการก่อนการลองครั้งแรกเสมอ เพราะถ้าสร้างคีย์ idempotency ภายในลูปรีเทรย์ แต่ละครั้งจะได้ตัวตนใหม่ ทำให้ทุกความพยายามถูกมองเป็นปฏิบัติการใหม่ และ idempotency หายไปโดยสิ้นเชิง วิธีที่ปลอดภัยคือให้ runtime สร้าง operation identity เดียวแล้วส่งต่อให้ทุกการเรียกใช้เครื่องมือในชุดนั้น เพื่อให้ระบบปลายทางสามารถดับเบิลเช็คหรือปฏิเสธการทำงานซ้ำได้อย่างสอดคล้อง
- กำหนด Side-effect contracts สำหรับทุกเครื่องมือ ว่าจัดอยู่ใน read_only idempotent_write deduplicated_write หรือ non_repeatable_write พร้อมระบุ retry policy ที่ชัดเจน
- ออกแบบให้ runtime สร้าง operation identity ก่อนการเรียกใช้เครื่องมือครั้งแรก แล้วแนบตัวตนนี้กับทุกความพยายามที่เกี่ยวข้องเพื่อรองรับการดับเบิลเช็ค
- ระบุในสัญญาว่าข้อผิดพลาดแบบใดรีเทรย์ได้ แบบใดคือผลลัพธ์ไม่รู้ ต้องเข้าสู่กระบวนการ reconciliation และแบบใดคือห้ามรีเทรย์โดยอัตโนมัติ
- สำหรับระบบที่ไม่มีฟังก์ชันค้นหาปฏิบัติการหรือดับเบิลเช็ค ให้ระบุในสัญญาเครื่องมือว่าต้องมีคนตรวจสอบสถานะภายนอกด้วยตนเอง และไม่อนุญาตให้ agent รีเทรย์เอง
- ผูกการอนุมัติของมนุษย์ (approval) เข้ากับ operation identity เดียว เพื่อป้องกันไม่ให้คำว่ารีเทรย์กลายเป็นการขยายสิทธิ์โดยไม่ตั้งใจ
ข้อผิดพลาดที่พบบ่อยอีกอย่างคือมองว่า idempotent มาจากข้อความในพรอมต์หรือคำอธิบายเครื่องมือ แต่หากระบบปลายทางไม่มีฟังก์ชัน lookup หรือไม่มีการเก็บคีย์ตัวตนแบบคงที่ การการันตี idempotent จากฝั่ง agent เป็นไปไม่ได้เลย ถ้าระบบปลายทางไม่รองรับ ต้องยอมรับว่าเครื่องมือดังกล่าวเป็น non_repeatable หรือ deduplicated_write ที่ต้องพึ่งมนุษย์ช่วยตรวจสอบภายนอก และบันทึกสิ่งนี้ไว้ในสัญญาเครื่องมืออย่างชัดเจนเพื่อให้ระบบ AI ปลอดภัย ผลลัพธ์ที่ได้ไม่ใช่การประกันทำงานครั้งเดียวเป๊ะ แต่คือการทำให้ขอบเขตแต่ละขั้นชัดและสามารถกู้คืนได้
Agent observability การประเมินผล และกับดักที่แดชบอร์ดบอกไม่ได้
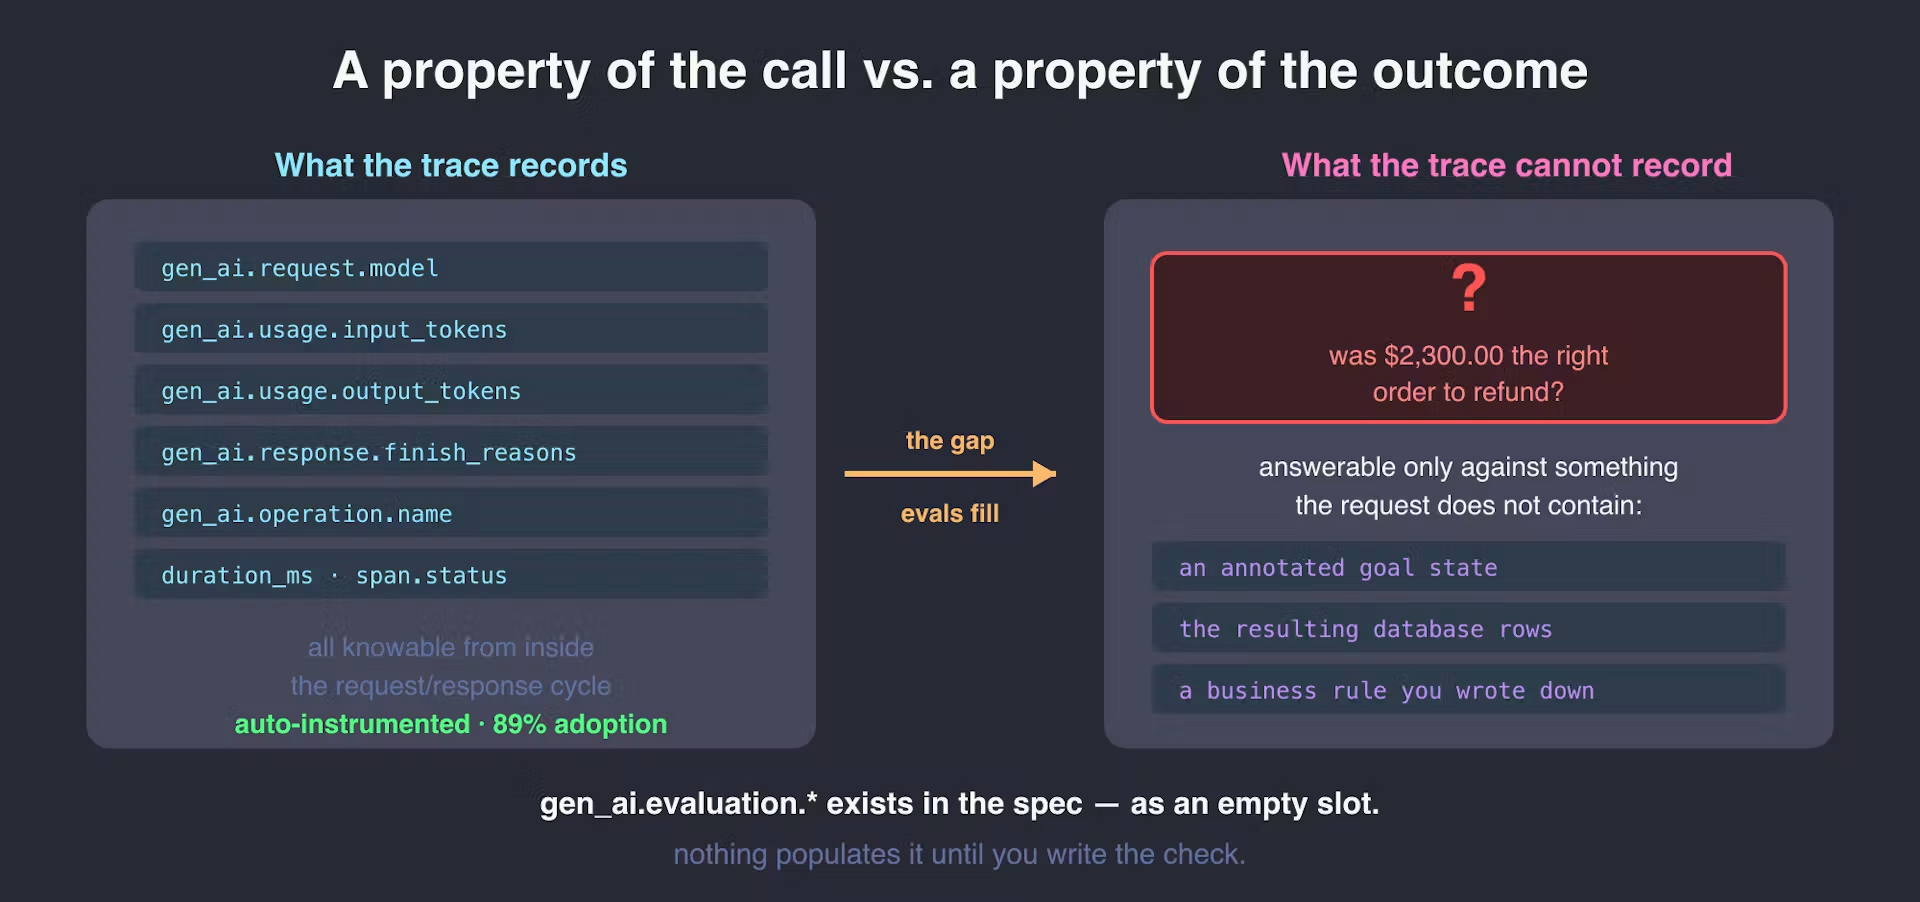
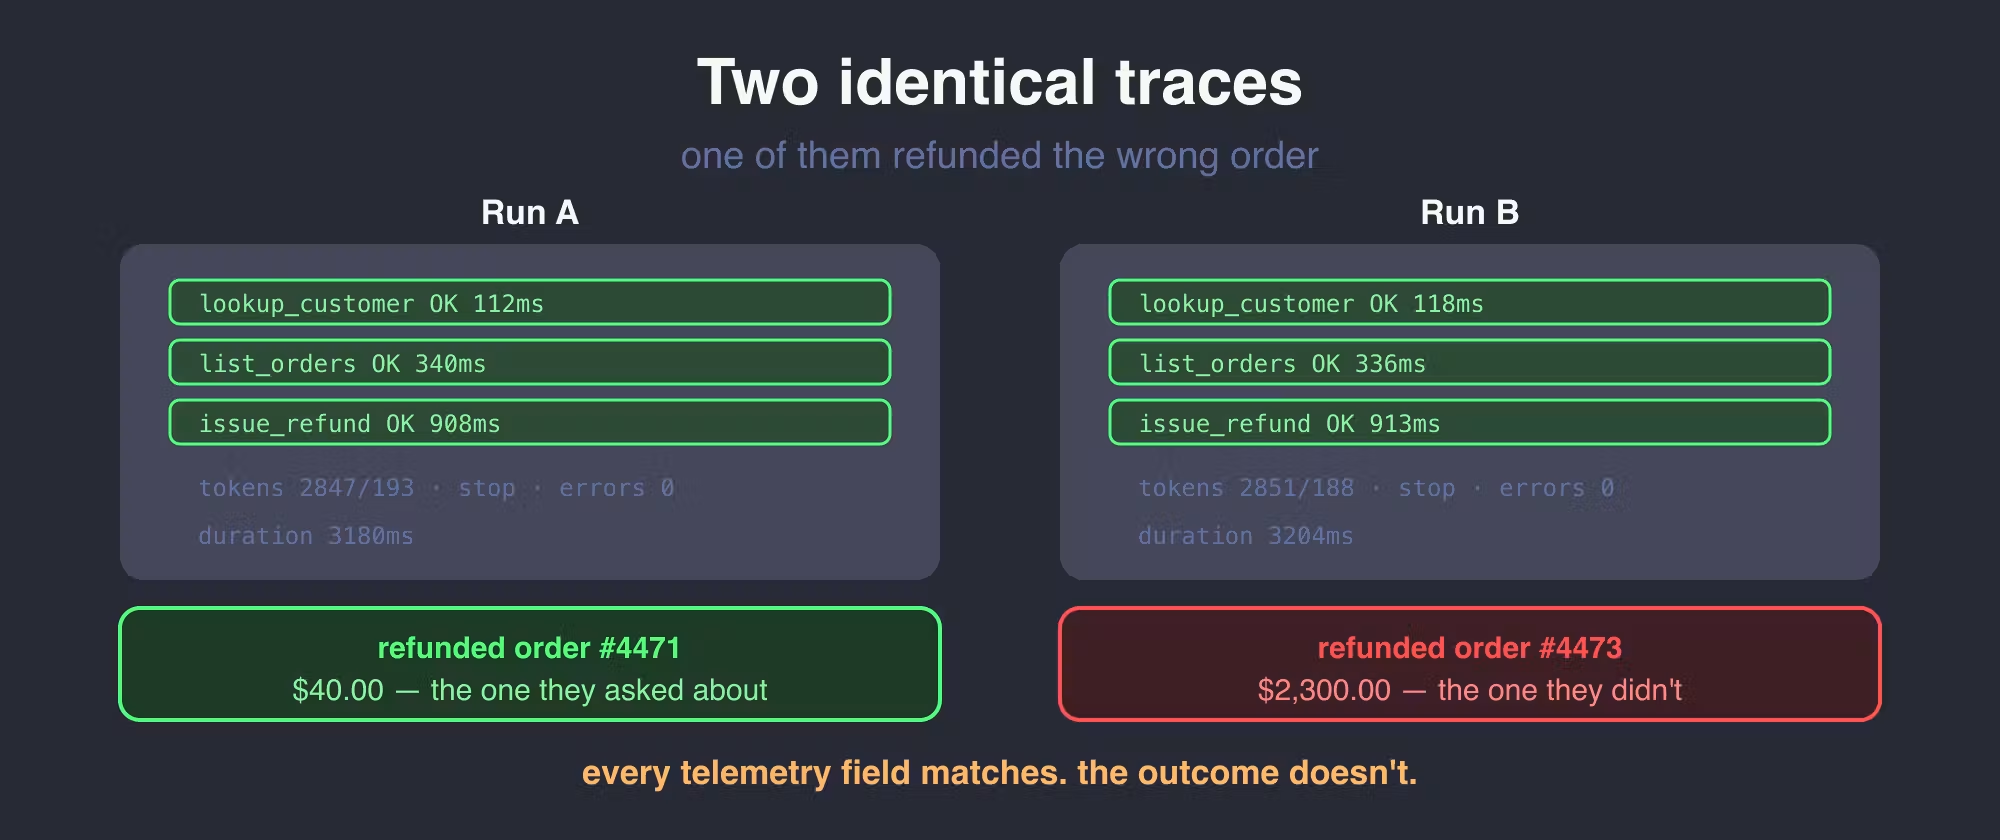
หลายทีมมองว่าแค่มีการเก็บ trace แบบ observability ก็พอแล้ว แต่ประสบการณ์จริงแสดงให้เห็นว่าการตามดูขั้นตอนคนละเรื่องกับการประเมินว่าผลลัพธ์ถูกหรือไม่ การติดตามมาตรฐานมักอาศัยฟิลด์ตาม OpenTelemetry GenAI semantic conventions เช่น ชื่อโมเดล จำนวนโทเคน เหตุผลที่หยุด และชื่อปฏิบัติการสำหรับ chat tool_call หรือ agent_run ฟิลด์เหล่านี้บอกค่าใช้จ่ายและเวลาได้ดี แต่ไม่มีฟิลด์ใดเปลี่ยนเป็นสีแดงเมื่อ agent คืนเงินผิดออเดอร์ เพราะทั้งหมดสะท้อนตัวการเรียก ไม่ใช่คุณภาพของคำตอบ
รายงานการใช้งาน agent ในทีมต่างๆ ระบุว่า 89% ของทีมมีการติดตั้ง observability แล้ว ในขณะที่เพียง 52.4% เท่านั้นที่ทำ offline evaluations กับชุดทดสอบ คำพูดที่ควรนำไปอ้างได้คือ การมีการสังเกตการณ์แทบจะเป็นสากล แต่การประเมินอย่างเป็นระบบกลับใกล้เคียงกับการโยนเหรียญว่าจะมีหรือไม่ ขณะเดียวกัน หลายทีมก็ยอมรับว่าเรื่องคุณภาพอย่างความถูกต้อง ความเกี่ยวข้อง และความสม่ำเสมอ คืออุปสรรคหลักในการนำ agent เข้าโปรดักชัน แต่กลับเป็นสิ่งที่วัดน้อยที่สุด
แม้ conventions จะมี namespace สำหรับการประเมินผล เช่น gen_ai.evaluation.name gen_ai.evaluation.score.value gen_ai.evaluation.score.label และ gen_ai.evaluation.explanation ซึ่งรองรับ label อย่าง correct แต่ฟิลด์เหล่านี้เป็นเพียงช่องว่าง ไม่ใช่เซนเซอร์อัตโนมัติ จนกว่าทีมจะเขียนตัวประเมินเองและเติมค่าเข้าไป ช่องเหล่านี้จะว่างอยู่เสมอ ซึ่งหมายความว่าไม่มีแพลตฟอร์มใดบอกคุณได้เองว่าการคืนเงินครั้งนั้นถูกออเดอร์หรือไม่ ต้องมาจากเกณฑ์และตัวประเมินที่คุณสร้างเอง
ออกแบบการประเมินผลและตัวชี้วัด AI Agent ความเชื่อถือได้
เมื่อยอมรับว่า observability ไม่สามารถแทนการประเมินผล การตั้งตัวชี้วัดความเชื่อถือได้จึงเป็นขั้นถัดไป โดยเฉพาะงานที่ต้องหน้าลูกค้า สิ่งที่ต้องวัดไม่ใช่แค่ pass@k ซึ่งดูว่าอย่างน้อยหนึ่งใน k ครั้งสำเร็จ แต่ควรมอง pass^k ที่วัดว่าทุกครั้งใน k ครั้งให้ผลลัพธ์ถูกต้อง เพื่อสะท้อนว่าลูกค้าของคุณไม่ได้รัน agent แปดครั้งแล้วเลือกรันที่ดีที่สุด แต่เขาเจอผลลัพธ์ครั้งเดียวต่อหนึ่งเคส นี่คือมาตรวัดที่ซื่อสัตย์สำหรับการออกแบบความเชื่อถือได้
การตั้งชุดทดสอบสำหรับ offline evaluations เป็นสิ่งที่หลายทีมผัดวัน แต่ประโยชน์ชัดเจนมาก เพราะช่วยเปิดช่องให้คุณเปรียบเทียบสถาปัตยกรรม agent ต่างๆ นโยบายรีเทรย์ และรูปแบบสัญญาเครื่องมือว่าอันไหนให้ pass^k สูงกว่า โดยไม่ต้องเสี่ยงในโปรดักชัน ขณะเดียวกัน การเพิ่ม online evaluations ในระบบจริง เช่นการตรวจบางเคสแบบสุ่มด้วยตัวประเมิน สามารถทำให้คุณรู้ได้ว่าพฤติกรรมที่เห็นในแดชบอร์ดยังตรงกับเกณฑ์ correct หรือไม่ ความต่างระหว่าง trace สองอันอาจไม่เห็นเลยจนกว่าจะมีการ diff สถานะธุรกิจจริงแบบสี่บรรทัด
การออกแบบตัวประเมินผลที่ดีต้องยึดโจทย์ธุรกิจเป็นหลัก เช่น ในเคสคืนเงิน สิ่งที่ถูกต้องคือคืนให้กับออเดอร์ที่ลูกค้าร้องเรียน ไม่ใช่แค่ว่า API issue_refund สำเร็จ การประเมินจึงต้องดูทั้งข้อมูลออเดอร์ เหตุผลที่ร้องเรียน และผลลัพธ์สุดท้าย แล้วบันทึกเป็น score label ว่า correct หรือไม่ในฟิลด์ gen_ai.evaluation.score.label เมื่อทำเช่นนี้ การติดตามผ่าน observability จึงมีบริบทเพิ่ม สามารถเชื่อม trace เดิมกับคุณภาพจริงของคำตอบได้ ไม่ใช่แค่ดูเวลาตอบและจำนวนโทเคน
Reconciliation และการกู้คืนให้ระบบ AI ปลอดภัยเมื่อผลลัพธ์ไม่ชัดเจน
ต่อให้ออกแบบดีแค่ไหน ระบบกระจายตัวย่อมเจอผลลัพธ์ไม่ชัด เช่น timeout หรือการตอบกลับหล่นหาย สิ่งที่ต้องมีคือกลไก reconciliation ไม่ใช่หวังว่าทุกอย่างจะผ่านไปเอง สัญญาเครื่องมือต้องระบุว่าเมื่อผลลัพธ์ unknown runtime ต้องเรียกฟังก์ชัน lookup จากระบบปลายทางด้วย operation identity เพื่อตรวจสอบสถานะก่อนอนุญาตให้เขียนซ้ำ ข้อสรุปที่ปลอดภัยคือ only not_found จึงจะอนุญาตให้รีเทรย์สำหรับงาน non_repeatable ส่วน still_unknown ต้องหยุด รอ หรือยกระดับ ไม่ควรกลายเป็นพรอมต์ถามโมเดลว่าควรทำอะไรต่อ
หากระบบปลายทางไม่มี lookup และไม่มีการดับเบิลเช็ค นั่นต้องถูกบันทึกไว้ในสัญญาเครื่องมือว่า automation ไม่สามารถสร้างการรับประกันที่ dependency ไม่มีให้ได้ วิธีปลอดภัยอาจเป็นการบังคับให้คนตรวจในระบบปลายทางก่อนทุกครั้งที่มี unknown outcome การผูกการอนุมัติจากมนุษย์เข้ากับ operation เดียวกันยังช่วยป้องกันไม่ให้คำว่ารีเทรย์กลายเป็นการขยายสิทธิ์ เช่นการส่งคืนเงินซ้ำโดยไม่มีการอนุมัติใหม่ ซึ่งช่วยให้ระบบ AI ปลอดภัยมากขึ้นทั้งต่อธุรกิจและลูกค้า
ผลสุดท้ายของการมี Side-effect contracts ที่ดี การสร้างตัวตนปฏิบัติการก่อนรีเทรย์ การวางกลไก reconciliation และการประเมินผลทั้ง offline และ online คือระบบที่แม้ยังไม่สามารถการันตีการทำงานครั้งเดียวเป๊ะ แต่ทุกขอบเขตชัด ตรวจสอบได้ และกู้คืนได้ ความคุ้มค่าคือเมื่อมีเหตุผิดพลาด คุณรู้ว่าต้องดู trace จุดไหน ตรวจสอบสถานะภายนอกอย่างไร และกดเบรก agent ตรงไหนแทนการหวังให้ระบบรักษาตัวเองบนข้อยกเว้นที่อาจกลายเป็นการทำงานซ้ำโดยไม่ตั้งใจ