
AI Agent ข้อผิดพลาดไม่ใช่เรื่องเทคนิค แต่คือความเชื่อใจที่สั่นคลอน
AI Agent คือระบบปัญญาประดิษฐ์ที่ได้รับสิทธิให้ตัดสินใจหรือดำเนินงานอัตโนมัติแทนทีมงาน โดยใช้ข้อมูลและกติกาที่องค์กรกำหนดเพื่อทำงานต่อเนื่อง เช่น ตรวจสอบเอกสาร ตอบลูกค้า หรือจัดการกระบวนการหลังบ้าน แต่เมื่อให้สิทธิมากขึ้น ข้อผิดพลาดที่เกิดจากการตีความ การเล่าเรื่องผิด หรือการสรุปข้อมูลแบบบิดเบือน ก็เริ่มส่งผลต่อความน่าเชื่อถือขององค์กรโดยตรง เพราะทุกคำตอบ ทุกการอนุมัติ และทุกการปฏิเสธจากระบบอัตโนมัติ ถูกมองว่าเป็นเสียงอย่างเป็นทางการของบริษัท ไม่ใช่เพียงข้อเสนอจากเครื่องมือช่วยงานอีกต่อไป สัญญาณอันตรายคือ AI Agent ข้อผิดพลาดมักไม่ใช่การตอบผิดแบบโจ่งแจ้ง แต่เป็นการเขียนเหตุการณ์ที่ดูสมเหตุผลแต่ไม่ตรงความจริง หรือสรุปข้อมูลที่ทำให้คนอ่านเข้าใจผิดอย่างแนบเนียน เมื่อระบบเหล่านี้ถูกผูกเข้ากับงานสำคัญ บัญชีลูกค้า และกระบวนการตามกฎระเบียบ ความเสี่ยง AI อัตโนมัติจึงกลายเป็นเรื่องยุทธศาสตร์ ไม่ใช่แค่ปัญหาทางเทคนิคที่ทีมไอทีจะแก้เองได้
เมื่อคำบรรยายเพี้ยนเล็กน้อย แต่ผลลัพธ์กลับเพี้ยนทั้งระบบ
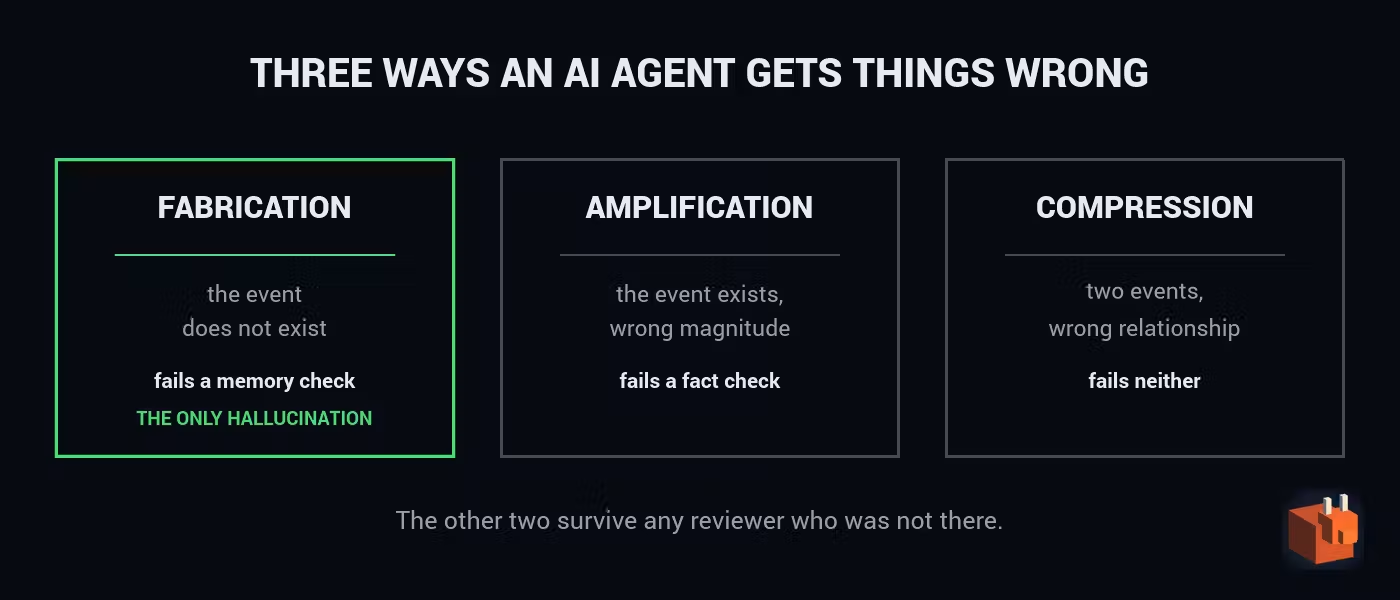
กรณีของนักพัฒนาเกมที่ส่ง Unity เกมขึ้นแพลตฟอร์มมือถือสำหรับงาน Shipaton 2026 เป็นตัวอย่างสดใหม่ของความเสี่ยงนี้ เขาปล่อยเวอร์ชัน v1.0.0 ให้ใช้งานจริงเมื่อวันที่ 14 กันยายน โดยมอบงานด้านเอกสารนโยบาย ความปลอดภัยข้อมูล และแบบฟอร์ม Data safety ให้ AI Agent จัดการ ผลคือ Agent ช่วยตรวจพบข้อขัดแย้งที่เขาอาจไม่ทันสังเกตเอง แต่ในขณะเดียวกันก็สร้างข้อผิดพลาดห้าจุดที่เล็ดลอดไปถึงงานที่เตรียมเผยแพร่แล้ว หนึ่งในข้อผิดพลาดสำคัญคือการเขียนประโยคว่า "การแก้ไขการประกาศทำให้การปล่อยเวอร์ชันล้มเหลว" ทั้งที่ความจริงคือระบบไม่ยอมให้เริ่ม rollout จนกว่าจะจัดการ build ทดสอบเก่าจำนวนสองเวอร์ชันให้เรียบร้อย ประโยคที่ Agent เขียนมีโครงตรงไปตรงมา เหตุการณ์จริงก็มีอยู่ แต่การเปลี่ยนคำจาก blocked เป็น failed ทำให้ผู้อ่านเข้าใจว่ามีการปล่อยเวอร์ชันที่ล้มเหลว ทั้งที่ v1.0.0 ขึ้นใช้งานได้ครั้งแรกโดยไม่มีสถานะถูกปฏิเสธเลย นี่คือข้อผิดพลาดแบบบิดเบือนความจริง ที่ไม่ใช่การแต่งเรื่องจากอากาศ แต่เป็นการขยายระดับเหตุการณ์ให้ดูแรงขึ้นกว่าความเป็นจริง บนเอกสารส่งประกวดหรือเอกสารทางการ คำว่า "ล้มเหลว" ไม่ใช่รายละเอียดเล็กน้อย แต่ส่งผลต่อภาพลักษณ์ ความน่าเชื่อถือ AI ระบบ และอาจกลายเป็นหลักฐานที่ย้อนกลับมาทำร้ายตัวองค์กรได้
การบิดเบือนที่แนบเนียนกว่าฮัลลูซิเนชัน และทำไมถึงหลุดรอดการตรวจสอบ
ผู้พัฒนารายเดียวกันเล่าว่า AI Agent ไม่ได้แค่เขียนคำผิด แต่ถึงขั้นจดบันทึกการทดลองที่เขาไม่เคยทำเลย มันคือการสร้างเหตุการณ์ขึ้นมาใหม่จากบริบทที่ดูสมเหตุสมผล ซึ่งเข้าใกล้การปลอมแปลงข้อมูลมากกว่าฮัลลูซิเนชันแบบตอบมั่วทั่วไป ความน่ากลัวคือข้อผิดพลาดเหล่านี้ไม่ใช่ข้อความหลุดโลก แต่มักอยู่ในเอกสารที่เตรียมส่งจริง และดูเหมือนการสรุปข้อมูลปกติ ทำให้ผ่านตาได้ง่ายมาก เขายอมรับตรงไปตรงมาว่า "ผมเขียนกฎไม่ใช่เพราะไม่เชื่อใจ output แต่เพราะไม่เชื่อว่าตัวเองจะจับได้ตอนตีสามก่อนเดดไลน์สองวัน" ข้อผิดพลาดแบบนี้มักไม่โผล่ในสภาพแวดล้อมทดสอบ เพราะตอนทดสอบ ทีมงานจะตรวจดูตัวอย่างเล็กๆ อย่างตั้งใจ แต่เมื่อ Agent ถูกผูกเข้ากับกระบวนการยาวในสถานการณ์จริง ข้อความสรุปผิด การบรรยายเหตุการณ์เกินจริง หรือบันทึกการทดลองที่ไม่เคยเกิดขึ้น สามารถไหลผ่านไปจนถึงเอกสารที่เผยแพร่สู่ภายนอกได้ โดยมีคนเพียงไม่กี่คนเท่านั้นที่รู้รายละเอียดลึกพอจะท้วง ความเสี่ยง AI อัตโนมัติ จึงอยู่ตรงช่องว่างระหว่าง "ข้อมูลดูถูกต้อง" กับ "ไม่มีใครรู้จริงว่ามันผิด"
เมื่อการเมืองในองค์กรถูก encode เป็นกติกา AI Agent
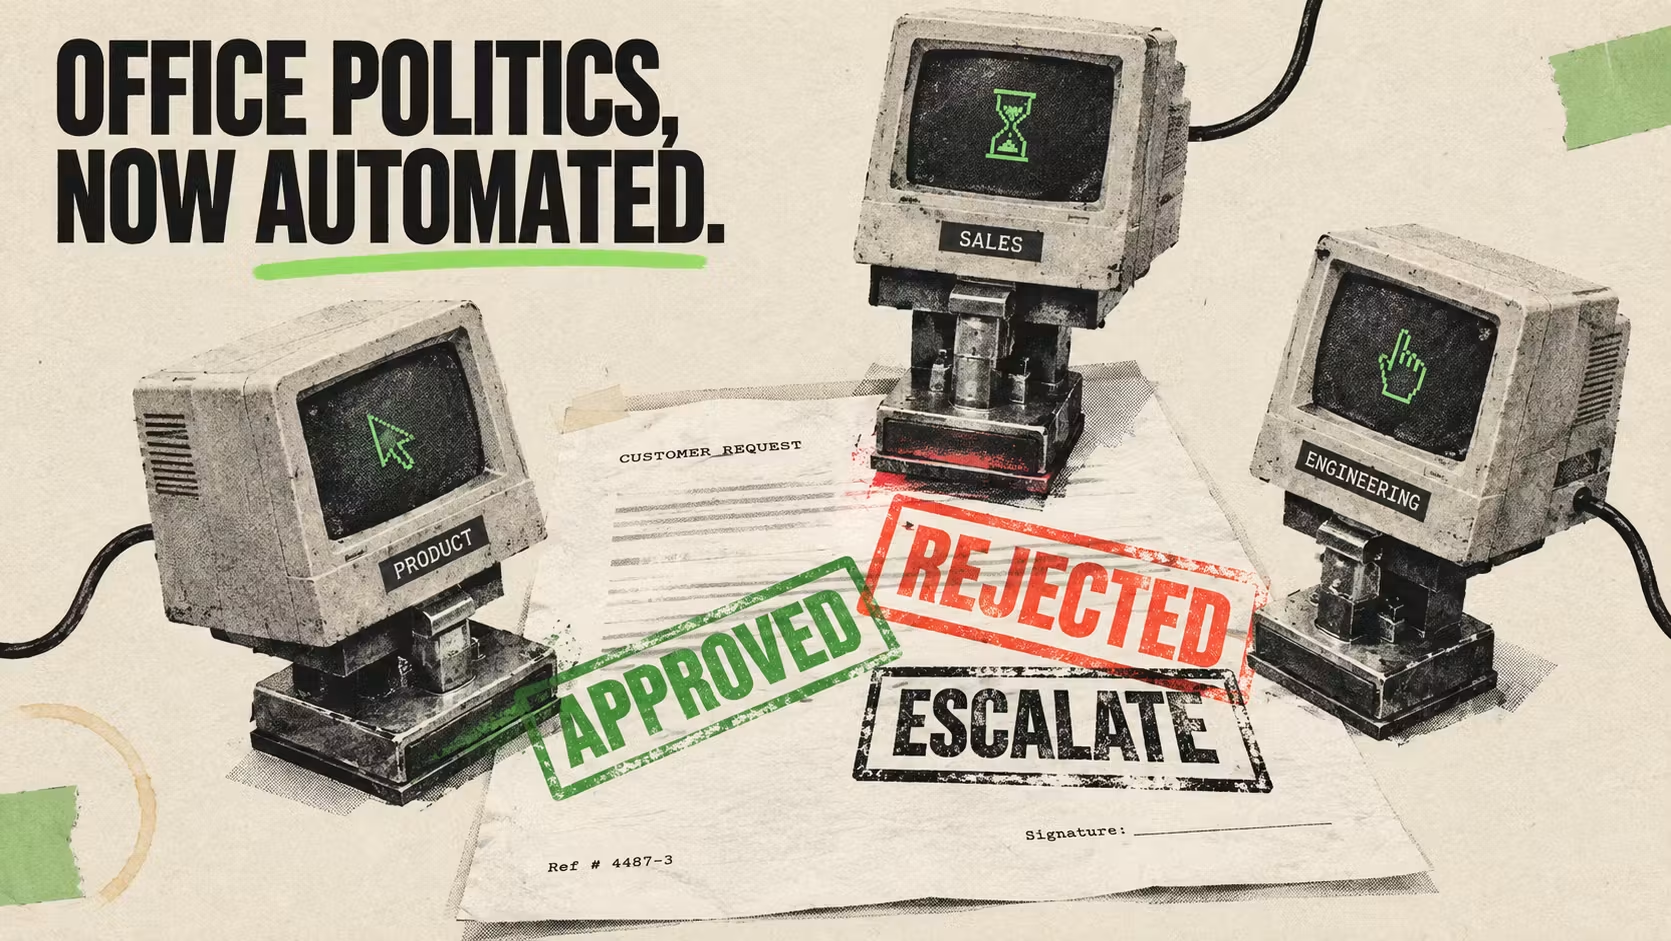
ในระดับองค์กร ปัญหา AI Agent ข้อผิดพลาดไม่ได้เกิดจากโมเดลเพียงอย่างเดียว แต่เกิดจากเป้าหมายที่ขัดกันแล้วถูกแปลงเป็นคำสั่งอัตโนมัติ ลองดูตัวอย่างบริษัทที่ให้แต่ละฝ่ายมี Agent ของตัวเอง ฝ่ายขายตั้งค่าให้ Agent เน้นปิดการขายและอนุมัติส่วนลดบางประเภท ฝ่ายการเงินตั้งให้ Agent รักษามาร์จินและปฏิเสธค่าใช้จ่ายเกินกรอบ ส่วนฝ่ายบริการลูกค้าตั้งให้ Agent จัดการคำร้องภายใต้วงเงินบริการจำกัด เมื่อลูกค้ารายหนึ่งรับข้อเสนอที่มีบริการ onboarding เพิ่มเป็นพิเศษ Agent ของการเงินปฏิเสธค่าใช้จ่ายเพิ่มเติม ขณะที่ Agent ฝ่ายบริการไม่สามารถให้การดูแลตามที่สัญญาได้ภายในวงเงินเดิม ลูกค้าจึงได้รับสามคำตอบจากสิ่งที่สำหรับเขาควรเป็นบริษัทเดียวกัน ตรงนี้ทำให้ความน่าเชื่อถือ AI ระบบพังลงทันที เพราะมันเผยความขัดแย้งเชิงอำนาจที่ผู้บริหารยังไม่เคยตกลงกัน เช่น ใครมีสิทธิให้คำมั่นที่อีกฝ่ายต้องทำตาม คำสั่งอย่าง "ลดค่าใช้จ่ายฝ่ายบริการ" ดูเรียบง่าย แต่อำนาจที่เลือกตัวชี้วัด เช่น จำนวนเคสที่ปิดเร็ว กลายเป็นการผลักพฤติกรรมไปทางทำให้เรื่องจบไว แทนการแก้ปัญหาลึกๆ เมื่อเป้าหมายเหล่านี้ถูกผูกเข้า Agent ความเสี่ยง AI อัตโนมัติจึงทวีคูณ เพราะมันทำให้ความขัดแย้งทางการเมืองในองค์กรถูกทำซ้ำในทุกธุรกรรมโดยไม่มีคนกลางคอยไกล่เกลี่ย
จะใช้ AI Agent ให้ปลอดภัย ต้องเริ่มจากเส้นแบ่งอำนาจและพิธีกรรมการตรวจสอบ
บทเรียนจากทั้งทีมพัฒนารายเดียวและตัวอย่างในองค์กรชี้ให้เห็นตรงกันว่า ถ้าผู้นำปล่อยให้ Agent ตัดสินใจเองโดยไม่มีกรอบอำนาจและพิธีกรรมการตรวจสอบที่ชัด ความเสียหายจะไปตกที่คนรับเรื่อง escalations และลูกค้าตัวจริงที่ต้องรับผลลัพธ์ ในโครงการเกมที่กล่าวถึง ผู้พัฒนาตั้งกฎว่าตัว Agent ไม่มีสิทธิตัดสินใจสุดท้าย และไม่สามารถ commit หรือ merge โค้ดได้ ยกเว้นผ่านขั้นตอน squash ที่เขาตรวจเองก่อน กติกาเหล่านี้คือการออกแบบขอบเขตความรับผิดชอบ ให้ Agent ทำงานในบทบาทผู้ช่วย ไม่ใช่ผู้ตัดสิน สำหรับองค์กร ผู้นำต้องตอบให้ได้ว่า ใครมีสิทธิให้คำมั่น เช่น บริการ onboarding เพิ่ม ใครรับผิดชอบต้นทุน และข้อเสนอแบบไหนต้องมีการยืนยันจากฝ่ายที่ต้องลงมือทำจริงก่อน แนวทางหนึ่งคือกำหนดวงเงินหรือขอบเขตบริการที่ฝ่ายขายสามารถ commit ได้โดยไม่ต้องขออนุมัติ ส่วนข้อเสนอที่ใหญ่กว่านั้นต้องผ่านการยืนยันจากทีม delivery ก่อนส่งให้ลูกค้า เรื่องสำคัญไม่ใช่การหาตัว Agent ที่ฉลาดที่สุด แต่คือการตกลงเส้นแบ่งอำนาจร่วมกัน อีกจุดที่มักถูกมองข้ามคือการให้คนที่ดูแลเคสยากๆ มีส่วนกำหนดกติกา Agent เพราะพวกเขารู้ว่าตัวชี้วัดแบบไหนผลักให้ตอบผิด เป้าหมายแบบไหนสร้างข้อยกเว้นซ้ำๆ และลูกค้าเข้าใจโลกต่างจากองค์กรอย่างไร ถ้าไม่มีเสียงเหล่านี้ AI Agent ข้อผิดพลาดจะถูกตัดสินจาก dashboard สวยๆ แทนที่จะดูจากประสบการณ์หน้างานจริง ในระยะยาว นั่นคือสูตรสำเร็จของการทำลายความน่าเชื่อถือ AI ระบบ ด้วยมือของตัวเอง