
Claude Opus 5.5 คืออะไร และทำไมเรื่องราคาถึงสำคัญ
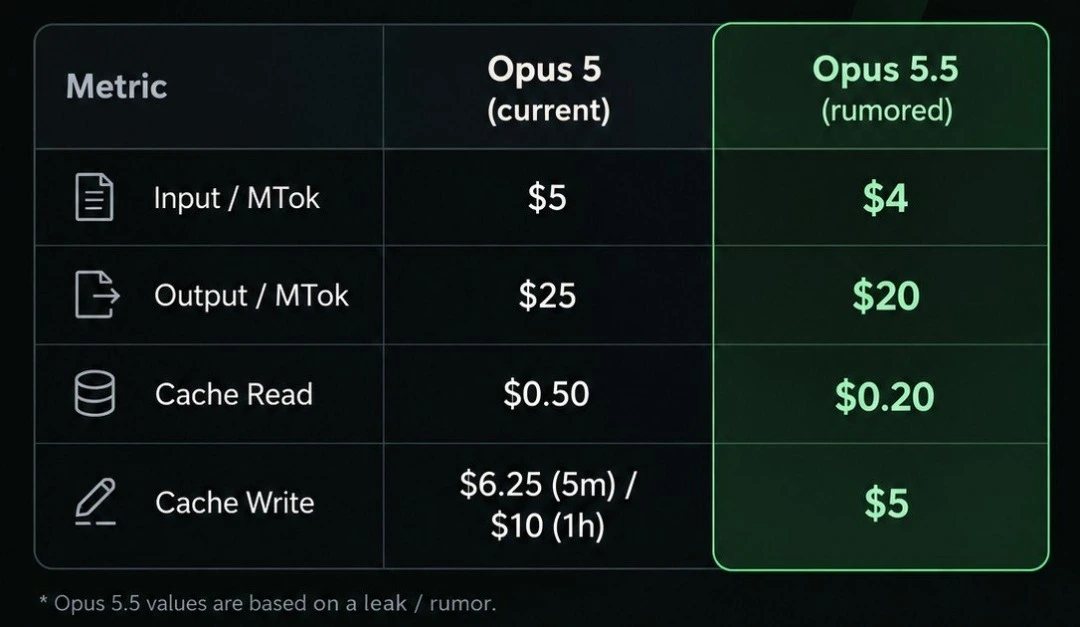
Claude Opus 5.5 คือโมเดลปัญญาประดิษฐ์รุ่นเรือธงใหม่ที่ออกแบบมาสำหรับงานเอเจนต์ระยะยาวและงานความรู้ที่ซับซ้อน โดยตั้งใจให้มีความสามารถใกล้เคียงโมเดลระดับสูงกว่าในตระกูลเดียวกัน แต่ปรับโครงสร้างต้นทุนให้ลดลงอย่างมาก เพื่อให้ผู้ใช้และองค์กรสามารถเข้าถึงพลังของโมเดล AI ระดับแนวหน้าด้วยค่าใช้จ่ายต่อครั้งที่ต่ำลงกว่าเดิม โดยยังคงรองรับบริบทงานขนาดใหญ่และการสร้างเอาต์พุตจำนวนมากได้อย่างต่อเนื่องโดยไม่เสียคุณภาพการทำงาน สาระสำคัญของ Claude Opus 5.5 ไม่ใช่แค่การเปิดตัวโมเดลใหม่ แต่เป็นการตั้งคำถามกับสมการเดิมของตลาด AI ว่าโมเดลที่เก่งต้องแพงเสมอหรือไม่ Anthropic เปิดตัว Opus 5.5 เป็นโมเดลแรกในตระกูล Claude 5.5 ที่ทำงานส่วนใหญ่ได้ในระดับเดียวกับ Claude Fable 5.1 แต่ต้นทุนใช้งานต่ำกว่า Claude Opus 5 ราว 40% ในงานทั่วไป การขยับราคาลงในขณะที่ประสิทธิภาพยังอยู่ระดับแนวหน้าทำให้มันกลายเป็นตัวอย่างชัดเจนของโมเดล AI ราคาถูกที่ไม่ได้แลกคุณภาพกับต้นทุน จังหวะการเปิดตัวก็น่าสนใจ Anthropic เพิ่งประกาศแนวคิดคุมจังหวะการพัฒนา AI แนวหน้า หรือการพัฒนาให้ความสามารถของโมเดลเดินตามหลังมาตรการความปลอดภัยไม่ห่างเกินไป Opus 5.5 จึงถูกออกแบบให้เป็นรุ่นแรกที่สะท้อนแนวคิดนี้ในทางปฏิบัติและผ่านการทดสอบจากหน่วยงานภายนอกอย่าง Frontier Design และ METR ก่อนปล่อยใช้งาน นั่นทำให้การลดต้นทุนครั้งนี้ไม่ได้เกิดจากการตัดความสามารถหรือมาตรการคุมความเสี่ยง แต่จากการคิดใหม่เรื่องสถาปัตยกรรมและค่าใช้จ่ายเบื้องหลังโมเดล
โมเดล AI ราคาถูกแต่เก่งเท่าระดับเรือธง: เปรียบเทียบ LLM และตัวเลขที่มีความหมาย
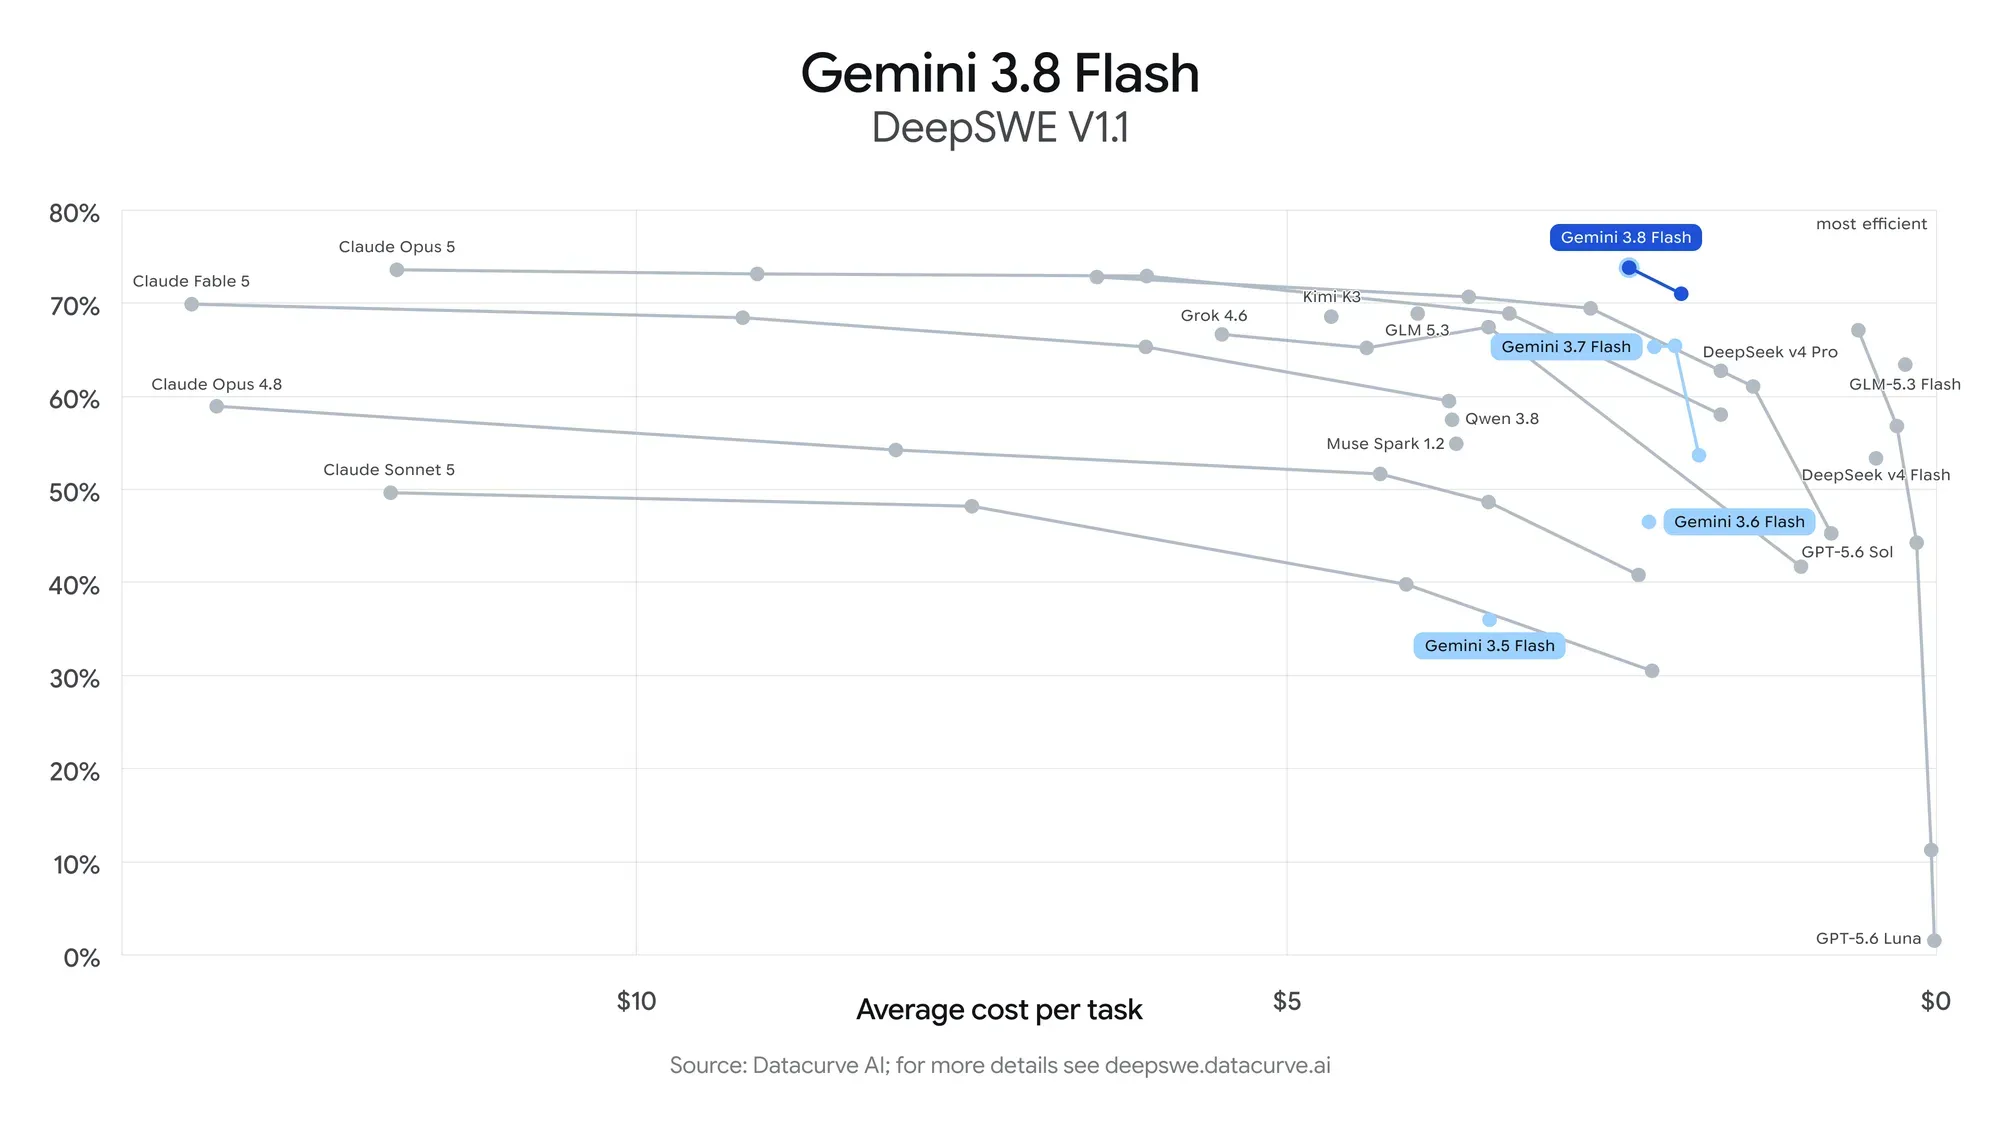
จุดพลิกเกมของ Claude Opus 5.5 คือการแสดงให้เห็นว่าปัญญาประดิษฐ์ประหยัดสามารถให้ผลลัพธ์ใกล้หรือเหนือกว่าคู่แข่งที่ราคาแพงกว่าในหลายสนามทดสอบมาตรฐาน เปรียบเทียบ LLM กันตรงๆ ในงานเขียนโค้ดแบบเอเจนต์ Opus 5.5 ทำคะแนนบน Terminal-Bench 4.0 ได้ 66.4% สูงกว่า Fable 5.1 ที่ 55.8% Opus 5 ที่ 52.3% และ GPT-6 Astra ที่ 57.9% ของอีกค่ายหนึ่ง ข้อเท็จจริงนี้สะท้อนว่าการลดต้นทุนไม่ได้มาพร้อมการลดความเก่งในระดับที่ผู้ใช้มืออาชีพรู้สึกได้ทันที ฝั่งงานความรู้ที่เป็นหัวใจของ AI enterprise solutions ก็มีภาพคล้ายกัน Opus 5.5 ทำคะแนน Elo บน GDPval-AA v2.1 ซึ่งใช้โจทย์จริงจาก 44 อาชีพ ได้ 1846 คะแนน สูงกว่า Fable 5.1 ที่ 1735 Opus 5 ที่ 1708 และ GPT-6 Astra ที่ 1542 หมายความว่าผู้ใช้ที่ต้องการตัวช่วยในงานวิชาชีพ เช่น การวิเคราะห์ข้อมูล เอกสาร หรือการวางแผนงานเชิงซับซ้อน สามารถเลือกโมเดลนี้เพื่อประหยัดต้นทุนโดยไม่ต้องยอมรับคุณภาพที่ด้อยลง แน่นอนว่า Opus 5.5 ไม่ได้ชนะทุกสนามทดสอบ GPT-6 Astra ยังได้คะแนนสูงกว่าใน AutomationBench ที่วัดงานธุรกิจ และ Terminal-Bench-Science ที่เน้นงานวิจัยวิทยาศาสตร์ แต่เมื่อภาพรวมคะแนนเริ่มใกล้กันมากในระดับโมเดลแนวหน้า ความต่างเล็กน้อยบนกราฟ benchmark มีความหมายต่อประสบการณ์ใช้งานจริงน้อยลง Anthropic เองก็ยอมรับว่าในการใช้จริงภายในบริษัท ช่องว่างระหว่าง Opus 5.5 กับ Fable 5.1 แคบกว่าที่ตัวเลขบอก ซึ่งยิ่งตอกย้ำว่าคำถามสำคัญไม่ใช่โมเดลไหนเก่งที่สุดในตัวเลข แต่คือโมเดลไหนให้สมดุลระหว่างค่าใช้จ่ายและความสามารถที่คุ้มค่าในระยะยาว
เบื้องหลังความประหยัด: กลยุทธ์แคชและการออกแบบเพื่อเอเจนต์ระยะยาว
หัวใจของการทำให้ Claude Opus 5.5 กลายเป็นปัญญาประดิษฐ์ประหยัดคือการมองต้นทุนเชิงเทคนิคใหม่ โดยเฉพาะงานเอเจนต์และงานโค้ดที่ต้องให้โมเดลทำงานต่อเนื่องหลายชั่วโมงและอ่านบริบทเดิมซ้ำหลายครั้ง Anthropic ระบุว่าค่าอ่านข้อมูลจากแคช ซึ่งถือเป็นต้นทุนก้อนใหญ่ของงานลักษณะนี้ ถูกปรับลดลง 60% ขณะที่ค่าเขียนแคชก็ลดลงเช่นกัน เมื่อประกอบกับการออกแบบให้โมเดลใช้โทเคนต่องานน้อยลง ทำให้ต้นทุนรวมต่อหนึ่งงานลดได้ราว 40% โดยไม่ตัดความสามารถในเนื้อสมองของโมเดล ผลจากการปรับสถาปัตยกรรมเช่นนี้สะท้อนชัดในงานจริง เช่น การย้ายโค้ดเบสหรือรีวิวโค้ดทั้งโปรเจกต์ Opus 5.5 ถนัดงานยาวกินพื้นที่ทั้งโค้ดเบสอย่างการย้ายระบบหรือการตรวจสอบโค้ด ทั้งการทดสอบภายนอกที่ย้ายโค้ด 680,000 บรรทัดในเวลาไม่ถึงหนึ่งวัน และการทดสอบภายในที่แปลงซอฟต์แวร์ HAProxy จากภาษา C เป็น Rust ซึ่ง Opus 5.5 ทำเสร็จเร็วกว่าและต้นทุนถูกกว่ารุ่นพี่อย่างมีนัยสำคัญ นี่คือภาพของโมเดลที่ไม่ได้แค่ตอบคำถาม แต่ทำหน้าที่เป็นเอเจนต์ทำงานยาวในระบบขององค์กร ที่สำคัญ Opus 5.5 ยังสร้างเอาต์พุตได้เร็วกว่า Opus 5 มากกว่า 30% และมีโหมด Fast Mode บนแพลตฟอร์มของ Anthropic ที่เร่งความเร็วได้สูงสุด 2.5 เท่าสำหรับงานที่ต้องการความเร็วเป็นพิเศษ แม้ฟีเจอร์นี้จะเพิ่มค่าใช้จ่ายต่อหน่วย แต่การมีตัวเลือกทั้งโหมดประหยัดและโหมดเร็วทำให้องค์กรออกแบบการใช้โมเดลได้ยืดหยุ่นขึ้น เลือกจ่ายเพิ่มเฉพาะงานที่ต้องการความเร็วจริง และให้เอเจนต์ทำงานประจำในโหมดต้นทุนต่ำเป็นหลัก
ผลกระทบต่อผู้ใช้และการแข่งขันตรงกับ GPT-6
ในมุมผู้ใช้ปลายทาง การที่โมเดล AI ราคาถูกอย่าง Opus 5.5 มาพร้อมความสามารถระดับแนวหน้า ทำให้ทางเลือก AI enterprise solutions เปลี่ยนไปอย่างชัดเจน ผู้ใช้แบบสมัครสมาชิกได้รับโควตาการใช้งานเพิ่มขึ้นในช่วงเวลา 5 ชั่วโมงสำหรับแพ็กเกจ Pro Max Team และ Enterprise แบบคิดตามจำนวนผู้ใช้ พร้อมสิทธิ์รีเซ็ตขีดจำกัดการใช้งานที่เก็บไว้ใช้ภายหลังได้ นี่ไม่ใช่แค่การลดต้นทุนต่อโทเคน แต่คือการออกแบบเงื่อนไขการใช้งานให้รองรับทีมและองค์กรที่ต้องการให้เอเจนต์ทำงานต่อเนื่องได้โดยไม่ติดเพดานง่ายๆ บนเวทีการแข่งขันกับ GPT-6 ภาพเริ่มชัดว่าตลาดไม่ได้ตัดสินด้วยชื่อแบรนด์เดียวอีกต่อไป ทั้งสองค่ายเพิ่งเปิดตัวโมเดลเรือธงชุดใหม่ในเดือนเดียวกัน โดยฝั่งคู่แข่งมี GPT-6 Astra และ Sol สำหรับงานทั่วไป ส่วน Anthropic นำเสนอ Opus 5.5 ที่เน้นงานเอเจนต์ระยะยาวและงานความรู้ เมื่อเทียบต้นทุนต่อความพยายามบน FrontierCode Opus 5.5 ทำให้ต้นทุนต่อหนึ่งงานต่ำกว่า GPT-6 Astra ประมาณ 20% และทำคะแนน Terminal-Bench 4.0 เทียบเท่ากันด้วยต้นทุนราว 40% เท่านั้น รวมถึงชนะ GPT-5.6 Sol บน CursorBench ด้วยคะแนนสูงกว่า 11 จุดและต้นทุนประมาณหนึ่งในสาม ประสบการณ์ใช้งานในชีวิตประจำวันก็สะท้อนแนวโน้มนี้ มีการทดสอบให้ ChatGPT-6 และ Claude Opus 5.5 ตอบโจทย์วางแผนปาร์ตี้เด็กในงบจำกัด ผลสรุประบุว่า Claude ชนะเพราะให้แผนงานพร้อมใช้งานละเอียดรอบคอบด้านความปลอดภัย ในขณะที่อีกฝั่งให้ผลลัพธ์คล้ายรายการซื้อของที่กระจัดกระจาย นี่คือสัญญาณว่าการแข่งขันกำลังขยับจากการโชว์สเปกไปสู่การพิสูจน์ว่าโมเดลไหนช่วยผู้ใช้ทำงานจริงได้เป็นรูปธรรมและคุ้มค่าเงินมากกว่า
Opus 5.5 กับการกำหนดจังหวะอนาคต AI แนวหน้า
เมื่อมองไปข้างหน้า จุดยืนของ Anthropic ที่วาง Opus 5.5 ให้เป็นตัวอย่างของการคุมจังหวะการพัฒนา AI แนวหน้าอาจกลายเป็นมาตรฐานใหม่ของวงการ ก่อนหน้านี้ไม่นาน ซีอีโอบริษัทเสนอว่าการพัฒนา AI ควรเดินในจังหวะที่แนวปฏิบัติด้านความปลอดภัยยังนำหน้าความสามารถของโมเดล และ Opus 5.5 ก็แสดงให้เห็นในทางปฏิบัติผ่านการเปิดใช้มาตรการป้องกันจริงระหว่างทดสอบ โมเดลจะส่งต่อบางงานด้านความปลอดภัยไซเบอร์และชีววิทยาให้รุ่นก่อนทำแทนเมื่อระบบป้องกันทำงาน ทำให้คะแนนในบาง benchmark ต่ำลง แต่สะท้อนการให้ความสำคัญกับความเสี่ยงมากกว่าตัวเลข ในทางนโยบาย Anthropic ไม่มองว่ามาตรการภายในองค์กรเพียงพอสำหรับโมเดลที่อาจเก่งถึงขั้นทำงานวิจัย AI ได้เอง จึงเริ่มผลักดันโครงสร้างสาธารณะและความร่วมมือกับบริษัทที่ปรึกษา รวมถึงตั้งโครงการ Cyber Verification Program เพื่อให้ผู้เชี่ยวชาญด้านการป้องกันระบบเข้ามาตรวจสอบและใช้ Opus 5.5 อย่างมีกรอบในอีกไม่กี่สัปดาห์ข้างหน้า รวมทั้งเปิดช่องให้ห้องแล็บในมหาวิทยาลัย สตาร์ทอัพ และบริษัทยา สมัครโครงการ Life Sciences Verification Program เพื่อใช้โมเดลกับงานวิจัยชีววิทยาได้เต็มรูปแบบภายใต้การตรวจสอบ ในมุมมองของผู้เขียน การที่โมเดลอย่าง Claude Opus 5.5 สามารถลดต้นทุนรวมราว 40% ขณะยังคงประสิทธิภาพระดับแนวหน้าถือเป็นหมุดหมายสำคัญของตลาด AI ระดับสูง โมเดล AI ราคาถูกไม่ใช่คำเรียกเล่นๆ อีกต่อไป แต่กลายเป็นกลยุทธ์แข่งขันจริงที่บีบให้คู่แข่งอย่าง GPT-6 ต้องพิสูจน์ว่าตัวเองคุ้มค่าต่อเม็ดเงินมากแค่ไหน ท้ายที่สุด ผู้ใช้และองค์กรจะเป็นฝ่ายชี้ขาดด้วยการเลือกโมเดลที่ให้สมดุลระหว่างราคา ความเก่ง และกรอบความปลอดภัยที่ไว้วางใจได้มากที่สุด