
จากคลัสเตอร์ 960,000 GPU สู่ยุคใหม่ของศูนย์ข้อมูล AI
โครงสร้างพื้นฐาน AI ระดับองค์กรที่รองรับ GPU หลายแสนตัวคือระบบศูนย์ข้อมูลที่ออกแบบมาเพื่อการฝึกและอนุมานโมเดลขนาดใหญ่ โดยรวมการประมวลผล เครือข่าย และที่เก็บข้อมูลเข้าด้วยกันในสเกลที่สามารถเชื่อมต่อ GPU ได้ตั้งแต่ระดับแร็กเดียวไปจนถึงหลายไซต์ พร้อมรองรับงานแบบเอเจนต์และเวิร์กโหลดแบบกระจายที่ต้องการความหน่วงต่ำและการใช้พลังงานอย่างมีประสิทธิภาพ
หัวใจของข่าวนี้คือการที่ Google Cloud และ NVIDIA ประกาศบนเวที GTC Berlin ว่ากำลังสร้างคลัสเตอร์ AI ที่สามารถสเกลได้สูงสุด 960,000 GPU ผ่านโครงข่าย Virgo Network ที่เชื่อมต่อ Rubin GPU ได้ถึง 80,000 ตัวในหนึ่งไซต์ และขยายเป็น 960,000 ตัวเมื่อกระจายหลายไซต์ นี่ไม่ใช่แค่ตัวเลขสวยหรู แต่คือการยกเพดาน GPU infrastructure scaling สำหรับองค์กรที่ต้องการสร้างโรงงาน AI ของตนเอง
การตัดสินใจลงทุนในคลัสเตอร์ระดับนี้หมายความว่าองค์กรที่ยังคิดแบบศูนย์ข้อมูลยุคเดิมจะเสียเปรียบทันที เพราะเกมใหม่ไม่ได้แข่งกันที่จำนวนเซิร์ฟเวอร์ แต่แข่งกันที่จำนวน GPU ที่ใช้งานได้จริงต่อเมกะวัตต์และต่อชั่วโมงการทำงาน
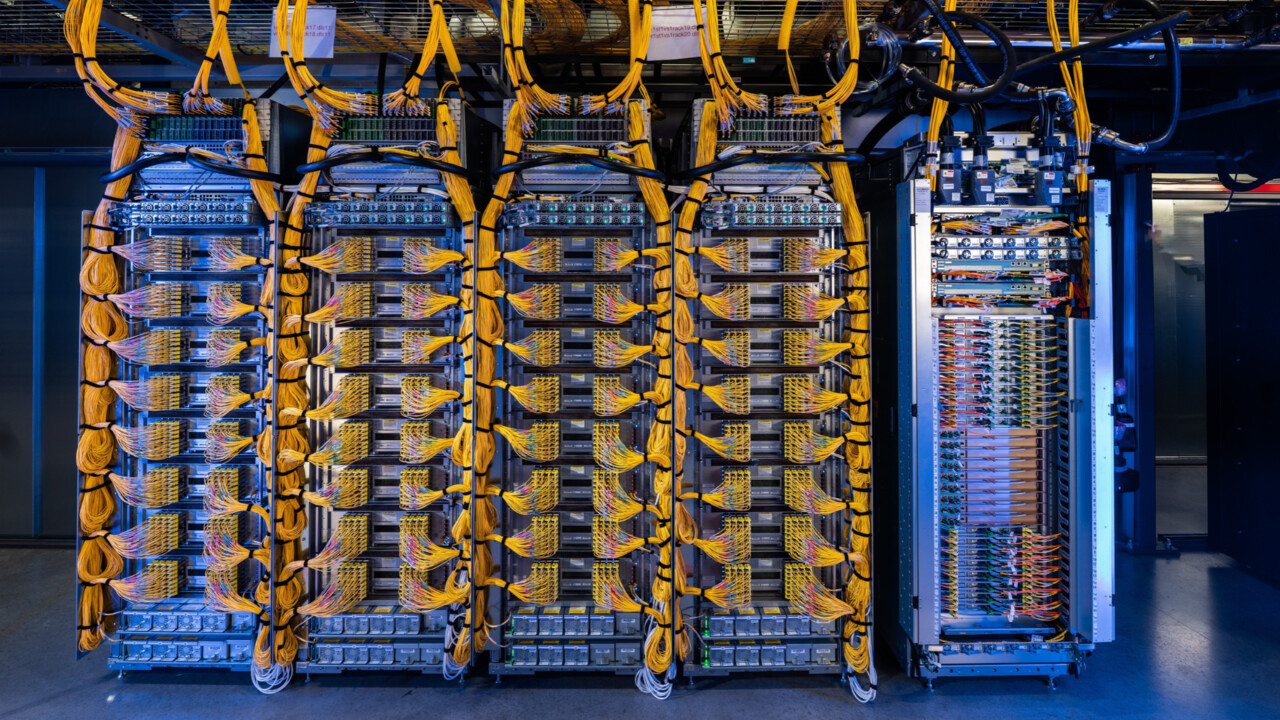
NVIDIA Vera Rubin A5X: เครื่องยนต์หลักของ enterprise GPU clusters
อินสแตนซ์ NVIDIA Vera Rubin A5X คือคำตอบเชิงวิศวกรรมสำหรับคำถามว่าเราจะรวมพลังประมวลผลระดับโรงงาน AI ไว้ในแพลตฟอร์มเดียวได้อย่างไร A5X สร้างบนแพลตฟอร์ม Rubin ที่รวม Rubin GPU 72 ตัว Vera CPU 36 ตัว NVLink 6 ชุด ConnectX-9 SuperNICs และ BlueField-4 DPU ไว้ในระบบระดับแร็กเดียว แล้วผสานเข้ากับ Virgo Network และระบบระบายความร้อนด้วยของเหลวขั้นสูงของ Google Cloud
อินสแตนซ์ A5X ชุดแรกเริ่มทำงานกับลูกค้ารายแรกแล้ว และมีแผนเปิดให้บริการทั่วไปในเดือนพฤศจิกายน พร้อมขยายไปยังภูมิภาคยุโรป ข้อมูลจาก NVIDIA ระบุว่าอินสแตนซ์เหล่านี้สามารถลดต้นทุนการอนุมานต่อโทเค็นได้สูงสุด 10 เท่า และเพิ่มปริมาณโทเค็นต่อเมกะวัตต์ได้สูงสุด 10 เท่าเมื่อเทียบกับรุ่นก่อนหน้า นี่คือประโยคที่ควรติดบอร์ดในทุกทีมไอทีองค์กร เพราะมันบอกชัดว่าการย้ายเวิร์กโหลดไปอยู่บน Vera Rubin ไม่ใช่แค่เรื่องแรง แต่คือเรื่องต้นทุนต่อหน่วยงาน AI
เมื่อรวม A5X เข้ากับ Google Kubernetes Engine และเครื่องมืออย่าง Managed DRANET และ Kueue การจัดสรร RDMA และการวางตารางงานแบบ location-aware ทำให้ enterprise GPU clusters กลายเป็นทรัพยากรที่บริหารได้เหมือนคลัสเตอร์ Kubernetes ปกติ แต่มีสเกลระดับหลายแสน GPU องค์กรที่ยังใช้ GPU แบบกระจัดกระจายจะเสียโอกาสในการรวมศูนย์การจัดการและการเพิ่มประสิทธิภาพอย่างเห็นได้ชัด
Minerva และ AI factory monitoring: ไม่ใช่แค่แรง แต่ต้องเสถียร
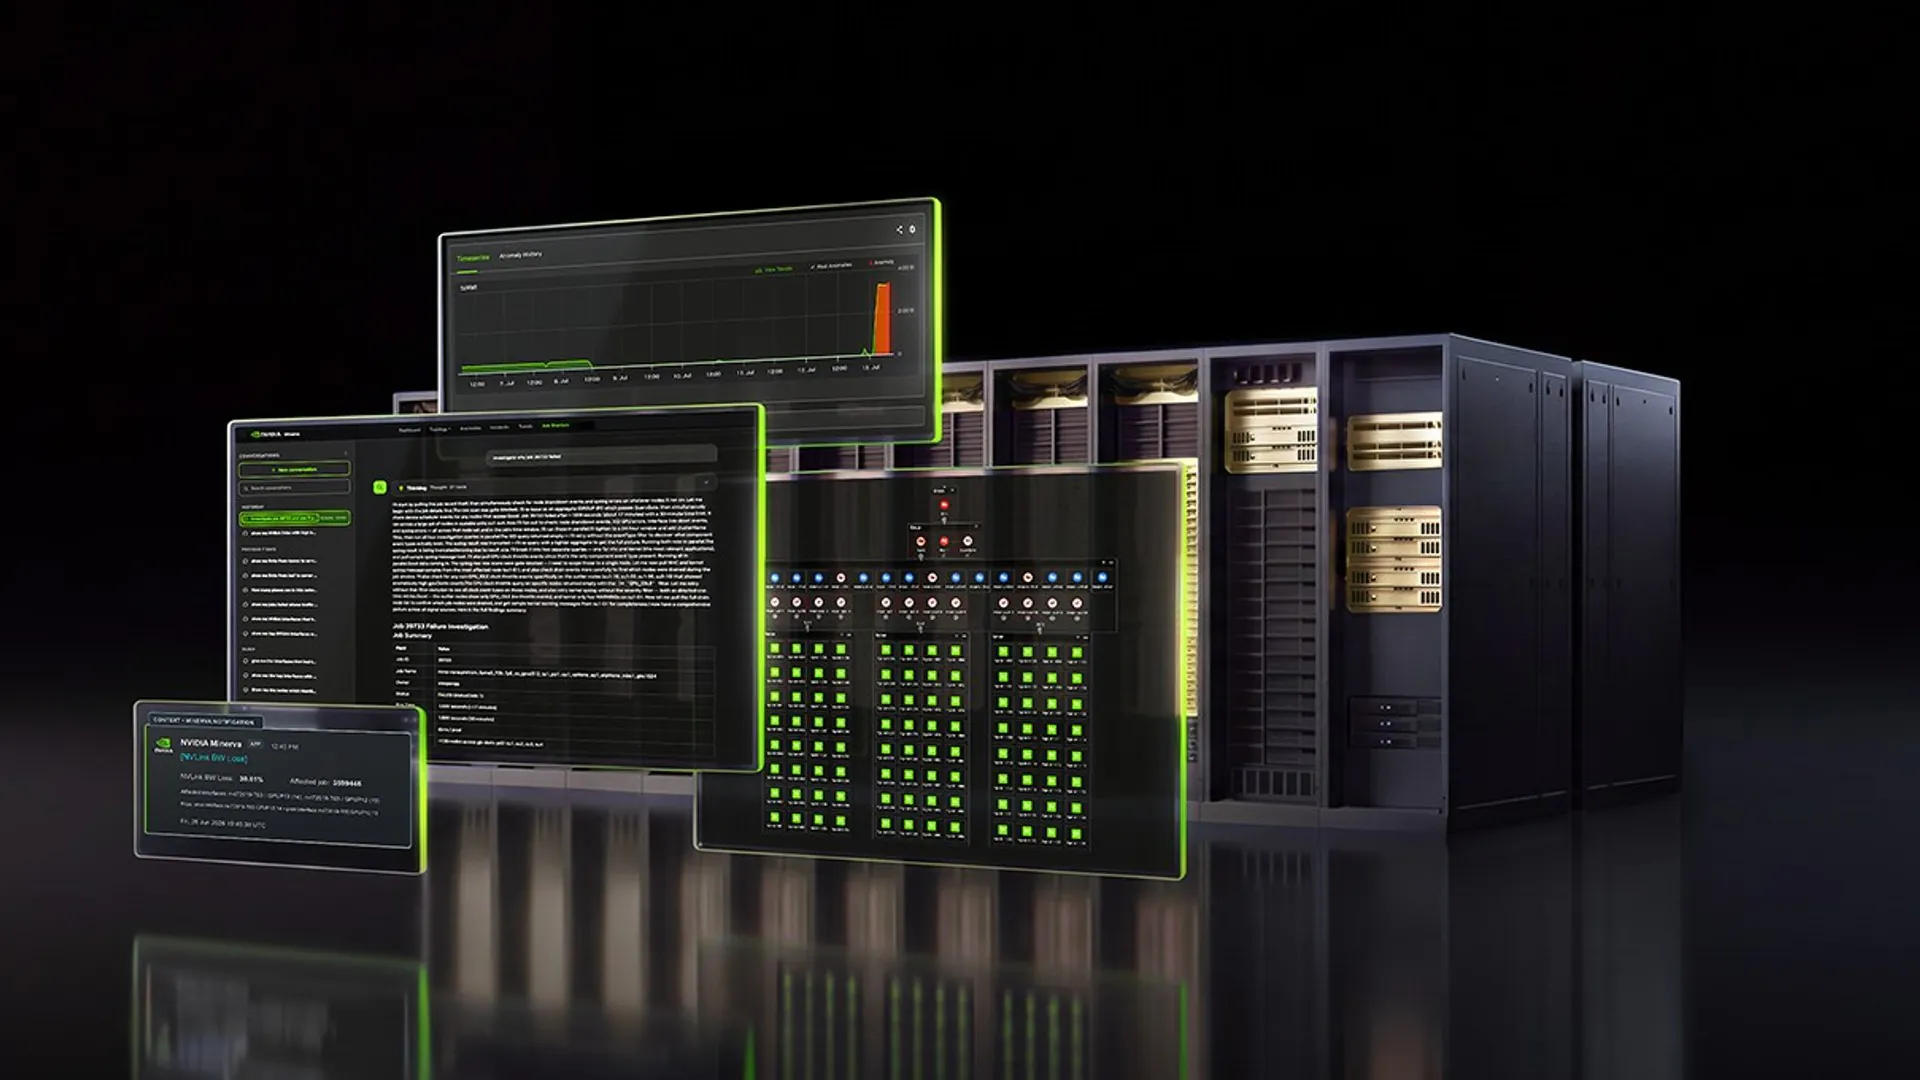
เมื่อโครงสร้างพื้นฐาน AI ขยายไปถึงระดับหลายแสน GPU ปัญหาที่แท้จริงไม่ใช่แค่การเพิ่มเครื่อง แต่คือการดูแลโรงงาน AI ให้เดินเครื่องต่อเนื่อง NVIDIA ตอบโจทย์นี้ด้วย Minerva แพลตฟอร์ม AIOps ที่เปิดตัวเมื่อวันที่ 22 ตุลาคม โดยออกแบบมาเพื่อให้ทีมปฏิบัติการได้รับแจ้งเตือนปัญหาโครงสร้างพื้นฐานล่วงหน้าในโรงงาน AI
Minerva รวบรวมเทเลเมทรีจาก GPU เครือข่าย ระบบจัดเก็บข้อมูล ตัวจัดตารางงาน และเวิร์กโหลด แล้วสร้างกราฟความรู้แบบไดนามิกที่เชื่อมโยง GPU SuperNIC สวิตช์ สายเคเบิล และงานที่รันอยู่เข้าด้วยกัน แพลตฟอร์มนี้วิเคราะห์จุดข้อมูลหลายพันล้านจุดต่อชั่วโมงด้วยแมชชีนเลิร์นนิงทั้งแบบมีผู้สอนและไม่มีผู้สอน เพื่อเรียนรู้พฤติกรรมปกติ แจ้งเตือนความผิดปกติใหม่ คาดการณ์ความขัดข้อง และรวมเหตุการณ์จำนวนมากให้เหลือเหตุขัดข้องเดียวที่มีสาเหตุชัดเจน
จุดที่น่าสนใจคือ Minerva ไม่ได้ถูกจำกัดอยู่ในศูนย์ข้อมูลของผู้ให้บริการรายใหญ่เท่านั้น แต่ยังถูกนำไปใช้โดยผู้เล่นอย่าง IREN Aolani Bitdeer AI IBM Jio Lambda Quake AI และ Tesla ขณะที่ Dell Lenovo และ Supermicro เตรียมนำเสนอ Minerva เป็นส่วนหนึ่งของโซลูชัน AI factory ของตน สำหรับองค์กร นี่คือสัญญาณชัดว่าการลงทุนใน GPU infrastructure scaling ต้องมาพร้อมกลยุทธ์ AI factory monitoring ตั้งแต่วันแรก ไม่เช่นนั้นสเกลที่เพิ่มขึ้นจะกลายเป็นความเสี่ยงมากกว่าความได้เปรียบ
ศูนย์ข้อมูลแบบโมดูลาร์และพันธมิตรระบบนิเวศ: ทางลัดจากปีเป็นสัปดาห์
การมี GPU จำนวนมากไม่พอถ้าไม่มีศูนย์ข้อมูลที่พร้อมรองรับ พันธมิตรในระบบนิเวศของ NVIDIA กำลังพยายามแก้ปัญหานี้ด้วยสถาปัตยกรรมศูนย์ข้อมูลแบบโมดูลาร์และแพลตฟอร์มข้อมูลที่ออกแบบมาสำหรับ AI โดยเฉพาะ ตัวอย่างคือการที่บริษัทโครงสร้างพื้นฐาน AI แบบโมดูลาร์นำแพลตฟอร์ม Sentinel ซึ่งเป็นศูนย์ข้อมูล AI แบบครบชุดในตู้ ISO High Cube ขนาด 45 ฟุต ที่อ้างอิงคอนฟิก 96 GPU ต่อหนึ่งยูนิต และขยายสเกลด้วย HyperPod สำหรับดีพลอยเมนต์ระดับหลายเมกะวัตต์
แนวคิดคือโรงงานสร้าง Sentinel จากโรงงานแล้วนำไปติดตั้งใกล้แหล่งพลังงาน ลดเวลาจากการรอสร้างศูนย์ข้อมูลแบบเดิมที่อาจกินเวลาหลายปีเหลือเพียงไม่กี่สัปดาห์ เมื่อผสานแพลตฟอร์มข้อมูลอย่าง Vast AI OS เข้าไป Sentinel แต่ละยูนิตจะขยายสถาปัตยกรรมข้อมูลเดียวกัน ทำให้การดีพลอยครั้งที่สิบสเกลได้สะอาดไม่ต่างจากครั้งแรก นี่คือรูปแบบ AI data center deployment ที่ตอบโจทย์องค์กรที่ต้องการความรวดเร็วและการควบคุมข้อมูลของตนเอง
ในฝั่งผู้ผลิตฮาร์ดแวร์ Dell และพันธมิตรอื่นกำลังผูกโซลูชันของตนเข้ากับแพลตฟอร์มอย่าง Minerva และโครงสร้างพื้นฐานของ NVIDIA เพื่อย่นระยะเวลาจากการออกแบบไปสู่การใช้งานจริง สำหรับองค์กร นี่คือสัญญาณว่าการสร้างศูนย์ข้อมูล AI ไม่จำเป็นต้องเป็นโปรเจกต์หลายปีอีกต่อไป แต่กลายเป็นการเลือกโมดูลที่เหมาะสมแล้วเชื่อมเข้ากับคลัสเตอร์ Vera Rubin และแพลตฟอร์ม AIOps ที่พร้อมใช้งาน
บทสรุป: จากโครงสร้างพื้นฐานสู่กลยุทธ์ AI ระดับองค์กร
เมื่อมองภาพรวม การสเกลโครงสร้างพื้นฐาน AI ไปถึง 960,000 GPU ไม่ได้เป็นเพียงการอัปเกรดฮาร์ดแวร์ แต่คือการเปลี่ยนวิธีคิดเกี่ยวกับศูนย์ข้อมูลทั้งระบบ ตั้งแต่เครื่องยนต์หลักอย่าง NVIDIA Vera Rubin A5X ที่ลดต้นทุนการอนุมานต่อโทเค็นได้สูงสุด 10 เท่า ไปจนถึงแพลตฟอร์ม AIOps อย่าง Minerva ที่ทำให้โรงงาน AI หลายแสน GPU ยังตรวจสอบและแก้ปัญหาได้ทันเวลา
องค์กรที่ต้องการใช้ AI อย่างจริงจังจึงต้องตอบคำถามสามข้อให้ชัด หนึ่ง จะวางแผน GPU infrastructure scaling อย่างไรให้รองรับเวิร์กโหลดในอีกหลายปี สอง จะใช้ AI data center deployment แบบใด ระหว่างศูนย์ข้อมูลแบบดั้งเดิมกับสถาปัตยกรรมโมดูลาร์ที่ดีพลอยได้ภายในไม่กี่สัปดาห์ และสาม จะออกแบบ AI factory monitoring อย่างไรให้ทีมปฏิบัติการมองเห็นปัญหาก่อนเกิดเหตุ ไม่ใช่หลังงานล่มไปแล้ว
คำตอบของสามข้อดังกล่าวจะเป็นตัวแบ่งองค์กรที่ใช้ AI เป็นเพียงโครงการทดลอง ออกจากองค์กรที่สร้างโรงงาน AI เป็นโครงสร้างพื้นฐานหลักของธุรกิจ ในโลกที่คลัสเตอร์ระดับ 960,000 GPU กำลังกลายเป็นมาตรฐานใหม่ การไม่มีกลยุทธ์โครงสร้างพื้นฐาน AI ที่ชัดเจนคือความเสี่ยงมากกว่าความประหยัด