
คำตอบสั้น ๆ: เลือกตามงาน ไม่ใช่คะแนนเดียว
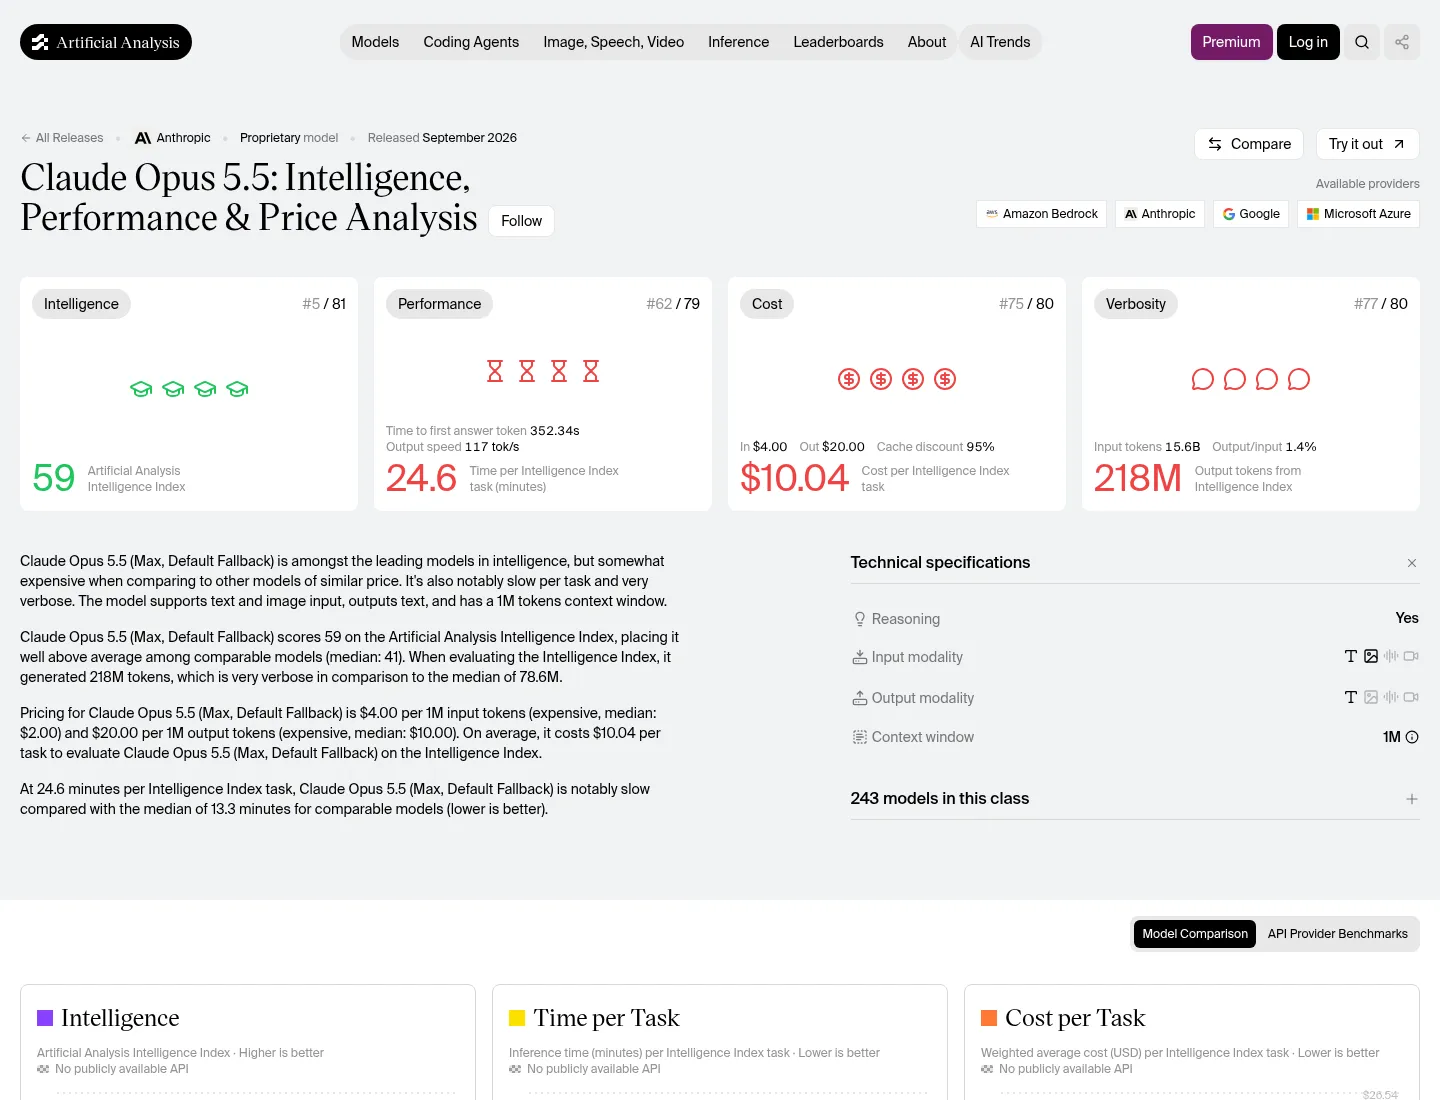
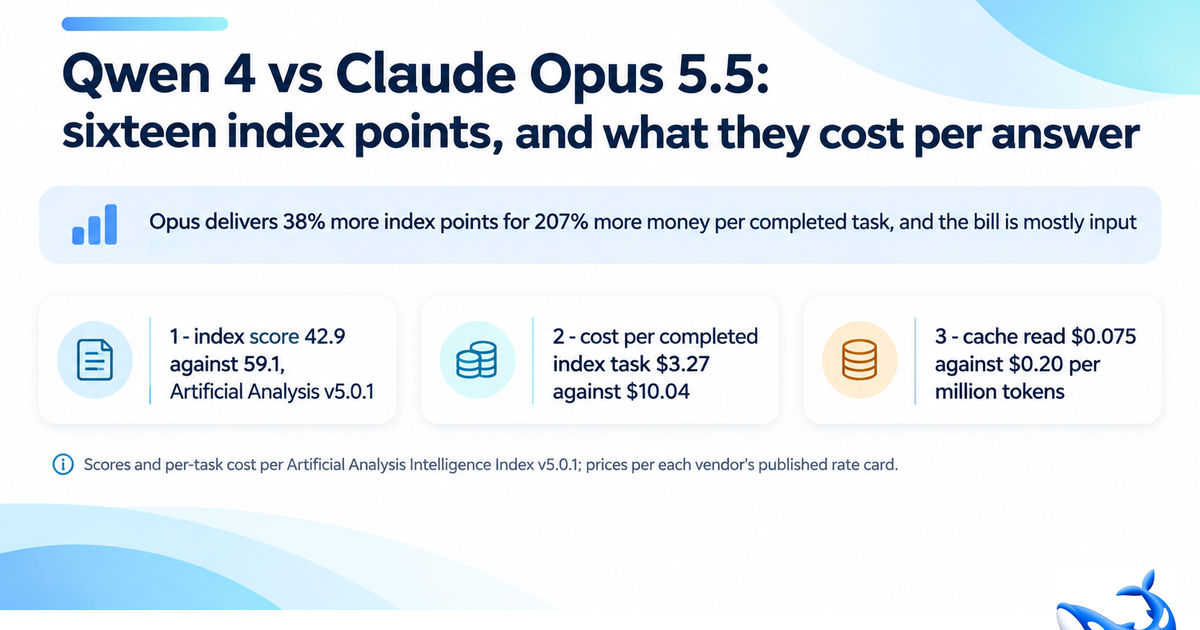
การเปรียบเทียบโมเดล AI คือการชั่งน้ำหนักความสามารถที่วัดจากงานทดสอบกับต้นทุนและเวลาที่ต้องใช้ เพื่อเลือกโมเดลให้เหมาะกับงานจริง ไม่ใช่ตัดสินจากคะแนนรวมเพียงตัวเดียว Qwen4-Max ได้ 42.9 คะแนน ส่วน Claude Opus 5.5 ได้ 59.1 คะแนน ห่างกัน 16.2 คะแนนบนดัชนีเดียวกัน แต่คะแนนที่สูงกว่ายังไม่ตอบว่าคุ้มกว่าหรือไม่ เพราะต้นทุนต่อภารกิจของ Claude สูงกว่ามาก และระดับความพยายามที่เลือกก็เปลี่ยนทั้งคะแนนกับเวลาได้ หากต้องการงานเขียนโค้ดแบบเอเจนต์หรือโจทย์เทคนิคซับซ้อน Claude มีเหตุผลรองรับการจ่ายเพิ่ม ส่วนงานทั่วไปที่ผลต่างระดับนี้ไม่สร้างมูลค่าเพิ่มชัดเจน Qwen เป็นตัวเลือกที่ประหยัดกว่า ทั้งสองเป็นโมเดลแบบปิด และ Qwen ไม่มีคะแนนแยกตามระดับความพยายามให้ใช้เทียบโดยตรง
| ประเด็น | Qwen4-Max | Claude Opus 5.5 |
|---|---|---|
| คะแนนดัชนีรวม | 42.9 ที่ระดับ xhigh | 59.1 ที่ระดับสูงสุด |
| ค่าใช้จ่ายต่อภารกิจดัชนี | 3.27 ดอลลาร์ | 10.04 ดอลลาร์ |
| ราคาต่อโทเค็นหนึ่งล้านหน่วย | รับเข้า 1.50 ดอลลาร์ และส่งออก 4.50 ดอลลาร์ในสิงคโปร์ | รับเข้า 4.00 ดอลลาร์ และส่งออก 20.00 ดอลลาร์ |
| ระดับความพยายามที่มีข้อมูล | Artificial Analysis วัดเพียงการกำหนดค่าเดียว ไม่มีคะแนนแยกตามระดับ | ห้าระดับ ตั้งแต่ต่ำถึงสูงสุด |
| คะแนนตั้งแต่ระดับต่ำถึงสูงสุด | ไม่มีข้อมูลแยก | 35 ถึง 59 คะแนน |
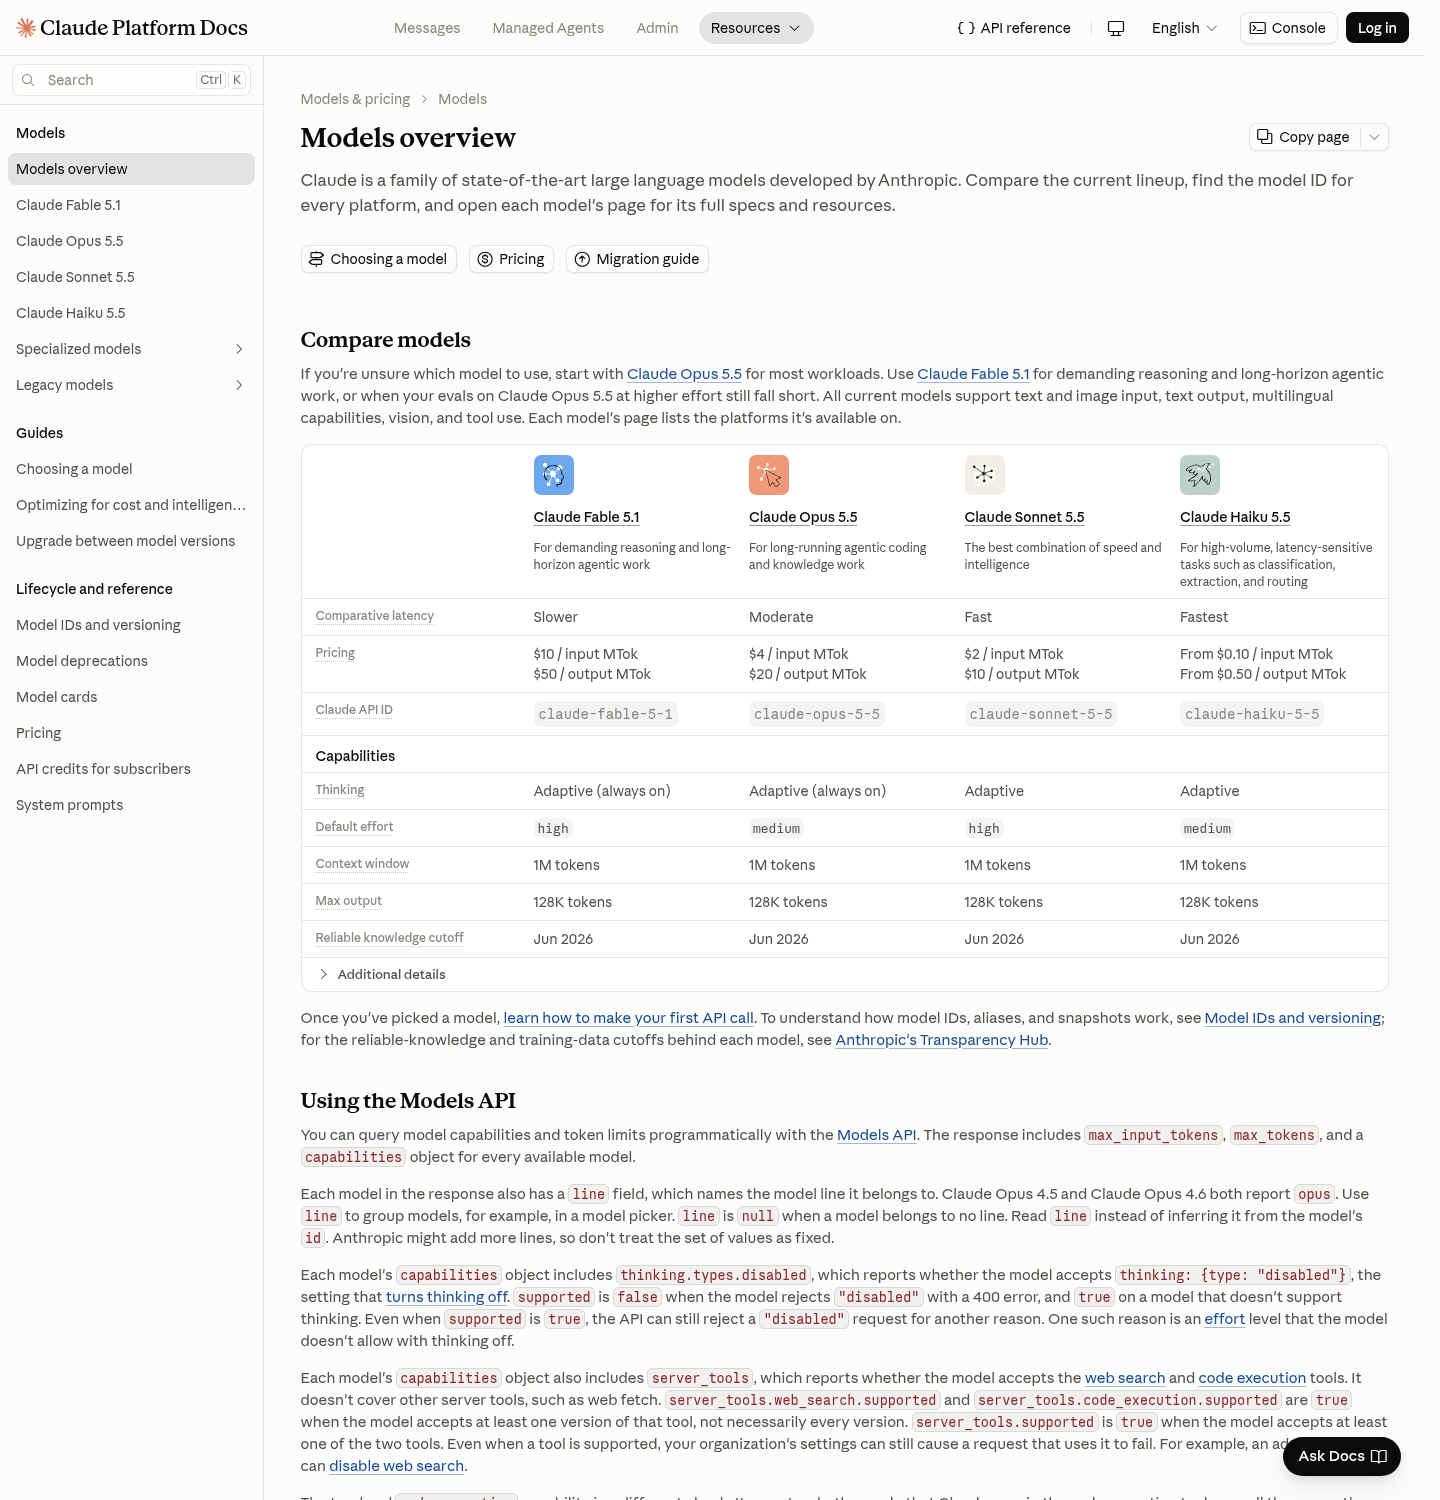
| ช่องบริบทตามข้อมูลที่เผยแพร่ | ระบุสูงสุด 1,000,000 โทเค็น; อินพุตในโหมดคิด 983,616 โทเค็น | 1,000,000 โทเค็น |
ตัวเลขในตารางเผยให้เห็นความต่างด้านค่าใช้จ่าย AI ชัดเจน: Claude ทำคะแนนดัชนีมากกว่า 38% แต่ต้นทุนต่อภารกิจสูงกว่า 207% อย่างไรก็ดี ตัวเลขราคาต่อโทเค็นข้างต้นเป็นราคาที่ระบุในสกุลเงินดอลลาร์ตามข้อมูลต้นทาง ไม่ใช่ต้นทุนที่ทุกคนจะเจอเหมือนกัน เพราะปริมาณอินพุตและเอาต์พุตของงานจริงเป็นตัวกำหนดบิล
ช่องว่าง 16 คะแนนมีความหมายไม่เท่ากันทุกงาน
Claude นำในงานที่ต้องลงมือทำกับระบบและโค้ด โดยได้ 59.6% ใน Terminal-Bench 4.0 เทียบกับ 48.5% ของ Qwen และได้ 46.4% ใน FrontierCode 2.0 เทียบกับ 26.5% ของ Qwen ผลต่างในงานโค้ดระดับรีพอซิทอรีจึงกว้างกว่าที่คะแนนรวมบอกมาก หากโมเดลต้องแก้โค้ดหลายไฟล์ เรียกใช้เครื่องมือ หรือทำงานต่อเนื่อง ความได้เปรียบของ Claude มีโอกาสแปลเป็นงานที่เสร็จสมบูรณ์มากขึ้น และอาจคุ้มกับต้นทุนที่สูงกว่า
แต่ไม่ควรนำช่องว่างนี้ไปเหมารวมกับทุกภารกิจ งานเอกสารและงานวิชาชีพที่วัดด้วย GDPval มีคะแนนใกล้กันกว่า โดย Claude ได้ 1,866.27 เทียบกับ 1,808.69 ของ Qwen ขณะที่ผลด้านวิทยาศาสตร์ยากและการให้เหตุผลฟิสิกส์เอนเอียงไปทาง Claude ชัดกว่า ดังนั้นผู้ซื้อควรทดสอบกับงานประจำของตนเอง หากเป็นการสรุปหรือสกัดข้อมูลที่มีคำตอบตรวจสอบได้ ความต่างของคะแนนดัชนีอาจไม่ทำให้ผลลัพธ์คุ้มกับค่าใช้จ่ายเพิ่ม แต่ถ้าเป็นงานเขียนโค้ดเอเจนต์ คะแนนรวมอาจประเมินช่องว่างต่ำกว่าความจริง
ระดับความพยายามของ Claude เปลี่ยนการตัดสินใจ
การเทียบคะแนนสูงสุดกับคะแนนเดียวของ Qwen ทำให้เห็นภาพไม่ครบ Claude Opus 5.5 ทำคะแนน 35 ที่ระดับต่ำ, 48 ที่ระดับปานกลาง, 52 ที่ระดับสูง, 57 ที่ระดับ xhigh และ 59 ที่ระดับสูงสุด ส่วน Qwen มีตัวเลขที่เผยแพร่เพียง 42.9 และไม่มีผลแยกตามระดับความพยายาม นั่นหมายความว่า Claude ระดับต่ำทำคะแนนต่ำกว่า Qwen อยู่ราวแปดคะแนน แต่ระดับปานกลางขยับขึ้นเหนือคะแนนของ Qwen แล้ว ผู้ใช้จึงมีทางเลือกปรับงบประมาณและความเร็ว แทนที่จะต้องเลือกระหว่างคะแนนสูงสุดกับไม่มีทางเลือก
การเพิ่มความพยายามก็มีต้นทุนด้านเวลา ระดับต่ำใช้เวลาประมาณ 3 นาทีต่องานดัชนี ส่วนระดับสูงสุดใช้ 24.6 นาที และเวลาไปถึงโทเค็นคำตอบแรกเพิ่มจาก 4.80 วินาทีเป็น 352.34 วินาทีตามการวัดที่เผยแพร่ สำหรับงานที่รอผลได้และมีความเสี่ยงจากคำตอบผิดสูง การตั้งระดับสูงอาจสมเหตุสมผลกว่าการใช้ระดับสูงสุดทุกครั้ง ส่วนงานที่ต้องตอบไว ระดับต่ำหรือปานกลางอาจเหมาะกว่า ทั้งนี้ไม่มีข้อมูลเวลาต่องาน อัตราเอาต์พุต หรือเวลาไปยังโทเค็นแรกของ Qwen ให้เทียบอย่างเท่าเทียม จึงไม่ควรสรุปว่า Qwen เร็วกว่าจากข้อมูลที่มี
ตัดสินความคุ้มจากภารกิจและเงื่อนไขใช้งาน
ถ้าระบบของคุณทำงานกับวิดีโอ Qwen มีความได้เปรียบด้านรูปแบบอินพุตตามข้อมูลที่ระบุ ขณะที่ Claude รองรับไฟล์ แต่ไม่มีการรองรับวิดีโอตามรายละเอียดในแหล่งข้อมูล อีกด้านหนึ่ง Claude เปิดให้ใช้ผ่านหลายช่องทาง เช่น API ของผู้พัฒนาและผู้ให้บริการคลาวด์หลายราย ส่วน Qwen ระบุผู้ให้บริการโฮสต์เป็น Alibaba Cloud เพียงรายเดียว ทั้งคู่ไม่เปิดเผยค่าน้ำหนักโมเดล จึงไม่ใช่ตัวเลือกแบบเปิดที่นำไปติดตั้งน้ำหนักเองได้
ข้อสรุปที่ใช้งานได้คืออย่าซื้อคะแนนเพิ่ม หากงานจริงไม่ได้ใช้ความสามารถนั้น เริ่มจากทดสอบคำสั่งและข้อมูลชุดเดียวกันกับทั้งสองโมเดล แล้วนับต้นทุนต่อภารกิจที่เสร็จตามเกณฑ์ ไม่ใช่ดูราคาต่อโทเค็นหรือคะแนนรวมอย่างโดดเดี่ยว หาก Claude ลดการแก้ซ้ำในงานโค้ดที่ซับซ้อนได้มาก ต้นทุนที่เพิ่มอาจมีเหตุผล แต่สำหรับงานที่ Qwen ทำได้ครบและตรวจสอบง่าย การจ่ายเพิ่มเพื่อคะแนนบนดัชนีไม่ใช่ข้อได้เปรียบที่จำเป็น
Buy if / Skip if
- Buy the Claude Opus 5.5 if งานหลักคือการเขียนโค้ดแบบเอเจนต์หรือโจทย์เทคนิคซับซ้อน และคะแนนที่นำในชุดทดสอบเหล่านั้นมีผลต่อคุณภาพงาน
- Skip the Claude Opus 5.5 if งานส่วนใหญ่เป็นการสรุปหรือสกัดข้อมูลที่ Qwen ทำได้เพียงพอ และการจ่ายเพิ่มไม่ลดเวลาหรือข้อผิดพลาด
- Buy the Qwen4-Max if ต้องการควบคุมค่าใช้จ่ายและงานจริงไม่จำเป็นต้องใช้ความสามารถที่ Claude แสดงความได้เปรียบ
- Skip the Qwen4-Max if ต้องการเทียบคะแนนตามระดับความพยายาม หรือภารกิจสำคัญพึ่งพาความสามารถด้านโค้ดที่ช่องว่างระหว่างโมเดลกว้าง