
AI agent testing คืออะไร และทำไมแนวคิดเก่าใช้ต่อไม่ได้
AI agent testing คือแนวทางการทดสอบระบบตัวแทนอัจฉริยะที่เน้นเส้นทางการทำงาน การตัดสินใจ และขอบเขตของเครื่องมือ มากกว่าการจับผิดประโยคผลลัพธ์ เพื่อให้ระบบที่มีโมเดลเชิงความน่าจะเป็นทำงานได้สอดคล้องกับสัญญาระบบที่กำหนด เช่น สคีมา ขั้นตอน และข้อกำกับความปลอดภัย โดยยอมรับว่าคำตอบอาจเปลี่ยนไปแต่พฤติกรรมต้องอยู่ในกรอบที่ตรวจสอบได้และทำซ้ำได้
ปัญหาหลักของนักพัฒนาคือเทสเคสเดิมผ่านแล้วอยู่ดีๆ ก็ล้มเพราะโมเดลเปลี่ยนคำตอบจาก I'll help you book that flight เป็น Happy to assist with your travel plans ทั้งที่มีความหมายช่วยจองเที่ยวบินเท่ากัน การบังคับให้ตอบประโยคเดิมจึงทำให้เทสเปราะและทำลายความเป็นธรรมชาติของเอเจนต์ แม้จะลด temperature เหลือศูนย์ก็ไม่สามารถทำให้โมเดลรีโมตและเชนเครื่องมือกลายเป็นฟังก์ชันบริสุทธิ์ได้
ประเด็นที่นักพัฒนาต้องยอมรับคือ AI agent ไม่ใช่ pure function แต่ทุกอย่างรอบโมเดล เช่น สคีมา สถานะ การอนุญาตเครื่องมือ และกฎความปลอดภัย ควรเป็นดีเทอร์มินิสติกและทดสอบได้ชัด การยึดติดกับคำตอบสุดท้ายอย่างเดียวจึงเป็นกับดัก เราควรย้ายจุดทดสอบไปที่สัญญาระบบรอบโมเดลแทน เช่น สคีมา การเสนอเครื่องมือ การอนุญาต และผลลัพธ์เชิงเหตุการณ์ มากกว่าการตรวจเทียบสตริงคำตอบแบบตรงตัว
Decision logging system ทำให้คำถามว่า "ทำไมเอเจนต์ทำแบบนั้น" มีคำตอบ
เมื่อ AI agent ทำพฤติกรรมประหลาด เช่น ส่งแจ้งเตือนราคาห้องพักผิดหรือใช้ข้อมูลเก่า สิ่งที่ทีมถามเสมอคือ ทำไมเอเจนต์ถึงตัดสินใจแบบนั้น แต่ล็อกแบบเดิมมักบอกได้แค่ว่าเรียกฟังก์ชันไหนเสร็จหรือเกิด error ตรงไหน โดยไม่แสดงจุดตัดสินใจระหว่างทางที่สำคัญเลย
decision logging system แก้ช่องว่างนี้ด้วยการเก็บบันทึกการตัดสินใจที่มีผลกระทบ เช่น กฎนโยบายข้อไหนถูกทริกเกอร์ เครื่องมือใดถูกเสนอ เหตุใดรันไทม์จึงรีทรายหรือปฏิเสธ แหล่งข้อมูลไหนให้คะแนน และผลลัพธ์ในภายหลังคืออะไร แนวคิดสำคัญคือไม่บันทึกทุกพรอมป์ต์หรือเหตุผลภายในโมเดล แต่บันทึกเหตุผลที่ตรวจสอบได้จากแอป เช่น ใช้ข้อมูลจากแคชอายุเท่าไร และนโยบายความสดข้อมูลให้ผ่านได้อย่างไร
เพื่อปกป้องข้อมูล Decision log ที่ดีควรมีโครงสร้าง คิวรีได้ และมีขนาดเล็กพอจะส่งที่ขอบเขตการตัดสินใจสำคัญ โดยหลีกเลี่ยงการบันทึกพรอมป์ต์เต็ม คอมพลีชันเต็ม อีเมล โทเคนเข้าถึงรายละเอียดการชำระเงิน หรือประวัติแชตส่วนตัวเป็นค่าเริ่มต้น พร้อมกำหนดอายุการเก็บและการเข้าถึงที่จำกัด เมื่อทำเช่นนี้คำว่า โมเดลตัดสินใจผิด จะถูกแปลงเป็นข้อผิดพลาดระบบที่สร้างเทสได้ เช่น ใช้ข้อมูลหมดอายุตามนโยบายผิด
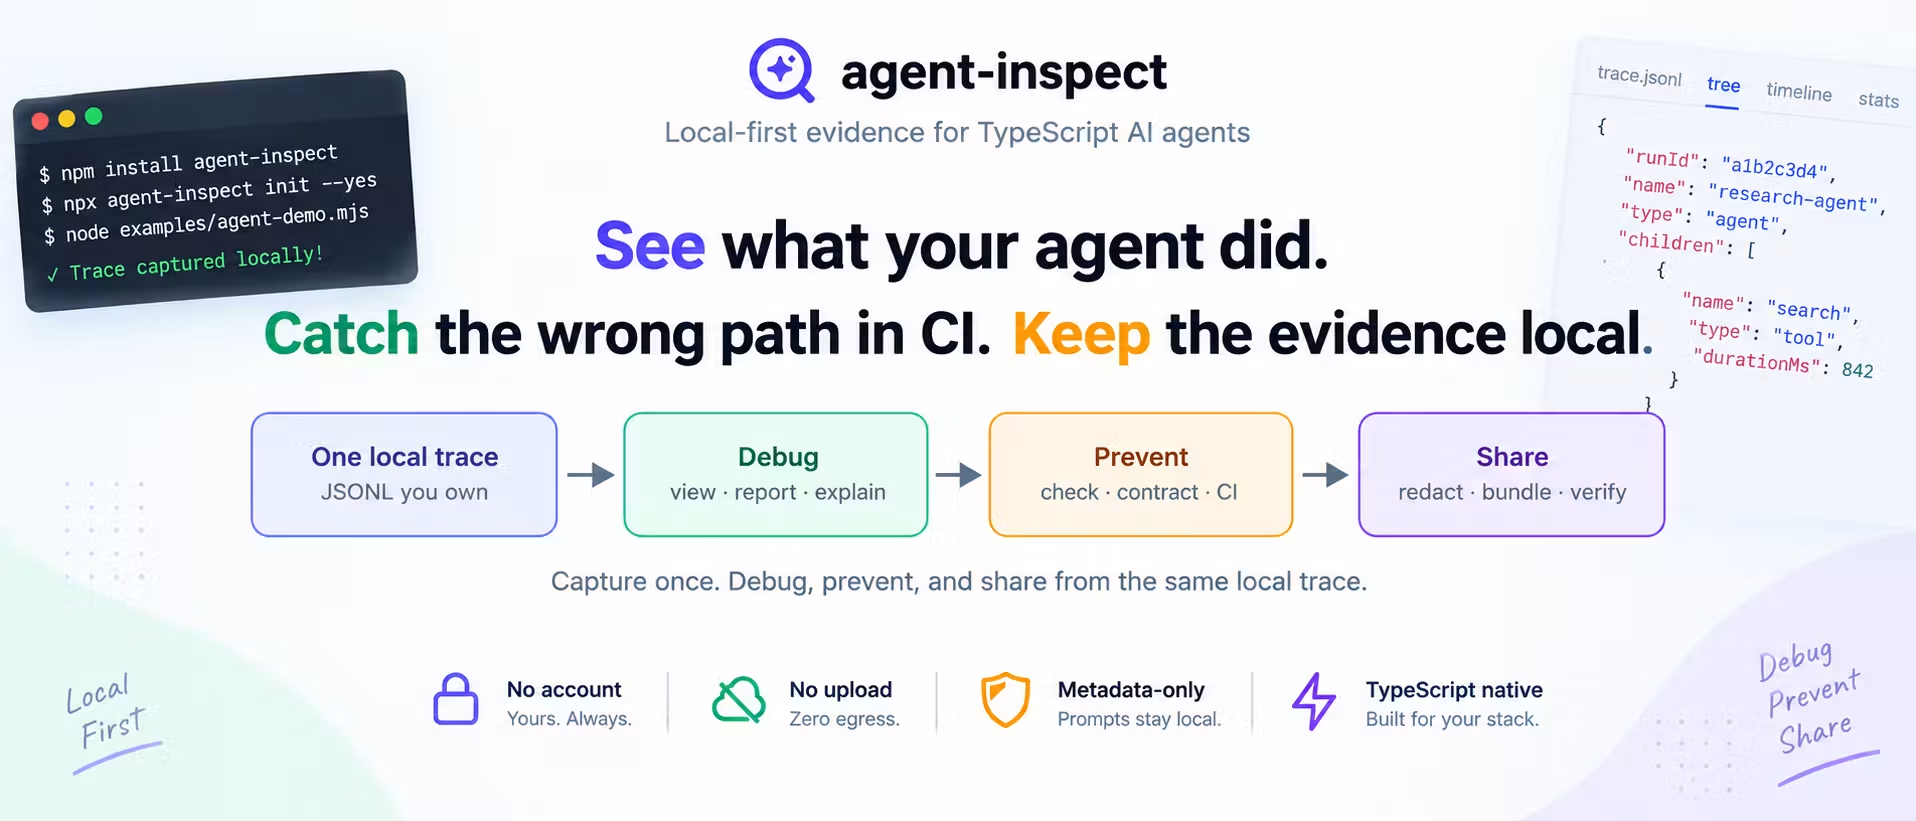
ทำให้การรันของเอเจนต์ทำซ้ำได้ และตรวจเส้นทางได้อย่างดีเทอร์มินิสติก
ในโลกของ AI agent ประโยคที่ว่า มันทำงานบนพรอมป์ต์ของฉัน กลายเป็นเวอร์ชันใหม่ของ มันทำงานบนเครื่องฉัน นักพัฒนารันเอเจนต์โลคัลแล้วเห็นคำตอบน่าเชื่อก็คิดว่าระบบใช้ได้ แต่พอขึ้นสภาพแวดล้อมอื่นหรืออัปเดตโมเดล เอเจนต์อาจตอบต่างกันทั้งที่ดูดีเหมือนเดิม
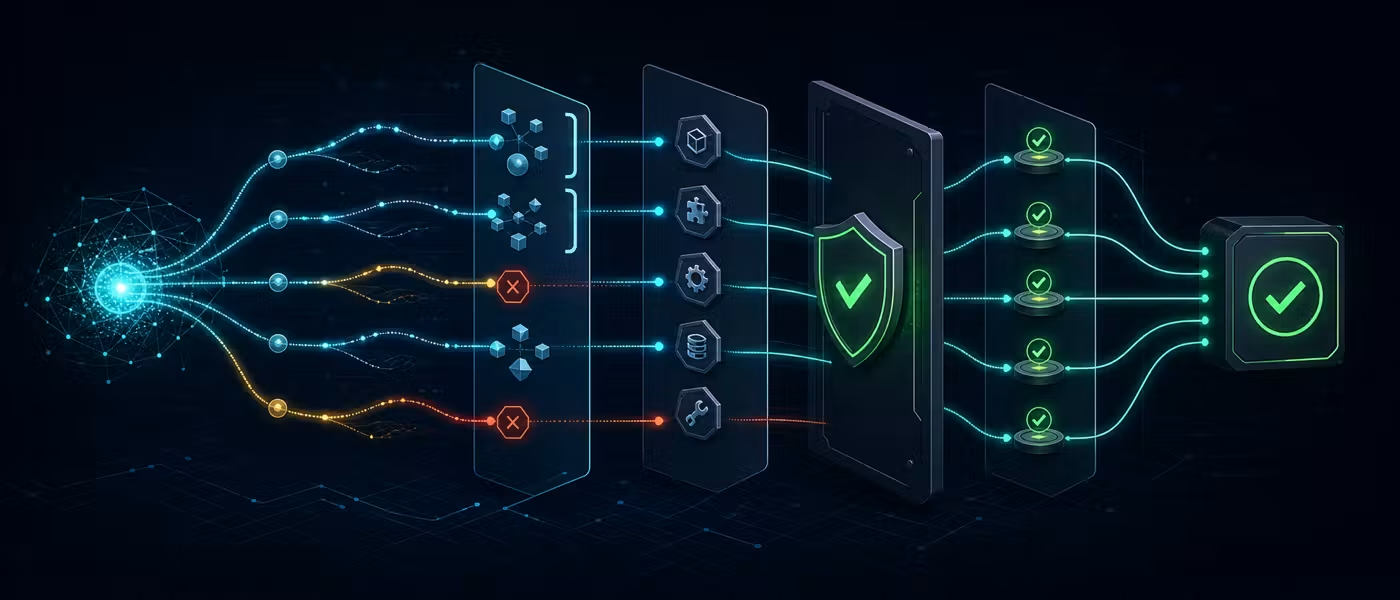
ทีมจึงต้องปฏิบัติต่อทุกการรันของเอเจนต์เหมือนอาร์ติแฟกต์ทางวิศวกรรมที่ทำซ้ำ ตรวจทบทวน และแลกเปลี่ยนได้ นั่นหมายถึงการเก็บ trace ที่แปลงเป็นอาร์ติแฟกต์ผ่านวงจร capture → normalize → inspect → check → redact → package → verify → attach กับงานรีวิว จุดประสงค์เพื่อให้ตอบคำถามที่ล็อกแบบเดิมตอบไม่ได้ชัดว่า เอเจนต์เดินเส้นทางไหนกันแน่
การตรวจควรถูกแยกเป็นเลนดีเทอร์มินิสติกและเลนเชิงความหมาย ในเลนดีเทอร์มินิสติกต้องตอบให้ได้แบบชัดเจนว่า retrieve_policy ถูกเรียกหรือไม่ มีการใช้เครื่องมือ search_docs ที่ห้ามหรือไม่ การสร้างคำตอบเกิดหลังการดึงนโยบายหรือเปล่า รันจบหรือไม่ ผลลัพธ์บันทึกไว้ล้มเหลวหรือสำเร็จ และเกินโควตาโทเคนหรือเวลาหรือไม่ เมื่อ trajectory facts เหล่านี้ถูกเก็บอย่างเป็นระบบ การรันใหม่เพื่อทวนข้อผิดพลาดหรือเปรียบเทียบเวอร์ชันจึงเป็นเรื่องตรงไปตรงมา
ทดสอบสัญญาระบบ ไม่ใช่คำตอบประโยคต่อประโยค
ตัวอย่างเทสที่เปราะที่สุดคือการคาดหวังให้เอเจนต์ตอบประโยคเดียวกันทุกครั้ง เช่น expect.toBe("I'll help you find hotels in Paris.") เมื่อเอเจนต์เปลี่ยนเป็น I can help you search for hotels in Paris เนื้อหายังมีประโยชน์เหมือนเดิมแต่เทสล้มทันที การบังคับให้เอเจนต์พูดซ้ำคำเดิมทำให้การพัฒนายากโดยไม่เก็บประโยชน์เพิ่ม
แนวทางที่ดีกว่าคือทดสอบสัญญารอบโมเดลที่เป็นดีเทอร์มินิสติก เช่น สคีมา ข้อเสนอเครื่องมือ เครื่องมือที่ถูก execute ผลการอนุญาต การเปลี่ยนสถานะ และผลลัพธ์ที่ต้องเกิดหรือห้ามเกิด ข้อความที่ต้องตรงเป๊ะควรถูกจำกัดไว้กับบริบทพิเศษ เช่น ข้อความยินยอมตามกฎระเบียบหรือป้ายข้อความใน UI ส่วนข้อความที่เอเจนต์สร้างทั่วไปควรประเมินด้วยรูบริกเชิงความหมายหรือ grader ที่มีขอบเขต มากกว่าจะบังคับประโยคเดียว
โครงสร้างผลลัพธ์ของการรันเอเจนต์ควรแยกสิ่งที่โมเดลเสนอออกจากสิ่งที่รันไทม์อนุญาตและดำเนินการ เช่น เก็บรายการ proposedTools แยกจาก executedToolNames พร้อมผล policyResults ที่ระบุเหตุผลอนุญาตหรือปฏิเสธ การแยกนี้ปิดช่องความคลุมเครือที่อันตราย เพราะข้อเสนอให้จองไม่ได้แปลว่าการจองเกิดขึ้นแล้ว และเปิดทางให้เทสเช็กทั้งเจตนาของโมเดลและพฤติกรรมของระบบรันไทม์ได้ชัด
สังเกตการณ์เอเจนต์ในโปรดักชัน เพื่อสร้าง autonomous system reliability
เมื่อ AI agent ถูกใช้ในโปรดักชัน คำถามเรื่องความน่าเชื่อถือของระบบอัตโนมัติหรือ autonomous system reliability จะสำคัญพอๆ กับคุณภาพคำตอบ ทีมไม่ควรสนใจแต่เฉพาะ correctness ของคำตอบ แต่ต้องสนใจ trajectory correctness และ evidence correctness ด้วย
การออกแบบ observability pattern ที่ดีเริ่มจากการผูก decision log ให้เป็นส่วนหนึ่งของ execution trace ด้วย trace ID ร่วมและความสัมพันธ์ของ span เพื่อให้เล่าเรื่องการรันได้ครบว่ามีการ plan → retrieve → rank → generate → validate → retry หรือ hand off อย่างไร เมื่อเก็บ structured decision events อย่างสม่ำเสมอ ทีมสามารถตั้งคำถามเฉพาะทาง เช่น กฎนโยบายข้อใดบล็อกการกระทำบ่อยที่สุด ดีเพนเดนซีใดสร้าง retry ซ้ำ เครื่องมือใดถูกเสนอแต่ไม่เคยถูกอนุญาต แหล่งคะแนนใดสัมพันธ์กับความสำเร็จภายหลัง และเวอร์ชันใดเริ่มทำให้พฤติกรรมเบี่ยงเบน
การที่ agent testing ส่วนใหญ่เดิมเน้นแค่ answer correctness แม้จะเป็นเรื่องเข้าใจได้ แต่สำหรับระบบโปรดักชัน trajectory correctness และ evidence correctness มีความสำคัญไม่แพ้กัน ที่สำคัญ แม้โมเดลและสภาพแวดล้อมจะเปลี่ยน สัญญาความปลอดภัยและพฤติกรรมของระบบไม่ควรเปลี่ยน การมี decision logging system การรันที่ทำซ้ำได้ และการสังเกตการณ์ที่เน้นเส้นทาง จึงเป็นเงื่อนไขสำคัญในการทำให้ autonomous system มีความน่าเชื่อถืออย่างยั่งยืน