
ฐานข้อมูลเวกเตอร์คืออะไร และทำไมถึงกลายเป็นสนามรบใหม่ของโลกองค์กร
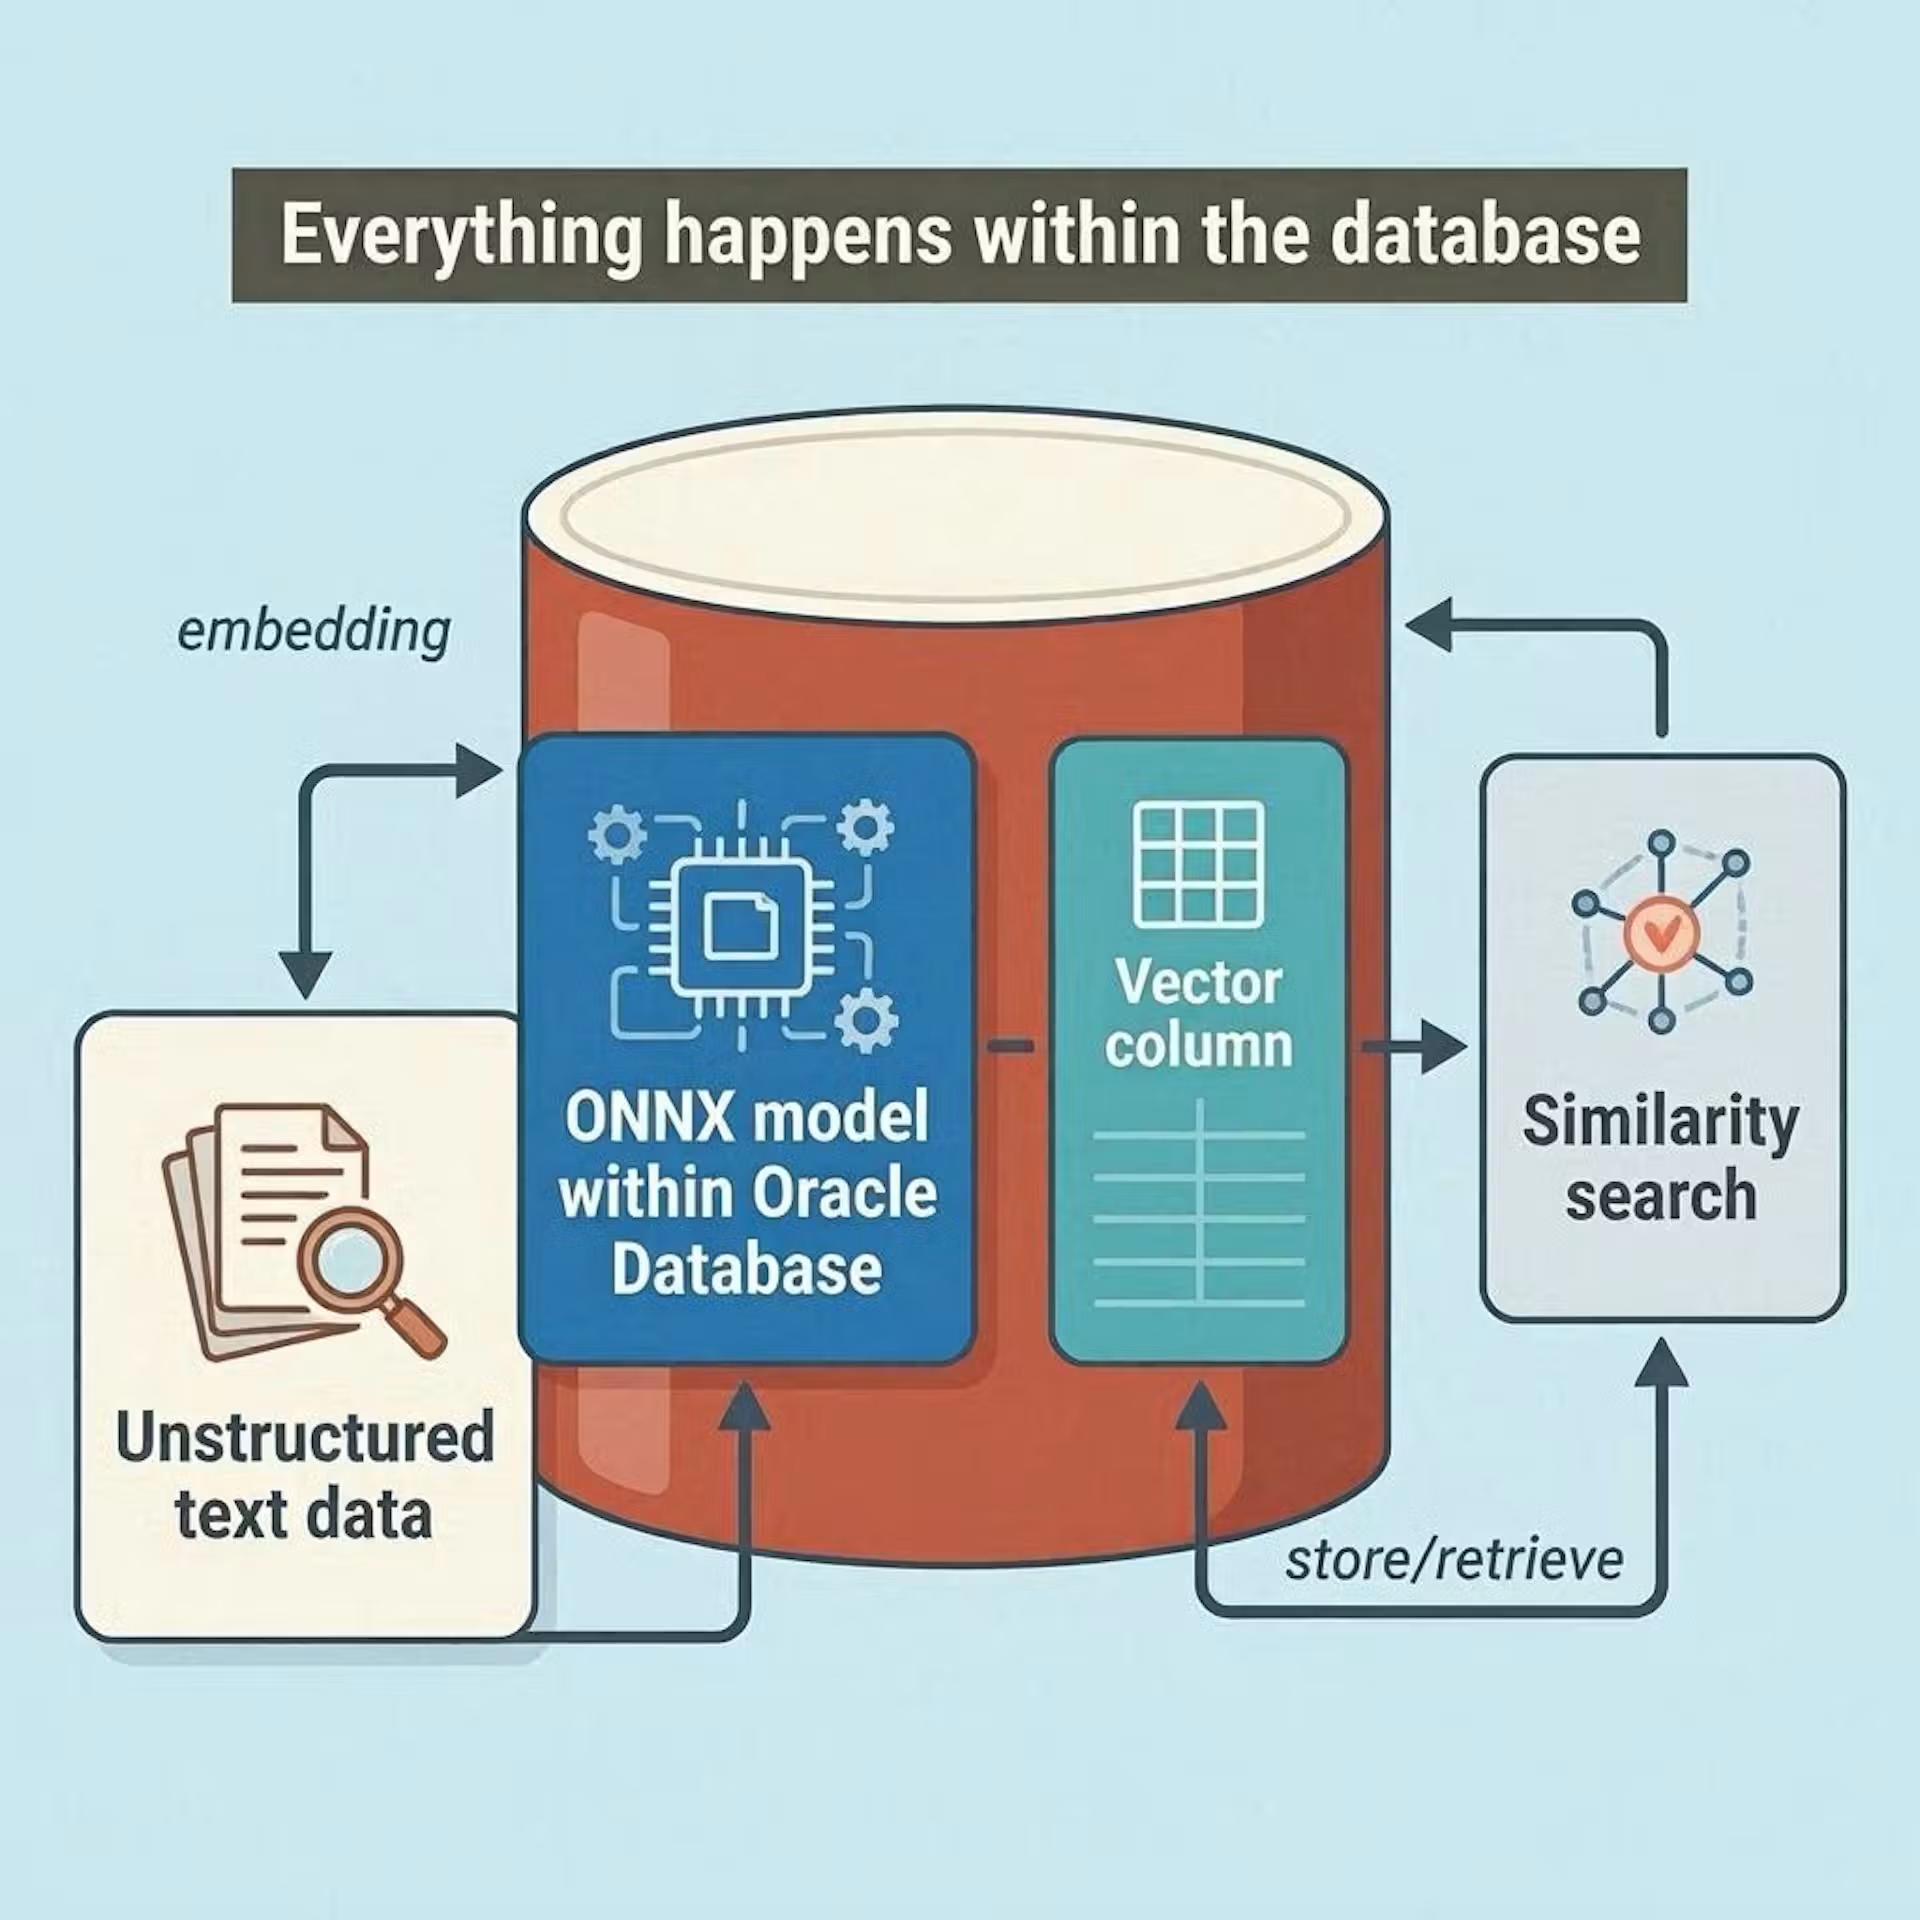
ฐานข้อมูลเวกเตอร์คือระบบจัดเก็บและค้นหาข้อมูลแบบเวกเตอร์ที่ใช้ตัวเลขหลายมิติแทนความหมายของข้อความ รูปภาพ หรือสัญญาณต่างๆ เพื่อให้แอปพลิเคชัน AI สามารถค้นหาความคล้ายคลึงเชิงความหมายได้อย่างรวดเร็วและแม่นยำ ต่างจากการค้นหาด้วยคีย์เวิร์ดหรือค่าที่ตรงกันเพียงอย่างเดียว จึงเป็นโครงสร้างพื้นฐานสำคัญสำหรับระบบที่ใช้โมเดลภาษาและตัวแทนอัจฉริยะขนาดใหญ่ในระดับองค์กร มุมมองที่ควรเข้าใจคือฐานข้อมูลเวกเตอร์ไม่ใช่เครื่องมือเสริมอีกตัว แต่กำลังกลายเป็นชั้นโครงสร้างพื้นฐาน AI infrastructure แบบใหม่ที่เชื่อมโมเดลกับข้อมูลธุรกิจโดยตรง Oracle MongoDB และ MariaDB เห็นภาพนี้ชัดและกำลังแข่งกันทำฐานข้อมูลของตนให้รองรับ vector search database แบบเนทีฟ เพื่อลดความซับซ้อนจากการต้องต่อหลายระบบเข้าด้วยกันในอดีต ที่เคยต้องมีฐานข้อมูลเชิงธุรกรรม ฐานข้อมูลเวกเตอร์ และระบบค้นหาข้อความแยกกัน
Oracle 23ai กับยุค converged database ที่เอาเวกเตอร์มาอยู่ใจกลาง SQL
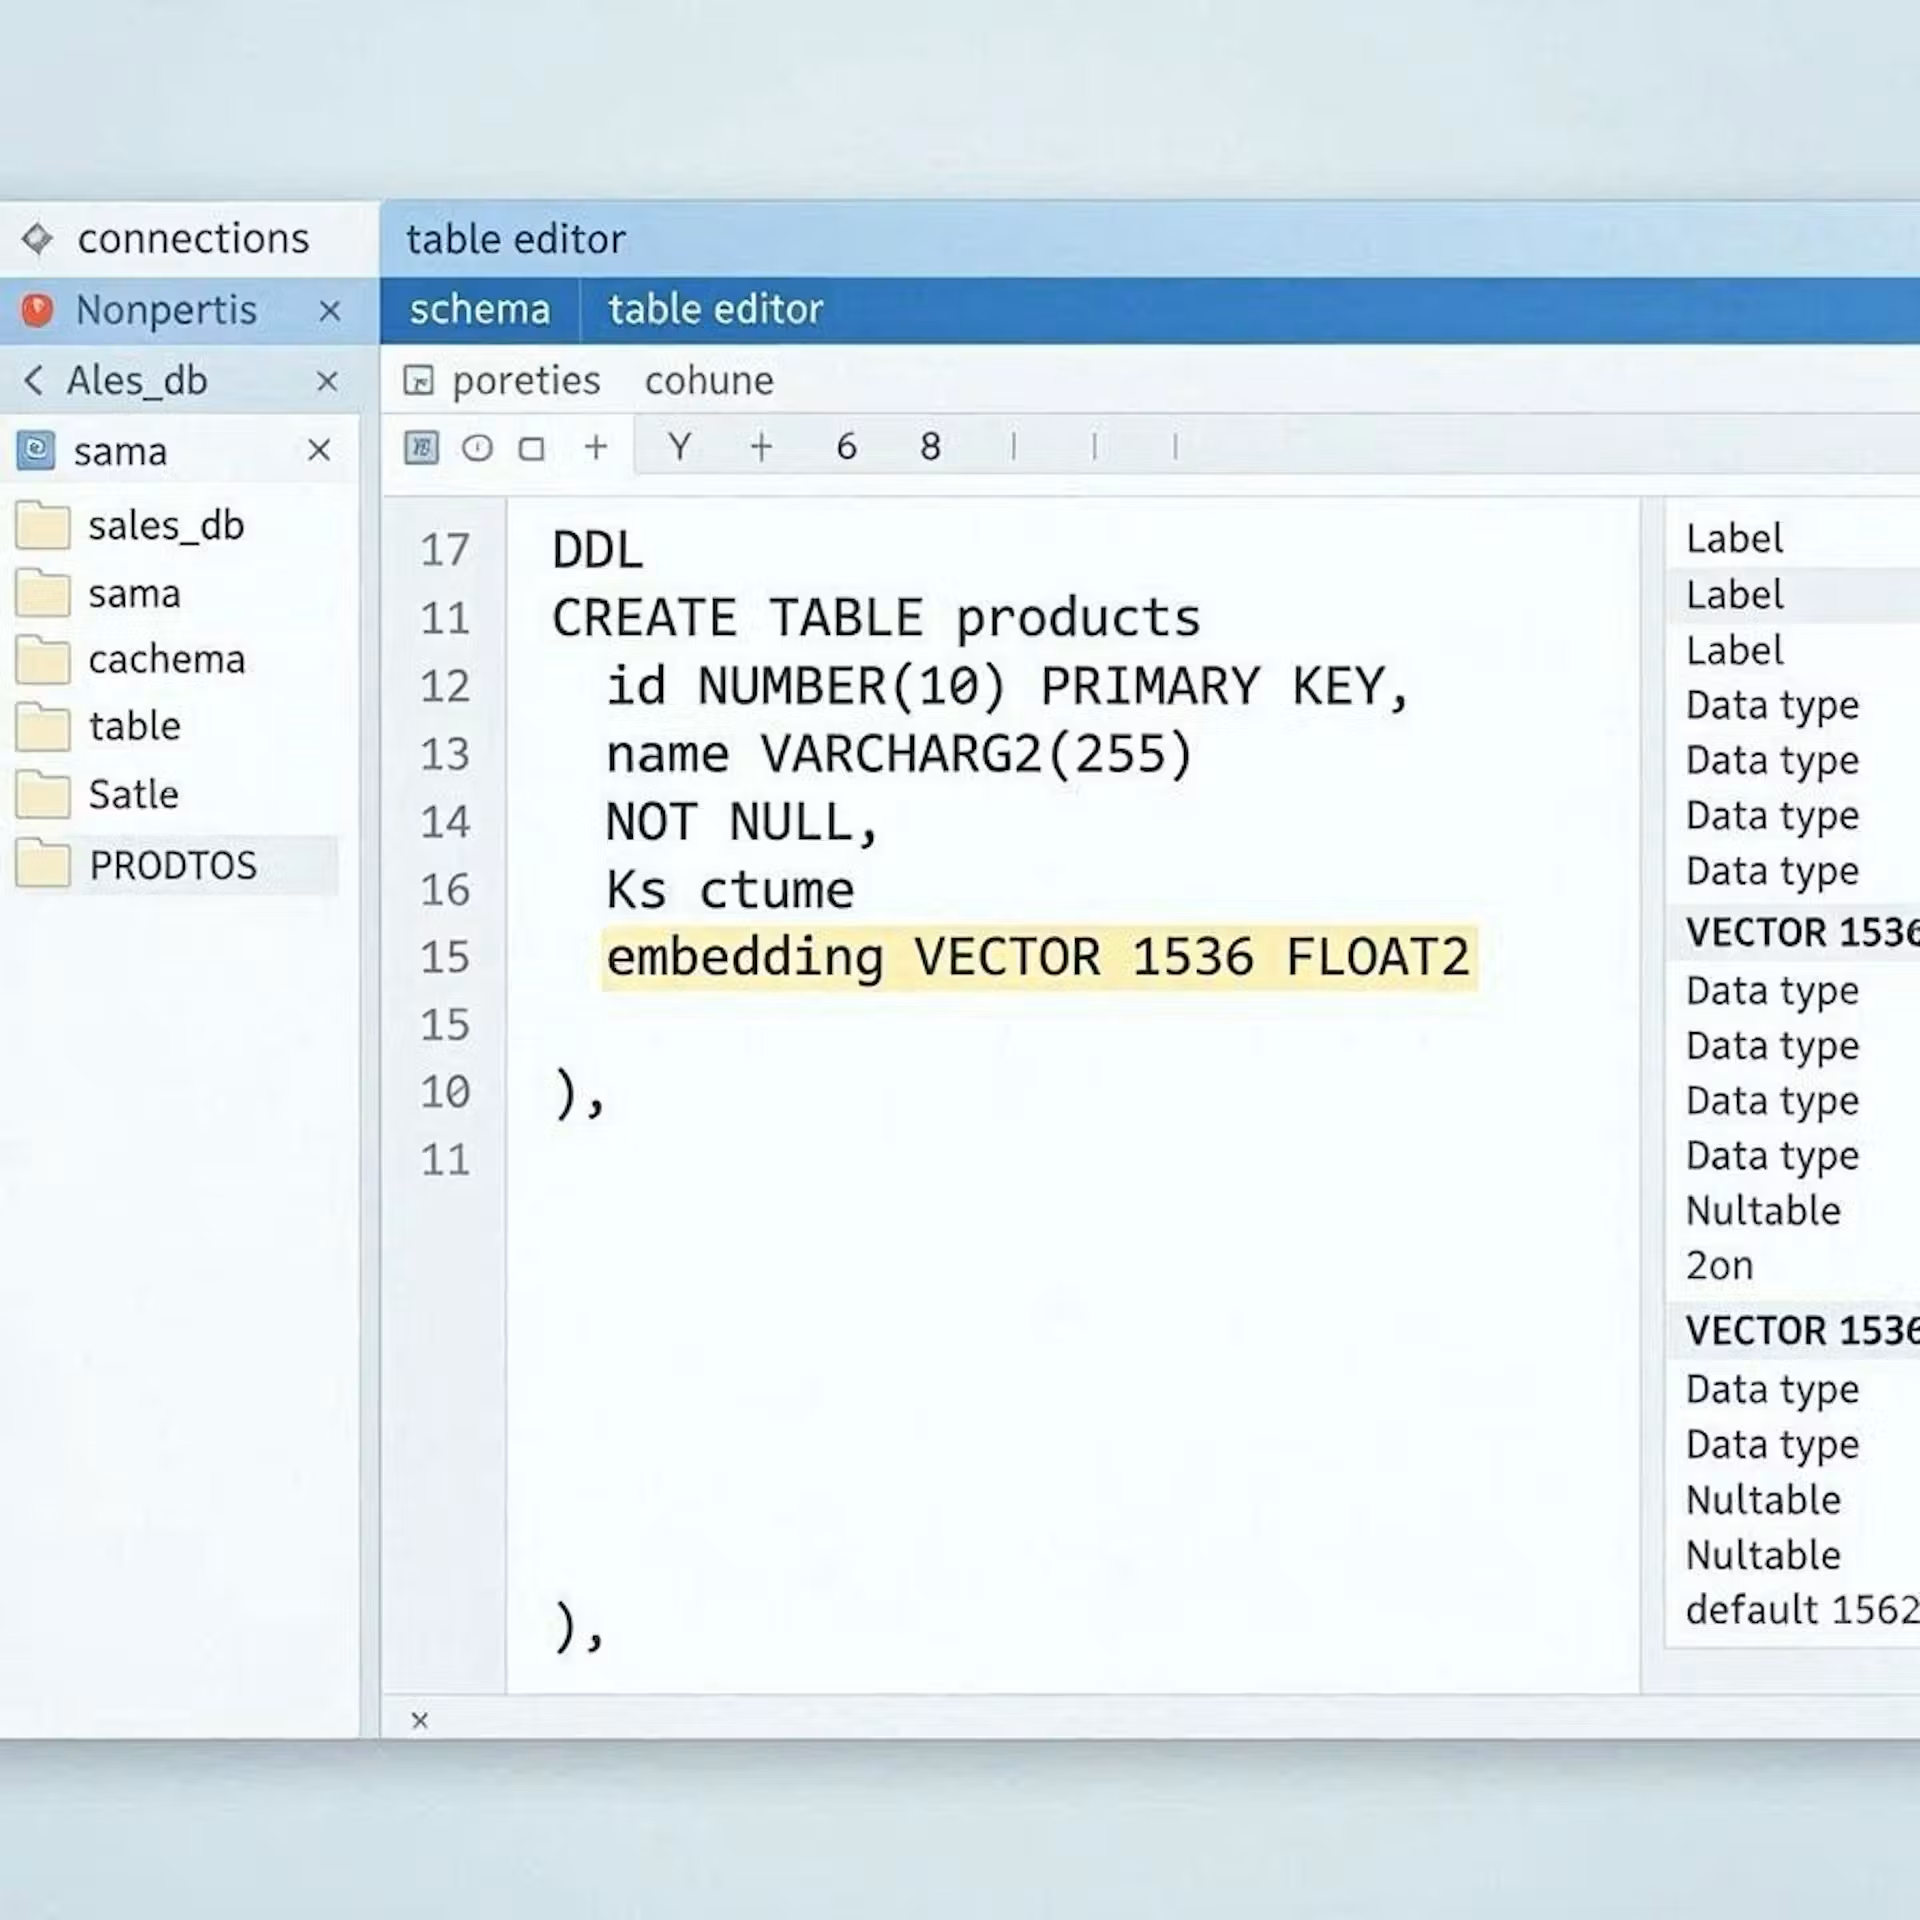
Oracle เลือกเดินเกมแบบชัดเจนด้วยแนวคิด converged database รวมธุรกรรม การวิเคราะห์ และ vector search ไว้ในระบบเดียวเพื่อตอบโจทย์ enterprise AI infrastructure โดยตรง จุดหักเหสำคัญคือ Oracle 23ai ที่ใส่ native vector types ลงในเอนจิน SQL ให้เวกเตอร์กลายเป็นคอลัมน์ชั้นหนึ่ง ไม่ต้องเก็บเป็น BLOB หรือ JSON ที่ยุ่งยากอีกต่อไป จุดแข็งเชิงเทคนิคคือการรองรับรูปแบบเวกเตอร์หลากหลายทั้ง INT8 FLOAT32 FLOAT64 และ BINARY พร้อมโหมด DENSE และ SPARSE ทำให้สามารถจูนระหว่างความแม่นยำกับพื้นที่จัดเก็บได้อย่างยืดหยุ่น ด้าน semantic search capabilities Oracle เพิ่มดัชนีเวกเตอร์สองแบบคือ HNSW แบบอยู่ในหน่วยความจำเต็ม และ IVF แบบเน้นสเกลบนดิสก์ ซึ่งเลือกใช้ตามขนาดข้อมูลและงบประมาณหน่วยความจำขององค์กร คำพูดที่สะท้อนทิศทางชัดคือแนวคิดว่า converged database จะทำให้คำสั่ง SQL เดียวเข้าถึงหลายชนิดข้อมูลพร้อมกันแต่ยังคงคุณสมบัติ ACID ครบถ้วน นี่คือการบอกกลายๆ ว่าฐานข้อมูลเวกเตอร์ควรเป็นส่วนหนึ่งของระบบธุรกรรม ไม่ใช่บริการเสริมที่ต้องผูกกับระบบภายนอก

MongoDB Atlas AI Engine ผลักฐานข้อมูลเอกสารให้กลายเป็นแพลตฟอร์ม AI-first
ฝั่งฐานข้อมูลเอกสาร MongoDB เลือกเน้นสเกลและการใช้งาน AI agent โดยตรง MongoDB Atlas ซึ่งเป็นบริการฐานข้อมูลแบบจัดการบนคลาวด์ถูกใช้โดยลูกค้ามากกว่า 70,000 รายสำหรับ Search Vector Search time series และ Stream Processing อยู่แล้ว ทำให้มีฐานข้อมูลที่เหมาะกับงาน AI อยู่ในมือ เวอร์ชัน 9.0 เพิ่มความเร็วแบบจับต้องได้ ทั้ง find-one ที่เร็วขึ้นถึง 35 เปอร์เซ็นต์ update-one เร็วขึ้น 30 เปอร์เซ็นต์ และ throughput บนอินสแตนซ์ใหญ่ที่เพิ่มขึ้นถึง 2 เท่า พร้อมผลทดสอบภายในที่ระบุว่า Atlas Infinite ให้ throughput ต่อค่าใช้จ่ายมากกว่า Atlas Core ถึง 189 เปอร์เซ็นต์ สำหรับ workload เชิง AI และธุรกรรมที่ต้องสเกลแรง นี่คือข้อเสนอที่น่าสนใจอย่างยิ่ง หัวใจด้าน AI agent deployment คือ Atlas AI Engine และ Atlas Agent Engine ที่ให้ทีมพัฒนานำเอเยนต์เข้า production ได้แบบเป็นโมดูล ใช้การค้นคืนข้อมูลโดย Voyage AI ที่ MongoDB ซื้อมาเพื่อ embeddings และ reranking จุดสำคัญคือสถาปัตยกรรมนี้เป็น model-agnostic รองรับมาตรฐานเปิดอย่าง MCP และ A2A ทำให้องค์กรไม่ต้องยอมติดล็อกผู้ให้บริการโมเดลรายเดียว แต่ยังคุมการกำกับดูแลและบันทึกการทำงานของเอเยนต์ผ่าน control plane กลางได้ด้วย
MariaDB เติมเวกเตอร์ลง SQL เพื่อปิดช่องว่างระหว่างฐานข้อมูลดั้งเดิมกับเครื่องมือ AI
ในโลกฐานข้อมูลเชิงสัมพันธ์ MariaDB เป็นตัวอย่างที่ชัดว่าฐานข้อมูลดั้งเดิมกำลังวิ่งไล่ให้ทันกระแส AI องค์กร MariaDB ได้สร้าง vector search database ในเซิร์ฟเวอร์ของตนเรียบร้อยแล้ว รองรับการค้นหาด้วยความคล้ายคลึงแทนการเปรียบเทียบค่าที่ต้องตรงกันเป๊ะ ซึ่งเป็นเงื่อนไขพื้นฐานในหลายแอปพลิเคชัน AI แนวคิดของ MariaDB คือช่วยให้ผู้พัฒนาไม่ต้องแยกฐานข้อมูลธุรกรรมออกจากระบบเวกเตอร์อีกต่อไป สามารถใช้ SQL เดิมแต่เพิ่มคำสั่งและโครงสร้างข้อมูลที่รองรับ embeddings ได้ ทำให้โลกฐานข้อมูลแบบเปิดและติดตั้งบนลินุกซ์ที่คุ้นเคยอยู่แล้วก้าวเข้ามาอยู่ในแผนโครงสร้างพื้นฐาน AI ได้ง่ายขึ้น ปัญหากลับไม่ใช่ด้านเทคนิค แต่เป็นด้านการรับรู้ ผู้บริหารมูลนิธิ MariaDB ระบุชัดว่ากำลังหงุดหงิดกับการที่โลกไม่รู้ว่า MariaDB มีเวกเตอร์ จนถึงขั้นกล่าวว่า หากถามโมเดลภาษาแบบสุมเดาว่าจะใช้ฐานข้อมูลไหนสำหรับเวกเตอร์ชื่อ MariaDB แทบไม่ถูกเสนอเลยเพราะข้อมูลฝึกยังไม่อัปเดต ท่าทีนี้สะท้อนว่าศึกฐานข้อมูลเวกเตอร์ในยุค LLM ไม่ได้ชนะกันที่ฟีเจอร์อย่างเดียว แต่ชนะกันที่ว่าจะปรากฏอยู่ในคำแนะนำของเครื่องมือโค้ดและเอเยนต์หรือไม่
ทำไมฐานข้อมูล converged พร้อมเวกเตอร์จึงเป็นทางรอดขององค์กรในยุค LLM
เมื่อดูภาพรวม Oracle MongoDB และ MariaDB ต่างเห็นตรงกันว่าการมีเวกเตอร์อยู่ในฐานข้อมูลหลักคือกุญแจไปสู่ enterprise AI infrastructure ที่ใช้งานได้จริงในองค์กร ไม่ใช่แค่การทดลองในแซนด์บ็อกซ์ เพราะในโลกก่อนหน้านี้ ทีมฐานข้อมูลต้องดูแลหลายระบบแยกกัน ตั้งแต่ฐานข้อมูลเชิงธุรกรรม ฐานข้อมูลเวกเตอร์ ระบบค้นหาข้อความ และอาจมีฐานข้อมูลกราฟอีกหนึ่งตัว ทำให้การสำรองข้อมูล ความปลอดภัย และความสอดคล้องระหว่างระบบกลายเป็นฝันร้ายเชิงปฏิบัติการ แนวทาง converged database และแพลตฟอร์ม AI-first อย่าง Atlas Infinite ที่ผูกการคิดเงินตามการใช้ compute และ storage แทนการกันทรัพยากรไว้ล่วงหน้า ช่วยให้องค์กรควบคุมต้นทุนได้แม่นและยืดหยุ่นกับ workload ของ AI agent ที่ผันผวน ขณะเดียวกัน MariaDB ก็ชี้ให้เห็นว่า หากฐานข้อมูลดั้งเดิมไม่ประกาศความสามารถเวกเตอร์ให้เข้าไปอยู่ในเฟรมเวิร์กและข้อมูลฝึกของ LLM ฐานข้อมูลเหล่านั้นจะถูกมองข้ามโดยอัตโนมัติ ข้อสรุปเชิงยุทธศาสตร์คือ สำหรับองค์กรที่กำลังสร้างระบบ LLM และ AI agent ขนาดใหญ่ การเลือกแพลตฟอร์มฐานข้อมูลไม่ควรมองแค่ว่ารองรับธุรกรรมได้ดี แต่ต้องถามเพิ่มว่าระบบนั้นมี native vector types vector search database และ semantic search capabilities ในตัวหรือไม่ รองรับ AI agent deployment และการกำกับดูแลในระดับองค์กรหรือเปล่า การตอบคำถามเหล่านี้จะเป็นตัวแยกว่าระบบ AI ของคุณเป็นเพียงเดโมหรือเป็นโครงสร้างพื้นฐานที่รองรับธุรกิจได้จริงในระยะยาว