
Qwen3.8-27B คืออะไร และทำไมจึงเป็นหมุดหมายของโมเดล AI แบบเปิด
Qwen3.8-27B คือโมเดล LLM แบบเปิดขนาด 27 พารามิเตอร์พันล้านที่ออกแบบมาให้รันบนฮาร์ดแวร์ท้องถิ่นได้เต็มรูปแบบ โดยยังให้ประสิทธิภาพใกล้เคียงโมเดลระดับแนวหน้าระบบปิด และถูกปล่อยภายใต้ไลเซนส์ที่อนุญาตให้นักพัฒนาดาวน์โหลด ตรวจสอบ ปรับแต่ง และใช้งานได้อิสระ โดยไม่ต้องพึ่งพา API หรือเซิร์ฟเวอร์ของผู้ให้บริการอีกต่อไป.
อาลีบาบาเลือกเดินเกมตรงข้ามโมเดลระบบปิดด้วยการปล่อย Qwen3.8-27B เป็นโมเดล AI แบบเปิดเต็มตัว น้ำหนักโมเดลถูกวางไว้บนแพลตฟอร์มโอเพ่นซอร์สให้นำไปใช้ได้ทันที และที่สำคัญ โมเดลนี้ถูกออกแบบมาให้รันบนโน้ตบุ๊คหรือเครื่องเดสก์ท็อปของผู้ใช้เอง โดยไม่ต้องต่ออินเทอร์เน็ตเลยเมื่อดาวน์โหลดไฟล์เสร็จ. นี่คือข้อความชัดเจนว่า “ยุคที่ต้องเช่า AI จากคลาวด์เพื่อให้ได้สมองระดับท็อปกำลังจะจบลง”
ปรากฏการณ์ Qwen ยังสะท้อนภาพใหญ่ของระบบนิเวศโมเดล AI แบบเปิดที่เติบโตอย่างรวดเร็ว รายงานหนึ่งชี้ว่า ยอดดาวน์โหลดมหาศาลทำให้ Qwen กลายเป็นหนึ่งในรากฐานที่ใหญ่ที่สุดของระบบนิเวศ AI แบบเปิด. นั่นหมายความว่าโลกนักพัฒนาไม่ได้หมุนรอบแค่โมเดลจากบริษัทยักษ์ฝั่งเดียวอีกต่อไป แต่กำลังเปิดพื้นที่ให้โค้ดโอเพ่นซอร์สที่ทุกคนเป็นเจ้าของร่วมกัน

เล็กแต่แรง: Qwen3.8-27B ไล่ทัน Claude Opus 4.6 ในเวลาเพียงครึ่งปี
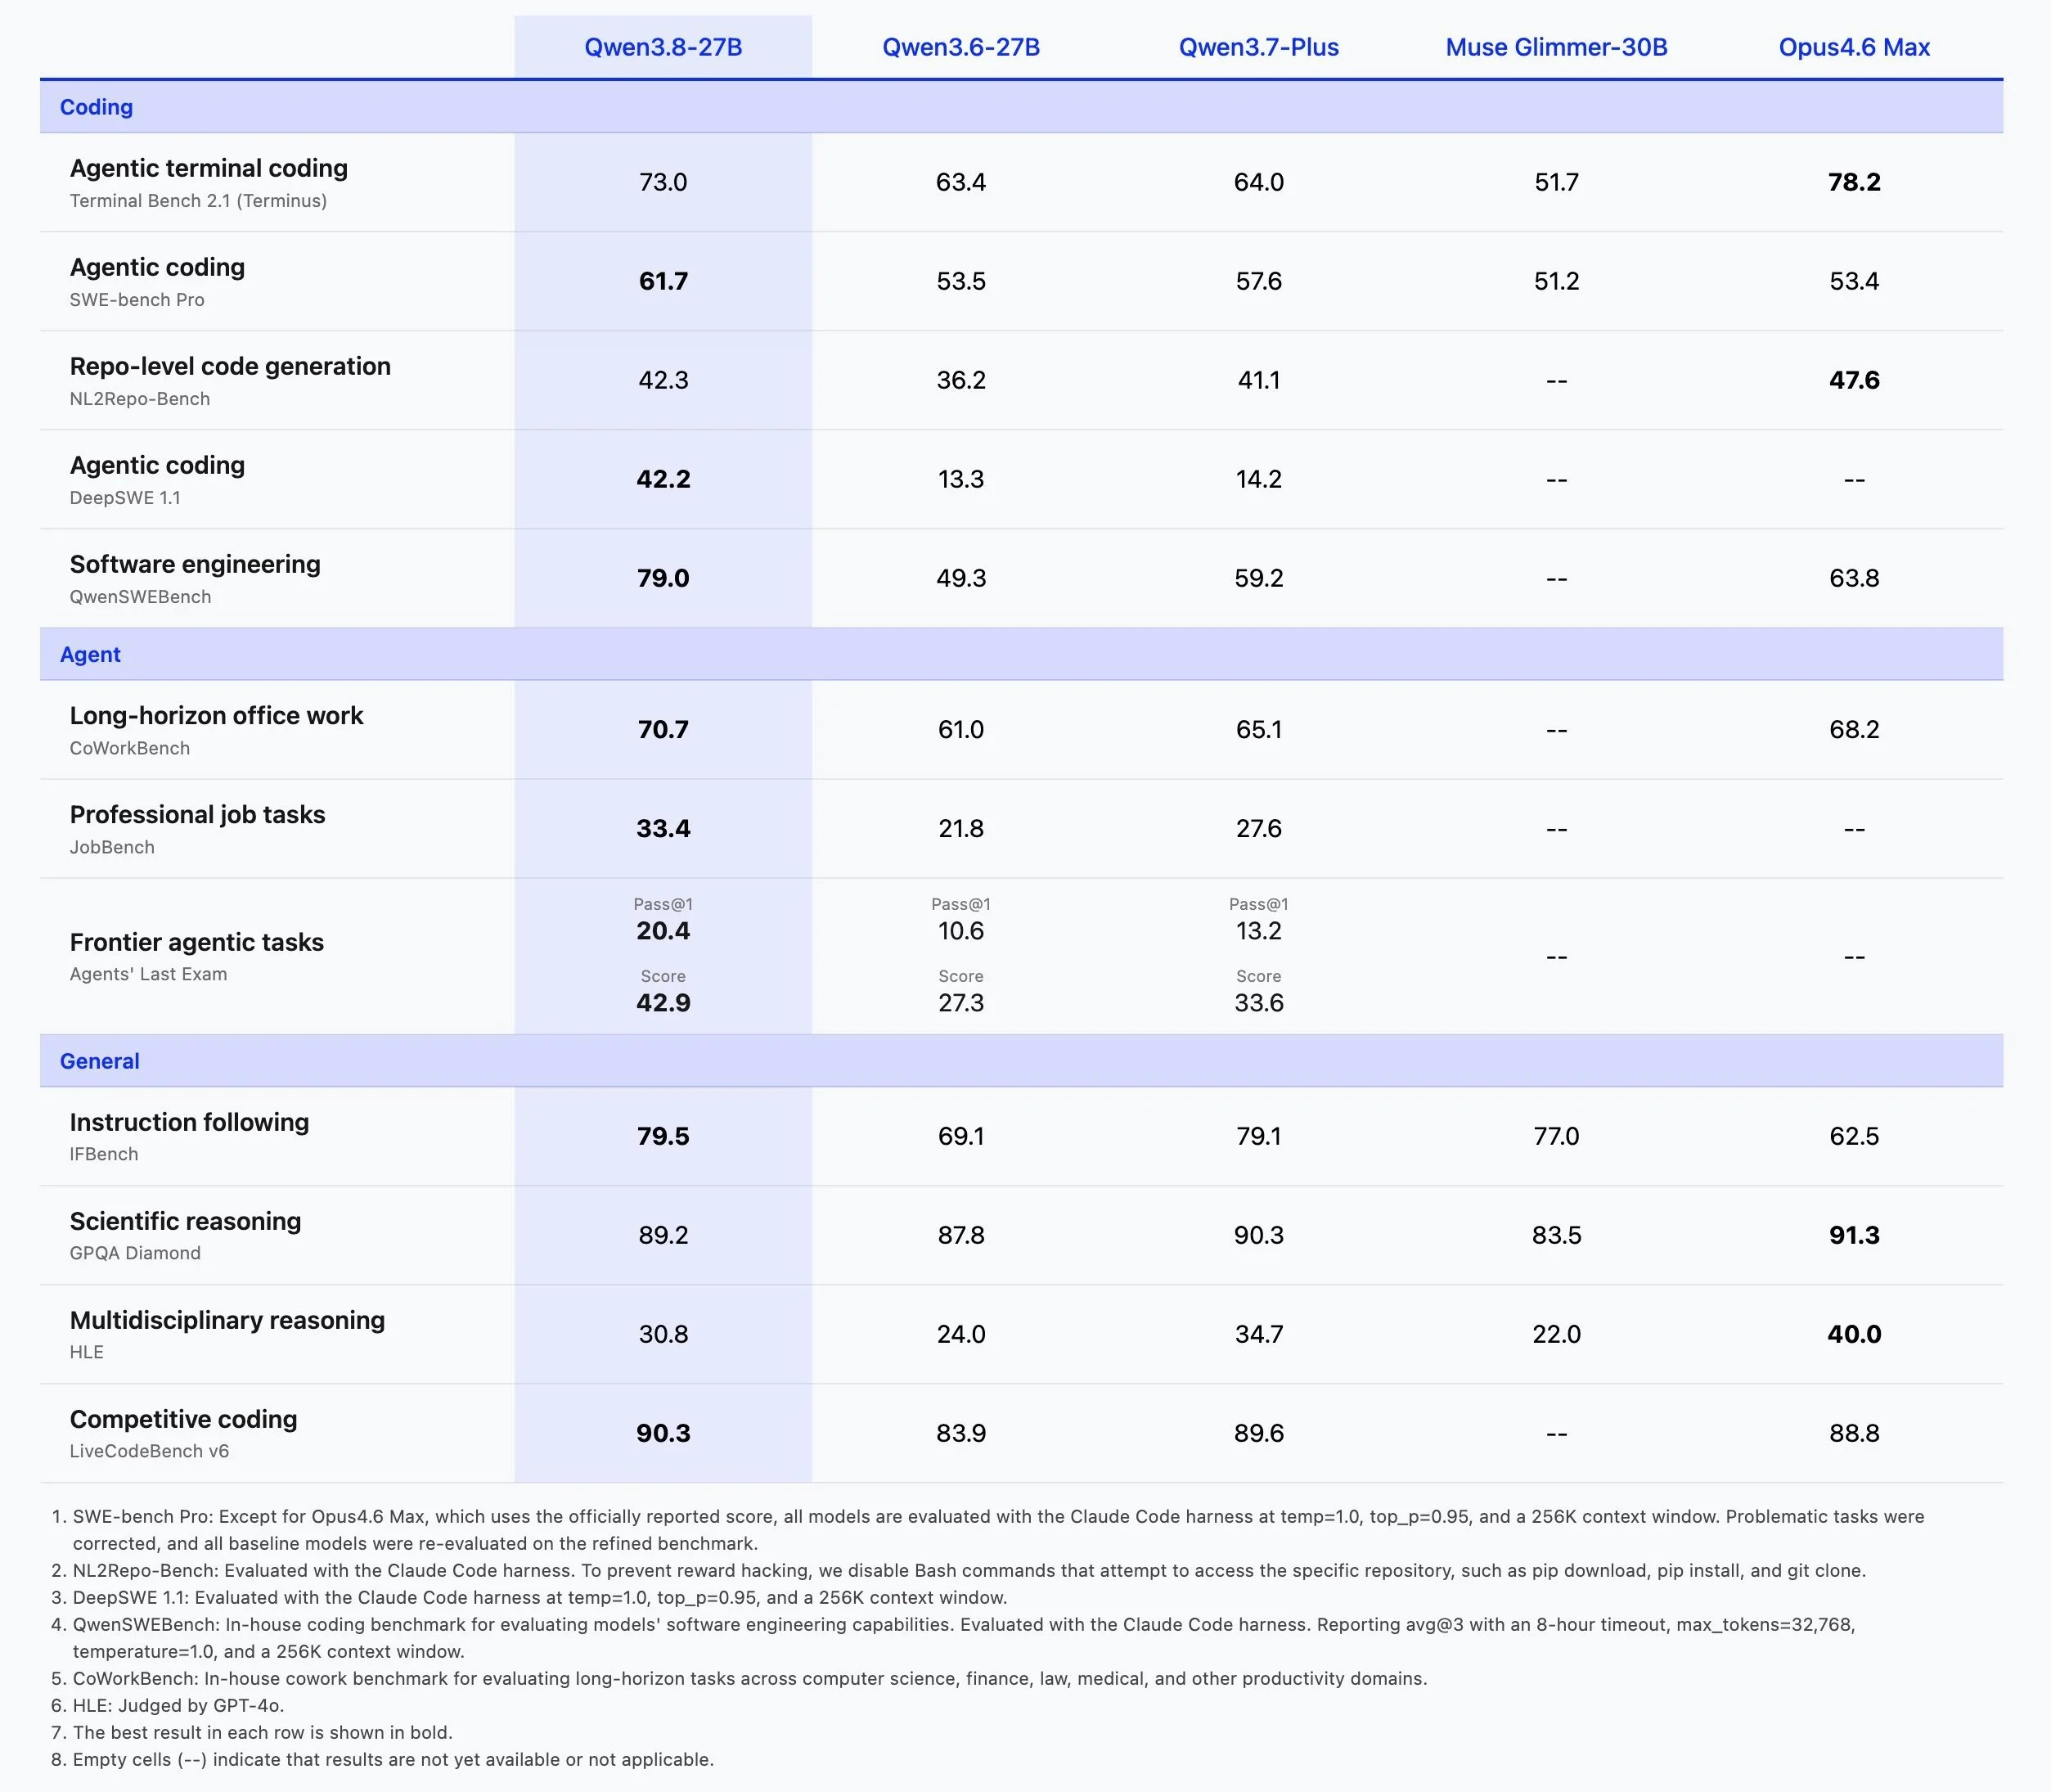
หัวใจของข่าวนี้ไม่ใช่แค่ “มีโมเดลใหม่” แต่คือความจริงที่ว่าโมเดลขนาด 27 พันล้านพารามิเตอร์ที่รันบนโน้ตบุ๊คส่วนตัวได้ กำลังเข้าใกล้ระดับสมรรถนะของ Claude Opus 4.6 โมเดลที่เคยถูกประกาศว่าเป็นรุ่นฉลาดที่สุดของ Anthropic ตอนเปิดตัวเมื่อกุมภาพันธ์ที่ผ่านมา. ในโลกที่เปลี่ยนช้า ปกติหกเดือนแทบไม่ใช่อะไร แต่ในโลก LLM วันนี้ หกเดือนคือระยะทางที่โมเดลโอเพ่นซอร์สไล่ทันแนวหน้าได้แล้ว.
บน benchmark GPQA Diamond ซึ่งทดสอบการให้เหตุผลระดับบัณฑิตในฟิสิกส์ เคมี ชีววิทยา Qwen3.8-27B ทำคะแนน 89.2 ขณะที่ Opus 4.6 ได้ 91.3. อีกบททดสอบอย่าง Humanity’s Last Exam Qwen ได้ 30.8 เทียบกับ 40.0 ของ Opus. ช่องว่างยังมี แต่ไม่ใช่ระดับ “คนละยุค” อีกต่อไป การที่โมเดลที่เคยต้องดาต้าเซ็นเตอร์ถึงใช้ได้ วันนี้ถูกย่อลงจนรันบนเครื่องเกมมิงพีซีได้ คือสัญญาณว่าเส้นแบ่งระหว่างคลาวด์ระดับบนกับของที่นักพัฒนาดาวน์โหลดเองกำลังบางลงอย่างรวดเร็ว.
สิ่งที่น่าสนุกคือ Qwen3.8-27B ไม่ได้ลงสนามคนเดียว กลุ่ม LLM ขนาดเล็กกำลังผุดขึ้นจากหลายค่าย เช่น Muse Glimmer ขนาด 30 พันล้านพารามิเตอร์ที่ออกแบบให้รันบน GPU เดียว แต่ในการทดสอบภายในหลายชุด Qwen3.8-27B ทำคะแนนเหนือกว่าเกือบทุกด้าน. เมื่อแนวรบ “โมเดลท้องถิ่น” กลายเป็นสมรภูมิหลัก นักพัฒนาคือผู้ได้เปรียบ เพราะไม่ต้องเลือกระหว่าง “แรงแต่แพงบนคลาวด์” กับ “ฟรีแต่โง่บนเครื่องตัวเอง” อีกต่อไป
จากคลาวด์สู่เครื่องเรา: ประมวลผล AI ท้องถิ่นกับต้นทุนที่ลดฮวบ
สิ่งที่ทำให้ Qwen3.8-27B น่าตื่นเต้นสำหรับนักพัฒนาไม่ใช่แค่คะแนน benchmark แต่คือเรื่องการประมวลผล AI ท้องถิ่นเต็มรูปแบบ โมเดลนี้ออกแบบให้รันได้บนฮาร์ดแวร์ของผู้ใช้เอง เมื่อดาวน์โหลดเสร็จ ตัวโมเดลจะทำงานบนเครื่องท้องถิ่นทั้งหมด ไม่มีการส่งโทเคนกลับไปยังเซิร์ฟเวอร์ ไม่มีการต้องใช้ API key และไม่มีบิลคลาวด์ตามมาทีหลัง. นี่คือ AI ประหยัดต้นทุนในเชิงโครงสร้าง เพราะคุณไม่ได้เช่าเวลาเซิร์ฟเวอร์ใครอีกแล้ว แต่เป็นเจ้าของไฟล์โมเดลเอง
ผลกระทบเชิงปฏิบัติชัดมาก: โมเดลที่รันท้องถิ่นสามารถใช้งานบนเครื่องบิน ในโรงงานหรือศูนย์ข้อมูลที่ไม่มีอินเทอร์เน็ต หรือภายในองค์กรที่ไม่ต้องการให้ข้อมูลออกนอกระบบเลย. ไม่ต้องกลัว rate limit ไม่ต้องกลัวเงื่อนไข API เปลี่ยน หรือโมเดลถูกถอนออกจากบริการข้ามคืน นอกจากนี้ Qwen3.8-27B ยังมาพร้อมหน้าต่าง context 262K ที่ขยายได้ถึงระดับล้านโทเคนผ่านเทคนิค YaRN ทำให้การวิเคราะห์เอกสารยาวหรือโค้ดเบสขนาดใหญ่บนเครื่องเดียวกลายเป็นเรื่องปกติ.
คำอธิบายหนึ่งระบุว่า “ช่องว่างระหว่างสิ่งที่บริษัททำได้ด้วยการสมัครใช้โมเดลคลาวด์ระดับแนวหน้า กับสิ่งที่นักพัฒนาทำได้ด้วยไฟล์โมเดลบนฮาร์ดไดรฟ์ของตัวเองกำลังหดลงอย่างรวดเร็ว และกำลังหดไปในทิศทางที่เข้าข้างคนที่อยากเป็นเจ้าของโครงสร้างพื้นฐาน AI เองมากกว่าการเช่า”. นี่คือจุดหักเหที่ทำให้การลงทุนใน LLM ขนาดเล็กกลายเป็นกลยุทธ์ AI ประหยัดต้นทุนที่ยังคงพลังระดับสูง
เบื้องหลังพลัง LLM ขนาดเล็ก: การกลั่นโมเดล (distillation)
คำถามที่นักพัฒนาหลายคนมีคือ ทำไม LLM ขนาดเล็กถึงเริ่ม “หมัดหนัก” ใกล้เคียงรุ่นใหญ่ คำตอบสำคัญคือเทคนิคการกลั่นโมเดล หรือ distillation ซึ่งคือกระบวนการให้โมเดลขนาดใหญ่ทำหน้าที่เป็นครู สอนโมเดลนักเรียนที่เล็กกว่าให้เลียนแบบรูปแบบคำตอบของมัน. แทนที่จะแค่เทรนด้วยฉลากปกติ นักเรียนจะเรียนรู้จากการกระจายความน่าจะเป็นและคำอธิบายของครู ทำให้ดูดซึมวิธีคิดของโมเดลระดับแนวหน้าเข้าไปได้มากกว่าการฝึกแบบเดิม
การกลั่นนี้ทำให้โมเดลขนาดเล็กที่รันบนฮาร์ดแวร์ธรรมดาทำงานได้เหนือกว่าขนาดของมันเอง มีตัวอย่างว่าโน้ตบุ๊ค RAM 8GB ยังรันโมเดล 3–4 พันล้านพารามิเตอร์แบบควอนไทซ์ได้. ทีมหนึ่งใช้โมเดลใหญ่ DeepSeek-R1 ซึ่งมีพารามิเตอร์รวม 671 พันล้าน (37 พันล้านใช้งานต่อโทเคน) เป็นครู สร้างชุดข้อมูลเหตุผลเพื่อเทรนโมเดลขนาดเล็กตั้งแต่ 1.5 ถึง 70 พันล้านพารามิเตอร์ที่อิงจาก Qwen และ Llama. ผลคือโมเดลลูกที่กลั่นออกมามีพลังการให้เหตุผลดีกว่าโมเดลขนาดเท่ากันที่เทรนด้วย reinforcement learning เพียงอย่างเดียว.
ข้อสรุปชัดเจน: distillation คือเหตุผลว่าทำไมเราถึงมี LLM ขนาดเล็กที่รันบนโน้ตบุ๊คได้แต่ยังทำงานซับซ้อนได้ดี มันช่วยให้โมเดล 3–4 พันล้านพารามิเตอร์สามารถสืบทอดพฤติกรรมของระบบขนาดหลายร้อยพันล้านได้. สำหรับนักพัฒนา ความหมายคือคุณไม่จำเป็นต้องเข้าถึงครูระดับคลาวด์ตลอดเวลา ขอแค่มีนักเรียนที่ได้รับการกลั่นดี ก็พอจะใช้เป็นสมองกลางในโครงการ self-hosted หรือระบบที่ต้องการประมวลผล AI ท้องถิ่นได้อย่างมั่นใจ

อนาคตของนักพัฒนา: จากโน้ตบุ๊คสู่ขอบเครือข่าย และการแข่งขันโมเดล AI แบบเปิด
เมื่อโมเดลอย่าง Qwen3.8-27B และ LLM ขนาดเล็กอื่นๆ กลายเป็นของใช้ทั่วไป แนวคิดการประมวลผล AI ท้องถิ่นบนมือถือ อุปกรณ์ edge และสภาพแวดล้อมทรัพยากรจำกัดจึงไม่ใช่แค่ทฤษฎีอีกต่อไป Distillation ทำให้โมเดลที่รันบนเครื่องเล็ก “ต่อยเกินน้ำหนัก” และยังคงรองรับงานซับซ้อนได้. นักพัฒนาสามารถออกแบบแอปที่ประมวลผลบนอุปกรณ์ผู้ใช้โดยตรง ลดการพึ่งพาเซิร์ฟเวอร์กลางทั้งด้านค่าใช้จ่ายและความเสี่ยงข้อมูลหลุด
ฝั่งผู้ให้บริการเองก็ไม่ได้หยุดอยู่ที่โมเดลท้องถิ่นเพียงอย่างเดียว อาลีบาบายังปล่อยโมเดลขนาดใหญ่กว่าอย่าง Qwen3.8-2.4T-A95B ซึ่งมีพารามิเตอร์รวม 2.4 ล้านล้านเพื่อไล่บี้โมเดลแนวหน้าระหว่างที่ Qwen3.8-27B เจาะตลาด self-hosted. รายงานหนึ่งชี้ว่าความสำเร็จของ Qwen ทำให้บริษัททิ้งระยะคู่แข่งทั้งในประเทศและมาจากสหรัฐได้ชัดเจน และกลายเป็นหนึ่งในฐานสำคัญของระบบนิเวศ AI แบบเปิด.
ที่สำคัญคือ แนวโน้มนี้ยังไม่ถึงจุดอิ่มตัว มีการประเมินว่าบรรดาโมเดล AI แบบเปิดและ LLM ท้องถิ่นจะยังพัฒนาต่อไปอีกมาก. ช่องว่างระหว่างสิ่งที่โมเดลโอเพ่นทำได้กับโมเดลระบบปิดระดับแนวหน้าจะยิ่งแคบลง และทั้งหมดนี้เกิดขึ้นในทิศทางที่เข้าข้างนักพัฒนาและองค์กรที่อยากเป็นเจ้าของโครงสร้างพื้นฐาน AI เองมากกว่าการเช่าตลอดไป. ในโลกใบใหม่ของ AI ประหยัดต้นทุน ผู้ชนะคือคนที่เรียนรู้จะใช้โมเดลโอเพ่นให้คุ้มบนฮาร์ดแวร์ที่ตัวเองมี