
AI Agent ไม่ใช่ฟังก์ชันธรรมดา: นิยามใหม่ของการทดสอบ
การทดสอบ AI Agent คือกระบวนการตรวจสอบความน่าเชื่อถือของ AI ที่ต้องตอบสนองแบบไม่กำหนดตายตัว โดยเน้นพฤติกรรม การเรียกใช้เครื่องมือ การอนุญาต และผลลัพธ์ต่อผู้ใช้ มากกว่าการตรวจถ้อยคำหรือค่าออกเฉพาะเจาะจง การทดสอบจึงต้องดูว่าระบบตอบสนองได้สม่ำเสมอ ปลอดภัย และสอดคล้องกับนโยบาย แม้ข้อมูลนำเข้า บริบท และสภาพแวดล้อมจะเปลี่ยนแปลงอยู่ตลอดเวลา
ข้อผิดพลาดใหญ่ของการทดสอบ AI Agent คือการคิดว่ามันเป็นฟังก์ชันเชิงกำหนดเหมือนโค้ดทั่วไป นักพัฒนาหลายคนเจอปัญหาว่าทดสอบผ่านแล้วพัง เพราะคำตอบเปลี่ยนจากประโยคหนึ่งเป็นอีกประโยคหนึ่งที่มีความหมายเดียวกัน แต่ assertion แบบเทียบข้อความเป๊ะกลับฟ้องว่าล้มเหลว สิ่งนี้สะท้อนตรงๆ ว่า AI Agent ไม่ใช่ pure function และการคาดหวังให้ตอบเหมือนเดิมทุกครั้งคือความเข้าใจที่ผิด การทดสอบ AI Agent จึงต้องหันไปมองคำถามที่สำคัญกว่า คือระบบ “มีพฤติกรรมถูกต้อง” หรือไม่ ไม่ใช่ “ตอบคำนี้หรือเปล่า”
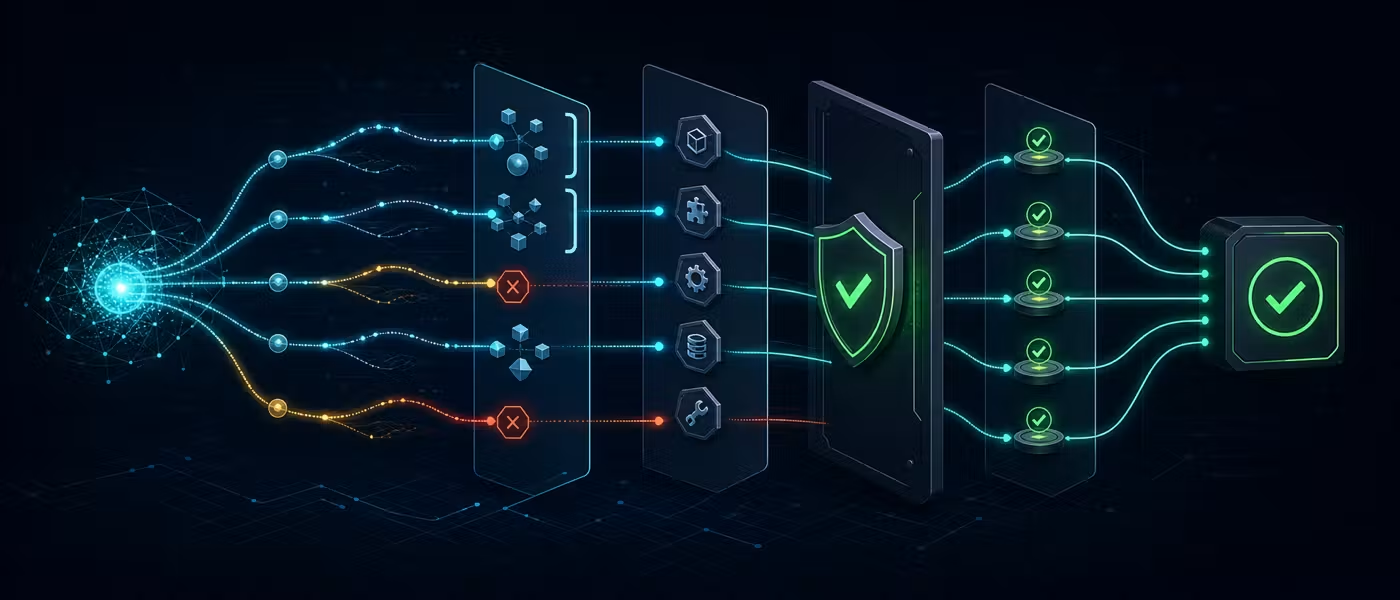
เลิกยึดติดคำตอบเป๊ะ หันมาทดสอบสัญญา เครื่องมือ และขอบเขตการอนุญาต
เมื่อผลลัพธ์ของ AI มีหลายคำตอบที่ยอมรับได้ การทดสอบแบบเทียบสตริงคำต่อคำจึงบอบบางและหักได้ง่าย การทดสอบ AI Agent ที่มีประสิทธิภาพควรย้ายจุดโฟกัสไปที่สัญญารอบส่วนที่เป็นความน่าจะเป็น เช่น schema ของข้อมูลที่แลกเปลี่ยน รายการเครื่องมือที่เสนอและถูกเรียกจริง การอนุญาต การเปลี่ยนสถานะ และผลลัพธ์ระดับระบบ สำหรับเนื้อหาที่สร้างเป็นข้อความทั่วไป ควรประเมินด้านความหมายและคุณภาพผู้ใช้ ผ่าน rubric หรือ semantic grader ที่มีขอบเขต แทนการบังคับให้ตอบประโยคเดียวกันทุกครั้ง
หัวใจสำคัญของการทดสอบการทำงานของ AI Agent ในโลกจริง คือเครื่องมือและขอบเขตการทำงาน ไม่ใช่ความสละสลวยของประโยค หนึ่งในประโยคที่ควรจำคือ เครื่องมือที่ถูกเลือกผิดอาจทำลายข้อมูลได้ แม้ข้อความจะสวยก็ตาม การทดสอบจึงต้องตรวจว่า agent เสนอการเรียกเครื่องมือไหน runtime อนุญาตให้เรียกอะไร และเครื่องมือที่ถูกเรียกสอดคล้องกับเจตนาของผู้ใช้หรือไม่ เพราะคำสวยงามไม่สามารถชดเชยการเรียกเครื่องมือที่ทำลายข้อมูลในงานค้นหาที่ควรอ่านอย่างเดียวได้
เมื่อการทดสอบผ่านหมด แต่ AI ยังล้มเหลวในโปรดักชัน
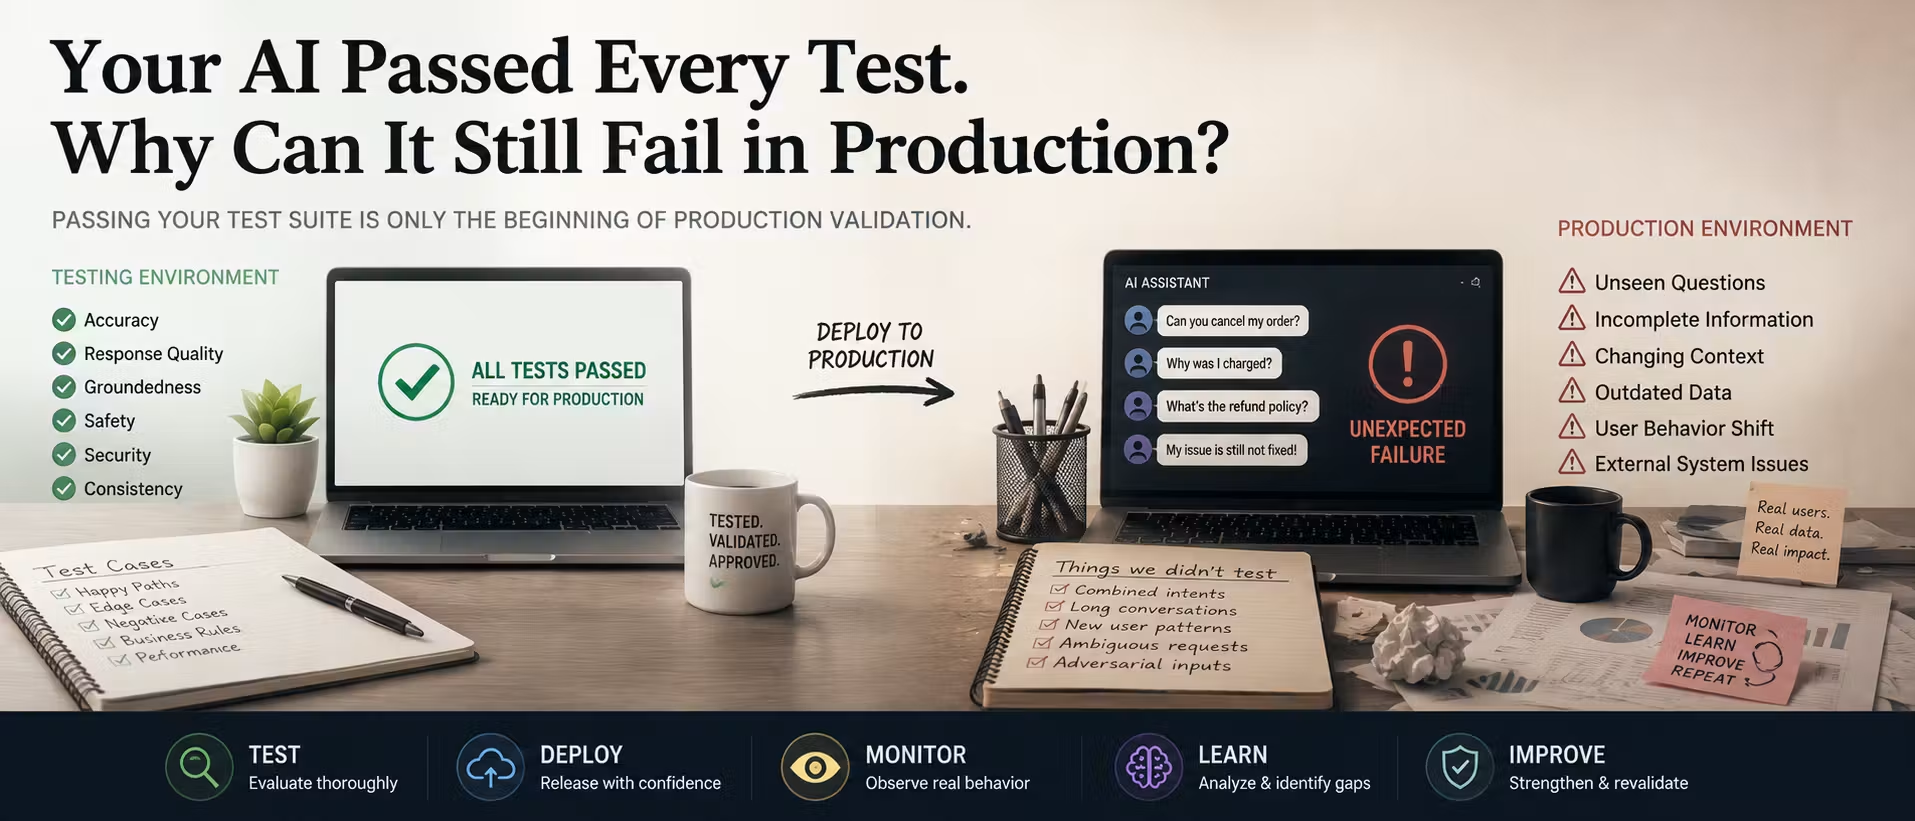
แม้จะมีการทดสอบ AI Agent อย่างเข้มข้น ทั้งความแม่นยำ คุณภาพคำตอบ และความปลอดภัย แต่เมื่อปล่อยใช้งานจริงผู้ใช้กลับพบความล้มเหลว สิ่งนี้ไม่ได้หมายความว่าทีมทดสอบไร้ประสิทธิภาพ แต่สะท้อนว่าการใช้กรอบคิดการทดสอบซอฟต์แวร์แบบเดิมกับระบบที่มีพฤติกรรมเปลี่ยนได้ตลอด เป็นสมมติฐานที่ผิด คำถามของการทดสอบกับ AI จึงไม่ใช่แค่ระบบทำงานตรงตามที่คาดหรือไม่ แต่ต้องถามว่า เมื่ออินพุต บริบท ข้อมูล และเอาต์พุตเปลี่ยน ระบบยังมีความน่าเชื่อถือแค่ไหน
เมื่อผู้ใช้จริงเริ่มถามคำถามที่ไม่มีในชุดทดสอบ ถามเรื่องเดิมด้วยภาษาที่ต่างออกไป ให้ข้อมูลไม่ครบ คุยยาวจนบริบทเปลี่ยน หรือทำให้โมเดลสับสน ระบบที่เคยดูมั่นใจในห้องแล็บอาจเริ่มตอบผิดและผิดนโยบาย ชุดทดสอบก่อนโปรดักชันอาจครอบคลุมสถานการณ์จำนวนมาก แต่ไม่เคยสามารถจำลองทุกปฏิสัมพันธ์จริงได้ และนี่คือเหตุผลสำคัญว่าทำไม AI ที่ผ่านทุกเทสต์ยังล้มเหลวในโปรดักชันได้ การวัดเพียงว่าเทสต์ผ่านหรือไม่จึงไม่พอ ต้องดูด้วยว่าสถานการณ์สำคัญให้ผลลัพธ์ที่ยอมรับได้อย่างสม่ำเสมอเพียงใด
กลยุทธ์การทดสอบ AI Agent ที่เน้นพฤติกรรมและความน่าเชื่อถือ
การทดสอบ AI Agent ที่เน้นความน่าเชื่อถือของ AI ต้องผสมผสานการทดสอบแบบกำหนดแน่นอนกับการประเมินพฤติกรรมที่ขึ้นกับโมเดล ใช้การทดสอบแบบ deterministic ตรวจ schema นโยบาย การเปลี่ยนสถานะ ตัวห่อเครื่องมือ กฎการ retry และตรรกะของอินเทอร์เฟซผู้ใช้ ซึ่งทั้งหมดควรทำงานได้แบบเสถียรและตรวจสอบได้บ่อย จากนั้นใช้ชุดการประเมินที่เล็กกว่าแต่ใช้โมเดลจริง เพื่อดูงานที่ขึ้นกับโมเดลโดยตรง เช่น การจัดประเภทเจตนา ข้อเสนอเครื่องมือ การถามย้อนเพื่อความชัดเจน คุณภาพเชิงความหมาย และคำถามโจมตีระบบ
ชุดการทดสอบ AI Agent ที่มีคุณค่าควรรวมสถานการณ์ที่คัดเลือกอย่างตั้งใจ ทั้งกรณีใช้งานปกติ เคสกำกวม เคสไม่ปลอดภัย และเงื่อนไขเสื่อมคุณภาพ เช่น บริบทไม่ครบหรือข้อมูลเก่า คำกล่าวที่ควรหยิบมาใช้ซ้ำในทีมคือ การถามเพียงว่าเทสต์นี้ผ่านหรือไม่ไม่เพียงพอ วิศวกรคุณภาพของ AI ควรถามเพิ่มว่า สถานการณ์นี้ให้ผลลัพธ์ที่ยอมรับได้บ่อยแค่ไหน เพราะสำหรับระบบ AI ความสม่ำเสมอสำคัญพอๆ กับความถูกต้อง
การตรวจสอบต่อเนื่องและการเฝ้าดูพฤติกรรม AI ในโลกจริง
การทดสอบ AI Agent ไม่จบในวันปล่อยโปรดักชัน การเปลี่ยนแปลงของข้อมูลธุรกิจ พฤติกรรมผู้ใช้ และบริบทการใช้งานทำให้คุณภาพที่เคยดีเมื่อวันเปิดตัวไม่ใช่ใบรับประกันตลอดกาล ระบบ AI จึงไม่อาจรับตรารับรองคุณภาพครั้งเดียวแล้วถือว่าทดสอบเสร็จ การตรวจสอบคุณภาพต้องเดินคู่กับการใช้งานจริงอย่างต่อเนื่อง เมื่อสภาพแวดล้อมเปลี่ยน การประเมินก็ต้องอัปเดตตาม
การเฝ้าดูในโปรดักชันจึงต้องขยับจากการดูว่าแอปยังออนไลน์อยู่หรือไม่ ไปสู่การดูว่าพฤติกรรมของ AI ยังน่าเชื่อถือหรือไม่ การทดสอบการทำงานในโลกจริงอาจรวมถึงการสุ่มตรวจคำตอบ การรีวิวเคสที่ผู้ใช้รายงาน การเก็บสถิติความสำเร็จในสถานการณ์สำคัญ และการใช้ evaluator อัตโนมัติช่วยตรวจความถูกต้องและความปลอดภัยของแต่ละรอบตอบ จุดหมายปลายทางไม่ใช่ AI ที่ไม่เคยผิด แต่คือ AI ที่เมื่อเริ่มเบี่ยงพฤติกรรมสามารถถูกจับได้เร็ว แก้ได้ไว และเรียนรู้จากข้อผิดพลาดในการใช้งานจริง