
AI ระบบการผลิตคืออะไร และทำไมการทดสอบไม่พอ
AI ระบบการผลิตคือระบบปัญญาประดิษฐ์ที่ถูกนำออกจากห้องทดลองไปใช้งานกับผู้ใช้จริงและข้อมูลจริงในสภาพแวดล้อมของธุรกิจ โดยต้องทำงานร่วมกับระบบเดิม ข้อมูลที่เปลี่ยนตลอดเวลา และเหตุการณ์ไม่คาดคิด เป้าหมายไม่ใช่แค่ให้โมเดลตอบถูกในชุดทดสอบ แต่ต้องตอบได้อย่างเสถียร ปลอดภัย และสอดคล้องกับบริบทที่เปลี่ยนไปเสมอ ดังนั้นการทดสอบ AI แค่ช่วงพัฒนาจึงไม่พอ เพราะการผ่านเทสต์ในห้องแลบไม่ได้แปลว่าระบบจะรอดในโลกจริงที่ยุ่งกว่ามาก
ความล้มเหลวของ AI ในระบบการผลิตไม่ได้หมายความว่าทีมทดสอบทำงานแย่เสมอไป ปัญหาใหญ่อยู่ที่เราพยายามใช้แนวคิดทดสอบซอฟต์แวร์แบบเดิมกับระบบที่มีพฤติกรรมไม่ตายตัวและผลลัพธ์หลากหลายกว่ามาก ในแอปจ่ายเงินแบบเดิม ผลลัพธ์ที่คาดหวังอาจชัดเจน แต่ในผู้ช่วย AI คำตอบที่ถือว่าถูกต้องอาจมีได้หลายแบบ และต้องตรวจทั้งข้อเท็จจริง ความเกี่ยวข้อง ความปลอดภัย และความสอดคล้องกับนโยบายองค์กร เมื่อการนิยามคำว่า “ผ่านเทสต์” ซับซ้อนขึ้น การหวังพึ่งชุดทดสอบรอบเดียวก่อนปล่อยเข้าสู่ AI ระบบการผลิตจึงเป็นความเสี่ยงมากกว่าหลักประกัน
เมื่อผู้ใช้จริงไม่เหมือนดาต้าเซ็ต: จุดที่ AI พังต่อหน้าคน
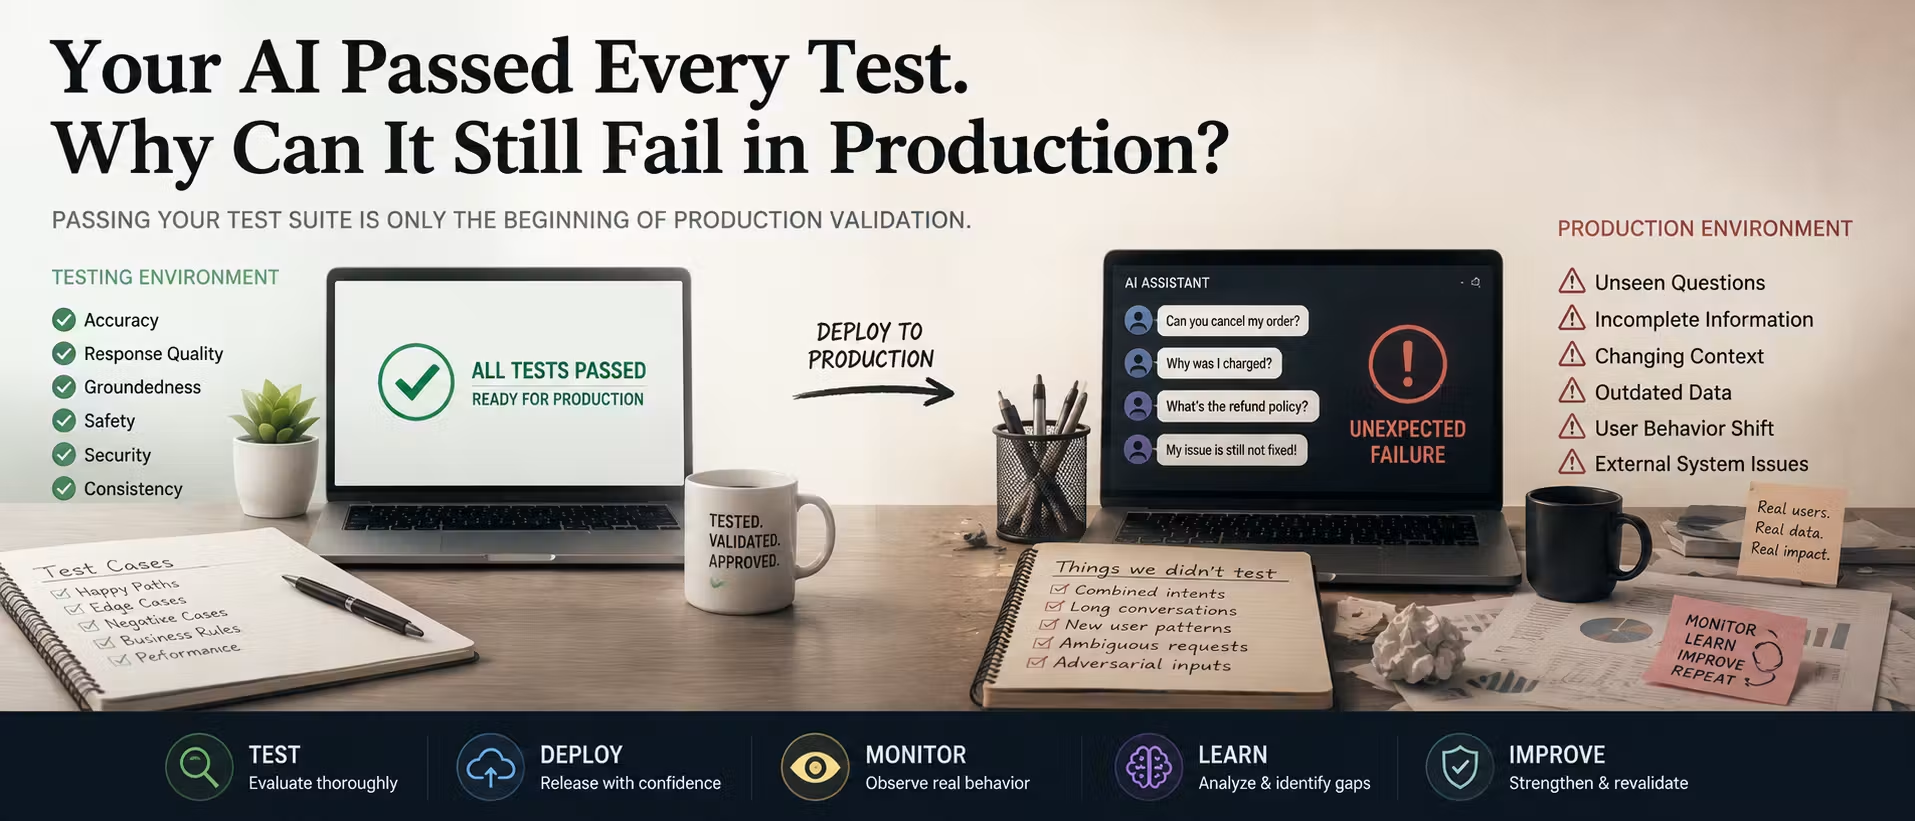
ในสายตาผู้ใช้ทั่วไป ความแตกต่างทางเทคนิคไม่สำคัญเลย ลูกค้าถามคำถามแล้วได้คำตอบผิด นั่นคือระบบล้มเหลวทันที สิ่งที่ทำให้ความล้มเหลวของ AI เจ็บปวดคือมันมักเกิดหลังจากทีมประกาศว่าผ่านทุกการทดสอบแล้ว ลูกค้าคนหนึ่งถามคำถามที่ไม่มีในดาต้าเซ็ต อีกคนถามเรื่องเดิมด้วยภาษาพูดแปลกออกไป บางคนให้ข้อมูลไม่ครบ บางคนสนทนายาวจนบริบทเปลี่ยน สิ่งเหล่านี้ไม่เคยโผล่ในห้องทดสอบ แต่เป็นเรื่องปกติของโลกจริง
ผู้ใช้จริงไม่พิมพ์เหมือนสคริปต์ทดสอบที่เตรียมอย่างดี พวกเขาสะกดผิด ใส่หลายคำถามในประโยคเดียว ใช้สแลง สลับภาษากลางบทสนทนา แปะข้อความยาวมาก และเปลี่ยนหัวข้อทันทีที่นึกออก พร้อมกันนั้นสภาพแวดล้อมระบบการผลิตยังเต็มไปด้วยดาต้าเก่า API ล่ม คำขอซ้ำซ้อน ข้อจำกัดสิทธิ์การเข้าถึง การเชื่อมต่อขัดข้อง ข้อมูลขัดแย้ง ผู้ใช้ไม่คาดคิด กติกาธุรกิจที่เปลี่ยน และข้อจำกัดต้นทุน AI ที่ดูน่าเชื่อถือในห้องทดลองจึงกลายเป็นระบบที่ตอบผิดหรือทำงานผิดลำดับต่อหน้าผู้ใช้ได้ง่าย
ปัญหาไม่ได้อยู่ที่โมเดลอย่างเดียว แต่อยู่ที่ทั้งระบบ
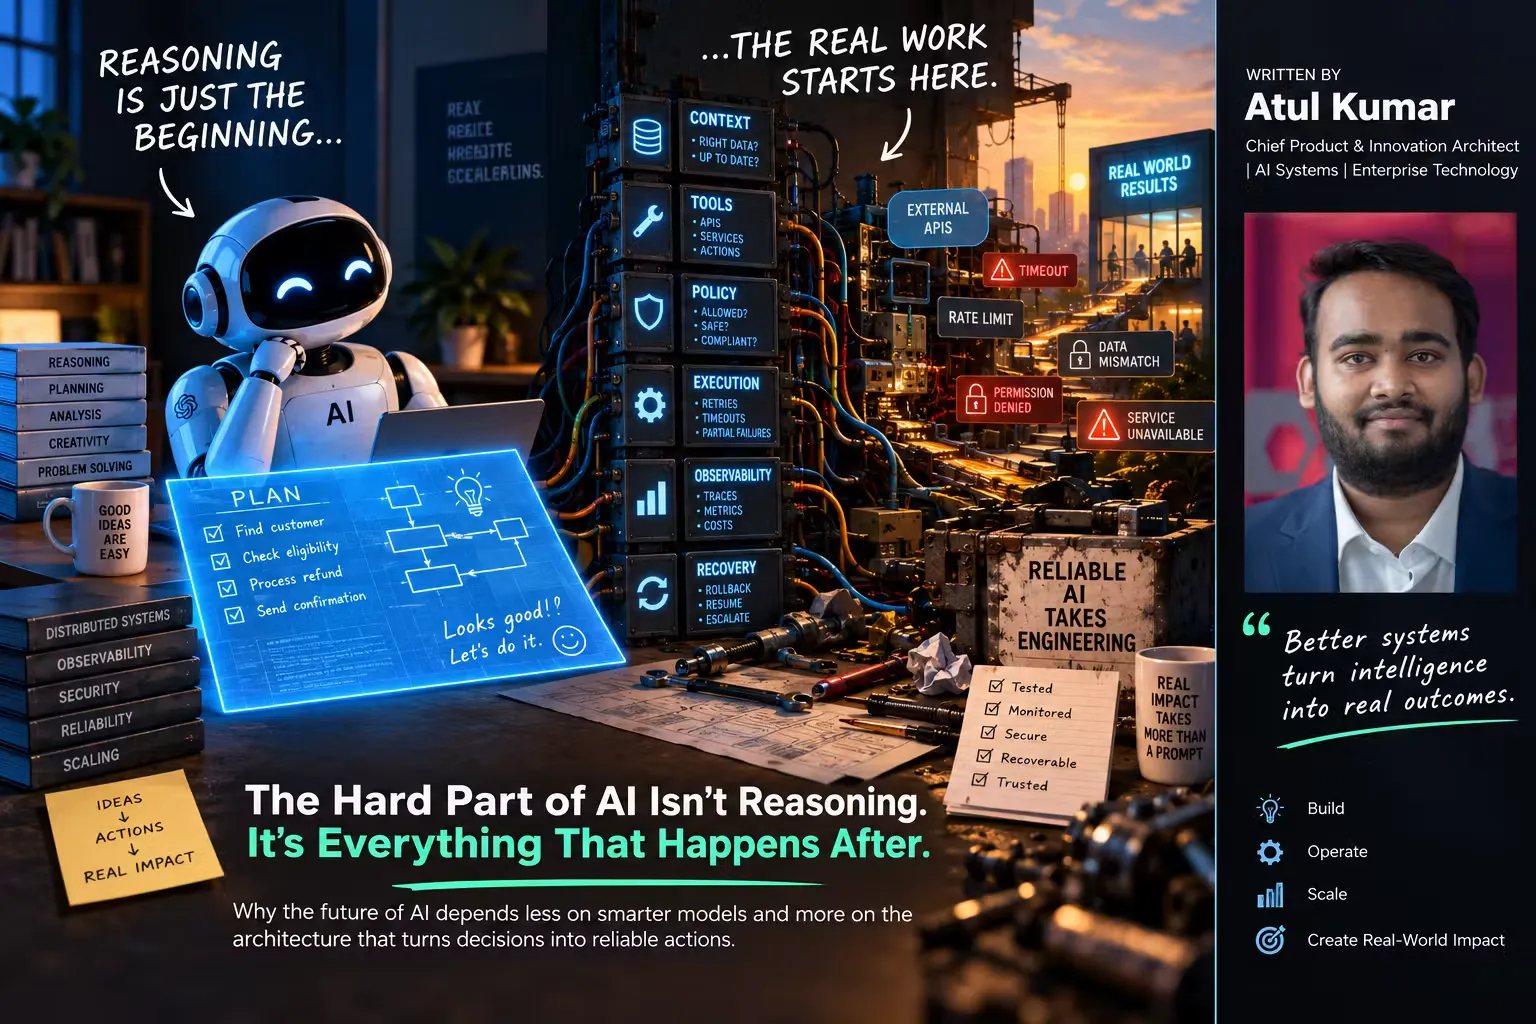
เรามักหลงกับตัวเลขความแม่นยำและผลสอบของโมเดลจนลืมว่างานยากของ AI ระบบการผลิตคือการเปลี่ยน “คำตัดสินของโมเดล” ให้เป็น “ผลลัพธ์ในโลกจริง” โมเดลอาจตัดสินได้ถูกว่าลูกค้ามีสิทธิ์ได้รับเงินคืน แต่ระบบยังต้องค้นหาบัญชี ตรวจรายการ เช็คกติกา คำนวณจำนวน เรียกบริการชำระเงิน บันทึกรายการ อัปเดตบัญชี และแจ้งลูกค้า ปัญหาที่เจอบ่อยอย่างบริการการชำระเงินล่ม การอัปเดตครึ่งทาง หรือกติกาเปลี่ยนกลางกระบวนการ คือคำถามด้านสถาปัตยกรรมซอฟต์แวร์มากกว่าความฉลาดของโมเดล
นี่คือเหตุผลว่าทำไมคุณภาพของ AI จึงห้ามตีความแค่คุณภาพของโมเดล เราต้องตรวจความเสถียรของทั้งแอปพลิเคชันที่ใช้ AI และระบบทั้งหมดที่ห่อหุ้มโมเดล โครงสร้างจริงของ AI ระบบการผลิตประกอบด้วยชั้นแอปพลิเคชัน AI runtime คอนเท็กซ์ เมมโมรี สเตต เกตเวย์โมเดล โมเดล LLM ขั้นตอนตรวจสอบ และเกตเวย์เครื่องมือ ที่ปลายทางยังเชื่อมกับ API ฐานข้อมูล และบริการอื่นๆ ขนานไปกับความปลอดภัย ระบบยืนยันตัวตน การสังเกตการณ์ การประเมิน นโยบาย การควบคุมต้นทุน และการกู้คืนเมื่อผิดพลาด โมเดลจึงเป็นเพียงส่วนหนึ่งของปัญหา ไม่ใช่ทั้งระบบ
การตรวจสอบต่อเนื่องและการทดสอบตามความเสี่ยงคือสายคาดเข็มขัดนิรภัย
AI ระบบการผลิตจึงไม่ควรได้รับตรารับรองคุณภาพในวันปล่อยใช้งานแล้วถือว่า “ทดสอบจบตลอดไป” การตรวจสอบต้องดำเนินต่อเนื่องไปพร้อมกับสภาพแวดล้อมที่เปลี่ยนแปลง แค่ดูว่าระบบรันอยู่ไม่พออีกต่อไป ทีมต้องมองเห็นด้วยว่าพฤติกรรมของ AI ยังน่าเชื่อถืออยู่หรือไม่ นี่คือจุดที่การตรวจสอบต่อเนื่อง การวัดผลลัพธ์จริง และการบันทึกเคสผิดปกติเป็นเครื่องมือหลักในการรักษาความเสถียรของ AI มากกว่าการเพิ่มชุดเทสต์แบบเดิมโดยไม่รู้ว่ามีผลในโลกจริงอย่างไร
สิ่งที่องค์กรจำนวนมากยังทำผิดคือปฏิบัติกับความล้มเหลวของ AI ทุกแบบเหมือนกัน ทั้งที่ความเสี่ยงต่างกันมาก AI ทีมงานควรเลิกมองทุกข้อผิดพลาดในน้ำหนักเท่ากัน และหันมาจัดลำดับแบบทดสอบให้สอดคล้องกับระดับผลกระทบ บางความผิดพลาดอาจแค่ทำให้คำตอบน่าอ่านน้อยลง แต่บางกรณีอาจกระทบเงิน ชื่อเสียง หรือข้อกฎหมาย การทดสอบตามความเสี่ยงจึงช่วยใช้ทรัพยากรได้คุ้มค่ากว่า แนวคิดนี้ทำให้ทีมเลิกหมกมุ่นกับการชนะทุกเบนชมาร์ก แล้วหันมาโฟกัสว่าจะป้องกันความล้มเหลวของ AI ที่กระทบผู้ใช้จริงอย่างรุนแรงแทน
บทสรุป: ความเสถียรของ AI เริ่มต้นหลังผ่านเทสต์ ไม่ใช่จบลงที่เทสต์
เมื่อ AI ก้าวออกจากห้องทดลอง ความท้าทายไม่ได้จบที่การ reasoning ของโมเดล แต่เริ่มต้นที่ทุกอย่างที่เกิดขึ้นหลังคำตอบถูกสร้าง ผู้ใช้ไม่สนว่าโมเดลมีสถาปัตยกรรมแบบไหน พวกเขาสนแค่ว่า AI ช่วยแก้ปัญหาได้หรือทำให้เรื่องแย่ลงเท่านั้น การยกระดับความเสถียรของ AI จึงต้องคิดแบบระบบ ไม่ใช่แบบโมเดลล้วนๆ ต้องมีการตรวจสอบต่อเนื่อง การมองภาพรวมของสถาปัตยกรรม และการทดสอบตามความเสี่ยง ไม่เช่นนั้นการผ่านทุกการทดสอบจะเป็นเพียงภาพลวงตา
สำหรับธุรกิจ บทเรียนชัดเจนคือการลงทุนใน AI ระบบการผลิตต้องเผื่อทรัพยากรให้กับส่วนที่ไม่ใช่โมเดล เช่น การสังเกตพฤติกรรม การประเมินผลลัพธ์ และกระบวนการแก้ไขอัตโนมัติ มากกว่าทุ่มทุกอย่างให้คะแนนความแม่นยำในห้องแลบ สำหรับผู้อ่านทั่วไป ความเข้าใจนี้ช่วยตั้งความคาดหวังที่สมเหตุสมผลกับ AI และกดดันผู้ให้บริการให้รับผิดชอบทั้งระบบ ไม่ใช่แค่โอ้อวดว่า “โมเดลของฉันฉลาดแค่ไหน” เท่านั้น เมื่อเราเลิกหลงกับตัวเลขในห้องทดลอง เราจึงจะได้ AI ที่น่าเชื่อถือในโลกจริง