
จากยุค Prompt-and-Hope สู่ยุคสถาปัตยกรรมกำหนดชะตาโค้ด
AI coding agents คือระบบอัตโนมัติที่ใช้โมเดลภาษาขนาดใหญ่สร้างและแก้ไขโค้ดในฐานโค้ดจริง โดยต้องอาศัยสถาปัตยกรรมซอฟต์แวร์ที่ออกแบบมาให้บริหาร context ของโค้ด กติกาในการแก้ไข และคุณภาพเชิงโครงสร้าง ไม่ใช่พึ่งคำสั่งแบบ prompt เดี่ยว ๆ ที่หวังให้โมเดลเดาเองว่าโค้ดควรหน้าตาอย่างไรและต้องยึดตามมาตรฐานใด จึงจะกลายเป็นโค้ดที่พร้อมใช้ในโปรดักชันและตรวจสอบย้อนกลับได้ในระยะยาว ตลอดสองปีที่ผ่านมา หลายทีมใช้ LLM แบบ “ฝากชีวิตไว้กับพรอมป์” ป้อนข้อความมหาศาลเข้าไปในกล่องดำแล้วรอปาฏิหาริย์ ผลคือวิกฤตในองค์กร ทั้ง parsing error ต่อเนื่อง semantic drift และปัญหาความถูกต้องเชิงธุรกรรม AI apps จำนวนมากไม่ได้ล้มเหลวเพราะเลือกโมเดลผิด แต่เพราะใส่ชั้นสถาปัตยกรรมเข้าไปเรื่อย ๆ โดยไม่เคยนิยามว่าชั้นนั้นแก้ปัญหาอะไรเลย เมื่อฐานโค้ดโตขึ้นไม่หยุด นักพัฒนาเริ่มพบว่าการให้เอเจนต์แก้โค้ดกลายเป็นเรื่องยากขึ้นอย่างเห็นได้ชัด
Monorepo การแยกขอบเขต และการจัดการ context ที่หยุดโค้ดเละในโปรดักชัน
หัวใจของ AI coding agents quality ไม่ใช่ความฉลาดของโมเดล แต่คือ code generation architecture ที่กำหนดว่ามันมองเห็นอะไรและถูกบังคับตามกติกาอะไร การปล่อยให้เอเจนต์อ่านฐานโค้ดกระจัดกระจายหลายรีโป ทำให้ context บวมและวิธีคิดพังเร็วมาก งานวิจัยหนึ่งชี้ว่าเมื่อโหลด context เกินประมาณ 3,000 token คุณภาพการ reasoning ลดลงอย่างชัดเจน ดังนั้นคำตอบไม่ใช่ context window ที่ใหญ่ขึ้น แต่คือการจัดการโครงสร้างให้โค้ดเข้าใจง่าย แนวทางที่ได้ผลคือใช้ monorepo เป็นยุทธศาสตร์ code context management ให้ทุกแอปและแพ็กเกจอยู่ใต้หลังคาเดียวกัน แต่ออกแบบ boundary ให้ชัดเจน เช่น แยก apps เป็น shell กับ micro frontend และแยก packages เป็น ui utils analytics config เมื่อ packages utils ปล่อยเวอร์ชัน 2.1.0 helper ใหม่ module-orders สามารถขยับมาใช้ “utils” เวอร์ชันนี้ทันที ขณะที่ module-catalog ยังอยู่บน “utils” 2.0.0 จนกว่าจะตัดสินใจอัปเดต การแยกเวอร์ชันแบบนี้ลด context drift และทำให้เอเจนต์ไม่ลากโค้ดคนละยุคมาปะปนกัน
หยุดสร้างมหาวิหาร AI ที่เปลืองทรัพยากร แต่ไม่เพิ่มคุณภาพโค้ด
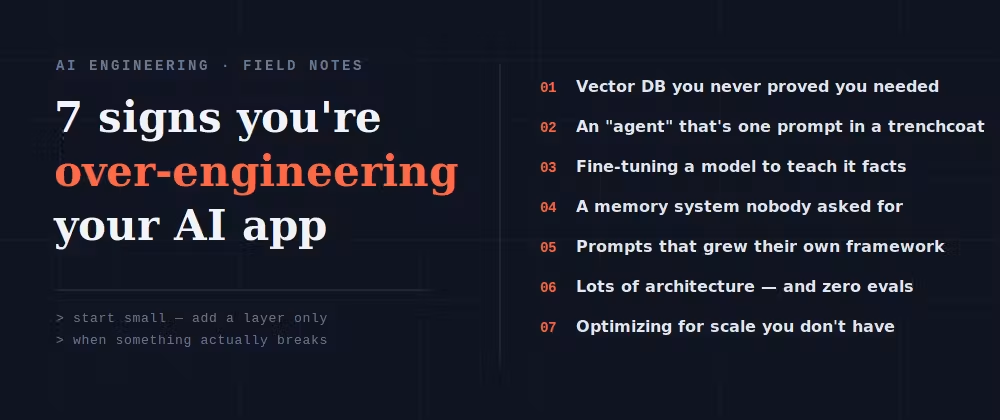
หลายทีมหลงทางไปกับโครงสร้าง AI ที่ดูอลังการแต่ไม่มีผลต่อคุณภาพจริง มีทั้ง vector database ระบบ multi-agent กราฟซับซ้อน memory layer fine-tune โมเดล และ abstraction เพื่ออนาคตที่ไม่มีใครใช้ ผลคือโครงการที่ดูน่าทึ่งในไดอะแกรม แต่ทำงานไม่ดีกว่าของง่าย ๆ เลย คุณกำลังจ่ายต้นทุนเวลา build ความซับซ้อน และภาระทางความคิด เพื่อรองรับทราฟฟิกหรือกรณีใช้งานที่อาจไม่เคยมาถึง และแต่ละชั้นกลายเป็นสิ่งที่ต้องดูแลและดีบั๊กแทนที่จะใช้ปรับปรุงผลิตภัณฑ์จริง ตัวอย่างชัดคือ vector database หลายคนรีบตั้ง Pinecone หรือ Chroma ทั้งที่ยังไม่รู้ด้วยซ้ำว่ามีปัญหาการค้นคืนระดับไหน ในทางกลับกัน coding agents ที่มีสมรรถนะสูงบางตัวกลับตัด vector search ออกแล้วใช้แค่ grep ดูโครงสร้างไฟล์ หรือขอไฟล์ตามชื่อแทน และผลลัพธ์โค้ดกลับดีกว่าอย่างมาก Multi-agent ก็เช่นกัน ทุกเอเจนต์ที่เพิ่มเข้าไปทวีคูณพื้นผิวความล้มเหลว เพิ่มจุด hallucination การส่งต่อที่พัง latency และต้นทุน ถ้าอธิบายไม่ได้ชัดเจนว่าแต่ละเอเจนต์ทำสิ่งที่ single call ทำไม่ได้ คุณกำลังเอาพรอมป์ตัวเดียวมาใส่เสื้อโค้ทหลายชั้นแล้วจ่ายแพงขึ้น
Inference-Time Scaling GraphRAG และการ orchestration เชิงกำหนดที่ทำให้เอเจนต์ทำงานดีขึ้นสองเท่า
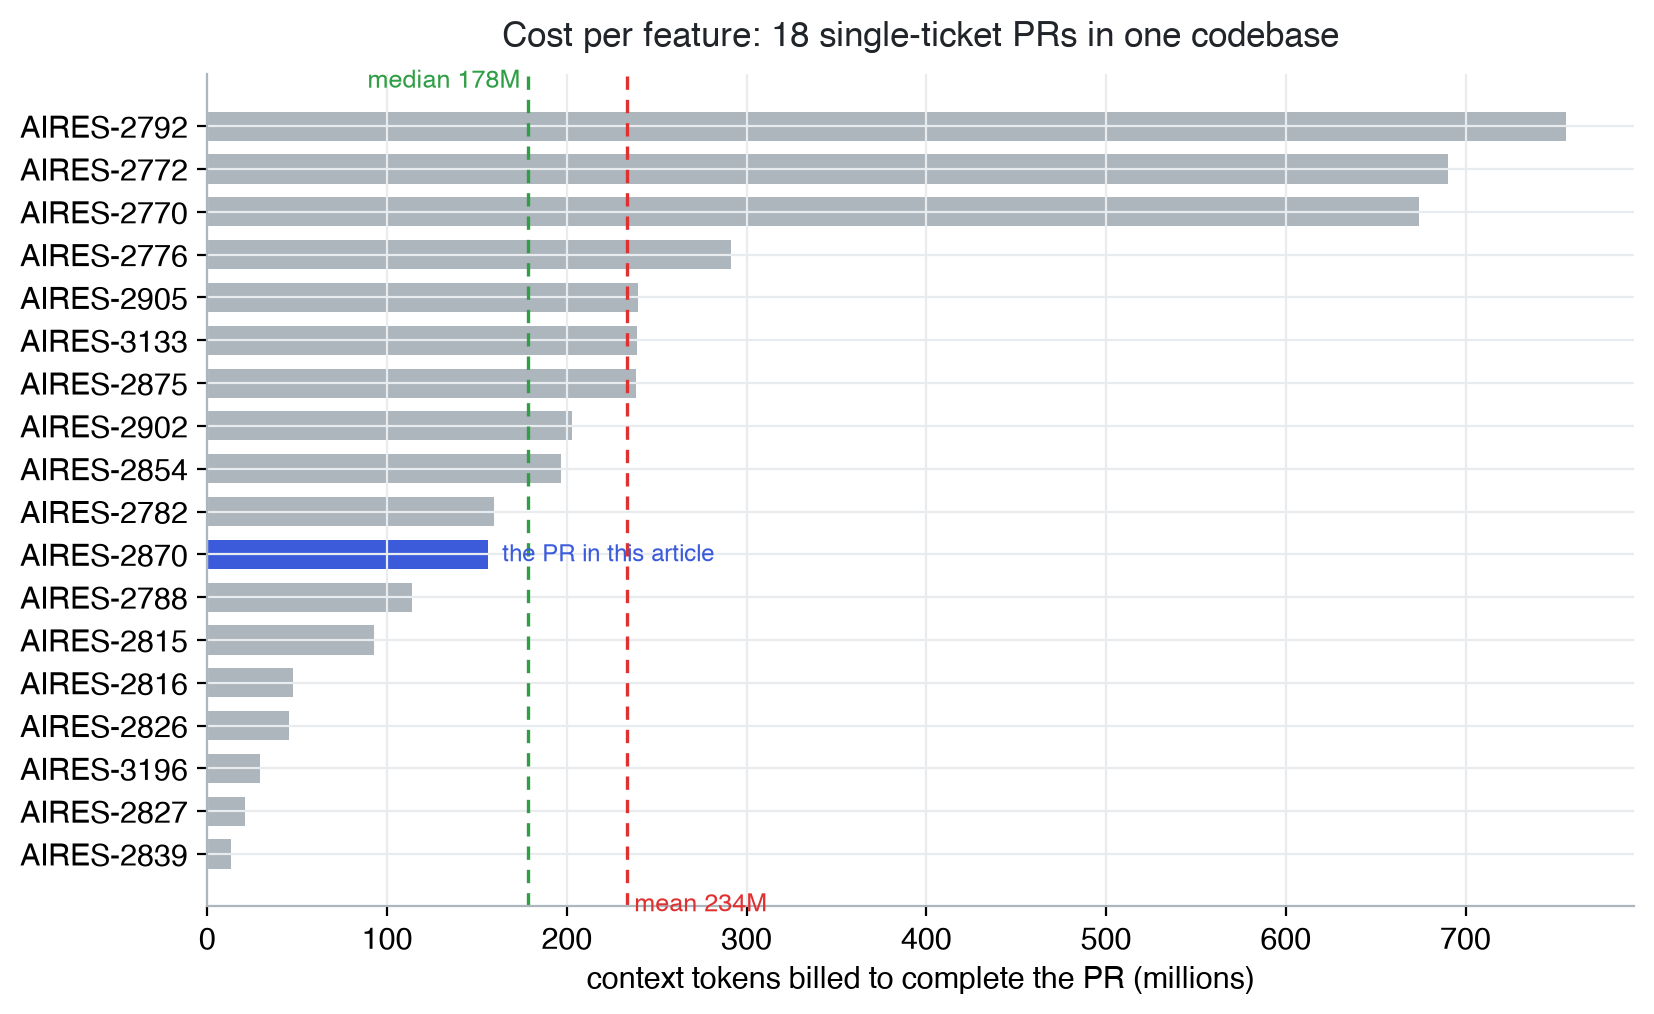
ยุคใหม่ของ production-ready AI systems กำลังขยับจากการเทรนโมเดลให้ใหญ่ขึ้นไปสู่ inference-time scaling เราไม่มองต้นทุนเป็น cost per 1M tokens อีกต่อไป แต่ดูที่ cost ต่อการทำงานสำเร็จในแต่ละงาน ระบบจำนวนมากเริ่มให้โมเดลมี “งบคิด” ก่อนตัดสินใจ ไม่ว่าจะใช้ Chain-of-Thought หรือวิธีค้นหาต้นไม้แบบ MCTS ทำให้การอนุมานเป็นเหมือนการระดมความคิดเชิงคำนวณ หนึ่งในประโยคที่ควรจดจำคือ “วันนี้ทักษะสำคัญของสถาปนิกคือการตั้งงบคำนวณให้แต่ละธุรกรรม” เพราะมันเปลี่ยนว่าเราจะใช้เอเจนต์อย่างมีวินัยหรือปล่อยให้มันคิดพร่ำเพรื่อ ด้าน context window ความเชื่อว่าขยายให้ใหญ่ขึ้นแล้วจบปัญหาความจำคือภาพลวงตาอันตราย ทางออกคือ GraphRAG สร้างหน่วยความจำภายนอกที่มีโครงสร้างเป็นกราฟ แล้วให้ LLM ทำงานกับข้อมูลเชื่อมโยงความแม่นสูง เราจึงส่งเข้า context แค่ราว 1,500 token ที่เป็นความเชื่อมโยงคมชัดแทนที่จะจมน้ำใน 100,000 token ที่เป็น noise การแยก “เครื่องคิด” LLM ออกจาก “เครื่องสถานะ” ที่เป็นสถาปัตยกรรม ทำให้ระบบตรวจสอบ ทดสอบ และ scale แบบเอ็นเตอร์ไพรส์ได้ ในหลายกรณี deterministic agent orchestration และสถาปัตยกรรมแบบนี้ช่วยเพิ่ม productivity ของ AI coding agents ได้เป็นเท่าตัว เพราะเราคุมเส้นทางการงานได้แทนที่จะหวังพึ่ง prompt engineering ที่แปรปรวน
Tiered agent rules Quality Gates และ Evals ที่ต้องมา “ก่อน” ไม่ใช่หลังระบบพัง
ปัญหาใหญ่สุดในการสร้าง production-ready AI systems คือทีมมักเริ่มด้วยการเขียนฟีเจอร์และ prompt จากนั้นค่อยวัดผลเมื่อระบบเริ่มพัง การข้ามขั้นประเมินคุณภาพเป็นหนึ่งในความผิดพลาดที่อันตรายที่สุดในงาน AI โปรดักชัน ทีมจำนวนมากเทเวลาหลายสัปดาห์ไปกับ retrieval pipeline กราฟเอเจนต์ และ memory layer แล้วใช้การคลิกดูผลแบบ “ความรู้สึก” วัดคุณภาพ ก่อนปล่อยระบบเมื่อมัน “ดูเหมือนใช้ได้” แนวทางที่ดีกว่าคือเขียน eval ก่อนฟีเจอร์ ตั้งชุดตัวอย่างทดสอบคุณภาพเล็ก ๆ แต่คุณภาพสูงราว 30–50 เคส แล้ววัดก่อนและหลังทุกการเปลี่ยนแปลงสถาปัตยกรรม ในฐานโค้ดเอง เราต้องสร้างสภาพแวดล้อมเอื้อต่อเอเจนต์ ถ้าอยากให้ AI tools มีประสิทธิภาพสูงสุด คุณต้องให้มันทำงานใน monorepo ที่เข้าถึง context ตรง มี micro frontend ที่ boundary ชัดและแตกไม่ง่าย และใช้ tiered AGENTS.md บังคับ conventions โดยไม่ทำให้หน้าต่าง context แน่นเกินไป การจัดเลเยอร์กฎแบบนี้ช่วยหยุด convention drift ที่ทำให้โค้ดแต่ละโมดูลพูดคนละภาษา พร้อมทั้งจับคู่กับ linter เข้มงวด เพื่อให้เอเจนต์ได้รับ feedback ทันทีเมื่อทำผิดกติกา ในระยะถัดไป เส้นทางของ enterprise AI ไม่ใช่รอ “คุณสมบัติ emergent มหัศจรรย์” แต่คือการดึงอำนาจการตัดสินใจกลับจากโมเดลมาอยู่ในโค้ดเชิงกำหนด เราต้องสร้าง Semantic Data Bus ให้ข้อมูลไหลอย่างมีความหมาย และเพิ่มเลเยอร์ควบคุมทีละชั้น วัดทุกครั้ง ถ้าไม่ดีขึ้นก็ย้อนกลับ เมื่อโครงสร้าง สภาวะแวดล้อม และประตูคุณภาพถูกตั้งแต่ต้น AI coding agents จะหยุดเขียนโค้ดเละ และกลายเป็นส่วนหนึ่งของระบบที่เชื่อถือได้ในโปรดักชัน