
ยุคใหม่ของ AI Coding Agents และคำจำกัดความของประตูทดสอบ
AI Coding Agents testing safety คือแนวคิดที่ให้ระบบทดสอบอัตโนมัติเป็นด่านควบคุมหลักในการปล่อยโค้ดที่สร้างโดย AI แทนการพึ่งแค่การอ่านรีวิวโค้ดของมนุษย์ เป้าหมายคือให้ทุกการเปลี่ยนแปลงต้องผ่านเกณฑ์ทดสอบเชิงโครงสร้าง เชิงพฤติกรรม และเชิงธุรกิจ ก่อนจะเข้าไปอยู่ในระบบจริง ลดความเสี่ยงจากโค้ดที่ดูเหมือนถูกต้องแต่ทำงานผิด และทำให้ทีมสามารถใช้ความเร็วของ AI agents ได้เต็มที่โดยไม่แลกกับความปลอดภัยของระบบและข้อมูลผู้ใช้
อาชีพวิศวกรรมซอฟต์แวร์เปลี่ยนไปมากในปีที่ผ่านมา จากเครื่องมือช่วยเขียนโค้ดเล็กน้อย กลายเป็นยุคที่งานส่วนใหญ่คือการสั่งและจัดการ AI coding agents หลายตัวให้ผลิตโค้ดพร้อมกันในปริมาณที่มากกว่าวิศวกรคนเดียวหลายเท่า แต่เมื่อฝั่งการผลิตโค้ดเร็วขึ้น ความจริงที่ตามมาคือทีมไม่สามารถทดสอบฟีเจอร์ได้เร็วเท่าความเร็วของกองทัพเอเจนต์ที่ยิง pull request เข้ามาเรื่อยๆ ทำให้หลายคนเริ่มลองให้เอเจนต์ช่วยทำ QA คลิกหน้าเว็บ กดปุ่ม ไล่ดูว่าฟีเจอร์ทำงานถูกต้องหรือไม่ ก่อนจะยอมให้โค้ดเข้า main branch
เมื่อเอเจนต์เขียนโค้ดให้ระบบเทรดเงินจริง 1,600 PR ทำไมแค่รีวิวโค้ดไม่พอ
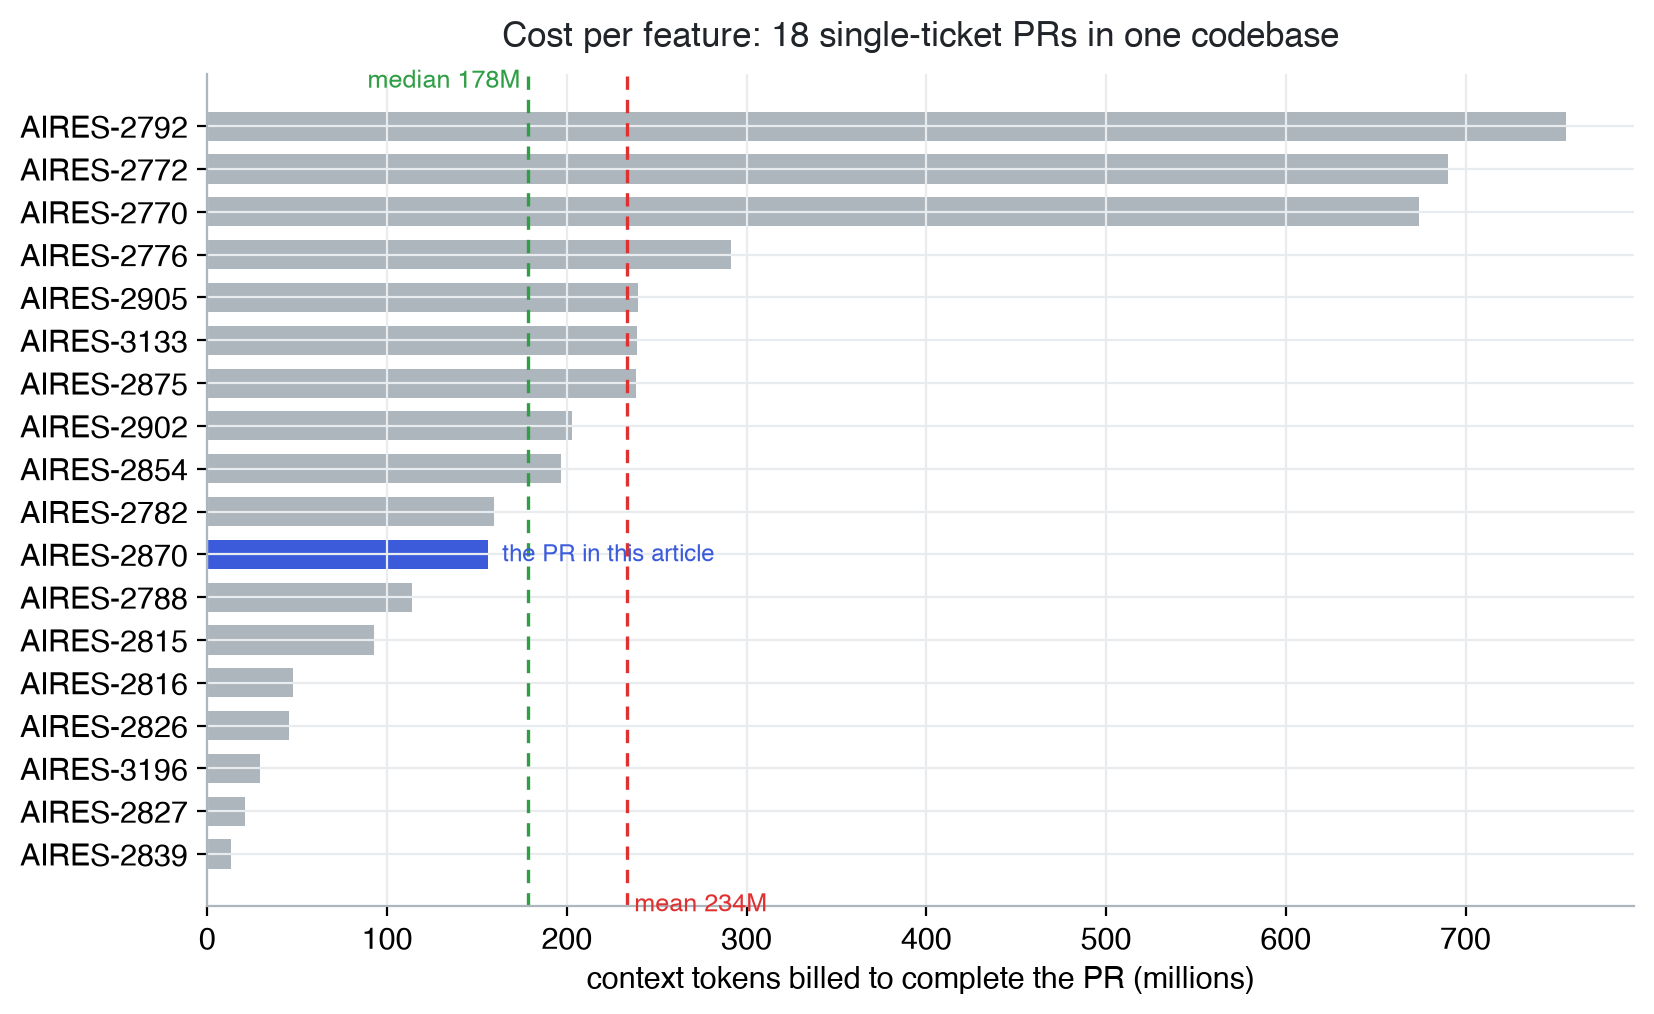
มีตัวอย่างที่ตรงที่สุดของ autonomous development risks คือระบบเทรดหุ้นอัตโนมัติชื่อ TopSet ที่ใช้เงินเจ้าของระบบเองและเทรดผ่าน broker API แบบสดบนโครงสร้างพื้นฐานที่เจ้าของถือเองทั้งชุด ในเวลา 21 เดือน เอเจนต์อย่าง Claude Code Cursor และ Copilot เขียนโค้ดส่วนใหญ่ รวมเป็นประมาณ 1,600 pull requests ซึ่งมากกว่าสิ่งที่วิศวกรคนเดียวจะพิมพ์ทันภายในเวลามากกว่านี้สามเท่า นี่คือคำยืนยันที่อ้างอิงได้ว่า "ภายใน 21 เดือน AI agents สร้าง pull request ประมาณ 1,600 ครั้งในระบบเทรดเงินจริงหนึ่งระบบ"
เมื่อโค้ดส่วนใหญ่เกิดจากเอเจนต์ เจ้าของระบบมีทางเลือกสองทางที่ล้มเหลวทั้งคู่ อ่านทุกบรรทัดแล้วช้ากว่าเขียนเอง หรืออ่านผ่านๆ แล้วปล่อยให้โค้ดที่ดูดีแต่ผิดลงระบบ ซึ่งในระบบที่สั่งออเดอร์เงินจริง ตัวเลือกหลังลงเอยด้วยการทำเทรดที่ไม่ตั้งใจแน่ๆ ดังนั้นเขาจึงเลือกทางที่สาม คือให้สิ่งอื่นนอกจากสมาธิของตัวเองเป็นตัวตัดสินว่าอะไรจะถูกปล่อย โดยนิยามว่า "Tests became the gate" ไม่มีอะไรถูก merge หรือ deploy หาก build ยังไม่เขียว และการอ่านของเขาขยับขึ้นไปอยู่ระดับดีไซน์ ความครอบคลุมของเทสต์ และผลลัพธ์สำคัญบางอย่างเท่านั้น
เมื่อ green build หลอกเรา สามบทเรียนจากระบบเทรดเงินจริง
การใช้ automated code review gates แบบเข้มข้นไม่ได้แปลว่าปลอดภัยสมบูรณ์ เจ้าของ TopSet ยอมรับตรงๆ ว่ามีอย่างน้อยสามครั้งที่ green build โกหกเขา และแต่ละกรณีเกิดในโลกจริงของระบบเทรดนี้เอง นี่คือด้านมืดของการฝากชีวิตไว้กับการทดสอบอัตโนมัติ หากนิยามของเทสต์ไม่ตรงกับความเป็นจริง ระบบก็จะยืนยันอย่างมั่นใจว่าโค้ดปลอดภัย ทั้งที่ความเสี่ยงยังซ่อนอยู่
ตัวอย่างหนึ่งคือเทสต์ไปยืนยันธรรมเนียมปฏิบัติที่ไม่มีอยู่จริง ทำให้ผ่านแบบไม่โดนจับผิด อีกกรณีคือเทสต์ผ่านบนค่า NaN ซึ่งในระบบการคำนวณถือว่าอันตรายมาก ประโยคที่ควรจำคือ เมื่อเอเจนต์เป็นคนเขียนแพตช์ การที่เราอ่านแล้วรู้สึกว่า "ดูถูก" เป็นสัญญาณที่น่าเชื่อถือน้อยที่สุด เพื่ออุดช่องว่างนี้ เขาให้เอเจนต์ช่วยเขียนสคริปต์รายงาน 161 ตัว ที่ดึงข้อมูล pipeline ออกมาเป็น CSV แล้วเขาเปิดสเปรดชีตตรวจเลขทีละชุด ตรวจผลตอบแทนต่อเทรด ค่าเลื่อนราคา และตัวเลขต่อปีด้วยมือ พร้อมสุ่มเช็กราคาต้นทางจากโฟลเดอร์ข้อมูลดิบ
จากรีวิวโค้ดสู่โครงสร้างการทดสอบคือกลไกควบคุมหลักของระบบอัตโนมัติ
หัวใจของบทเรียนนี้คือ ในโลกของ AI agents การทดสอบและโครงสร้างพื้นฐานการทดสอบกลายเป็น primary control mechanism แทนที่จะเป็น code review แบบเดิม เพราะเมื่อเอเจนต์ผลิตโค้ดจำนวนมาก ต่อให้ใช้รีวิวโค้ดมนุษย์อย่างเข้มข้นก็รับไม่ไหว เจ้าของ TopSet จึงตั้งกฎตายตัวว่าทุก pull request ต้องผ่านชุดทดสอบเต็มรูปแบบ ตั้งแต่ lint และ type checking ด้วย ruff และ mypy ไปจนถึงชุดเทสต์ประมาณ 7,500 ตัวที่กระจายอยู่ใน 331 โมดูลการทดสอบ การยืนยันว่า test database ว่างหลังรันเทสต์ การ rollback และ reapply migration ย้อนกลับไปถึงฐาน และ terraform validate กับบัญชี AWS ทั้งสองชุด ถ้าขั้นตอนไหนล้มเหลว การ merge จะไม่เกิดขึ้น และ build ถูกนิยามว่าคือ merge gate ที่ไม่ใช่คำแนะนำแต่เป็นกฎบังคับ
ในระดับ production system testing ยังมีชุดหนักประจำสัปดาห์ที่เข้มกว่า คือการรันกระบวนการ rebalance แบบ end-to-end สองครั้งกับ mock broker การรัน integration test เดิมซ้ำ 100 รอบเพื่อไล่หาความไม่เสถียร การรัน model-training snapshot แบบ deterministic เก้าชุดใน Docker และการเช็ก leakage สองครั้งใน training pipeline เจ้าของระบบสรุปชัดว่า weekly gate นี้มีไว้เพราะเกตที่หลุดบ้างไม่เสถียร แย่กว่าการไม่มีกำแพงเลยในระบบที่มี autonomous development risks สูง
ทำให้เอเจนต์ทดสอบได้ฉลาดขึ้นด้วยแผนที่ผลิตภัณฑ์และโครงสร้าง QA
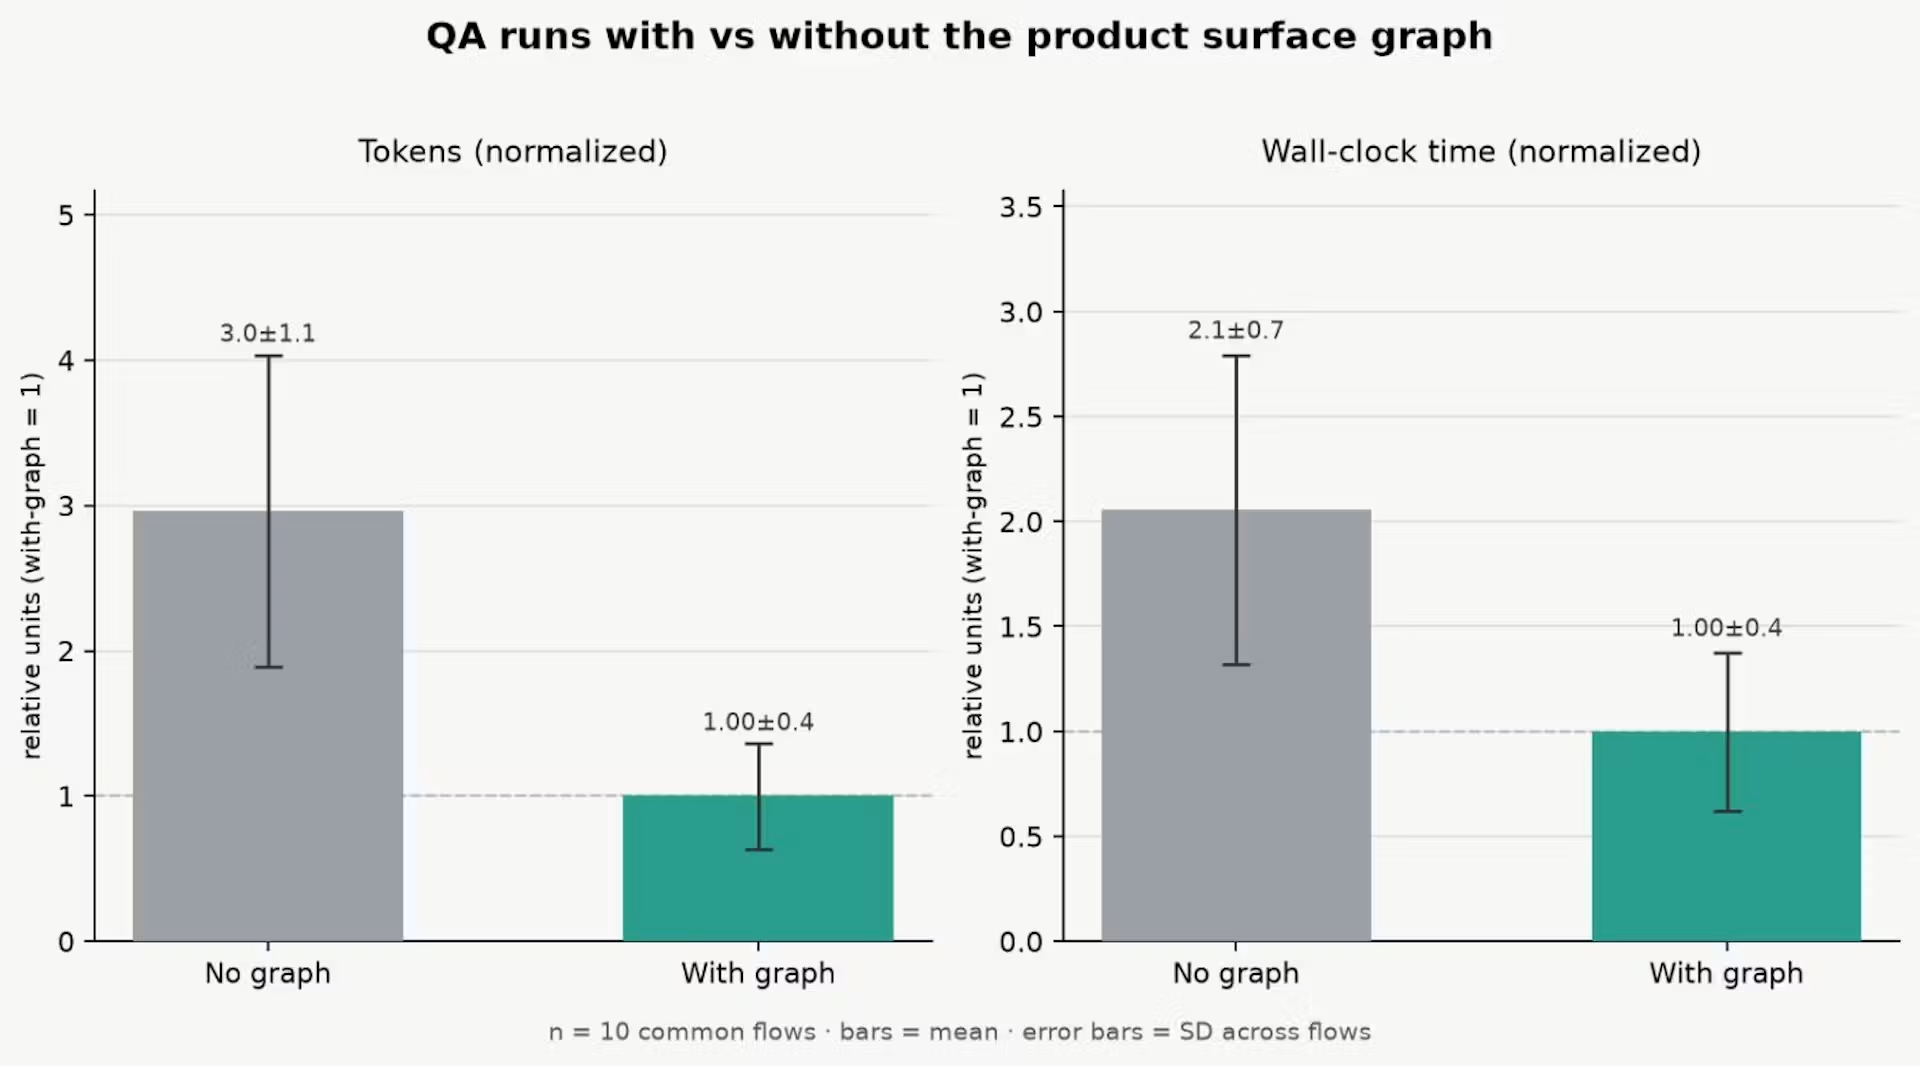
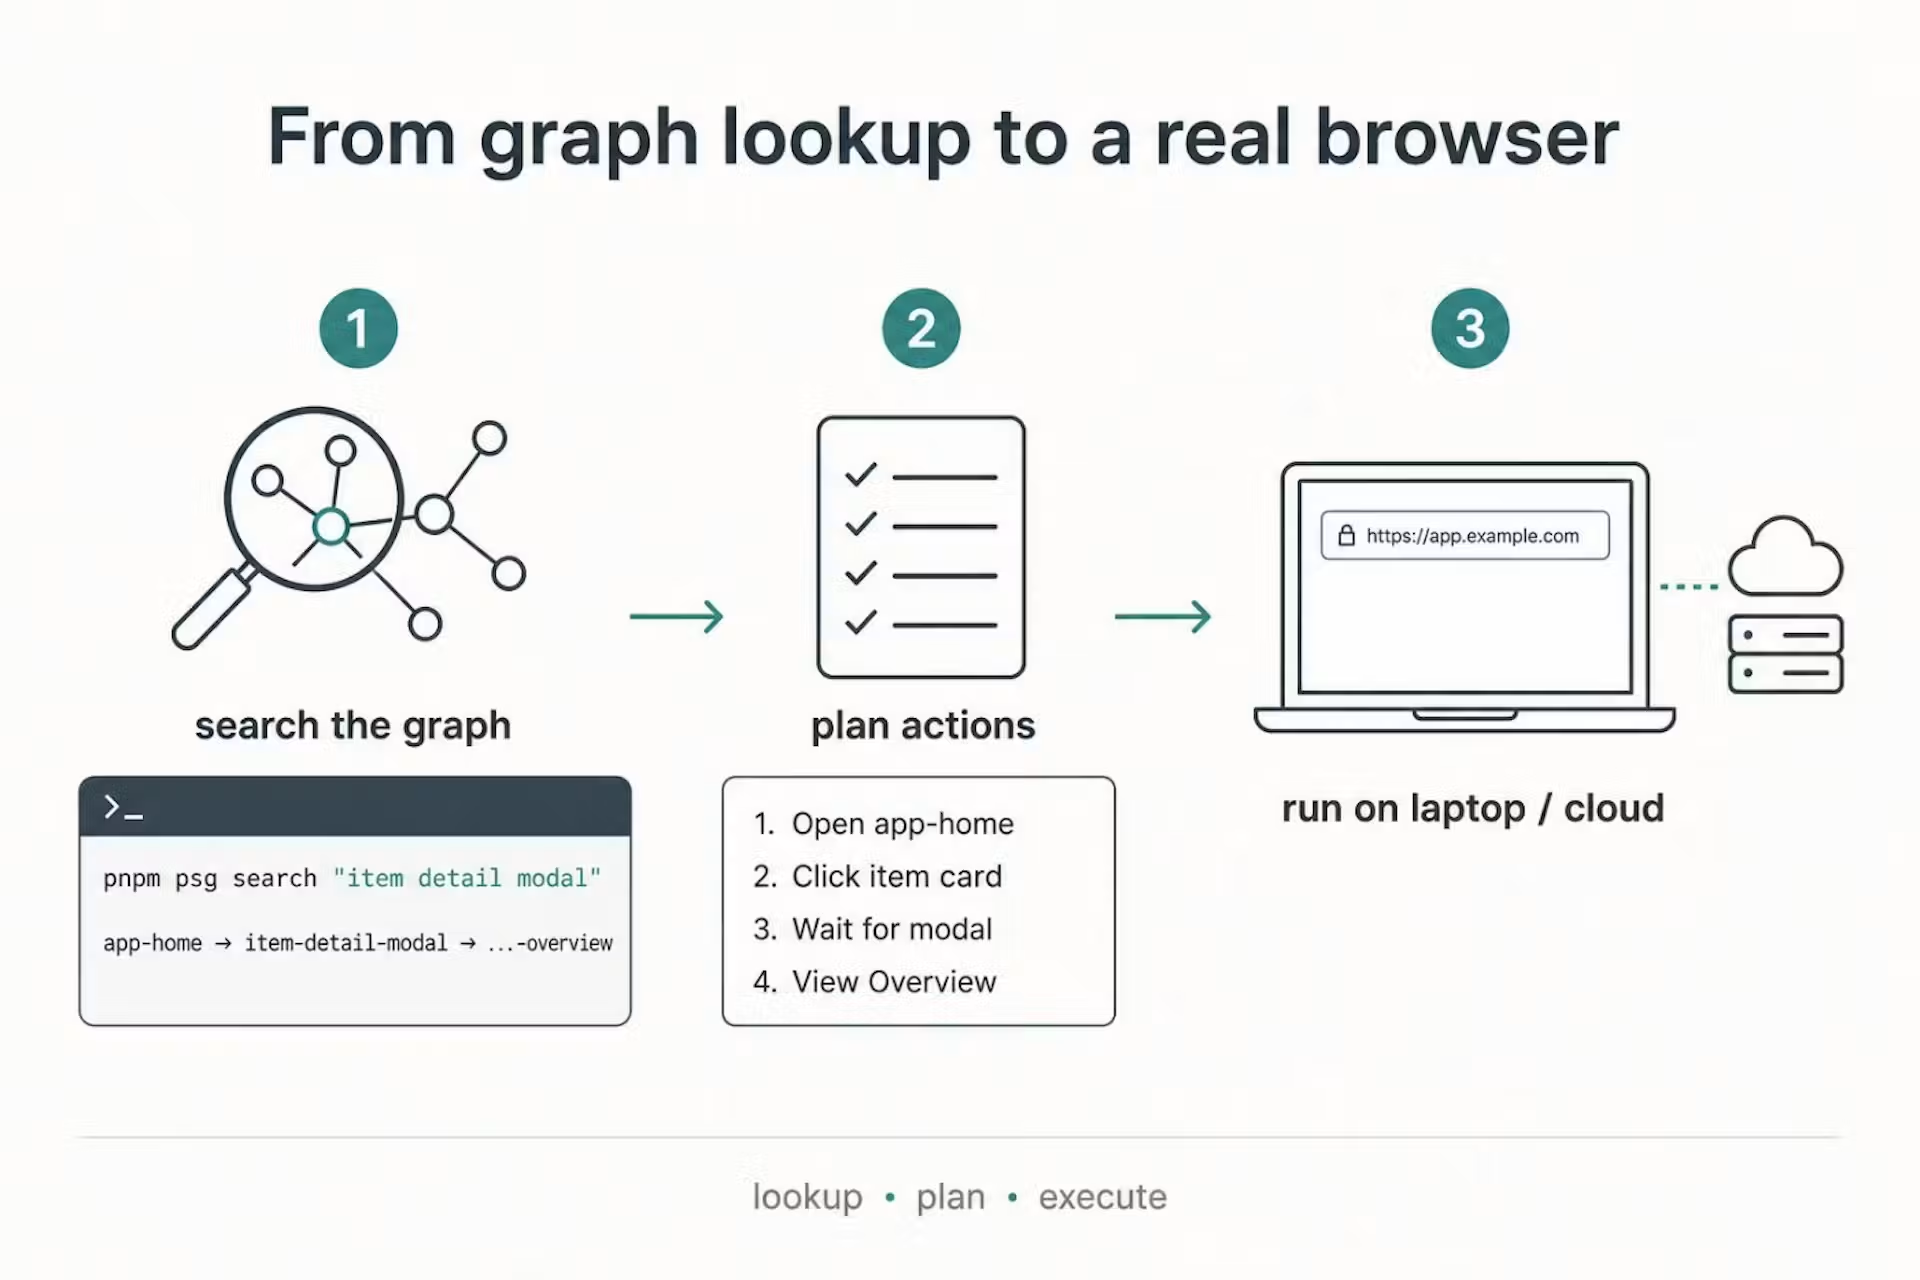
ในฝั่งแอปพลิเคชันที่ซับซ้อนอย่างมาร์เก็ตเพลสออนไลน์ที่มีหลาย persona ทั้งฝั่งลูกค้า ฝั่งแอดมิน ระบบรายงาน และเครื่องมือภายในสำหรับปฏิบัติการ เอเจนต์ต้องรู้ว่าอะไรอยู่ตรงไหน ใครใช้อะไร และเวิร์กโฟลว์เป็นอย่างไร วิศวกรคนหนึ่งเริ่มจากให้เอเจนต์ทำ QA ผ่าน Playwright MCP เชื่อมกับ Claude Code เพื่อคลิกทดสอบฟีเจอร์ทุกตัวเหมือนที่เขาเคยทำเองด้วยมือ แต่พบว่าเอเจนต์เสียเวลามากไปกับการ "ค้นพบ" หน้าเดิมซ้ำๆ เปิดหน้า ถ่ายภาพหน้าจอ ทำความเข้าใจ แล้วค่อยคลิกหรือกรอกข้อมูลใหม่ทุกครั้ง ทำให้เปลืองทั้งโทเคนและเวลา
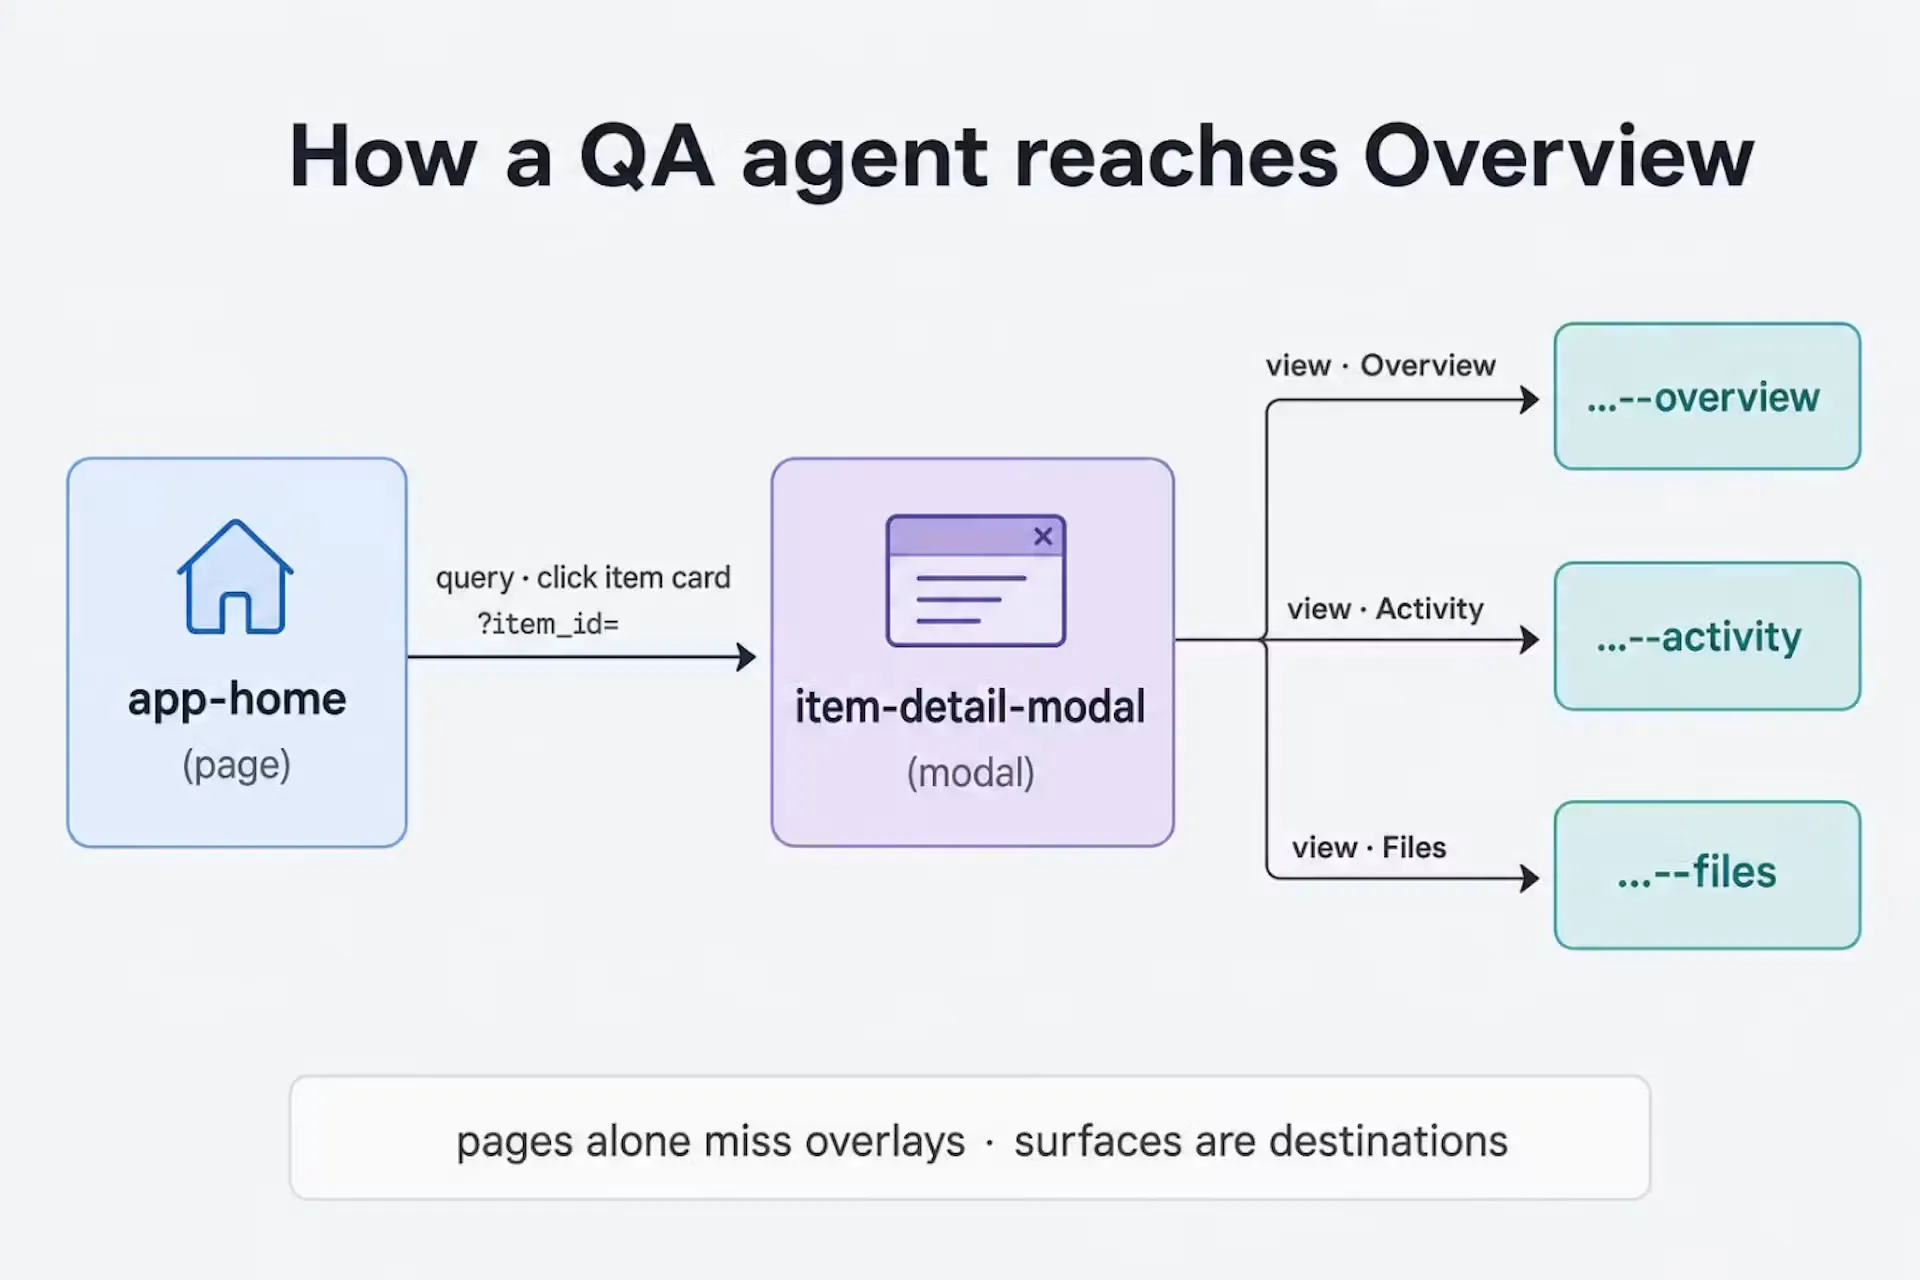
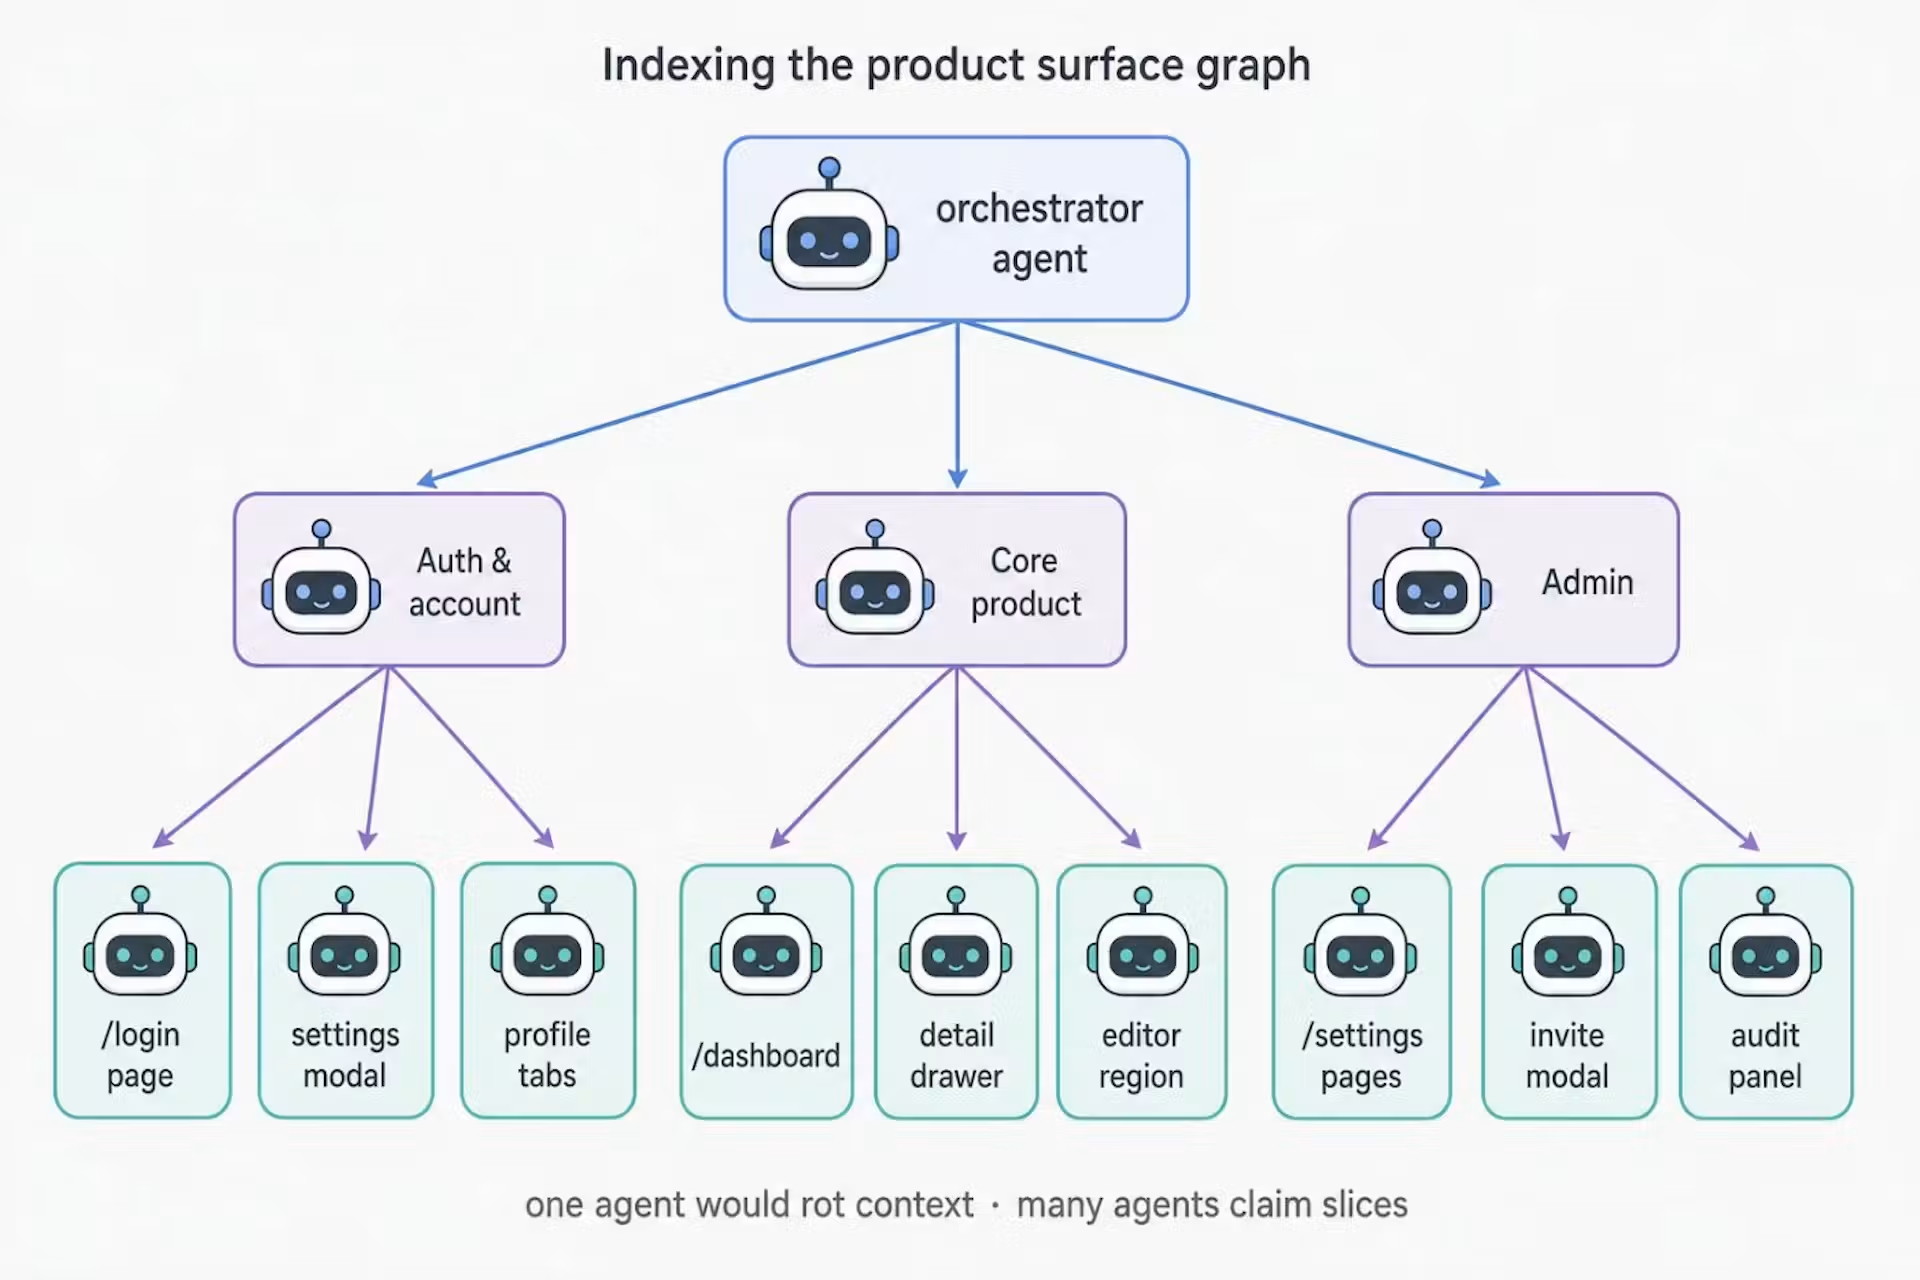
เขาจึงสร้างสิ่งที่เกินกว่า AI agents testing safety แบบดิบๆ ขึ้นมา คือเริ่มจาก Feature Maps ที่อธิบายการทำงานของแต่ละฟีเจอร์เป็น markdown แล้วผูกเป็น /verification-skill ให้เอเจนต์เรียกใช้ได้ในรอบถัดไป จากนั้นต่อยอดไปเป็น knowledge graph ที่เก็บภาพรวมว่าผลิตภัณฑ์ทำงานอย่างไร หน้าไหนอยู่ตรงไหน ผู้ใช้ต่างบทบาทเดินทางในระบบอย่างไร และต้องผ่านเวิร์กโฟลว์อะไรบ้าง ผลคือเอเจนต์ที่เคยใช้เวลา 25 นาทีในการทดสอบฟีเจอร์ที่ต้องคลิกหลายหน้าลดเหลือ 15 นาที โดยยังทดสอบได้ครบเหมือนเดิม งานวิจัยในสายนี้ชี้ตรงกันว่าการนำทางผลิตภัณฑ์ให้ได้ผลต้องมีมากกว่าความฉลาดของเอเจนต์ แต่ต้องมีแผนที่ให้มันใช้วางเส้นทางและการกระทำด้วย