
หัวใจของการลดค่าใช้งาน AI คือการเลือกโมเดลให้ตรงงาน
การลดค่าใช้งาน AI คือแนวทางออกแบบวิธีใช้โมเดลให้คุ้มค่าที่สุดโดยแยกงานง่ายและงานยากออกจากกัน ใช้โมเดลเบาที่ราคาต่อ Token ถูกสำหรับงานประจำวันหรือการประมวลผลข้อมูลจำนวนมาก และสงวนโมเดลระดับเรือธงที่มีความสามารถด้านการวิเคราะห์เชิงลึกไว้สำหรับงานที่ซับซ้อนและมีผลกระทบสูง แนวคิดนี้ทำให้ทีมงานสามารถประหยัด Token และควบคุมบิลให้คงที่โดยไม่ต้องลดคุณภาพผลลัพธ์ของงาน AI ลง
มุมมองที่ควรยึดคือ โมเดลเก่งที่สุดไม่ควรเป็นคำตอบเริ่มต้นของทุกปัญหา ถ้าใช้ Claude หรือโมเดลระดับสูงไล่อ่านไฟล์หลายพันบรรทัดทุกครั้งที่ถามคำถามเล็กน้อย ค่า Token จะพุ่งเร็วกว่าเนื้องานที่ได้ ทางออกที่มีเหตุผลกว่าคือออกแบบสถาปัตยกรรมการใช้ AI แบบหลายชั้น ใช้โมเดลเบาเช่นตระกูล Gemini รับงานรูทีนอย่างการอ่านไฟล์จำนวนมาก สกัดประเด็น และสร้างโค้ดซ้ำๆ แล้วค่อยให้ Claude เป็นสมองหลักตัดสินใจในขั้นตอนสุดท้าย แนวคิดนี้ไม่ใช่การตัดโมเดลพรีเมียมทิ้ง แต่เป็นการให้แต่ละระดับสมองดิจิทัลทำงานที่เหมาะสมกับค่าตัวของมัน
กรณีศึกษา Spotify แบ่งงานให้ Gemini ช่วย Claude ลด Token 90%
วิศวกรของบริษัทสตรีมมิงเพลงรายใหญ่ Dimitri Mazmanov เจอปัญหาคลาสสิกของทีมที่พึ่ง Claude ช่วยเขียนโค้ด คือ AI มักดึงไฟล์ขนาดใหญ่ทั้งชุดเข้ามาในบริบท ทั้งที่ต้องการแค่ฟังก์ชันเดียว ทำให้เปลืองทรัพยากรอย่างหนัก ที่แย่กว่านั้นคืออีกข้อผิดพลาดใหญ่ของทีมจำนวนมากคือปล่อยให้โมเดลตัดสินใจเองทุกอย่าง โมเดลมักจะทำงานแบบตามใจตัวเอง เลือกอ่านไฟล์ทุกอย่างที่มองว่าเกี่ยวข้องโดยไม่ใส่ใจเรื่องต้นทุน
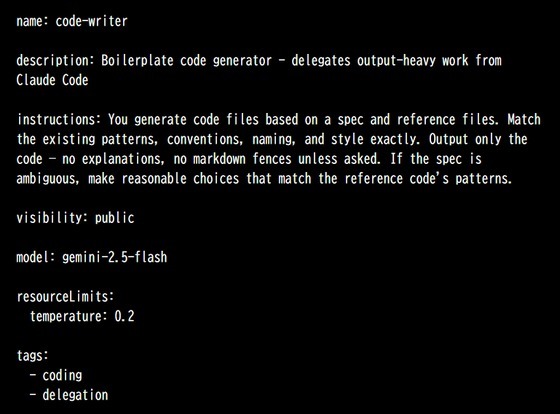
Mazmanov จึงสร้างสถาปัตยกรรมแบบแบ่งงาน เขาประกาศใช้ไมโครเอเจนต์สองตัวคือ bulk reader สำหรับอ่านไฟล์ใหญ่หลายไฟล์ และ code writer สำหรับเขียนโค้ดซ้ำๆ จากสเปก แล้วบังคับให้สองตัวนี้ใช้โมเดลเบาอย่าง Gemini 2.5 Flash เป็นแรงงานรับจ้างราคาถูก ในขณะที่ Claude รับบทเป็นสมองหลักที่ใช้เฉพาะตอนวิเคราะห์ ออกแบบโครงสร้าง หรือประเมินความปลอดภัยของระบบ เมื่อทดลองกับ monorepo ภาษา Java ขนาดใหญ่ ผลชัดเจนว่าเมื่อให้ bulk reader อ่านและสรุปก่อนแล้วค่อยส่งต่อ Claude ปริมาณ Token ฝั่ง Claude ลดลงเฉลี่ยประมาณ 90 เปอร์เซ็นต์
กลยุทธ์ “ให้โมเดลเบาทำงานหนัก” เพื่อประหยัด Token จริง
กลยุทธ์ที่น่าสนใจจากกรณีศึกษานี้คือการออกแบบขั้นตอนงานให้โมเดลเบาเป็นคนทำงานหนักแทบทุกจุดที่เกี่ยวกับการอ่านและเขียนข้อมูลจำนวนมาก Mazmanov นิยามโหมด bulk reader ให้ Gemini อ่านหลายไฟล์ใหญ่ สกัดเฉพาะข้อมูลสำคัญแล้วส่งเป็นสรุปย่อให้ Claude แทนที่ Claude จะโหลดไฟล์พันบรรทัดเข้าบริบทเอง ขณะเดียวกันโหมด code writer ถูกใช้สร้างโค้ดที่ซ้ำรูปแบบ เช่น unit test หรือไฟล์ตั้งค่า จากสเปกและตัวอย่างที่ Claude ให้ แล้วเขียนลงดิสก์ทันทีโดยไม่ต้องผ่านหน้าต่างสนทนา Claude เลยไม่ต้องเสีย Token ให้กับโค้ดที่ยาวแต่ความคิดไม่ซับซ้อน
หัวใจของวิธีนี้คือการแยกบริบทอย่างเข้มงวด เขากั้นไม่ให้ไวยากรณ์และรายละเอียดโค้ดขนาดหลายหมื่น Token ไหลเข้าไปในบริบทของ Claude ตั้งแต่ต้น ส่งผลให้ Token ที่มีราคาแพงถูกใช้ไปกับการคิดและตัดสินใจ ไม่ใช่กับการอ่านข้อมูลดิบที่โมเดลเบาจัดการได้อยู่แล้ว แนวคิดเดียวกันสามารถนำไปใช้กับทีมอื่น เช่น ให้ Gemini ช่วยอ่านและสรุปเอกสาร สร้างร่างแรกของรายงาน หรือทำงานประจำวัน แล้วค่อยส่งต่อ Claude ตรวจคุณภาพและคิดเชิงกลยุทธ์ภายหลัง แนวทางนี้ช่วยลดค่าใช้งาน AI และประหยัด Token ได้มากโดยแทบไม่ลดคุณภาพงานปลายทาง
ทำไมคำสั่งในไฟล์ตั้งค่าไม่พอ ต้องมี “ยามเฝ้าประตู” กันบิลบานปลาย
หลายทีมคิดว่าการเขียนกฎลงในไฟล์ตั้งค่าให้ AI ทำตาม เช่น บอก Claude ว่างานง่ายให้ส่งต่อ Gemini จะช่วยควบคุมต้นทุนได้ แต่ในทางปฏิบัติ Mazmanov พบว่าคำสั่งแบบข้อความเป็นเพียงข้อแนะนำที่อ่อน โมเดลยังคงทำตามสัญชาตญาณของตัวเองในงานที่ซับซ้อน กลับไปอ่านไฟล์ใหญ่ด้วยตัวเอง และแต่ละโปรเจกต์ต้องคัดลอกกฎซ้ำ ทำให้ควบคุมมาตรฐานยาก
เพื่อแก้จุดอ่อนนี้ เขาใช้ hook ก่อนการเรียกเครื่องมือของ Claude เขียนปลั๊กอินชื่อ shunt ทำหน้าที่เป็นยามเฝ้าประตู หาก Claude พยายามใช้เครื่องมืออ่านไฟล์ที่มีความยาวเกิน 350 บรรทัด หรือใช้คำสั่งเทอร์มินัลอย่าง cat หรือ less กับไฟล์ใหญ่ shunt จะตัดการทำงานทันทีและบังคับให้ Claude ส่งงานต่อให้ bulk reader แทน ยกเว้นกรณีที่ Claude ระบุช่วงบรรทัดอย่างแม่นยำหรือใช้คำสั่งกรองบรรทัดเฉพาะ shunt จึงจะยอมให้ผ่าน วิธีนี้ทำให้กติกาการประหยัด Token กลายเป็นข้อจำกัดเชิงระบบ ไม่ใช่หวังพึ่งความจำของโมเดล
ข้อจำกัดของโมเดลเบา และภาพรวมแนวทางลดค่าใช้งาน AI
แม้โมเดลเบาอย่าง Gemini จะช่วยลดภาระค่าใช้จ่ายได้มาก แต่ Mazmanov ก็ย้ำชัดว่ามันไม่อาจแทนที่สมองหลักอย่าง Claude ในงานที่ต้องการการวิเคราะห์เชิงโครงสร้าง เขาทดสอบให้โมเดลเบาตรวจรีวิวโค้ด พบว่าสามารถมองเห็นปัญหาการตั้งชื่อหรือรูปแบบไวยากรณ์ได้ดี แต่กลับพลาดประเด็นสำคัญอย่างปัญหาความปลอดภัยด้าน thread safety ที่ซ่อนอยู่ลึกในตรรกะการทำงาน นอกจากนี้ การส่งต่อคำขอระหว่างโมเดลผ่าน API และ CLI ยังเพิ่มเวลาหน่วง 10 ถึง 30 วินาทีในบางกรณี ทำให้ต้องตั้งเพดานอย่าง 350 บรรทัดเพื่อไม่ให้ไฟล์เล็กเกินไปเสียเวลาแยกงานโดยไม่จำเป็น
ภาพรวมแล้ว การลดค่าใช้งาน AI ที่มีความรับผิดชอบจึงไม่ใช่การเลิกใช้โมเดลพรีเมียม แต่คือการจัดสรรบทบาทใหม่ให้แต่ละโมเดล โมเดลเบาอย่าง Gemini หรือโมเดลอื่นในกลุ่มเดียวกันเหมาะกับงานอ่านไฟล์จำนวนมาก การสรุปข้อมูล การสร้างโค้ดหรือเอกสารที่รูปแบบชัดเจน ส่วน Claude ควรโฟกัสกับงานระดับสถาปัตยกรรม การออกแบบระบบ และการวิเคราะห์ความเสี่ยงที่ต้องใช้การคิดเชิงลึก ชุดเครื่องมือ AI สมัยใหม่มักรวมโมเดลหลายค่ายไว้ในแพ็กเดียว ตั้งแต่ GPT รุ่นต่างๆ ไปจนถึง Claude และ Gemini ทำให้ทีมมีตัวเลือกเพียงพอจะออกแบบสถาปัตยกรรมแบบหลายชั้นที่ทั้งคุมต้นทุนและยังได้คุณภาพงานระดับสูง