
โมเดลเล็กที่รับช่วงงานซ้ำ
Meta Muse Ember คือโมเดล AI ขนาดเล็กที่สุดของ Meta ที่ออกแบบมาให้ AI Agent ทำงานย่อยซึ่งมีขั้นตอนชัดเจนและเกิดซ้ำได้ ตั้งแต่เรียกใช้เครื่องมือ ดึงข้อมูล ไปจนถึงช่วยเขียนโค้ด โดยเน้นลดภาระจากการส่งทุกงานไปยังโมเดลขนาดใหญ่ Meta AI Research เปิดตัวโมเดลนี้เมื่อวันที่ 9 พฤศจิกายน 2026 และวางตำแหน่งให้เหมาะกับงานเอเจนต์และการเขียนโค้ดซ้ำ ๆ มากกว่าการแก้ปัญหาซับซ้อนทุกประเภท[ ] แนวคิดนี้มีเหตุผลเชิงปฏิบัติ: Meta ระบุว่าเอเจนต์ใช้โทเค็นส่วนใหญ่ไปกับขั้นตอนย่อยที่มีโครงสร้าง เช่น การอ่านไฟล์ รันทดสอบ และแก้โค้ดเฉพาะจุด หากงานส่วนใหญ่เป็นกิจวัตร การใช้โมเดลที่ปรับมาเพื่อรับช่วงเหล่านี้อาจช่วยให้ระบบอัตโนมัติไม่ใช่เครื่องมือราคาแพงที่จำกัดอยู่กับงานทดลองอีกต่อไป

จุดขายคือให้โมเดลใหญ่คิด โมเดลเล็กลงมือ
บทบาทของ Ember ชัดขึ้นเมื่อมองคู่กับ Muse Wonder: Meta เสนอให้ Wonder วางแผนสำหรับปัญหาที่ยาก แล้วให้ Ember จัดการงานย่อยซ้ำ ๆ ในวงกว้าง[ ] สำหรับนักพัฒนา วิธีแบ่งงานเช่นนี้อาจลดการเรียกโมเดลที่มีความสามารถสูงกว่าในทุกขั้นตอน และทำให้ AI ช่วยเขียนโค้ดทำงานอยู่เบื้องหลังได้ต่อเนื่อง ตั้งแต่เปิดไฟล์ไปจนถึงตรวจผลและแก้ไขจุดเล็ก ๆ ประโยชน์ไม่ได้จำกัดอยู่ที่โค้ด Ember รองรับข้อความ ภาพ เสียง และวิดีโอ จึงอาจอ่านภาพหน้าจอ แผนภูมิ เอกสารสแกน หรือบันทึกการประชุมได้โดยไม่ต้องส่งต่อให้โมเดลอีกตัว อีกทั้งมีหน้าต่างบริบทขนาด 1 ล้านโทเค็น ซึ่ง Meta ระบุว่ารองรับโค้ดเบสหรือชุดเอกสารทั้งชุดในการเรียกครั้งเดียว แนวทางเฉพาะทางนี้มีโอกาสทำให้การทำงานอัตโนมัติเข้าถึงได้ง่ายขึ้น แต่ความคุ้มจริงยังขึ้นกับความแม่นยำและการควบคุมการกระทำของเอเจนต์
ผลทดสอบเด่น แต่ไม่ได้ชนะทุกงาน
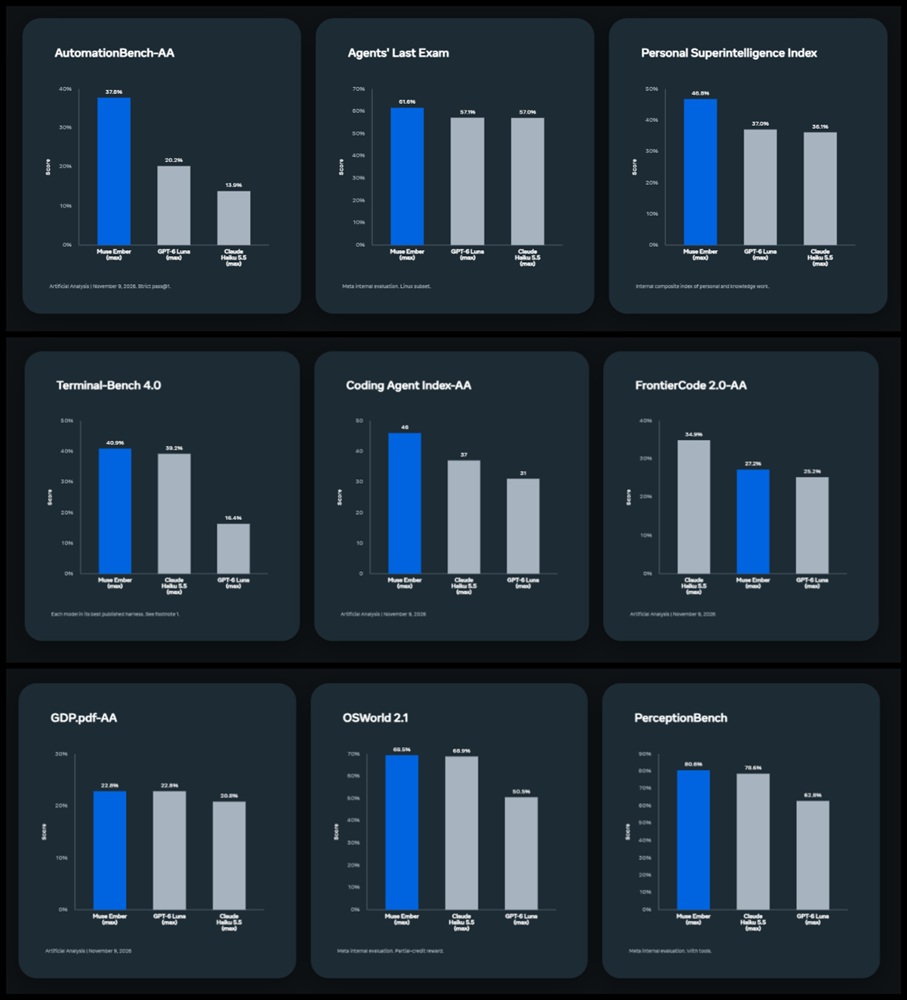
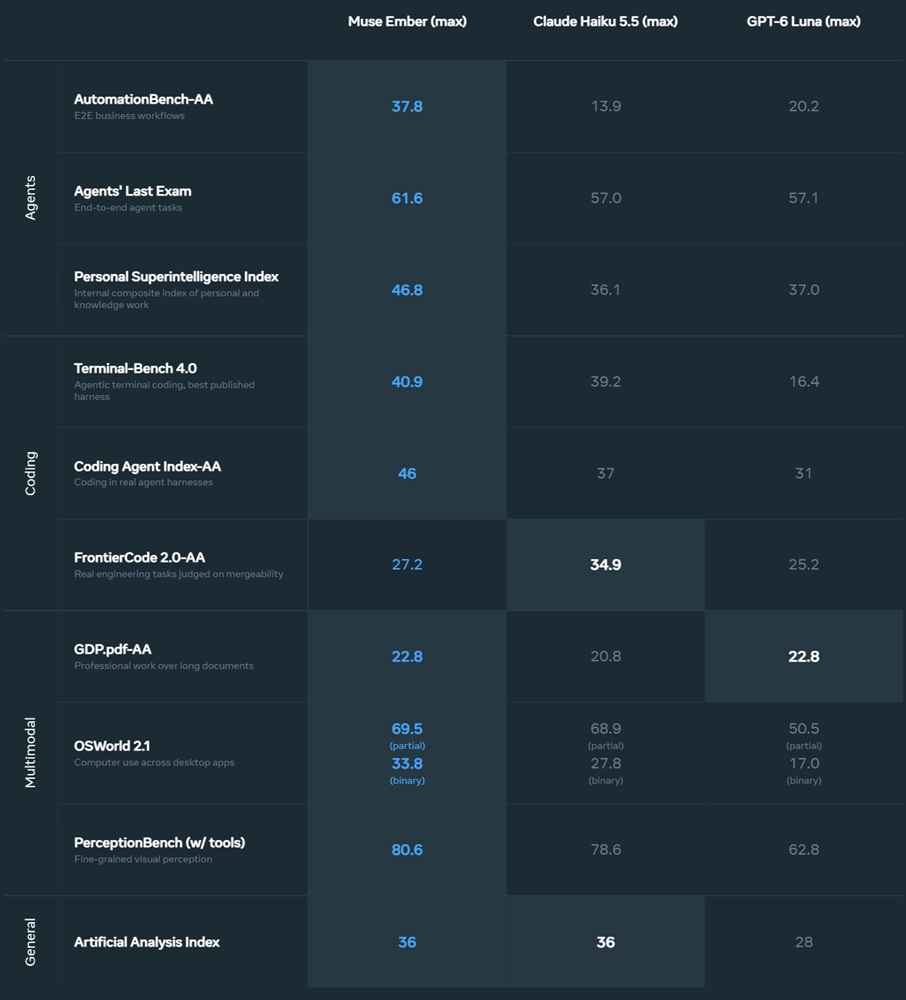
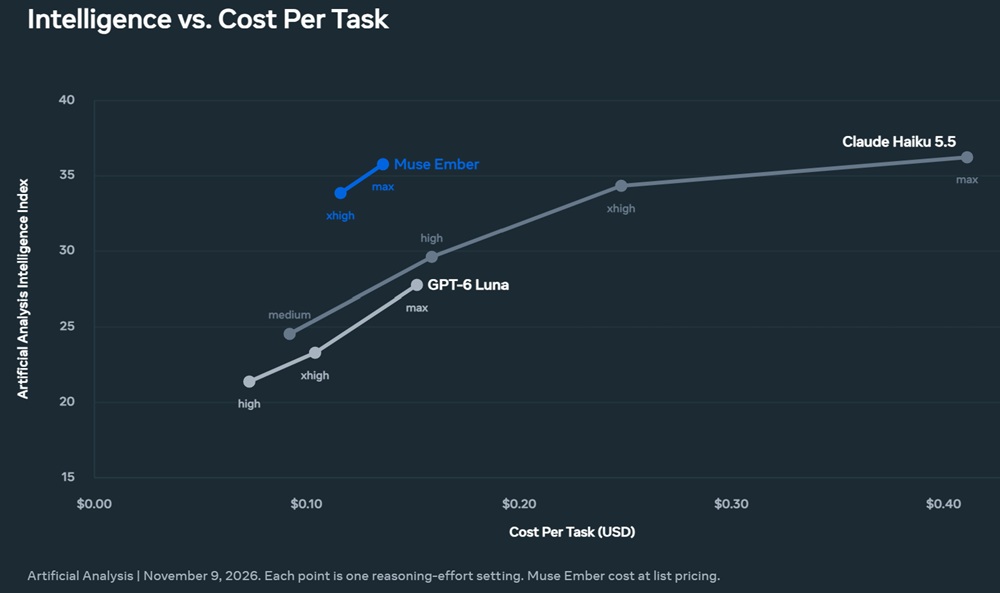
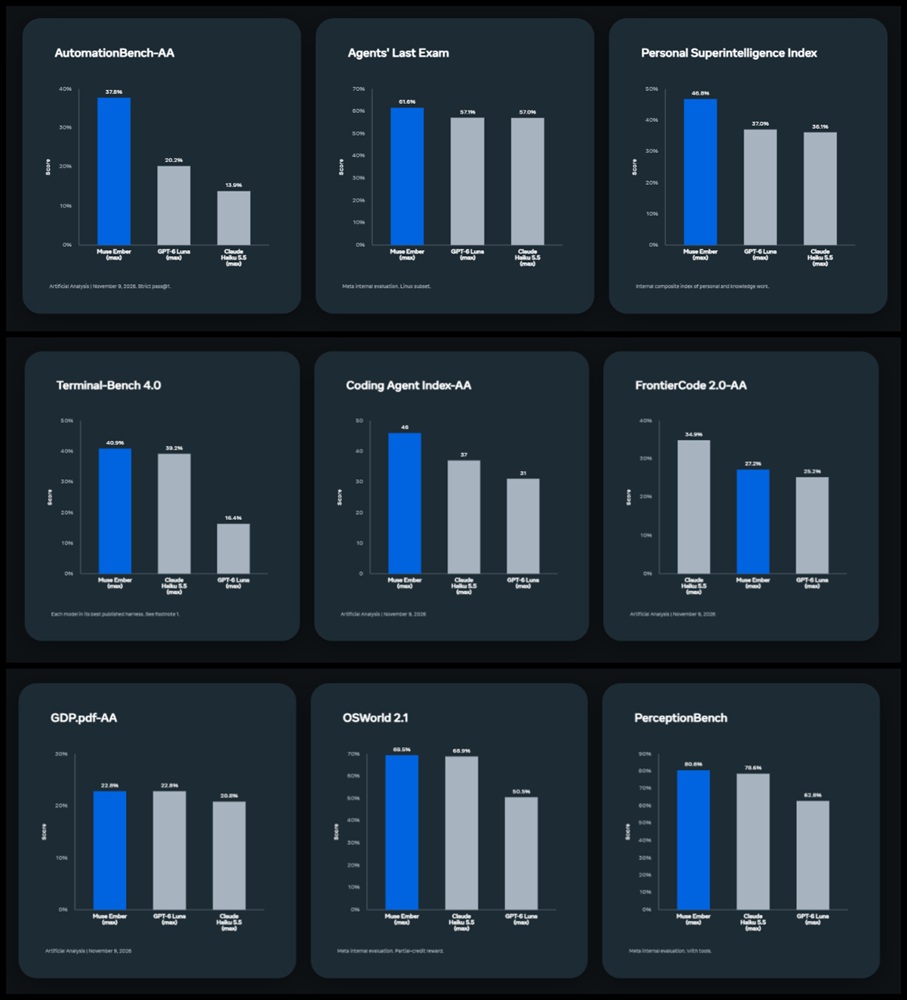
ตัวเลขที่ Meta ยกมาสนับสนุนภาพของโมเดลที่แลกความสามารถบางส่วนกับต้นทุนที่ต่ำลง โดย Ember ได้คะแนน 36 ใน Artificial Analysis Intelligence Index เทียบกับ Muse Spark 1.3 ที่ได้ 37 ขณะที่การประเมินค่าใช้จ่ายต่อภารกิจที่อ้างในแหล่งข้อมูลอยู่ที่ 0.14 ดอลลาร์สำหรับ Ember และ 2.39 ดอลลาร์สำหรับ Spark 1.3 ตัวเลขนี้เป็นการประเมินตามราคาที่ Meta ประกาศ ไม่ใช่หลักประกันว่าทุกองค์กรจะได้ผลลัพธ์เหมือนกัน ผลทดสอบงานเอเจนต์บางรายการของ Ember สูงกว่าคู่เทียบที่นำมาแสดง เช่น AutomationBench-AA ได้ 37.8% และ Coding Agent Index-AA ได้ 46 แต่ภาพไม่ได้เป็นผู้ชนะทุกด้าน ใน FrontierCode 2.0-AA ซึ่งวัดงานวิศวกรรมจริงและการรวมโค้ดเข้ากับโครงการ Claude Haiku 5.5 ได้ 34.9% ขณะที่ Ember ได้ 27.2% จึงควรมองคะแนนเอเจนต์ที่ดีเป็นหลักฐานของความเหมาะกับงานบางชนิด ไม่ใช่ข้อสรุปว่า Ember เหนือกว่าในงานพัฒนาซอฟต์แวร์ทั้งหมด
ใช้งานได้แล้ว แต่การประเมินจริงยังสำคัญ
Meta เปิดให้ใช้ Ember ผ่าน Muse Code และ Meta Model API ในชื่อ muse-ember-1.0 แล้ว พร้อมรองรับ Responses API[ ] บริษัทระบุว่าได้ประเมินความเสี่ยงด้านเคมีและชีวภาพ ความมั่นคงปลอดภัยทางไซเบอร์ และการสูญเสียการควบคุม รวมถึงทดสอบว่าโมเดลเคารพเจตนาผู้ใช้ ปกป้องข้อมูลละเอียดอ่อน และขอความเห็นจากมนุษย์ก่อนดำเนินการที่มีผลกระทบสูง อย่างไรก็ตาม ผลประเมินของบริษัทเองและการทดสอบระยะแรกจากพันธมิตรยังไม่แทนประสบการณ์ใช้งานจริงในระบบที่มีข้อมูลและขั้นตอนหลากหลาย องค์กรที่กำลังพิจารณาควรทดสอบกับงานของตน โดยดูอัตราความผิดพลาด เวลาที่ต้องให้คนตรวจ และความสามารถในการหยุดเมื่อเจอคำสั่งที่ซ่อนอยู่ในเอกสารหรือผลจากเครื่องมือ Meta ระบุว่ากำลังฝึกโมเดลที่มีประสิทธิภาพสูงขึ้นเพิ่มเติม[ ] ข้อสรุปในตอนนี้จึงไม่ใช่ว่าโมเดลเล็กแทนโมเดลใหญ่ได้ทั้งหมด แต่การแยกงานตามความยากอาจทำให้ AI Agent คุ้มและใช้ได้จริงขึ้น หากผลทดสอบภาคสนามยืนยันความน่าเชื่อถือ