
คำจำกัดความของช่องว่างระหว่างโมเดลกับระบบจริง
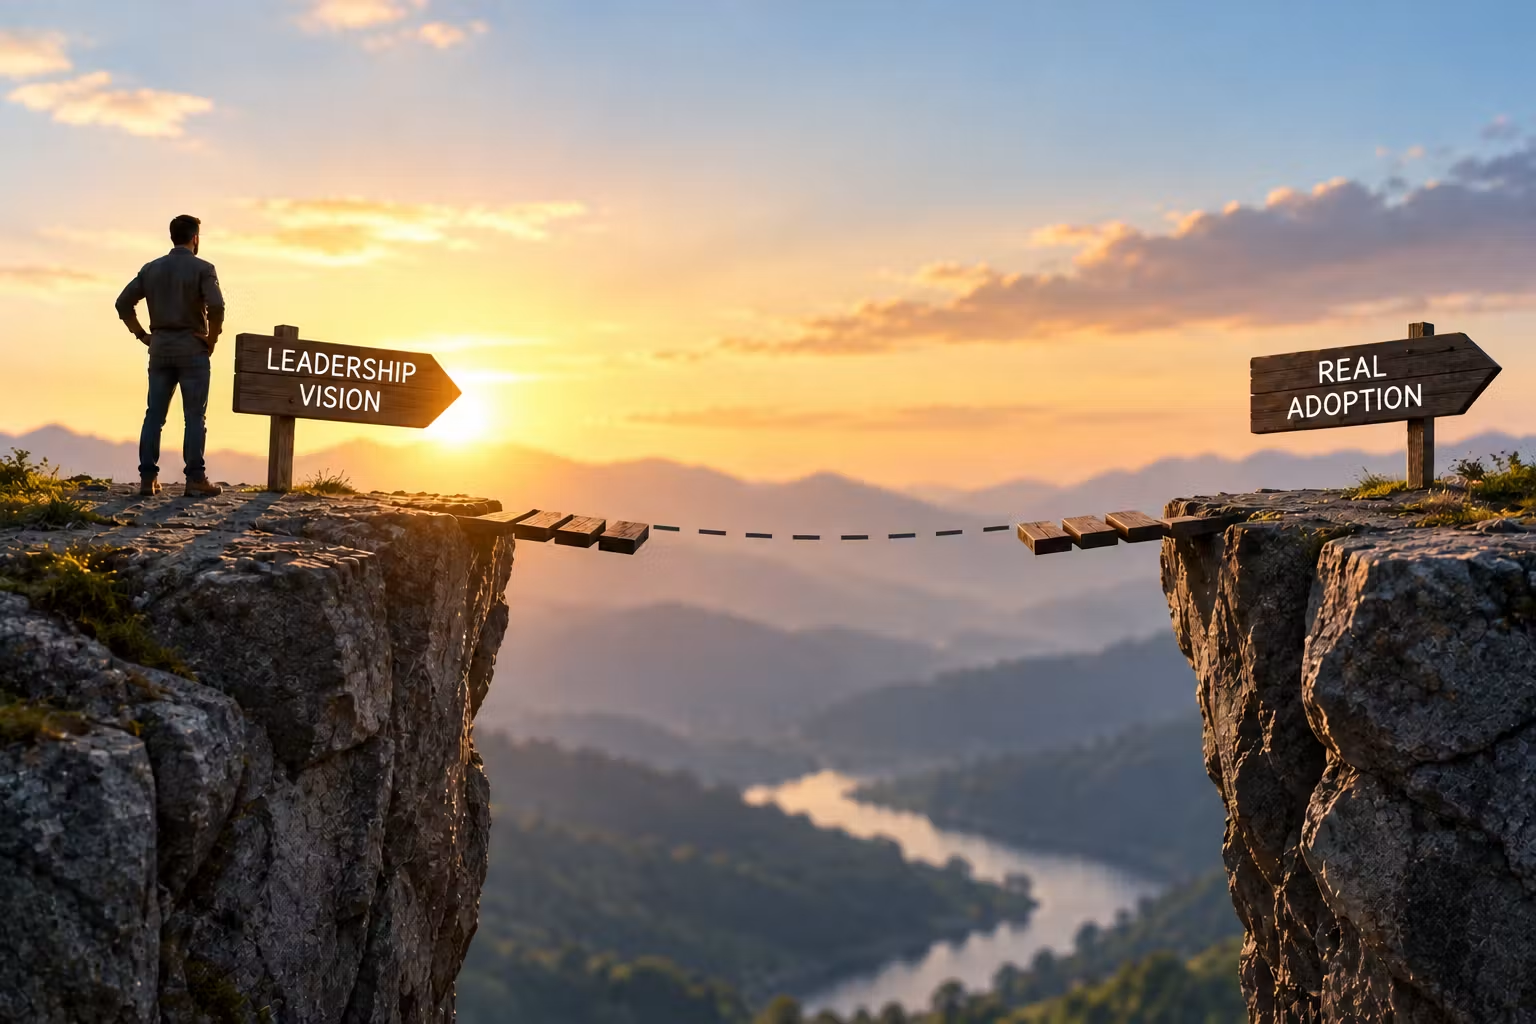
ช่องว่างวิศวกรรมการผลิต AI คือความแตกต่างระหว่างโมเดลที่ทำงานได้ดีในสภาพแวดล้อมทดสอบที่ควบคุมได้ กับระบบ AI ที่ต้องรับมือข้อมูลจริง โครงสร้างระบบที่ซับซ้อน ข้อจำกัดด้านต้นทุน และความเสี่ยงด้านธุรกิจในการใช้งานจริง ช่องว่างนี้ทำให้โครงการที่ดูดีในเดโมหรือโปริโตไทป์ กลายเป็นความล้มเหลวของโครงการ AI เมื่อขยายไปสู่การปรับใช้ระบบ AI ระดับองค์กร เพราะระบบจริงต้องผูกผลลัพธ์ของโมเดลเข้ากับขั้นตอนธุรกิจที่เชื่อถือได้ รองรับข้อผิดพลาด และต้องไม่ทำให้ผู้ใช้หรือระบบอื่นพังกลางทาง ความเข้าใจช่องว่างนี้คือจุดต่างระหว่างการเล่นกับเทคโนโลยีใหม่ กับการสร้างความเชื่อถือได้ของ AI ในโลกจริง

เมตริกทดสอบสวยหรู แต่ไม่ตอบโจทย์ระบบจริง
ปัญหาแรกที่ผลักให้ความล้มเหลวของโครงการ AI เกิดขึ้นซ้ำ คือการใช้เมตริกความสำเร็จคนละชุดระหว่างเฟสทดลองกับเฟสปรับใช้จริง ทีมจำนวนมากตัดสินความสำเร็จจากเดโมที่ให้คำตอบถูก บนข้อมูลสะอาดและชุดคำถามจำกัด แต่ระบบจริงต้องอยู่กับข้อมูลค้าง อัปเดตไม่เท่ากัน API ล่ม การขอข้อมูลซ้ำ การจำกัดสิทธิ์ และกฎธุรกิจที่เปลี่ยนตลอดเวลา เมื่อทีมรันทดลองเล็กแล้วเอาไปเปรียบกับมาตรฐานการใช้งานทั่วองค์กร จึงมักสรุปว่า AI ใช้ไม่ได้ ทั้งที่โปริโตไทป์ไม่เคยถูกออกแบบมาเพื่อพิสูจน์เรื่องนั้น ตรงกันข้าม บางครั้งเดโมที่ราบรื่นทำให้เกิดความเชื่อมั่นเกินจริง จนระบบถูกนำไปใช้ในเคสที่ไม่เคยทดสอบมาก่อน กลายเป็นจุดเจ็บใหญ่ของการปรับใช้ระบบ AI ที่ระดับองค์กรต้องจ่ายราคา
จากข้อความสุ่มเสี่ยงสู่สัญญาผลลัพธ์ที่ต้องปลอดภัยเสมอ
ในแล็บ เราพอใจแค่ให้โมเดลตอบกลับในรูปแบบที่เราขอ แต่ในแอปมือถือหรือระบบผู้ใช้จริง ข้อมูลต้องมีรูปทรงที่เราสามารถแสดงผลได้เสมอ ช่องว่างระหว่างผลลัพธ์เชิงความน่าจะเป็นของโมเดล กับ UI เชิงดีเทอร์มินิสติก คือจุดที่ฟีเจอร์ AI ส่วนใหญ่แอบพังเมื่อเข้าการผลิต ทางออกไม่ใช่การเขียนพรอมป์ใหม่ แต่คือการออกแบบสัญญาผลลัพธ์ที่ชัดเจน มีเวอร์ชัน และตรวจสอบก่อนเสมอ ว่าโครงสร้างข้อมูลตรงตามสคีมาที่กำหนดไว้ สิ่งสำคัญคือการไม่เชื่อผลลัพธ์ดิบจากโมเดล จนกว่าจะผ่านการ validate ตามสคีมา แล้วต้องมีกลไก fallback ที่แสดงข้อความเช่น "ไม่สามารถสร้างผลลัพธ์ โปรดลองอีกครั้ง" แทนการปล่อยให้ JSON ครึ่ง ๆ กลาง ๆ ทำหน้าจอค้างหรือว่างเปล่า นี่คือจุดที่วิศวกรรมการผลิต AI แยกตัวจากการเล่นกับโมเดลอย่างชัดเจน
สถาปัตยกรรมรอบโมเดลคือหัวใจของความเชื่อถือได้ของ AI
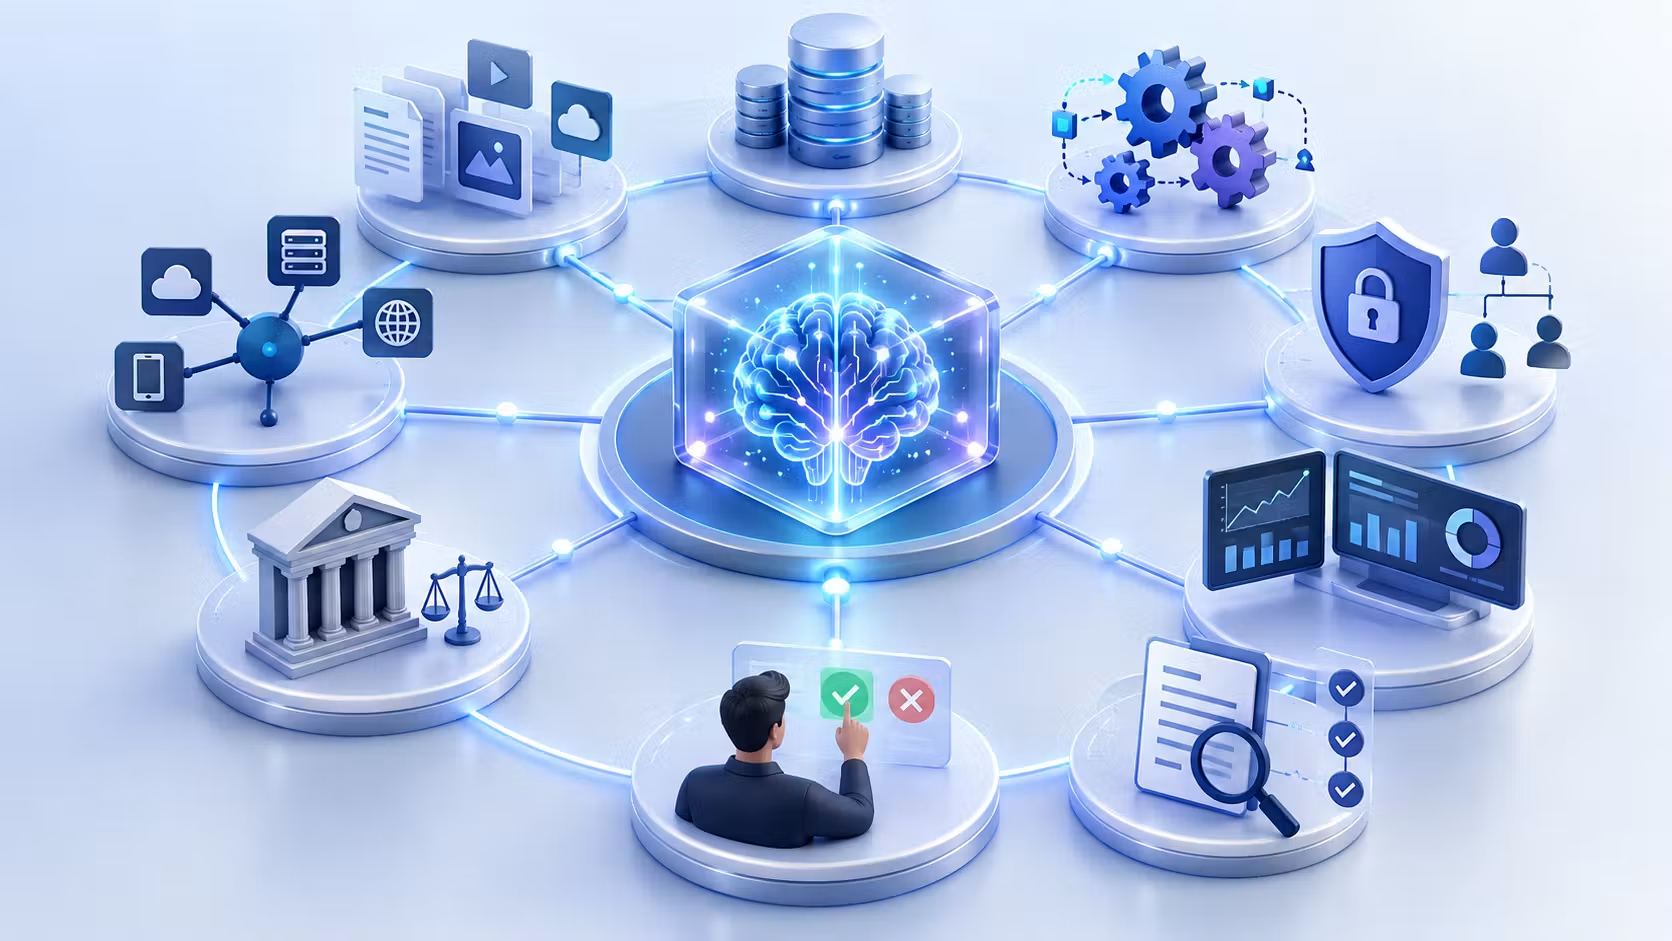
องค์กรจำนวนมากหมกมุ่นกับการเลือกโมเดล เปรียบเทียบชื่อโมเดล ขนาดคอนเท็กซ์ หรือโค้ดโอเพนซอร์ส แต่ประเด็นที่น่าห่วงกว่าคือ โมเดลมองเห็นข้อมูลที่ต้องใช้ตัดสินใจครบและทันสมัยหรือไม่ ข้อมูลในองค์กรกระจายอยู่ในสเป็ก API บริการภายใน ไฟล์คอนฟิก รันบุ๊ก เอกสารสินค้า ทิคเก็ต ฐานข้อมูล และความรู้ในหัววิศวกรบางคน ซึ่งอัปเดตด้วยความเร็วไม่เท่ากัน โมเดลภาษาจะเพียงแค่ให้เหตุผลบนข้อมูลที่ได้รับ หากข้อมูลนั้นล้าสมัย ไม่ครบ หรือขัดแย้งกัน ต่อให้โมเดลเก่งแค่ไหน ก็สามารถให้คำตอบที่มั่นใจแต่ผิดได้ สถาปัตยกรรมระบบ AI สมัยใหม่จึงต้องรวมเลเยอร์บริบท หน่วยความจำ สถานะ เกตเวย์โมเดล การตรวจสอบ ตลอดจนระบบเครื่องมือและบริการอื่น พร้อมเลเยอร์ครอบที่ดูแลด้านความปลอดภัย อัตลักษณ์ การสังเกตการณ์ การประเมิน นโยบาย ต้นทุน และการกู้คืนจากความล้มเหลว เลเยอร์นี้ต่างหากที่กำหนดความเชื่อถือได้ของ AI มากกว่าโมเดลเพียงตัวเดียว
จากโปริโตไทป์สู่การปรับใช้จริง ต้องคิดใหม่ทั้งเกณฑ์และโครงสร้าง
เมื่อ AI เริ่มไม่ใช่แค่บอทตอบคำถาม แต่สามารถอัปเดตข้อมูลลูกค้า ทริกเกอร์เวิร์กโฟลว์จ่ายเงิน หรือเรียกใช้บริการภายใน ผลของความผิดพลาดจึงรุนแรงขึ้นทั้งต่อผู้ใช้และองค์กร จุดนี้ทำให้การขยายจากโปริโตไทป์สู่การปรับใช้ระบบ AI กลายเป็นโจทย์วิศวกรรมการผลิต AI มากกว่างานวิจัยโมเดล เกณฑ์ความพร้อมต้องเปลี่ยนจากคำถามว่า "โมเดลตอบถูกไหม" เป็น "ระบบยังใช้ต่อได้โดยที่ภาระดูแลไม่ทำลายประโยชน์ที่ได้" รายงาน World Quality Report 2025 ระบุว่า 88 เปอร์เซ็นต์ของผู้ตอบมองว่า AI เป็นกลยุทธ์สำคัญสำหรับการทดสอบในอนาคต แต่มีเพียง 12.6 เปอร์เซ็นต์ที่ใช้มันในกิจกรรมทดสอบหลักวันนี้ ช่องว่างนี้ไม่ใช่สัญญาณว่า AI ล้มเหลว แต่สะท้อนว่าสถาปัตยกรรม ระบบดึงข้อมูล ความปลอดภัย การสังเกตการณ์ และธรรมาภิบาล ยังไม่ถูกออกแบบให้รองรับการใช้งานจริงในวงกว้าง หากองค์กรไม่ตีโจทย์เหล่านี้ให้แตก การปรับใช้ระบบ AI ก็จะติดอยู่ที่เดโมสวยหรูแต่ใช้งานจริงไม่ได้