
การตรวจสอบโค้ด AI จาก GitHub: จากการเขียนโค้ดเร็ว สู่การดูแลคุณภาพระยะยาว
การตรวจสอบโค้ด AI คือแนวทางที่ใช้ปัญญาประดิษฐ์ช่วยอ่าน วิเคราะห์ และให้ข้อเสนอแนะต่อโค้ดที่นักพัฒนาส่งขึ้นระบบควบคุมเวอร์ชัน โดยมุ่งเน้นทั้งความถูกต้อง ความสามารถในการดูแลต่อยอด ความปลอดภัย และผลกระทบต่อระบบภาพรวม แทนที่จะพิจารณาเพียงว่าฟีเจอร์ใหม่ทำงานได้หรือไม่ โดยเฉพาะในยุคที่เครื่องมือช่วยเขียนโค้ดทำให้จำนวนบรรทัดโค้ดเพิ่มสูงขึ้นอย่างรวดเร็ว การตรวจสอบอัตโนมัติที่มีโครงสร้างและวัดผลได้จึงกลายเป็นด่านคัดกรองสำคัญก่อนโค้ดจะเข้าไปอยู่บนสาขาหลักของระบบขนาดใหญ่
GitHub Code Quality เปิดให้ใช้งานทั่วไปบน GitHub Enterprise Cloud และ GitHub Team หลังจากอยู่ในสถานะทดลองใช้งานแบบสาธารณะมาตั้งแต่เดือนตุลาคม 2025 แก่นสำคัญไม่ใช่แค่เพิ่มเครื่องมือสแกน แต่คือการวางมาตรฐานคุณภาพโค้ดให้ทีมพัฒนาใช้ร่วมกันทั้งองค์กร Code Quality ผสานการวิเคราะห์ CodeQL เข้ากับการตรวจจับปัญหาด้านการดูแลรักษาและความเชื่อถือได้ด้วย AI แล้วใช้ Copilot Autofix เสนอการแก้ไขให้รีวิวบน pull request แนวทางนี้สะท้อนชัดว่าการตรวจสอบโค้ด AI กำลังถูกมองเป็นเลเยอร์ควบคุมคุณภาพที่แยกจากการผลิตโค้ดด้วย AI โดยตรง

GitHub Code Quality: จากเครื่องมือสแกน สู่ระบบคะแนนคุณภาพโค้ดทั้งองค์กร
หัวใจของ GitHub Code Quality คือการยอมรับความจริงว่า AI ช่วยให้ทีมผลิตโค้ดได้มากขึ้น แต่ภาระในการประเมินดีไซน์และความสามารถในการดูแลระยะยาวยังคงอยู่ที่ทีมวิศวกร แปลว่าถ้าไม่มีระบบควบคุม คุณภาพโค้ดมีโอกาสดรอปลงพร้อมๆ กับที่ปริมาณโค้ดพุ่งขึ้น GitHub จึงออกแบบ Code Quality ให้ทำงานสองระดับคือบน pull request และบนสาขาหลักของ repository เมื่อมี pull request ระบบจะรันการวิเคราะห์ CodeQL รายงานข้อค้นพบด้านคุณภาพในบริบทของ diff และแสดงว่าการเปลี่ยนแปลงกระทบ test coverage หรือไม่ ขณะที่บน default branch จะใช้เพื่อค้นหา “หนี้คุณภาพ” ที่สะสมอยู่ใน repo
การวิเคราะห์ CodeQL ที่เคยใช้เน้นด้านความปลอดภัย ถูกต่อยอดให้ดูแลทั้ง maintainability และ reliability ควบคู่กับการตรวจหาชช่องโหว่เดิม และเวอร์ชันใช้งานทั่วไปยังเพิ่มความสามารถระดับองค์กร เช่น การเปิดใช้แบบรวมศูนย์ แดชบอร์ดคะแนนด้านการดูแลรักษาและความเชื่อถือได้ ตัวชี้วัด test coverage และ ruleset สำหรับตั้ง quality gate ที่สำคัญคือยังมีโหมด evaluate ให้ทีมค่อยๆ นำข้อบังคับเหล่านี้ไปใช้ โดยไม่ต้องเหวี่ยงเปลี่ยนกระบวนการทั้งหมดทันที นี่คือการย้ายจุดสนใจจาก “โค้ดเยอะขึ้นแค่ไหน” ไปเป็น “โค้ดของเราดูแลระยะยาวได้แค่ไหน” ซึ่งสอดคล้องกับลำดับความสำคัญด้านความเชื่อถือได้ขององค์กรขนาดใหญ่
การตรวจสอบโค้ดแบบแบ่งระดับ Lite/Balanced: บาลานซ์ระหว่างความลึกของ AI และทรัพยากรทีม
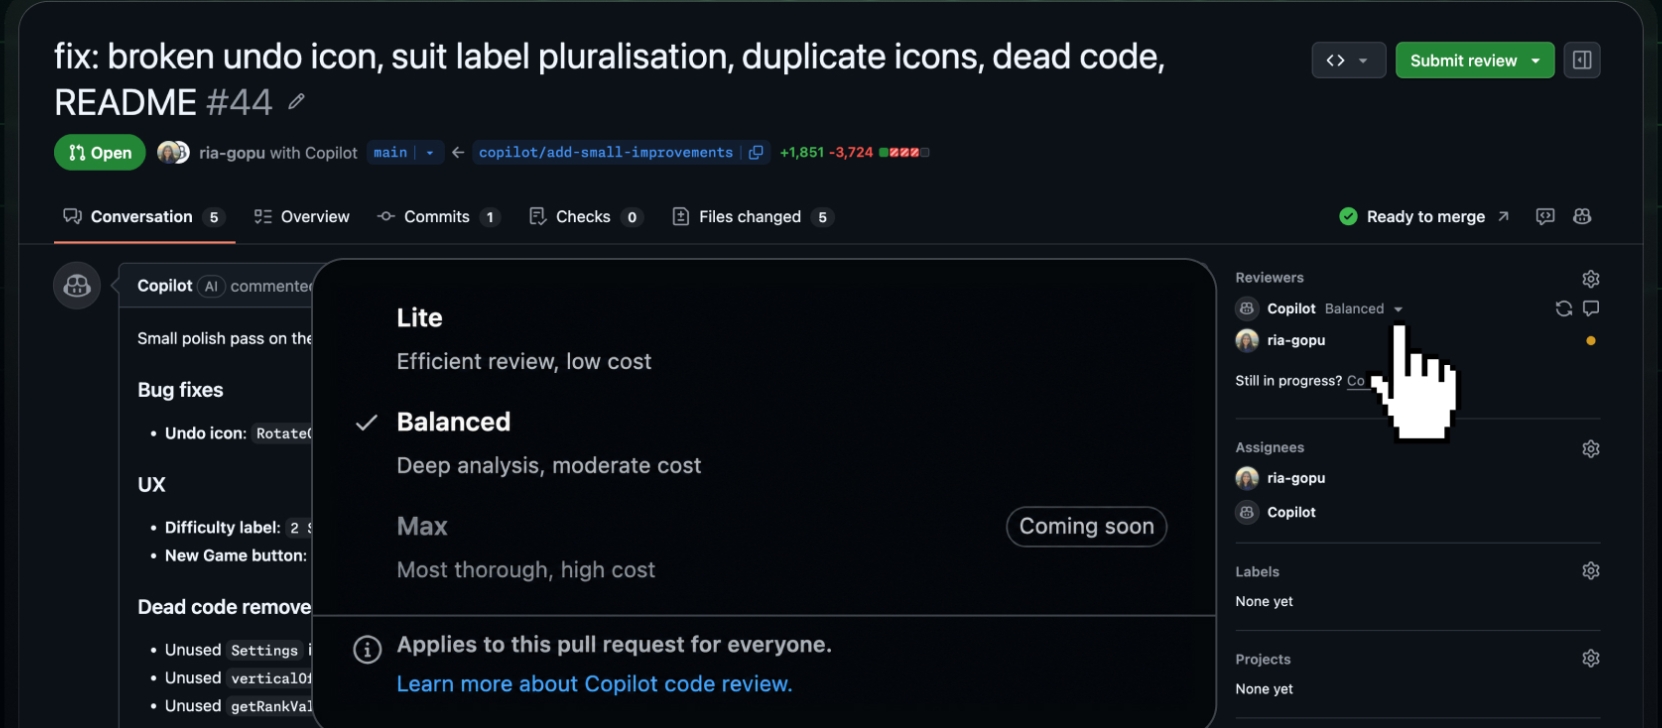
การเพิ่มปริมาณการตรวจสอบโค้ด AI โดยไม่คิดเรื่องต้นทุนคำนวณ เป็นทางตรงสู่ระบบที่ช้าและฟีดแบ็กล้นเกิน GitHub จึงผลักดันแนวคิด “tiered review” ใน Copilot Code Review ด้วยโหมด Lite และ Balanced ที่เพิ่งเปิดใช้งาน โดยให้นักพัฒนาปรับความเข้มข้นการวิเคราะห์ตามความซับซ้อนและความเสี่ยงของการเปลี่ยนแปลงในแต่ละครั้ง Lite ถูกออกแบบมาสำหรับการแก้ไขเอกสาร bug เล็กๆ หรือการเปลี่ยนแปลงที่มีขอบเขตชัดเจน ในขณะที่ Balanced จะเรียกใช้โมเดล AI ที่มีความสามารถด้าน reasoning สูงกว่า เพื่อเจาะลึกตรรกะโปรแกรมที่ซับซ้อน โค้ดที่เกี่ยวข้องกับความปลอดภัย และการเปลี่ยนแปลงที่เชื่อมโยงหลายระบบบริการพ่วงกัน
แม้ชื่อจะดูเบาและสมดุล แต่ผลเชิงโครงสร้างชัดมาก Balanced ใช้ทรัพยากรการคำนวณ AI มากกว่า Lite จึงกิน GitHub AI points และ GitHub Actions minutes สูงกว่าอย่างมีนัยสำคัญ ตามเอกสารของ GitHub ทีมที่ต้องการตรวจสอบลึกขึ้นจึงต้องตัดสินใจบนฐานทั้งความเสี่ยงทางเทคนิคและงบทรัพยากร ข้อดีคือความยืดหยุ่น การขอให้ Copilot ตรวจสอบโค้ดครั้งใดครั้งหนึ่ง นักพัฒนาสามารถเลือก Lite หรือ Balanced ได้โดยไม่ไปเปลี่ยนค่า default ของ repository หรือองค์กร ทำให้ในโปรเจกต์เดียวกัน สามารถใช้ Lite กับ patch ทั่วไป แล้วสลับเป็น Balanced เมื่อเจอการปรับโค้ดที่แตะ security หรือ core logic สำคัญๆ
การตั้งค่าแบบรวมศูนย์แต่ยืดหยุ่น: ทางสายกลางของทีมเล็ก ทีมใหญ่ และองค์กร
องค์กรขนาดใหญ่ต้องการมาตรฐานเดียวกัน ขณะที่ทีมย่อยและนักพัฒนาแต่ละคนต้องการพื้นที่ตัดสินใจ นี่คือจุดที่ระบบการตรวจสอบโค้ด AI แบบแบ่งระดับของ GitHub แสดงบทบาทสำคัญ ฝั่ง GitHub Code Quality เวอร์ชันทั่วไปเพิ่มการเปิดใช้ในระดับองค์กร แดชบอร์ดรวม และชุดกฎที่ใช้เป็น quality gate ใน pipeline ทำให้ผู้บริหารวิศวกรรมสามารถกำหนดเกณฑ์ขั้นต่ำด้านคุณภาพโค้ด การวิเคราะห์ CodeQL และ test coverage ให้ทุก repository ต้องปฏิบัติตาม โดยยังใช้โหมด evaluate ช่วย rollout แบบค่อยเป็นค่อยไป ลดแรงต้านจากทีมที่ยังไม่พร้อมรับกฎเข้มเต็มรูปแบบ
ในระดับ Copilot Code Review ผู้ดูแลองค์กรสามารถตั้งค่าระดับการตรวจสอบดีฟอลต์ได้ และ repository ที่ยังไม่ได้ตั้งเองจะรับค่าจากองค์กรไปใช้โดยอัตโนมัติ ขณะเดียวกัน repository แต่ละอันยังตั้งค่าส่วนตัวเพิ่มเติมได้อีกชั้น ที่สำคัญกว่านั้น เมื่อถึงเวลาขอให้ Copilot ตรวจสอบโค้ด นักพัฒนายังสามารถเลือก Lite หรือ Balanced แบบครั้งต่อครั้งได้ โดยไม่ไปเปลี่ยนค่าพื้นฐานของโปรเจกต์ หลังการตรวจสอบ ระบบจะบันทึกใน timeline และคอมเมนต์รวมของ pull request ว่าครั้งนั้นใช้โหมดใด แนวทางนี้ทำให้ทีมเล็กที่เน้นความเร็วใช้โหมดเบาส่วนใหญ่ ในขณะที่ทีมแพลตฟอร์มหรือทีม security สามารถผลักดันให้ใช้ Balanced กับโค้ดที่แตะโครงสร้างสำคัญของระบบ
จากปริมาณไปคุณภาพ: ผลกระทบที่แท้จริงต่อมาตรฐานทีมพัฒนา
ประเด็นที่น่าสนใจที่สุดไม่ใช่ฟีเจอร์ใหม่ของ GitHub แต่อยู่ที่การขยับกรอบคิดของทีมพัฒนาโดยรวม เครื่องมือพัฒนาแบบมี AI ช่วยเขียนทำให้ปริมาณโค้ดเพิ่มขึ้นอย่างมาก แต่ภาระในการประเมินดีไซน์และความสามารถในการดูแลระยะยาวยังคงตกอยู่กับทีมวิศวกร การที่ GitHub ใส่ชั้นควบคุมเพิ่มเติมผ่าน GitHub Code Quality เพื่อดูแล maintainability, coverage และ reliability ควบคู่ไปกับเช็คด้านความปลอดภัยของ CodeQL คือสัญญาณชัดเจนว่าจุดเน้นของวงการกำลังเคลื่อนจาก “เขียนให้ได้เยอะ” ไปเป็น “เขียนแล้วไว้ใจได้” ไม่ใช่เรื่องบังเอิญที่ GitHub ถึงกับสรุปว่า “Code Quality helps teams ship code they trust.”
แน่นอน การตรวจสอบโค้ด AI ยังไม่ใช่กระสุนเงิน Code Quality สามารถช่วยค้นหาและจัดลำดับปัญหา แต่การตัดสินใจยอมรับการแก้ไขที่ระบบเสนอ ยังคงต้องมาจากนักพัฒนาเอง และเอกสารของ GitHub ก็ย้ำว่า Copilot Code Review ไม่สามารถรับประกันว่าจะเจอปัญหาทุกอย่าง ข้อเสนอแนะของ AI ยังต้องผ่านการตรวจสอบโดยมนุษย์ และไม่สามารถแทนที่การรีวิวโค้ดแบบ manual ได้ นั่นทำให้โครงสร้างที่สมเหตุสมผลที่สุดในวันนี้คือ “คนกำหนดมาตรฐานและตัดสินใจ AI ทำหน้าที่ค้นหาและช่วยแก้” ทีมที่ปรับตัวทันจะได้ทั้งความเร็ว การมองเห็นคุณภาพในระดับองค์กร และมาตรฐานความปลอดภัยซอฟต์แวร์ที่สูงขึ้นโดยไม่สูญเสียความรับผิดชอบของมนุษย์ไป