
คะแนนดัชนีช่วยคัดตัวเลือก แต่ไม่ได้ชี้ผู้ชนะทุกงาน
คะแนนดัชนี AI คือผลประเมินโมเดลจากชุดงานมาตรฐานที่ใช้เทียบความสามารถ เช่น การให้เหตุผลและการทำงานหลายรูปแบบ แต่คะแนนไม่ใช่คำตอบสำเร็จรูปว่ารุ่นใดเหมาะกับทุกงานหรือคุ้มต้นทุนที่สุด โมเดล Gemini 4 มีทั้งรุ่นที่ทำคะแนนสูงและรุ่นที่เน้นความเร็ว ขณะที่คู่แข่งบางรุ่นแลกคะแนนกับต้นทุนต่อการใช้งานที่ต่ำกว่า ดังนั้นการเปรียบเทียบโมเดล AI ควรเริ่มจากงานที่ต้องทำจริง แล้วค่อยอ่านคะแนน ราคา และข้อจำกัดร่วมกัน โดยเฉพาะเมื่อคะแนนมาจากระดับการคิดหรือเงื่อนไขทดสอบต่างกัน
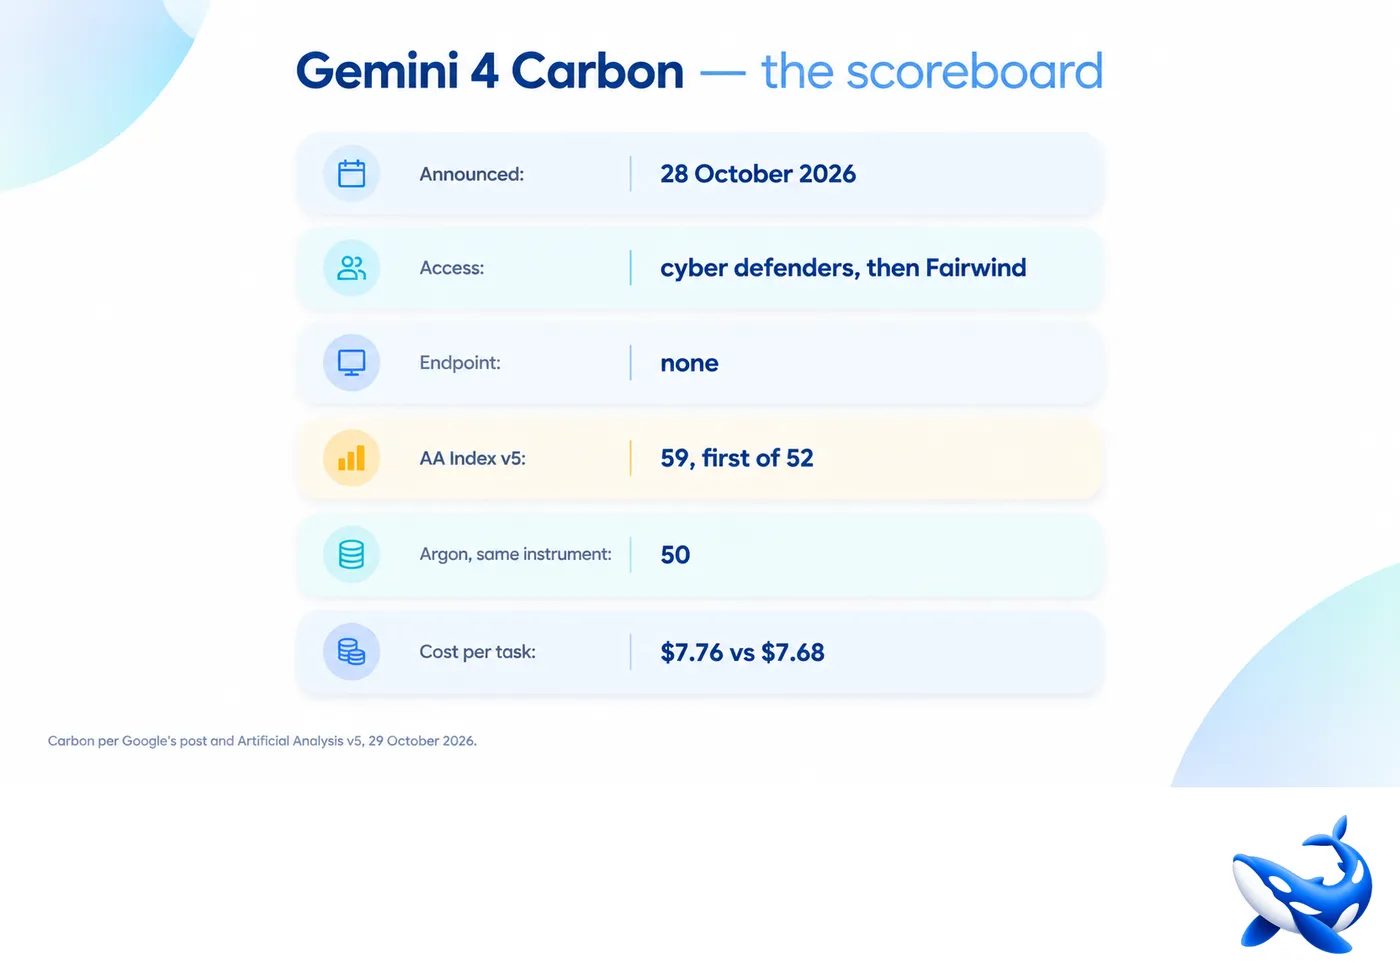
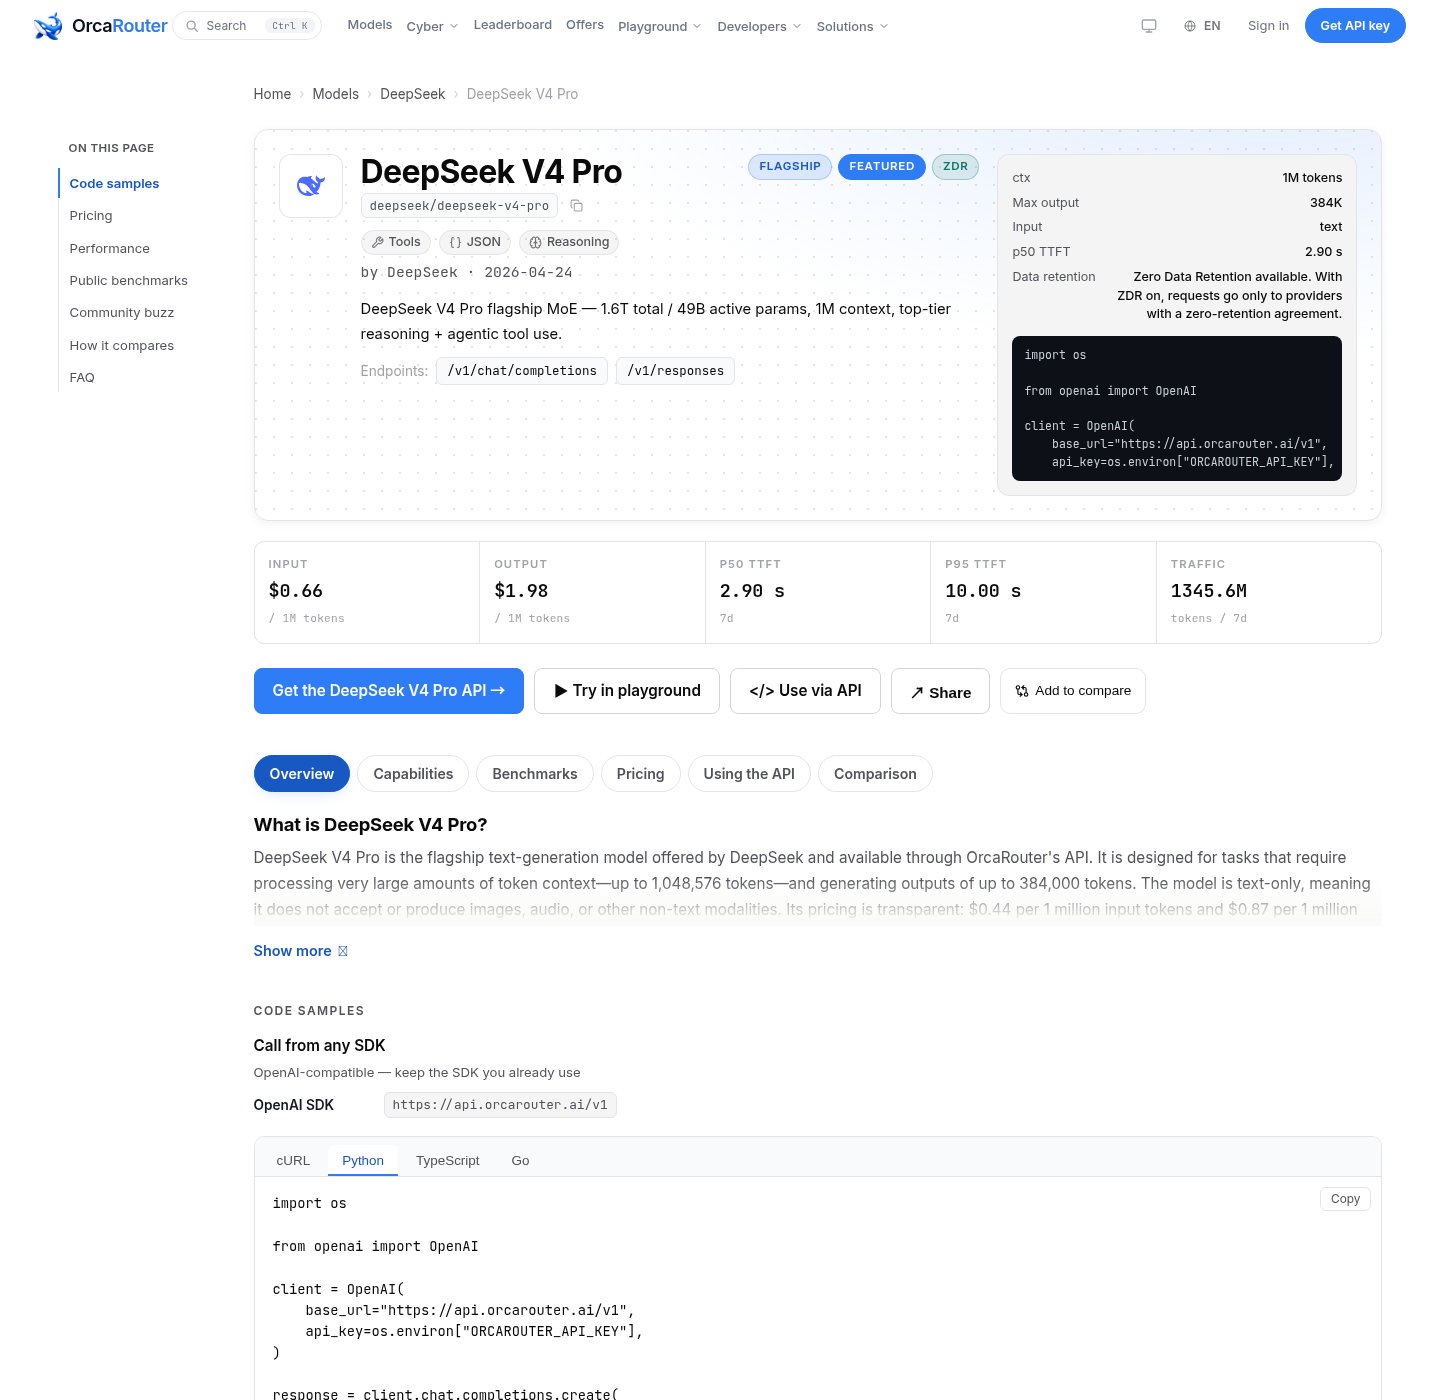
กรณี Gemini 4 Carbon เทียบกับ DeepSeek V4 Pro เห็นความต่างชัดเจน: Carbon ได้ 60 คะแนน ส่วน V4 Pro ได้ 23 คะแนนบนดัชนีเดียวกัน แต่ค่าใช้จ่ายต่อหนึ่งงานดัชนีอยู่ที่ 7.76 ดอลลาร์เทียบกับ 1.77 ดอลลาร์ จึงไม่ควรอ่านคะแนนสูงว่าเป็นเหตุผลให้เลือก Carbon โดยอัตโนมัติ ตัวเลขค่าใช้จ่ายต่องานสะท้อนจำนวนโทเค็นที่แต่ละโมเดลใช้กับงานของดัชนี ไม่ใช่ใบเสนอราคาสำหรับภาระงานของทุกคน
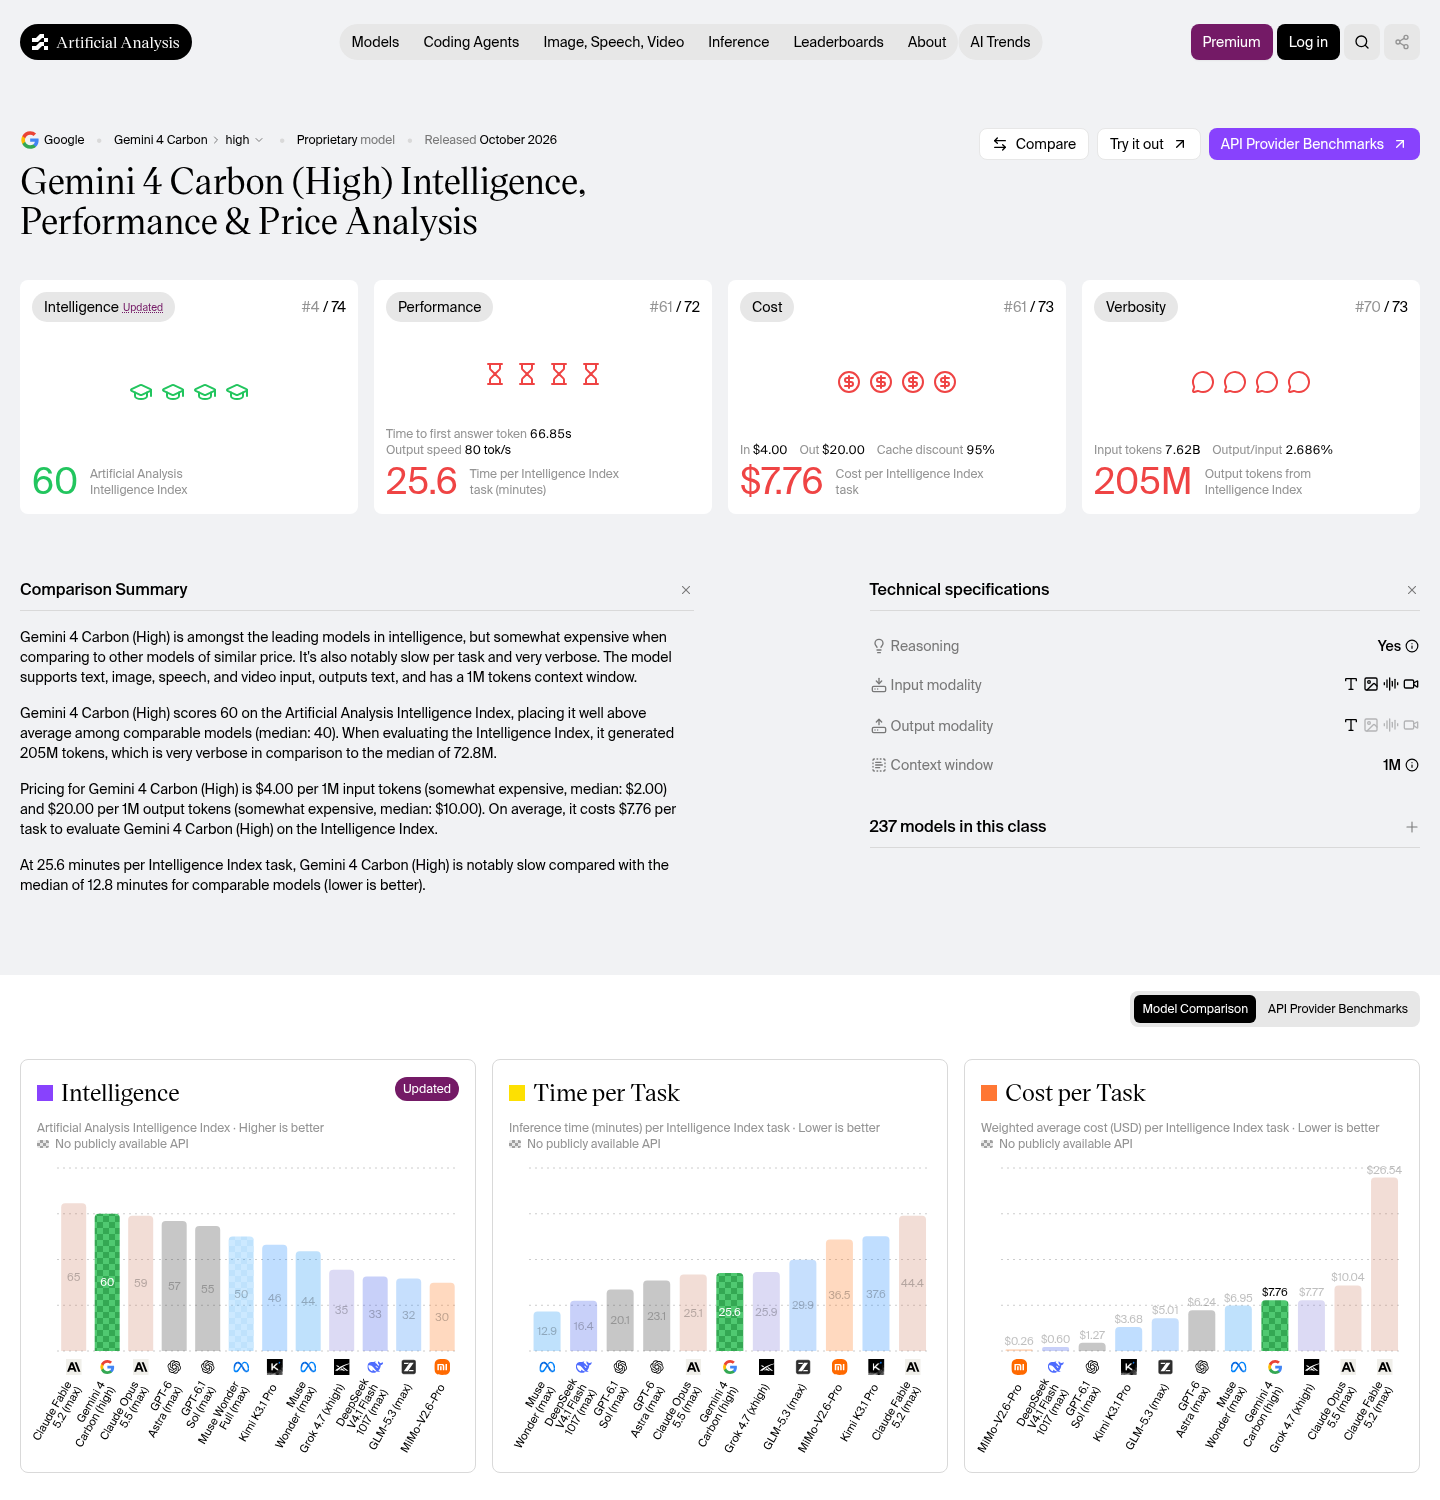
Carbon ชนะด้านคะแนน ส่วน V4 Pro เด่นเมื่อเน้นงานข้อความปริมาณมาก
ถ้างานต้องอ่านภาพ เสียง วิดีโอ หรือ PDF Carbon ได้เปรียบจากการรองรับอินพุตหลายรูปแบบ ขณะที่ V4 Pro รับเฉพาะข้อความ จึงใช้แทนกันไม่ได้ในทุกขั้นตอนของระบบ ทั้งคู่มีบริบท 1 ล้านโทเค็น แต่เพดานเอาต์พุตต่างกัน: Carbon ส่งออกพร้อมกันได้ 65,536 โทเค็น และขยายได้ถึง 1,048,576 โทเค็นเมื่อใช้การถอดรหัสระยะยาว ส่วน V4 Pro จำกัดเอาต์พุตไว้ที่ 384,000 โทเค็น
| ประเด็น | Gemini 4 Carbon | DeepSeek V4 Pro |
|---|---|---|
| คะแนนดัชนี | 60 | 23 |
| ต้นทุนต่องานดัชนี | 7.76 ดอลลาร์ | 1.77 ดอลลาร์ |
| บริบท | 1 ล้านโทเค็น | 1 ล้านโทเค็น |
| เอาต์พุตสูงสุด | 65,536 โทเค็นแบบพร้อมกัน หรือสูงสุด 1,048,576 โทเค็นเมื่อถอดรหัสระยะยาว | 384,000 โทเค็น |
| อินพุต | ข้อความ รูปภาพ เสียง วิดีโอ และ PDF | ข้อความ |
| น้ำหนักโมเดล | ปิด | เปิดภายใต้สัญญาอนุญาต MIT |
คะแนนทั้งสองวัดจาก Artificial Analysis โดย Carbon ใช้ระดับการคิด high ส่วน V4 Pro รุ่น 0813 ใช้ max effort จึงควรมองเป็นผลจากผู้ประเมินภายใต้การตั้งค่าที่ระบุ ไม่ใช่คำรับรองจากผู้พัฒนา และไม่ใช่การทดสอบแบบควบคุมที่ทำให้ทุกเงื่อนไขเหมือนกันทุกประการ หากงานเป็นข้อความจำนวนมากและต้องคุมค่าใช้จ่าย V4 Pro เป็นตัวเลือกที่น่าทดลองกว่า แต่ถ้าต้องประมวลผลสื่อหลายชนิดหรือให้คะแนนความสามารถเป็นหลัก Carbon มีเหตุผลรองรับส่วนต่างด้านต้นทุน
Argon มีคะแนนอ้างอิง ส่วน Mi:dm K ยังต้องพิสูจน์กับงานของคุณ
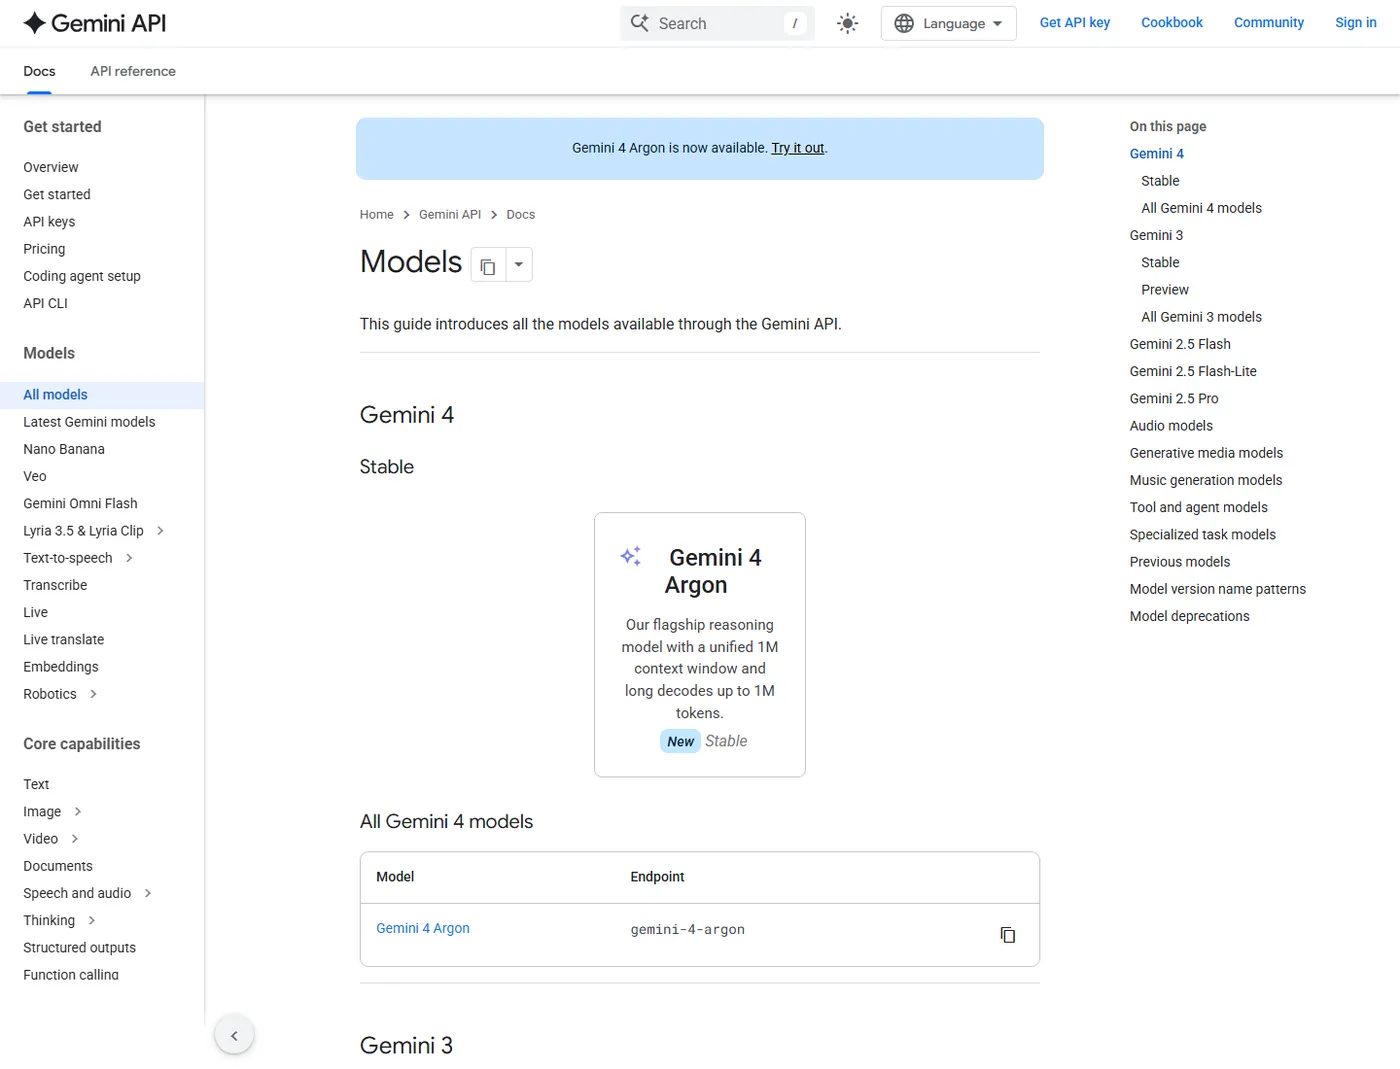
Gemini 4 Argon ได้ 52.6 คะแนนบน Artificial Analysis Intelligence Index และทำได้ 68.90% บน Vals Index ส่วน Mi:dm K 3.0 Pro ยังไม่มีคะแนนในดัชนีทั้งสอง จึงเปรียบเทียบความสามารถจากตัวเลขชุดเดียวกันไม่ได้ Argon รองรับข้อความ รูปภาพ เสียง วิดีโอ และไฟล์ ส่วน Mi:dm K 3.0 Pro รองรับข้อความเป็นหลัก ความได้เปรียบของรุ่นหลังจึงอยู่ที่ต้นทุนโทเค็นที่ต่ำกว่า ไม่ใช่คะแนนความสามารถที่ยืนยันได้จากดัชนี
การไม่มีคะแนนไม่เท่ากับทำงานไม่ได้ แต่เพิ่มความไม่แน่นอน โดยเฉพาะงานที่ต้องการคำตอบถูกตั้งแต่รอบแรก หากมีคนตรวจทานผลลัพธ์หรือใช้โมเดลราคาถูกกับงานความเสี่ยงต่ำ Mi:dm K อาจคุ้มสำหรับการทดลอง ควรนำชุดคำถามและเอกสารของตัวเองมาทดสอบ แล้ววัดทั้งความถูกต้อง จำนวนครั้งที่ต้องแก้ และต้นทุนรวมต่อคำตอบที่ยอมรับได้ แนวทางนี้ป้องกันการตัดสินใจจากราคาต่อโทเค็นเพียงอย่างเดียว
ต้นทุนโมเดล AI ไม่ได้เท่ากับต้นทุนต่อโทเค็นเท่านั้น เพราะคำตอบผิดอาจต้องส่งต่อให้โมเดลที่เก่งกว่า ตรวจซ้ำ หรือให้คนแก้ เมื่อเทียบโมเดลที่มีต้นทุนต่อหน่วยความสามารถซึ่งวัดไว้ กับโมเดลที่รู้เพียงราคาต่อโทเค็น ข้อมูลสองแบบนี้ยังนำมาหักลบกันตรง ๆ ไม่ได้
Hydrogen เร็วตามคำกล่าวอ้างหรือไม่ ต้องแยกผลทดสอบคนละชุด
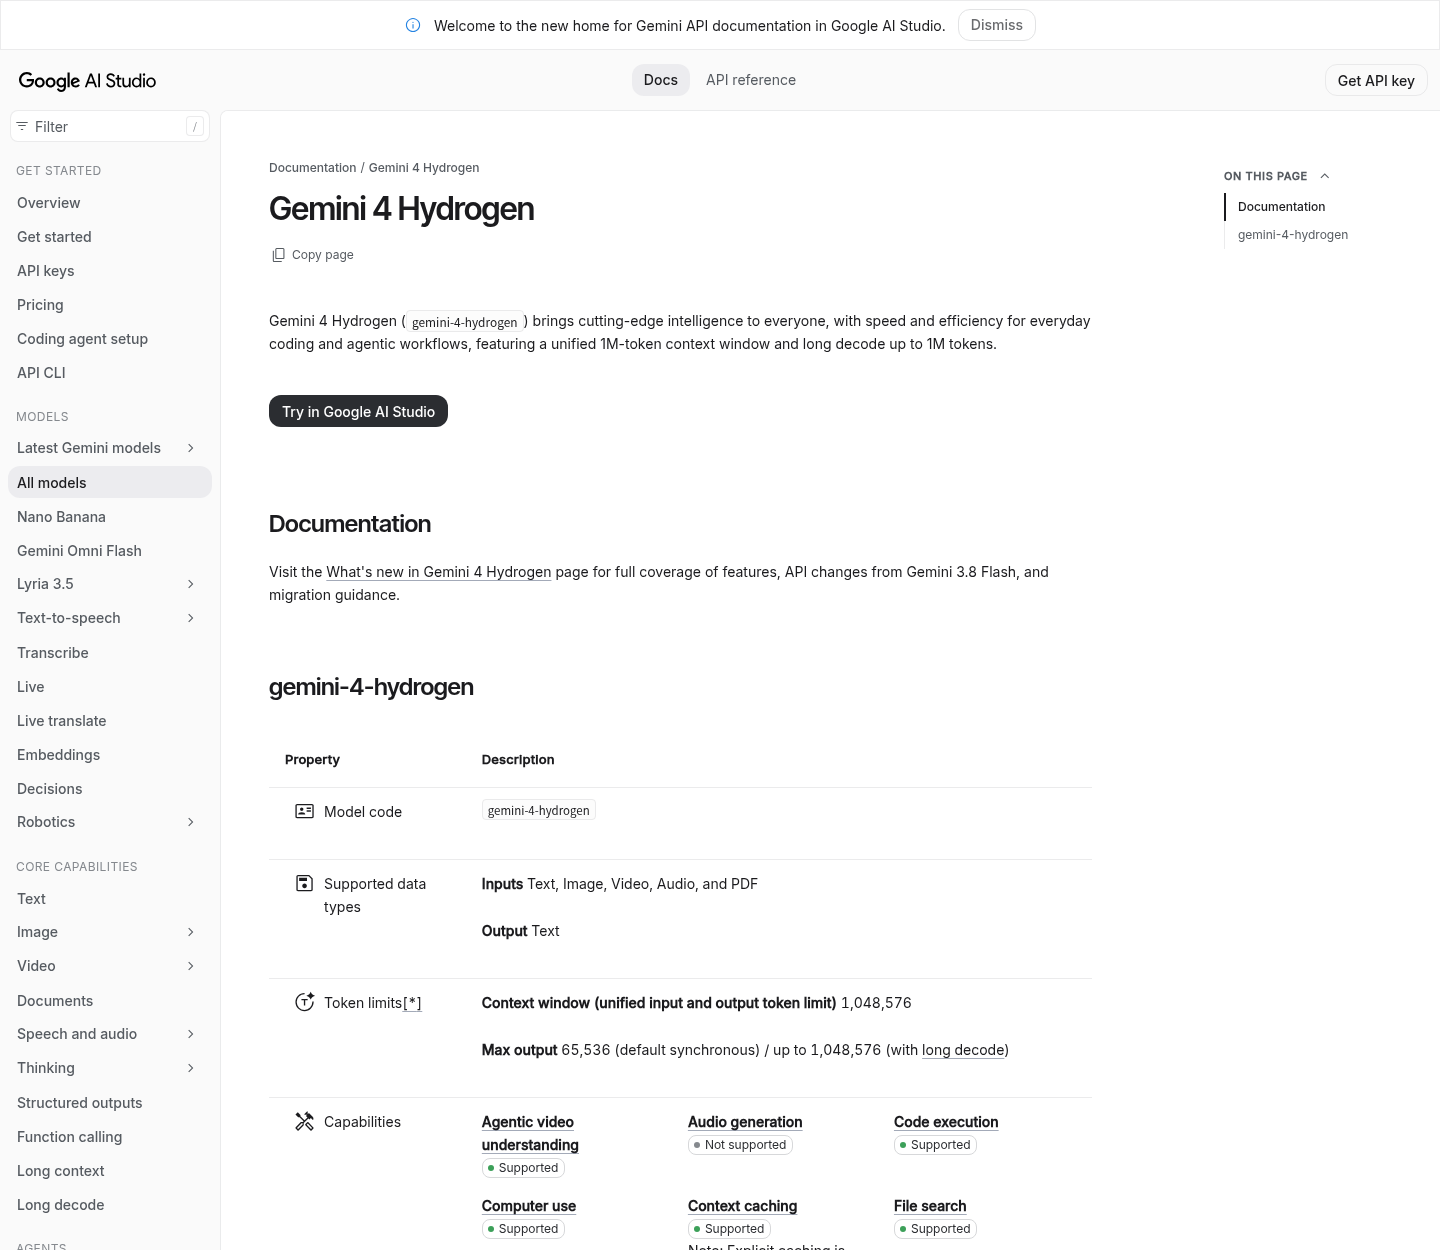
Google DeepMind ระบุว่า Gemini 4 Hydrogen ทำงานเสร็จเร็วกว่า Gemini 3.8 Flash 2.5 เท่า แต่ผลจากชุดทดสอบอิสระชุดเดียวกันวัดเวลาเฉลี่ยต่องานดัชนีของ Hydrogen ที่ 13.5 นาที และ Gemini 3.8 Flash ที่ 14.8 นาที ต่างกันราว 10% ไม่ใช่ 150% Hydrogen ได้ 54 คะแนน เทียบกับ Argon ที่ 50 คะแนนบนการประเมินที่อ้างถึง จึงดูน่าสนใจด้านคะแนนด้วย แต่ตัวเลขความเร็วจากประกาศและผลทดสอบภายนอกไม่ได้วัดสิ่งเดียวกันเสมอไป
รายละเอียดการตั้งค่าก็สำคัญ: คะแนนหลักของ Hydrogen จากผู้ประเมินใช้ระดับ xhigh ขณะที่ตัวเลขเปรียบเทียบของ Google ใช้ระดับ high ซึ่งเป็นค่าเริ่มต้น และรายงานด้านความเร็วในประกาศยังไม่มีการทำซ้ำนอก Google ตามข้อมูลที่ให้มา จึงควรถือคำกล่าวอ้าง 2.5 เท่าเป็นข้อมูลจากผู้พัฒนา ไม่ใช่ข้อสรุปที่ยืนยันแล้วในทุกภาระงาน
คะแนนดัชนีและต้นทุนต่องานเป็นเครื่องมือคัดกรอง ไม่ใช่ตัวแทนการทดสอบระบบจริง ผลขึ้นกับส่วนผสมของงาน ความยาวอินพุตและเอาต์พุต ระดับการคิด และเงื่อนไขที่ผู้ประเมินเลือก ต้นทุนต่องานของดัชนีจึงเป็นคุณสมบัติของชุดงานนั้น ไม่ใช่ราคาสำหรับงานของคุณโดยตรง ทางเลือกที่รอบคอบคือทดลองกับคลังข้อมูลจริงก่อนผูกระบบหรือสัญญาระยะยาว
Buy if / Skip if
- Buy the Gemini 4 Carbon if ต้องใช้โมเดลเดียวรองรับภาพ เสียง วิดีโอ และ PDF พร้อมให้ความสำคัญกับคะแนนดัชนีที่สูงกว่า
- Skip the Gemini 4 Carbon if งานหลักเป็นข้อความปริมาณมากและคะแนนที่เพิ่มขึ้นไม่ได้สร้างคุณค่าเท่าต้นทุนที่สูงกว่า
- Buy the DeepSeek V4 Pro if งานเน้นข้อความ ต้องการลดต้นทุนต่องาน และให้ความสำคัญกับน้ำหนักโมเดลแบบเปิด
- Skip the DeepSeek V4 Pro if ขั้นตอนจำเป็นต้องอ่านภาพ เสียง วิดีโอ หรือ PDF
- Buy the Gemini 4 Argon if ต้องการคะแนนอ้างอิงจากดัชนีและอินพุตหลายรูปแบบ โดยทดสอบกับงานจริงก่อนเลือกใช้
- Skip the Gemini 4 Argon if ต้องการยืนยันความสามารถเทียบกับ Mi:dm K จากคะแนนเดียวกัน เพราะรุ่นหลังยังไม่มีคะแนนในดัชนีที่อ้างถึง
- Buy the Mi:dm K 3.0 Pro if มีคนตรวจคำตอบได้และต้องการทดลองโมเดลข้อความที่มีต้นทุนต่ำกว่า
- Skip the Mi:dm K 3.0 Pro if งานเสี่ยงสูงและต้องการผลประเมินอิสระก่อนนำไปใช้
- Buy the Gemini 4 Hydrogen if ผลทดสอบของคุณยืนยันว่าความเร็วและคะแนนเหมาะกับงาน โดยแยกผลจริงออกจากคำกล่าวอ้างของผู้พัฒนา
- Skip the Gemini 4 Hydrogen if ต้องการหลักฐานอิสระที่ยืนยันความเร็วมากกว่า Gemini 3.8 Flash ถึง 2.5 เท่าในงานของคุณ