
ภาพรวมโมเดล AI ราคาถูก และคำแนะนำเบื้องต้น
โมเดล AI ราคาถูก คือโมเดลปัญญาประดิษฐ์ที่ออกแบบให้มีประสิทธิภาพเพียงพอสำหรับการใช้งานจริง แต่ลดต้นทุนการฝึกและการประมวลผลลงอย่างมีนัยสำคัญ เพื่อให้ธุรกิจและนักพัฒนาสามารถเข้าถึงความสามารถด้านการเขียนโค้ด การทำงานเอกสาร การใช้เครื่องมือ และการสร้างเอเจนต์อัตโนมัติ โดยไม่ต้องจ่ายค่าบริการระดับพรีเมียมของโมเดลเรือธงรุ่นใหญ่
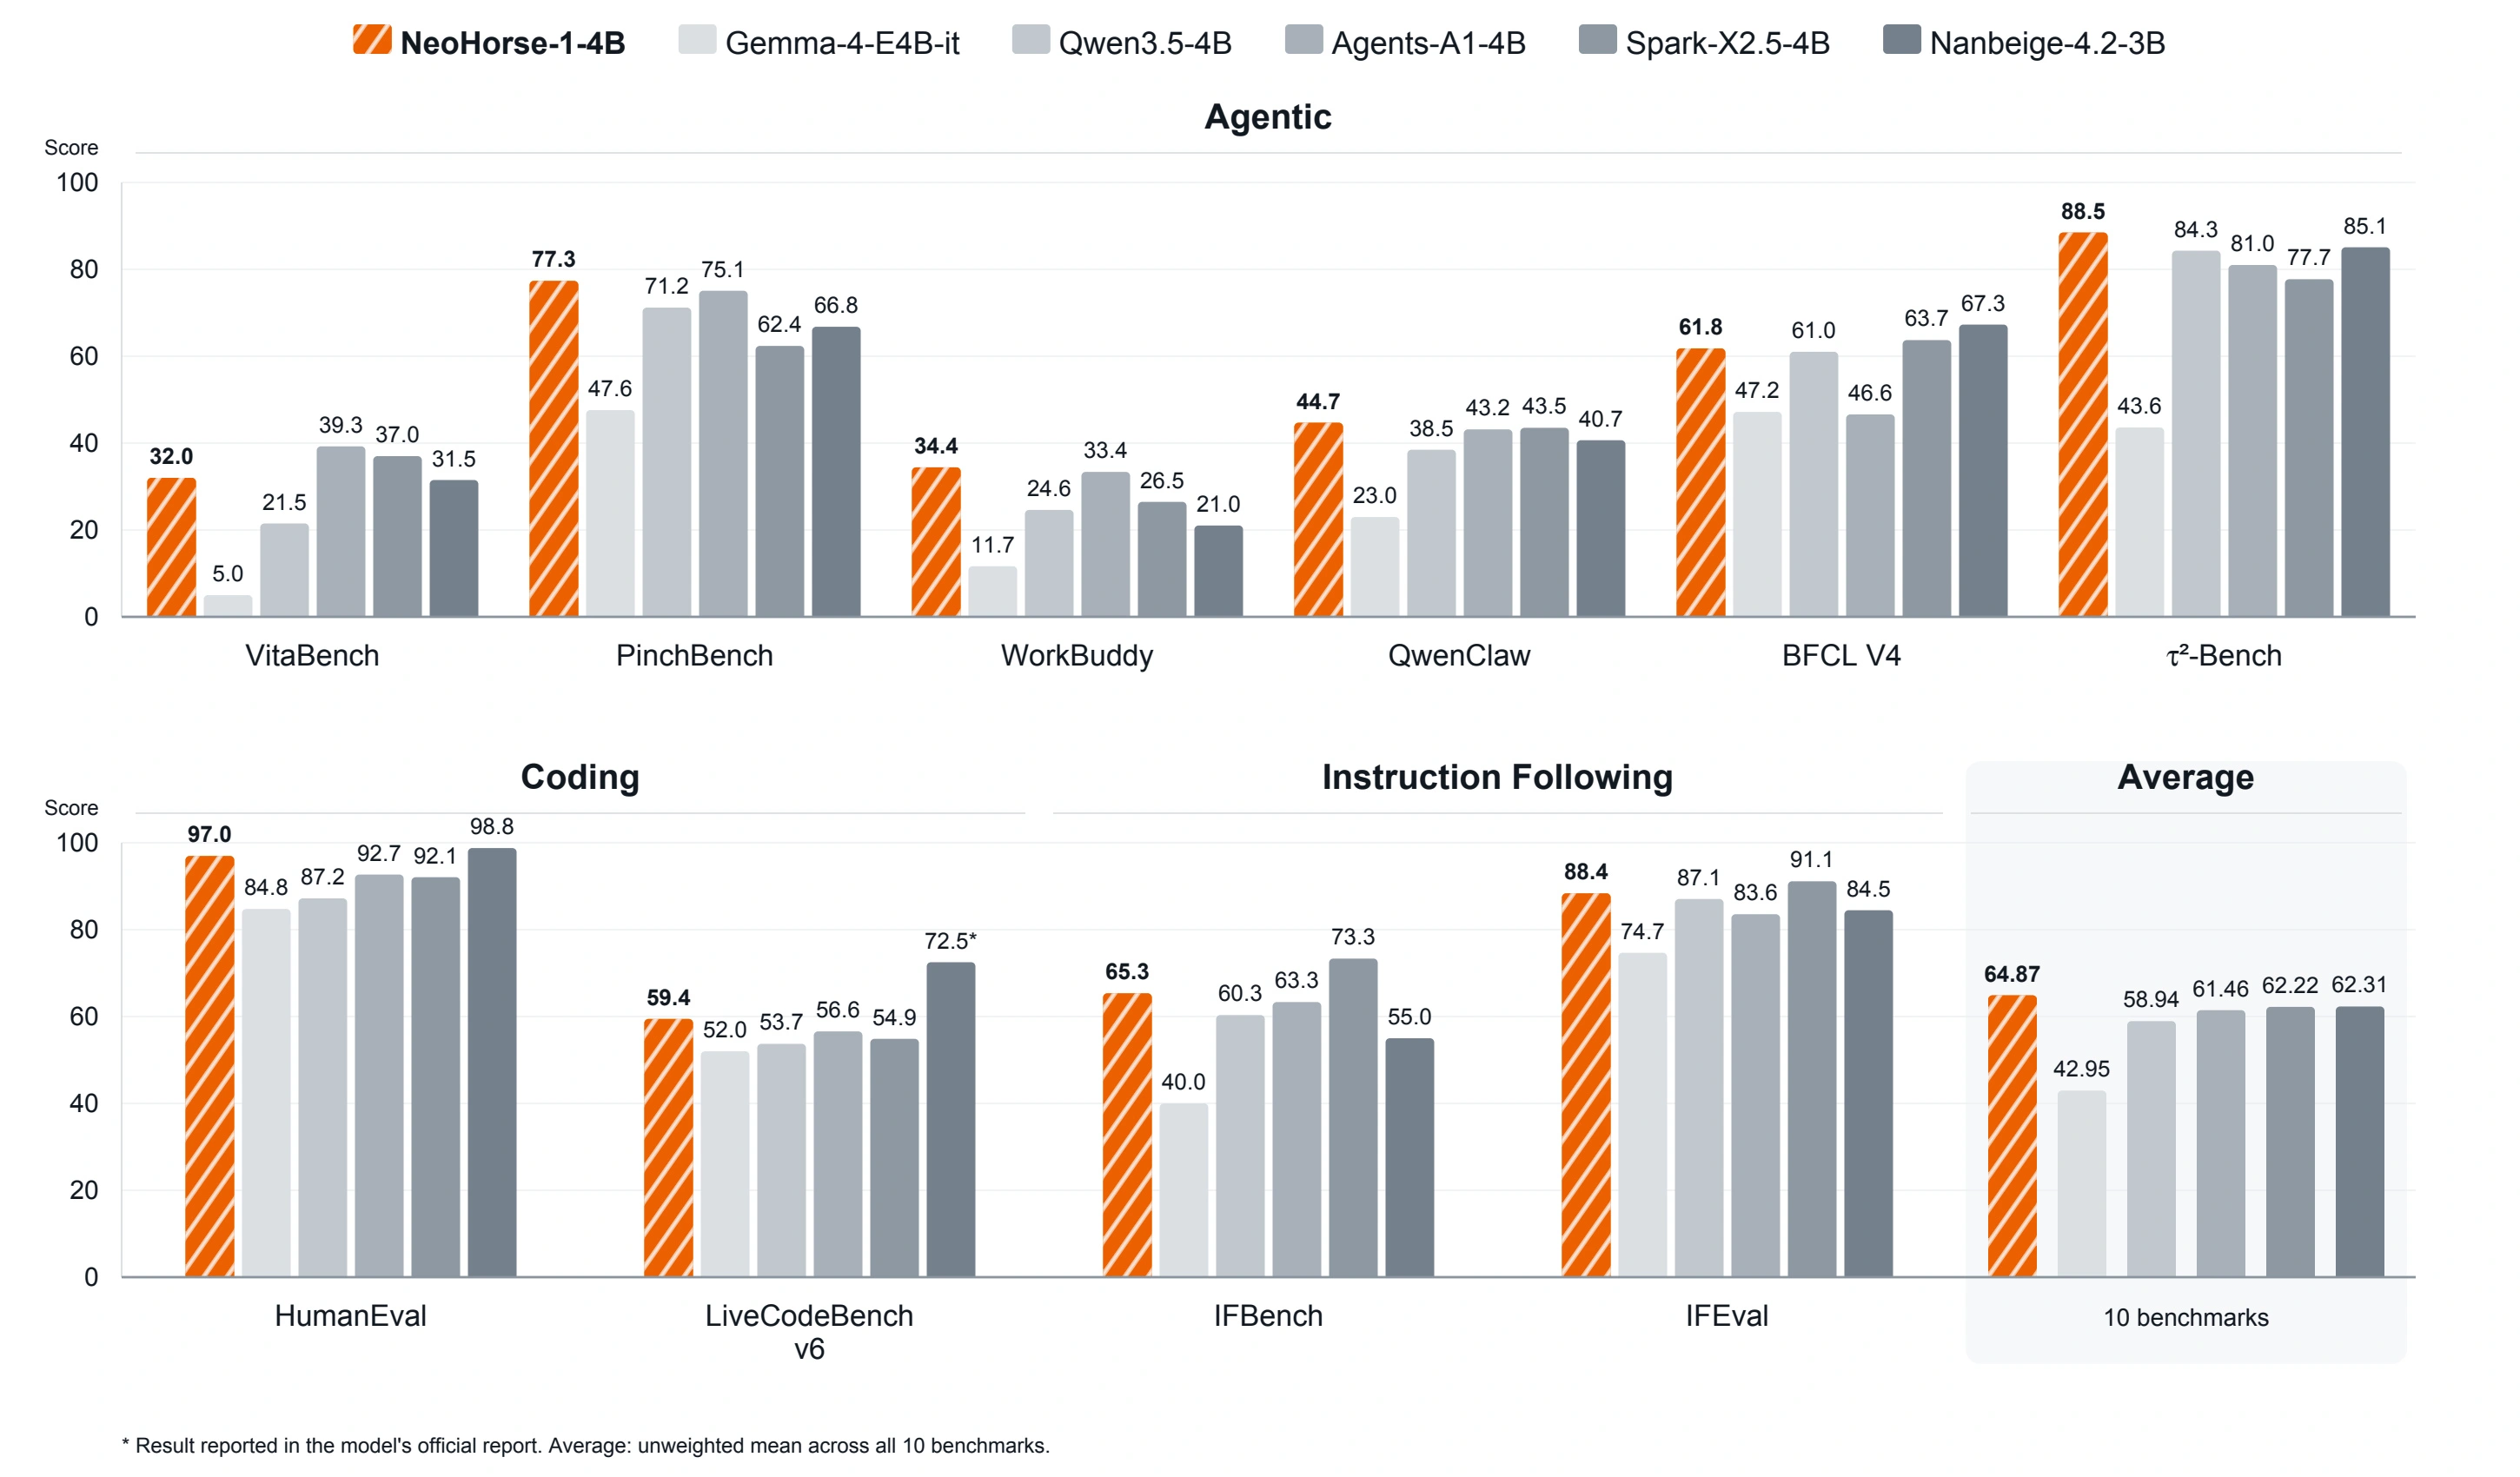
เมื่อดูภาพรวมการแข่งขัน โครงเรื่องวันนี้แบ่งชัดเจน Qwen3.8-Flash เด่นด้านประสิทธิภาพต้นทุนต่ำและงานองค์กรที่โหลดงานหนัก Hy4 จาก Tencent เน้นโมเดลใหญ่บริบทยาวที่คุ้มราคากว่าตลาดเรือธง ส่วน NeoHorse-1-4B เป็น AI โมเดลเล็กที่ออกแบบมาสำหรับเอเจนต์และงานเขียนโค้ดที่ต้องการความเร็วและใช้ทรัพยากรน้อย หากคุณทำแพลตฟอร์ม SaaS หรือโซลูชัน AI ภายในองค์กรที่ต้องรันหลายงานพร้อมกัน Qwen3.8-Flash จะเหมาะที่สุด ถ้าระบบของคุณต้องอ่านเอกสารหรือโค้ดบริบทยาวระดับล้านโทเคนในราคาประหยัด Hy4 เป็นตัวเลือกที่น่าพิจารณา ขณะที่สตาร์ตอัปและทีมวิจัยที่ต้องการรันเอเจนต์จำนวนมากบนฮาร์ดแวร์จำกัด NeoHorse-1-4B คือทางเลือกที่สมเหตุสมผล
Qwen3.8-Flash เน้นประสิทธิภาพต้นทุนต่ำและงานองค์กรโหลดหนัก
จุดขายของ Qwen3.8-Flash คือการออกแบบให้ประสิทธิภาพสูงแต่ประหยัดทรัพยากร จัดอยู่ในกลุ่มโมเดล AI ราคาถูกที่ยังรักษาความสามารถระดับใกล้เคียงโมเดลเรือธง Qwen3.8-Flash ใช้สถาปัตยกรรม Mixture-of-Experts มีโมเดลหลัก 125 พันล้านพารามิเตอร์ร่วมกับ N-gram Embeddings 51 พันล้านพารามิเตอร์ แต่ระหว่างทำงานจริงจะเปิดใช้ราว 6 พันล้านพารามิเตอร์ต่อโทเคนเท่านั้น แนวคิดนี้ช่วยลดภาระประมวลผลลงอย่างมากโดยไม่เสียความสามารถแบบโมเดลใหญ่ โมเดลรองรับบริบท 262K โทเคน และขยายได้ถึง 1 ล้านโทเคน จึงเหมาะกับงานสำนักงาน ระบบผู้ช่วย และ AI Agent ที่ต้องทำงานหลายขั้นตอนต่อเนื่องพร้อมเชื่อมต่อเครื่องมือหลายชนิด
ในด้านต้นทุน อาลีบาบาระบุว่าการออกแบบใหม่ร่วมกับเทคนิคอย่าง Hybrid Attention, Gated DeltaNet และ Muon Optimizer ทำให้ Qwen3.8-Flash ใช้ทรัพยากรเทรนเพียงประมาณหนึ่งในเก้าของรุ่นก่อนอย่าง Qwen3.7-Plus แต่ยังทำผลงานด้านการเขียนโค้ดและงานสำนักงานได้ดีกว่าในบางการทดสอบ นอกจากนี้ Standard Mode รุ่นใหม่ยังช่วยลดจำนวนโทเคนที่ใช้ต่อหนึ่งงานได้ถึง 75 เปอร์เซ็นต์ และเพิ่มความเร็วการสร้างเนื้อหาเกือบสองเท่าเมื่อเทียบกับโหมดเดิม ส่งผลให้ต้นทุนใช้งานจริงต่อคำสั่งลดลงอย่างชัดเจน ด้านการเข้าถึง โมเดลนี้เปิดเผยค่าน้ำหนักแบบ Open-weight ให้ดาวน์โหลด และมี API ให้ใช้ในบริการคลาวด์ จึงตอบโจทย์ทั้งองค์กรใหญ่และนักพัฒนาที่ต้องการความคุ้มค่าในระยะยาว
Tencent Hy4 เปรียบเทียบจุดคุ้มค่ากับโมเดลเรือธง
Tencent Hy4 เปรียบเทียบกับโมเดลเรือธงรายอื่นได้สูสีแต่ตั้งใจวางตัวเป็นโมเดล AI ราคาถูกที่เกิดมาเพื่องานจริง ตั้งแต่เอกสาร การคำนวณ การเขียนโค้ด ไปจนถึงการสร้างเกม โมเดลมีขนาดรวม 7.7 แสนล้านพารามิเตอร์ แต่ขณะทำงานจะเปิดใช้ราว 4.9 หมื่นล้านพารามิเตอร์ รองรับบริบทสูงสุด 1 ล้านโทเคน ทำให้ใช้วิเคราะห์เอกสารจำนวนมาก ตรวจสอบ อ่าน และสรุปเนื้อหาได้แม่นยำ รวมถึงงานคำนวณทางวิทยาศาสตร์และงานโปรแกรมมิ่งซับซ้อน ผลทดสอบระบุว่าขีดความสามารถ Hy4 ใกล้เคียง GLM 5.3 และ Qwen 3.8 Max คือตามหลังโมเดลเรือธงระดับบนอย่าง Claude Opus หรือ GPT รุ่นใหม่ไปเล็กน้อย แต่ยังติดกลุ่มประมาณสิบอันดับแรกของตลาด
ด้านค่าใช้จ่าย Hy4 โดดเด่นในฐานะโมเดล AI ราคาถูกเมื่อเทียบกับคู่แข่งระดับเรือธง ทั้งจากผู้เล่นรายใหญ่และตระกูลโมเดลจีนเอง มีรายงานว่าค่าบริการถูกกว่าตระกูล Qwen หรือ Kimi ประมาณสองถึงสี่เท่า จึงเหมาะกับองค์กรที่เน้นประสิทธิภาพต้นทุนต่ำมากกว่าไล่ระดับสูงสุดของตลาด จุดแข็งอีกด้านคือความสามารถโปรแกรมมิ่งที่สร้างเครื่องมือบนเบราเซอร์ และเปลี่ยนคำสั่งสั้นให้กลายเป็นต้นแบบเกมพร้อมรันบนเอนจินเกมภายนอกได้ทันที อย่างไรก็ดี Hy4 ยังมีข้อจำกัดเรื่องใช้เวลาคิดนานและตรวจทานซ้ำซ้อนมากเกินไปในบางเคส ส่งผลให้บางงานสิ้นเปลืองเวลาและต้นทุนการใช้งานกว่าที่ควร แต่เมื่อเทียบกับราคา โมเดลนี้ยังจัดอยู่ในกลุ่มประสิทธิภาพต้นทุนต่ำที่น่าพิจารณาสำหรับระบบเชิงพาณิชย์
| สเปกหลัก | Qwen3.8-Flash | Hy4 |
|---|---|---|
| สถาปัตยกรรม | MoE 125B + N-gram 51B ใช้งานจริงราว 6B ต่อโทเคน | โมเดล 7.7 แสนล้านพารามิเตอร์ เปิดใช้งานราว 4.9 หมื่นล้านพารามิเตอร์ |
| บริบทสูงสุด | 262K โทเคน ขยายได้ประมาณ 1 ล้านโทเคน | รองรับบริบทสูงสุด 1 ล้านโทเคน |
| แนวทางค่าบริการ | วางกลยุทธ์ค่าบริการเน้นประสิทธิภาพสูงแต่ต้นทุนใช้งานต่ำ | ค่าบริการถูกกว่าโมเดลเรือธงอื่นราว 2–4 เท่า |
| จุดเด่นงานใช้งาน | Agentic Coding งานสำนักงาน การเรียกใช้เครื่องมือ และ AI Agent ภายในองค์กร | งานเอกสารปริมาณมาก การคำนวณวิทยาศาสตร์ การพัฒนาเกมและเครื่องมือบนเบราเซอร์ |
NeoHorse-1-4B AI โมเดลเล็กสำหรับเอเจนต์และการใช้เครื่องมือ
NeoHorse-1-4B เป็นตัวอย่างชัดของ AI โมเดลเล็กที่เน้นประสิทธิภาพต้นทุนต่ำสำหรับเอเจนต์และการใช้เครื่องมือโดยตรง โมเดลนี้มีราว 4 พันล้านพารามิเตอร์ พัฒนาต่อจาก Qwen3.5-4B ผ่านกระบวนการฝึกแบบ routing-guided ที่เก็บบริบทการทำงานของเอเจนต์ การเรียกใช้เครื่องมือ และผลลัพธ์มาป้อนกลับเป็นสัญญาณฝึก ทำให้ถนัดการเลือกเครื่องมือ สร้างคำสั่งแบบมีโครงสร้าง และเดินงานยาวหลายขั้นตอนในสายเอเจนต์ NeoHorse-1-4B รองรับบริบท 262,144 โทเคน และระบุว่าสามารถขยายได้ถึงราว 1,010,000 โทเคน ข้อดีคือเหมาะกับรีโปโค้ดขนาดใหญ่และประวัติงานเอเจนต์ยาว แต่ต้องจัดสรรหน่วยความจำจีพียูและการตั้งค่าการให้บริการให้เหมาะสม เพราะการใช้บริบทสูงสุดจริงอาจขึ้นกับฮาร์ดแวร์
ทางทีมพัฒนาระบุชัดว่า NeoHorse-1-4B เหมาะเลือกใช้เมื่อคุณให้ความสำคัญกับต้นทุนการดีพลอย การใช้หน่วยความจำ และอัตราการประมวลผลมากกว่าความลึกของเหตุผลแบบโมเดลใหญ่ และเมื่อโมเดลระดับ 4 พันล้านพารามิเตอร์ยังตอบโจทย์งานเอเจนต์ เขียนโค้ด หรือระบบ instruction-following ของคุณ เนื่องจากเป็นโมเดลเปิดภายใต้สัญญาอนุญาตแบบ Apache 2.0 ผู้ใช้เชิงพาณิชย์สามารถนำไปปรับใช้ได้โดยมีเงื่อนไขตามใบอนุญาต แต่ตัวโมเดลไม่มีส่วนประเมินอคติ ความเป็นพิษ หรือความปลอดภัย ผู้ใช้จึงควรเสริมการกรองเนื้อหา ระบบอนุญาตเครื่องมือ แซนด์บ็อกซ์ และการตรวจสอบผลลัพธ์ก่อนให้โมเดลดำเนินการที่ส่งผลกระทบสูงในโลกจริง
สมดุลขนาดโมเดล บริบท ต้นทุน และข้อควรระวังความปลอดภัย
เมื่อเปรียบเทียบ Qwen3.8-Flash ต้นทุน Hy4 และ NeoHorse-1-4B จะเห็นภาพชัดของดีไซน์โมเดล AI ราคาถูกในสามแนวทาง Qwen3.8-Flash เลือกใช้ MoE เพื่อให้โมเดลใหญ่ทำงานแบบเปิดใช้พารามิเตอร์จริงเพียงบางส่วน ทำให้ลดต้นทุนฝึกเหลือหนึ่งในเก้าของรุ่นก่อนและยังรักษาผลงานที่แข่งขันกับโมเดลชั้นนำในงานเขียนโค้ด งานสำนักงาน การเรียกใช้เครื่องมือ และ AI Agent ได้ Hy4 เลือกทางโมเดลขนาดใหญ่มากแต่เปิดใช้พารามิเตอร์บางส่วน เพื่อให้รองรับบริบทยาวถึง 1 ล้านโทเคน และให้ประสิทธิภาพใกล้เคียง Qwen 3.8 Max ในค่าบริการที่ถูกกว่าโมเดลเรือธงอื่นราว 2–4 เท่า ส่วน NeoHorse-1-4B ใช้ขนาดเล็กเพื่อให้ดีพลอยง่าย ประหยัดหน่วยความจำ และรองรับเอเจนต์ที่ใช้เครื่องมือจำนวนมากในโลกจริง
ด้านข้อควรระวัง ทั้งสามแนวทางสะท้อนว่าการเลือกโมเดลไม่ใช่แค่สเปก แต่ต้องดูสภาพแวดล้อมดีพลอยด้วย รายละเอียดของ NeoHorse-1-4B ระบุว่าไม่มีข้อมูลความต้องการหน่วยความจำจีพียู ความหน่วงเวลา อัตราโทเคนต่อวินาที และขนาดแบตช์ที่เหมาะสม ทำให้ผู้ใช้ต้องทดลองและจูนเอง รวมถึงไม่มีข้อมูลการประเมินอคติ ความเป็นพิษ ความเป็นส่วนตัว หรือความปลอดภัย จึงควรเสริมระบบกรองและการอนุญาตก่อนให้โมเดลดำเนินการที่มีผลกระทบสูง ในทางเดียวกัน Hy4 แม้ถูกกว่าและอยู่กลุ่มท็อปเท็น แต่ก็มีพฤติกรรมใช้เวลาคิดนานและตรวจทานซ้ำซ้อนมากเกินไป ทำให้บางงานสิ้นเปลืองต้นทุนการใช้งานจริง ภาพรวมคือยิ่งโมเดลใหญ่ บริบทยาว ค่าใช้จ่ายต่อคำสั่งอาจสูงขึ้น แม้ค่าบริการต่อโทเคนจะถูกลงก็ตาม ผู้ใช้จึงต้องคำนึงถึงความสมดุลระหว่างขนาดโมเดล บริบทที่ต้องใช้ และลักษณะงานในระบบของตน
Buy if / Skip if
- Buy the Qwen3.8-Flash if ระบบของคุณเป็นแพลตฟอร์มหรือบริการองค์กรที่ต้องรองรับงานจำนวนมากพร้อมกันและต้องการสมดุลดีที่สุดระหว่างประสิทธิภาพ ความเร็ว และต้นทุนต่อคำสั่ง
- Skip the Qwen3.8-Flash if งานของคุณไม่ต้องใช้บริบทยาวหรือการทำงานแบบเอเจนต์หลายขั้นตอน และเน้นโมเดลเล็กที่ดีพลอยบนฮาร์ดแวร์จำกัดได้ง่ายกว่า
- Buy the Tencent Hy4 if คุณต้องการโมเดลบริบทยาวระดับ 1 ล้านโทเคนสำหรับเอกสารหรือโค้ดจำนวนมาก และยอมรับประสิทธิภาพใกล้เคียงเรือธงในราคาต่ำกว่าประมาณสองถึงสี่เท่า
- Skip the Tencent Hy4 if การตอบสนองรวดเร็วสำคัญกว่าความสามารถวิเคราะห์บริบทยาว และคุณไม่ต้องการรับความเสี่ยงจากการใช้เวลาคิดนานและตรวจทานซ้ำซ้อนในบางงาน
- Buy the NeoHorse-1-4B if คุณต้องสร้าง AI โมเดลเล็กสำหรับเอเจนต์ที่ใช้เครื่องมือจำนวนมาก เขียนโค้ด และต้องให้ความสำคัญกับต้นทุนดีพลอยและการใช้หน่วยความจำจีพียูที่จำกัด
- Skip the NeoHorse-1-4B if ระบบของคุณต้องการเหตุผลเชิงลึกระดับโมเดลใหญ่ หรือคะแนนเบนช์มาร์กสูงสุดในทุกด้าน และไม่พร้อมออกแบบชั้นกรองความปลอดภัยและความเป็นส่วนตัวเอง