
คลังข้อมูลถูกสร้างมาเพื่อมนุษย์ ไม่ใช่ AI agents
สถาปัตยกรรมคลังข้อมูลและ lakehouse แบบดั้งเดิมคือระบบจัดเก็บ แปลง และนำเสนอข้อมูลที่ออกแบบให้มนุษย์ใช้เครื่องมือ BI และ SQL วิเคราะห์ ตีความ และตัดสินใจเอง โดยมีการไหลของข้อมูลเชิงเส้นจากต้นทางไปยังชั้นข้อมูลที่สะอาดเพื่อการรายงาน แต่ไม่ได้ถูกออกแบบให้รองรับ AI agents ที่ทำงานอัตโนมัติ วางแผน ใช้เครื่องมือ และปรับปรุงเวิร์กโฟลว์ด้วยตัวเอง ระบบเหล่านี้จึงมักขาดชั้นความหมาย เชิงบริบท และกลไกการควบคุมที่จำเป็นสำหรับการตัดสินใจโดยเครื่อง
lakehouse แบบเหรียญ Bronze Silver Gold ใช้ได้ดีสำหรับการทำข้อมูลดิบให้ทีม BI เชื่อถือได้ แต่หัวใจของปัญหาคือมันสมมติว่ามีมนุษย์อยู่ปลายทางของทุกคำขอ เช่น เปิดแดชบอร์ด จัดรันงาน dbt หรือกำหนดรายงานที่ต้องอัปเดตเช้านี้ เมื่อเปลี่ยนผู้บริโภคข้อมูลจากมนุษย์เป็น AI agents data analysis ที่ต้องประเมินความน่าเชื่อถือของตัวเลขเอง สมมติฐานนี้เริ่มสั่นคลอนทันที การปล่อยให้ agent ยิง SQL เข้า gold layer อย่างเดียวจึงเสี่ยงต่อการหลอนตัวชี้วัดผิดๆ และการตัดสินใจที่องค์กรไม่มีโอกาสตรวจสอบ
| มิติสำคัญ | สถาปัตยกรรมเดิม | ความต้องการของ AI agents |
|---|---|---|
| ผู้ใช้ปลายทาง | นักวิเคราะห์และทีม BI | agents ที่วางแผนและตัดสินใจเอง |
| รูปแบบการไหลของข้อมูล | เชิงเส้นจากต้นทางสู่รายงาน | เชิงกราฟ มีการวนกลับ ตรวจสอบ และเขียนกลับ |
| บริบทและความหมาย | อาศัยความเข้าใจของคน | ต้องมี semantic layer architecture ที่ชัดเจนและบังคับใช้ |
| การควบคุมและกำกับดูแล | แคตาล็อกและสิทธิ์การเข้าถึงขั้นพื้นฐาน | data governance AI แบบเชิงรุกและแบบเรียลไทม์ |

AI agents ต้องการชั้นความหมาย เครื่องมือที่ถูกกำกับ และ feedback loop
ถ้าองค์กรคิดจะใช้ AI agents data analysis อย่างจริงจัง สิ่งแรกที่ต้องยอมรับคือสถาปัตยกรรมข้อมูลต้องเพิ่มชั้น semantic และกลไกกำกับแบบที่คลังข้อมูลยุคเดิมไม่เคยมี การปล่อยให้ agentเดา context จากชื่อคอลัมน์และสคีมาเปล่าๆ คือการชวนให้เกิดความผิดพลาดแบบเงียบ ที่อันตรายกว่าบั๊กที่ล้มเหลวเสียงดัง เพราะผลลัพธ์ดูสะอาดแต่ผิด
แพลตฟอร์มสำหรับ agents ต้องมี semantic layer ที่ถูกบังคับใช้จริง ไม่ใช่เอกสารใน wiki ที่ไม่มีใครอ่าน ชั้นนี้นิยามความหมายเช่น active customer หรือ revenue ให้เป็นมาตรฐานเดียว และใช้เป็นฐานในการสร้างเครื่องมือและคำสั่ง Agent ยังต้องมี context store เช่นฐานเวกเตอร์เพื่อดึงเอกสาร สายธารข้อมูล และการตัดสินใจก่อนหน้าแทนการเดาจากสคีมาอย่างเดียว พร้อมกันนั้นต้องมีชั้นเครื่องมือที่ทำหน้าที่เป็นตัวกลาง Agents ควรเรียก action ที่นิยามไว้แทนการยิงคำสั่งดิบใส่ storage ซึ่งทั้งช่วยเรื่อง data governance AI และช่วยลดโอกาสที่ agent จะเขียนข้อมูลผิดไปยังตาราง production
- ออกแบบ semantic layer architecture ที่ผูกกับมาตรฐานตัวชี้วัดและนิยามทางธุรกิจ
- สร้างชุดเครื่องมือที่มีสิทธิ์และขอบเขตชัดเจน ให้ agents ใช้แทนการเข้าฐานข้อมูลโดยตรง
- ตั้ง feedback loop ที่บันทึกการตัดสินใจ ตรวจสอบความถูกต้อง และปรับปรุงสูตรวิเคราะห์อย่างต่อเนื่อง
จาก agentic workflows สุ่มเสี่ยง สู่กราฟการทำงานแบบกำหนดได้และทำซ้ำได้
เครื่องมือ agentic workflows ยุคนี้เปิดโอกาสให้คนที่รู้เพียงเล็กน้อยเกี่ยวกับ LLM ทำ data analysis โดยไม่ต้องเขียนโค้ดเอง Agent สามารถตรวจข้อมูล ติดตั้งไลบรารี เขียนสคริปต์ แก้ปัญหา และสร้างผลวิเคราะห์ตามคำสั่งผู้ใช้ แต่ทุกคำขอจะสร้างชุดโค้ดใหม่และเสี่ยงต่อความไม่แน่นอนของโมเดล ผลลัพธ์คือขั้นตอนที่ทำซ้ำไม่ได้ แพง และตรวจสอบยาก
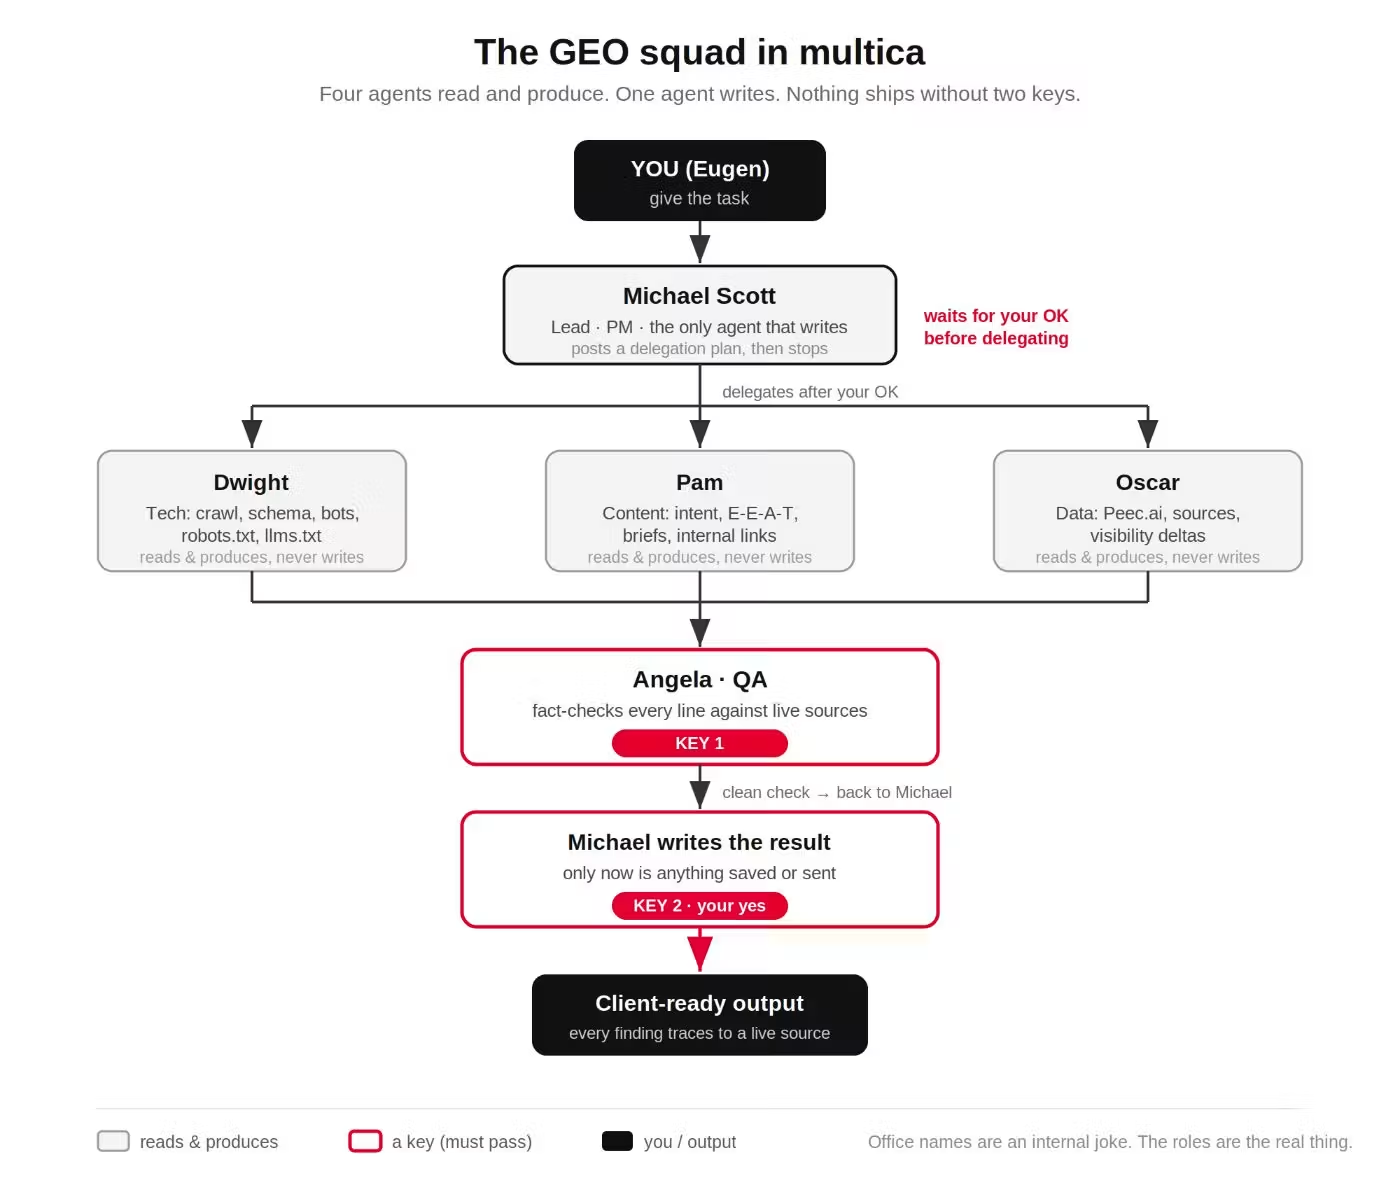
ทางออกไม่ใช่แค่เขียน SKILL.md เพื่อบอกขั้นตอนกว้างๆ แต่คือการนิยามกราฟการทำงานแบบชัดเจนผ่าน artifacts เช่น recipe ที่ระบุลำดับขั้นตอน อินพุต เอาต์พุต และเงื่อนไขการแตกแขนงของเวิร์กโฟลว์อย่างละเอียด สูตรที่ดีจะกำหนดเส้นทางเริ่มต้นของการทำงาน เช่น ขั้น A ตรวจสอบ แล้วค่อยไปขั้น B C และตรวจสอบผลลัพธ์อีกครั้ง นอกจากนี้ต้องบังคับให้มีการประกาศ dependency แบบจำเป็นไม่ใช่ทางเลือก เพื่อให้สร้างสภาพแวดล้อมที่รู้ว่าทำงานแล้วซ้ำได้ และช่วยให้การแก้ปัญหาไม่ไปทำลายส่วนที่เคยทำงานดีอยู่ ถ้าองค์กรยังปล่อยให้ agentแก้บั๊กโดยไม่มีขอบเขต โค้ดที่เคยถูกจะพังเพราะการทดลองที่ไม่จำเป็น
- สร้าง recipe ที่ระบุกราฟการทำงาน agentic workflows อย่างชัดเจน
- ประกาศและตรวจสอบ dependency ทุกตัวให้ครบก่อนถือว่าเวิร์กโฟลว์สมบูรณ์
- ตั้งกติกาการแก้บั๊กให้ agentปรับเฉพาะจุดที่ล้มเหลว ไม่รื้อทั้งกระบวนการ

เมื่อ Text-to-SQL ไปต่อไม่ไหว Agents ต้องการบริบทมากกว่าที่สคีมาให้
หลายองค์กรเริ่มจากการให้ผู้ใช้ถามภาษาไทยหรืออังกฤษ แล้วใช้ Text-to-SQL บนระบบ RAG เป็นทางลัดสู่ AI agents data analysis แต่ประสบการณ์จากงานนำร่องแสดงชัดว่า Text-to-SQL limitations ไม่ใช่เรื่องเล็ก ความล้มเหลวที่น่ากังวลที่สุดคือการล้มเหลวแบบเงียบ คือ query รันผ่าน ได้ผลลัพธ์ แต่ผิดโดยไม่มีสัญญาณเตือน
คำถามข้ามตาราง เช่นการหา revenue จาก 10 SKU แรกในไตรมาสแบ่งตามภูมิภาค ต้อง join ระหว่าง sales_fact product_dim และ region_dim แต่ตัวดึงข้อมูลมักคืนมาเฉพาะบางตารางทำให้โมเดลสร้าง SQL จากสคีมาที่ไม่ครบ เกิดทั้งคอลัมน์หลอนและคำสั่งถูกเชิงไวยากรณ์แต่ผิดเชิงความหมาย ยิ่งไปกว่านั้น การรวมข้อมูลแบบซับซ้อน เช่น conditional aggregation หรือ window functions มักเกินขีดความสามารถของการให้โมเดลสร้าง SQL ครั้งเดียวจากบริบทที่ดึงมา โจทย์ที่พังเหล่านี้มีจุดร่วมคือระบบต้องดูผลลัพธ์ขั้นกลางก่อนตัดสินใจขั้นต่อไป นี่คือเหตุผลว่าทำไมเราต้องขยับจาก Text-to-SQL ตรงๆ ไปสู่แนวทาง agentic ที่ให้ agentรัน วิเคราะห์ และปรับ query ตามสถานการณ์ด้วยบริบทที่กว้างกว่าแค่สคีมา
ข้อดีของ Text-to-SQL
- ตั้งต้นการถามข้อมูลด้วยภาษามนุษย์ได้สะดวก
- ทำงานได้ดีในโจทย์ lookup ง่ายและรวมข้อมูลพื้นฐาน
ข้อจำกัดสำคัญ
- ล้มเหลวแบบเงียบในคำถามรวมข้อมูลระดับกลางและซับซ้อน
- มีปัญหาการดึงสคีมาข้ามตาราง ทำให้ join ผิดหรือขาดบางตาราง
- ไม่รองรับเวิร์กโฟลว์ที่ต้องตัดสินใจจากผลลัพธ์ขั้นกลาง
ออกจากโหมดทดลอง สู่การผลิต: ออกแบบ data governance และสิทธิ์ใหม่เพื่อรองรับ AI agents
จุดเปลี่ยนที่ยากที่สุดไม่ใช่การเลือกโมเดล แต่คือการยอมรับว่า data governance AI และการควบคุมการเข้าถึงต้องถูกออกแบบใหม่สำหรับโลกที่มี agents ตัดสินใจเอง Autonomous agents ที่ทำงานบนข้อมูลองค์กรไร้การตรวจสอบทีละขั้นสร้างคำถามด้านธรรมาภิบาลที่ยังไม่มีใครตอบได้ครบ เช่น ใครมีสิทธิ์อนุมัติการเปลี่ยนสคีมาโดย agent หรือเมื่อ agentด้านต้นทุนทะเลาะกับ agentด้านคุณภาพข้อมูลว่าควรหยุดหรือเดินต่อ pipeline ใครคือกรรมการตัดสิน
คำตอบในทางปฏิบัติตอนนี้คือการมีด่าน human in the loop สำหรับการกระทำที่ไม่สามารถย้อนกลับหรือมีต้นทุนสูง ให้ระบบหยุดรอการอนุมัติ ไม่ใช่เพียงเซ็นยางฝ่ายเดียว และต้องคิดสิทธิ์การเข้าถึงใหม่ ไม่ให้ agentมี write access ต่อ production tables แบบไร้ขอบเขต โครงสร้าง bronze silver gold ยังมีคุณค่าอยู่ แต่ชั้นบนของสถาปัตยกรรมต้องเปลี่ยนจากแดชบอร์ดสำหรับคนไปเป็นแพลตฟอร์มที่จัดการ trust กับกระบวนการที่ไม่หลับและไม่ถามผู้จัดการก่อนลงมือ ถ้าองค์กรยังคิดว่า AI pilot กับระบบผลิตใช้กติกาเดียวกัน เท่ากับปล่อยให้ agentทดลองบนทรัพย์สินข้อมูลที่มีค่าโดยไม่มีราวกันตก
องค์กรควรเริ่มออกแบบใหม่จากจุดไหนเมื่อจะนำ AI agents เข้าสู่ระบบผลิต
เริ่มจากการทำแผนที่เวิร์กโฟลว์ทั้งหมดที่ agentจะมีส่วนร่วม กำหนด semantic layer ให้ชัด เจาะจงเครื่องมือที่ agentเรียกได้ ออกแบบสิทธิ์และ checkpoint ที่มนุษย์ต้องเข้ามาตัดสินใจ แล้วจึงค่อยเชื่อมต่อเข้ากับ lakehouse เดิมแทนการให้ agentเข้าถึงคลังข้อมูลโดยตรง