
AI ในเครื่องไม่จำเป็นต้องเริ่มจากเครื่องแรงที่สุด
โมเดล AI ในเครื่องคือระบบปัญญาประดิษฐ์ที่ประมวลผลบนคอมพิวเตอร์ของผู้ใช้ แทนการส่งคำถามและไฟล์ไปยังบริการคลาวด์ จึงช่วยเพิ่มความเป็นส่วนตัวและเปิดทางให้ใช้งานโมเดลเปิดน้ำหนักได้โดยตรง แม้ฮาร์ดแวร์มีข้อจำกัด
ประเด็นสำคัญของข่าวรอบนี้ไม่ใช่แค่โมเดลใหม่ทำคะแนนดีขึ้น แต่คือผู้พัฒนากำลังลดภาระคนละจุด ตั้งแต่ลดจำนวนพารามิเตอร์ที่ทำงานต่อคำขอ ออกแบบชั้นประมวลผลให้ใช้ซ้ำ ไปจนถึงดึงส่วนของโมเดลจาก SSD เฉพาะเวลาที่ต้องใช้ แนวทางเหล่านี้ทำให้การรัน AI ในเครื่องไม่จำกัดอยู่แค่คอมพิวเตอร์ระดับศูนย์ข้อมูล แต่ก็ไม่ได้แปลว่าเครื่องทั่วไปจะทำงานได้เร็วเท่ากันทุกกรณี
เมื่อวันที่ 17 พฤศจิกายน 2026 OVHcloud เปิดตัว Olala ซึ่งเป็นตระกูลโมเดลภาษาขนาดใหญ่ตระกูลแรกของบริษัท โดยเริ่มจาก Olala mini 7A1B รุ่นกะทัดรัด และระบุว่าออกแบบให้ทำงานบน GPU ที่มีหน่วยความจำ 8 GB ได้ บริษัทวางแผนเผยแพร่โมเดลบน Hugging Face ภายใต้สัญญาอนุญาต Apache 2.0 พร้อมน้ำหนักโมเดลและเอกสารประกอบด้านการปฏิบัติตามกฎหมาย AI ของสหภาพยุโรป
จังหวะนี้มาถึงเมื่อความรู้และเครื่องมือสำหรับฝึกโมเดลเข้าถึงได้กว้างขึ้น และต้นทุนการฝึกลดลงเหลือหนึ่งใน 20 ภายในสามปี ตามคำกล่าวของ Klaba ผลคือผู้ใช้เริ่มมีทางเลือกนอกเหนือจากการพึ่งบริการปิดบนคลาวด์ แต่คำว่าโอเพนซอร์สหรือเปิดน้ำหนักเพียงอย่างเดียวไม่รับประกันว่าโมเดลจะเหมาะกับงานหรืออุปกรณ์ของทุกคน
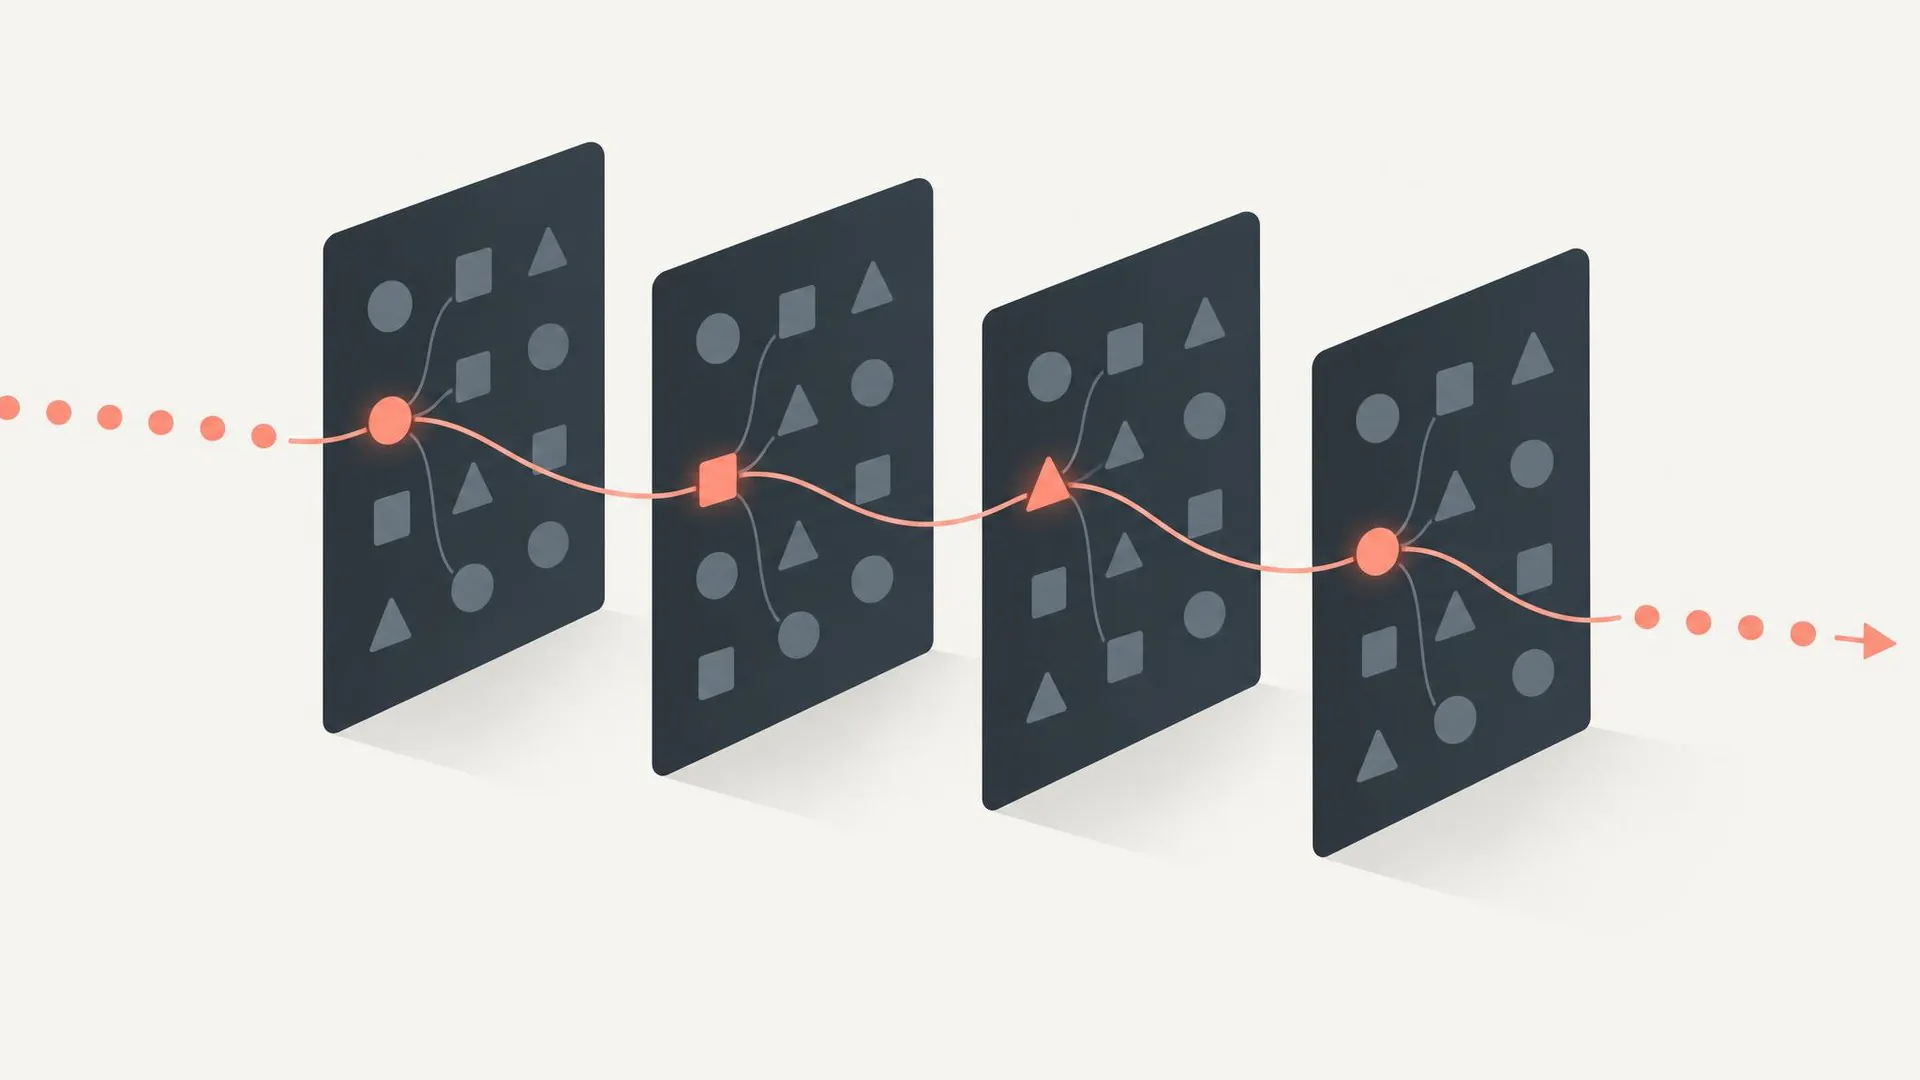
สามวิธีลดภาระ: ใช้พารามิเตอร์น้อยลง วนซ้ำ หรือสตรีมจาก SSD
Olala mini ใช้พารามิเตอร์รวม 7 พันล้านตัว แต่เปิดใช้งานเพียง 1 พันล้านตัวต่อคำขอ โดยเลือกผู้เชี่ยวชาญจากทั้งหมด 256 หน่วยในแต่ละชั้น แนวทางนี้ลดงานที่ต้องประมวลผลในแต่ละครั้ง จึงมุ่งให้โมเดลขนาดใหญ่ทำงานได้บนฮาร์ดแวร์ที่มีหน่วยความจำจำกัด บริษัทระบุความเร็ว 160 โทเค็นต่อวินาทีบน RTX A4500 และ 50 โทเค็นต่อวินาทีบนซีพียูทั่วไปโดยไม่มี GPU แต่ตัวเลขเหล่านี้เป็นผลที่รายงานสำหรับอุปกรณ์และเงื่อนไขเฉพาะ
Inkling 2 Mini เลือกเพิ่มความสามารถด้วยสถาปัตยกรรม looped transformer และรูปแบบผู้เชี่ยวชาญหลายแขนง มีพารามิเตอร์รวมทางกายภาพประมาณ 26 พันล้านตัว แต่ใช้ 3 พันล้านตัวต่อโทเค็น โดยนำชั้นกลาง 12 ชั้นกลับมาทำงานวนสามรอบแทนการเพิ่มชั้นจริง การส่งต่อข้อมูลระหว่างรอบและกลไกควบคุมการรับข้อมูลช่วยขัดเกลาการประมวลผล แต่ก็แลกกับการทำงานหลายรอบ จึงควรทดสอบความเร็วจริงบนเครื่องที่จะใช้
อีกแนวทางมาจาก WiCi Infer ซึ่งไม่พยายามบรรจุโมเดลทั้งชุดไว้ในหน่วยความจำ แต่สตรีมเฉพาะส่วนที่ต้องใช้จาก SSD ไปยัง RAM หรือหน่วยความจำ GPU บริษัทระบุว่าแอปเดสก์ท็อปนี้รันโมเดลเปิดน้ำหนักระดับ 800 พันล้านพารามิเตอร์ได้ และทดสอบ Muse Spark Open ขนาด 816 พันล้านพารามิเตอร์บน MacBook Pro ที่มี SSD 1 TB กับ RAM 24 GB โดยแนะนำ RAM 48 GB
สามแนวทางจึงแก้ปัญหาคนละด้าน: Olala ลดจำนวนพารามิเตอร์ที่ทำงานพร้อมกัน, Inkling ใช้ชั้นเดิมซ้ำเพื่อเพิ่มการประมวลผลโดยไม่เพิ่มชั้นจริง และ WiCi ลดความจำเป็นในการโหลดน้ำหนักทั้งหมด แต่แบบสุดท้ายทำให้ SSD เป็นส่วนหนึ่งของสายงาน AI ความเร็วและความจุของไดรฟ์จึงมีผล ไม่ใช่มีพื้นที่เก็บไฟล์พอแล้วจะได้ประสบการณ์ลื่นไหลโดยอัตโนมัติ
เลือกจากงานจริง ไม่ใช่ดูจำนวนพารามิเตอร์อย่างเดียว
ก่อนเลือกโมเดล AI โอเพนซอร์สหรือโมเดลเปิดน้ำหนัก ผู้ใช้ควรตรวจสอบหน่วยความจำที่ต้องใช้จริง รูปแบบความแม่นยำที่รองรับ ความเร็วบนอุปกรณ์ของตน และโปรแกรมที่เชื่อมต่อได้ Inkling 2 Mini รองรับข้อความและภาพ มีบริบทสูงสุด 1 ล้านโทเค็น และใช้งานผ่าน Transformers, Llama App และ MLX ได้ ส่วนรูปแบบน้ำหนักผู้เชี่ยวชาญมีทั้ง NVFP4 และ MXFP8 บริบทขนาดใหญ่เป็นประโยชน์กับเอกสารยาว แต่ไม่ได้รับประกันว่าทุกงานจะตอบแม่นหรือเร็ว
ควรแยกตัวเลขพารามิเตอร์รวมออกจากจำนวนที่ทำงานต่อโทเค็นด้วย เพราะสองค่านี้บอกภาระคนละอย่าง และอย่ามองข้ามการเร่งความเร็วด้วยข้อมูลคาดการณ์หรือการลดความละเอียดของน้ำหนัก ซึ่งอาจต้องแลกกับทรัพยากรและคุณภาพบางด้าน สำหรับ WiCi สิ่งที่ต้องพิจารณาเพิ่มคือ SSD ที่เร็วพอ เพราะข้อมูลโมเดลถูกอ่านเข้าหน่วยความจำเป็นช่วง ๆ ส่วนผู้ต้องการใช้ภาพควรทดสอบงานด้านการมองเห็นโดยตรง ไม่ควรอนุมานจากความสามารถด้านข้อความ
ประโยชน์ที่จับต้องได้คือความเป็นส่วนตัวเมื่อไฟล์ไม่ต้องออกจากเครื่อง โดยเฉพาะงานภาพลูกค้า ภาพที่ยังไม่เผยแพร่ และคลังส่วนตัว WiCi ระบุว่าแอปเก็บการประมวลผลไว้บนเครื่อง และเปิดให้เชื่อมต่อกับเครื่องมือเขียนโค้ด เอกสาร และงานเขียนผ่านจุดเชื่อมต่อโมเดลได้ ขณะเดียวกัน ตัวอย่างการใช้จริงของ Olala กับฟีเจอร์ตอบคำถามของ Qwant ให้คำตอบเร็วขึ้น 20% และลดต้นทุนการดำเนินงานเหลือหนึ่งในสาม เมื่อเทียบกับโมเดลเดิม ตามข้อมูลของ OVHcloud
แผนต่อไปของ OVHcloud คือ Olala รุ่น 1.1 ภายในสิ้นปี 2026 ซึ่งตั้งเป้าขยายบริบทเป็น 128,000 โทเค็นและปรับปรุงการให้เหตุผลทางคณิตศาสตร์ ส่วนรุ่น 2.0 วางแผนให้มีพารามิเตอร์มากกว่า 100 พันล้านตัว WiCi Infer เปิดให้ดาวน์โหลดฟรีแล้วตามข้อมูลของบริษัทผู้พัฒนา แต่ทิศทางที่น่าจับตาไม่ใช่การแข่งขันว่าใครมีโมเดลใหญ่ที่สุด หากเป็นการทำให้ผู้ใช้เลือกสมดุลระหว่างความเป็นส่วนตัว ความเร็ว ความแม่นยำ และฮาร์ดแวร์ได้ด้วยตนเอง
ข้อสรุปคือโมเดล AI ขนาดเล็กและเทคนิคการโหลดแบบใหม่กำลังทำให้การรัน AI ในเครื่องเป็นทางเลือกจริงมากขึ้น แต่ไม่มีวิธีใดลบข้อจำกัดทั้งหมด ผู้ใช้ควรเริ่มจากงานที่ต้องการทำ ตรวจสอบหน่วยความจำและ SSD แล้วทดลองผลลัพธ์บนเครื่องจริงก่อนเลือก โมเดลที่เหมาะไม่จำเป็นต้องใหญ่ที่สุด แค่ทำงานได้ตรงโจทย์โดยไม่ส่งข้อมูลสำคัญออกไปก็มีคุณค่าแล้ว