
ต้นทุน AI coding agent ไม่ได้อยู่ที่ราคาต่อโทเคนอย่างเดียว
ต้นทุน AI coding agent คือค่าใช้จ่ายทั้งหมดที่ทีมวิศวกรรมต้องจ่ายเพื่อให้ AI agent เขียนโค้ด แก้บั๊ก และโต้ตอบจนได้ผลลัพธ์ที่ผ่านการทดสอบเรียบร้อย รวมทั้งจำนวนโทเคนที่ใช้ในทุกอินพุตและเอาต์พุต จำนวนรอบพูดคุย การรีรันเมื่อทำงานผิด และผลกระทบจากข้อความส่วนเกินที่ถูกลากเข้าไปใน context window ทุกครั้งที่เรียกโมเดลใหม่อีกครั้ง ถ้าเราคิดว่าประหยัดงบประมาณ AI แค่จากการเลือกโมเดลราคาถูก เรากำลังมองต้นทุนด้านนี้แบบผิวเผินอย่างน่ากังวล หลายทีมเชื่อว่าตัวเลขค่าบริการต่อโทเคนที่ต่ำกว่าจะช่วยให้ยื่นงบได้ง่ายขึ้น แต่ประสบการณ์จริงเริ่มฟ้องตรงกันว่า โมเดลที่ราคาถูกอาจกลายเป็นกับดักค่าใช้จ่ายซ่อนเร้น โดยเฉพาะเมื่อใช้เป็น coding agent แบบหลายรอบโต้ตอบในโปรเจกต์ใหญ่
Claude model comparison ชี้ชัด โมเดลถูกอาจแพงกว่า 8–14 เท่า
งานทดสอบของทีมวิจัยด้านประสิทธิภาพ AI เปรียบเทียบ Claude Haiku 4.5 กับ Claude Sonnet 5 ในบทบาท coding agent แก้บั๊ก Python หลายเคส พบความย้อนแย้งอย่างแรง Haiku ถูกออกแบบให้เป็นโมเดลเบา ราคาต่อโทเคนถูกกว่าครึ่งทั้งฝั่งอินพุตและเอาต์พุต แต่เมื่อคำนวณต้นทุนต่อการแก้บั๊กที่ผ่านชุดทดสอบที่ซ่อนอยู่จริง กลับจ่ายแพงกว่า Sonnet ถึงประมาณ 8.4–14.1 เท่าต่อหนึ่งบั๊ก ประโยคที่ควรจดจำคือ "โมเดลที่มีอัตราค่าโทเคนครึ่งหนึ่ง แต่ต้นทุนต่อการแก้ไขสำเร็จแพงกว่า 8–14 เท่า แปลว่าราคาป้ายแทบไม่บอกอะไรเลยเกี่ยวกับต้นทุนจริง" ทีมทดลองสร้าง workflow ที่ให้ AI สั่งอ่านไฟล์ แก้โค้ด รันเทสต์วนไปสูงสุด 8 รอบ แต่คิดค่าใช้จ่ายเฉพาะเคสที่ผ่าน hidden tests เท่านั้น ตรงนี้ทำให้เห็นชัดว่า การดูแค่ราคาต่อโทเคนทำให้ทีมประเมินต้นทุน AI coding agent ผิดไปไกล
Token consumption optimization สำคัญกว่าเลือกโมเดลถูก
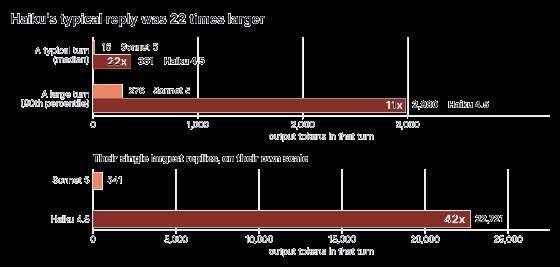
หัวใจของ token consumption optimization คือการควบคุมไม่ให้เอาต์พุตและบริบทสะสมพองตัวโดยไร้ค่า เพราะทุกโทเคนที่เพิ่มเข้าไปในข้อความสนทนา จะกลายเป็นต้นทุนอินพุตในรอบถัดไปเสมอ ในการเปรียบเทียบ Haiku กับ Sonnet พบว่า Sonnet มีจำนวนโทเคนเอาต์พุตต่อรอบแบบมัธยฐานเพียง 16 โทเคน แต่ Haiku กลาง ๆ อยู่ที่ 361 โทเคนต่างกันถึง 22 เท่า และในกรณีเลวร้ายที่สุด Haiku เคยตอบยาวถึง 22,721 โทเคน ขณะที่ Sonnet ยาวสุดแค่ 541 โทเคนเท่านั้น แนวโน้มที่น่าขำกลายเป็นเรื่องน่ากลัว Haiku บางรอบถึงขั้น "สมมติ" ผลลัพธ์การรันคำสั่ง แล้วเขียนสคริปต์ต่อเองอีกหลายสิบคำสั่ง ยัดทุกอย่างในเอาต์พุตเดียว ในขณะที่ระบบ agent รันจริงแค่คำสั่งแรก ที่เหลือจึงเป็นข้อความขยะที่ไม่มีค่า แต่กลับกินโทเคนอินพุตวนไปทุกครั้งที่เรียกโมเดลถัดไป สร้างต้นทุนบานปลายแบบทวีคูณ
เมื่อ custom skills และพรอมพ์บวม ทำให้ต้นทุนพุ่งแบบเงียบ ๆ
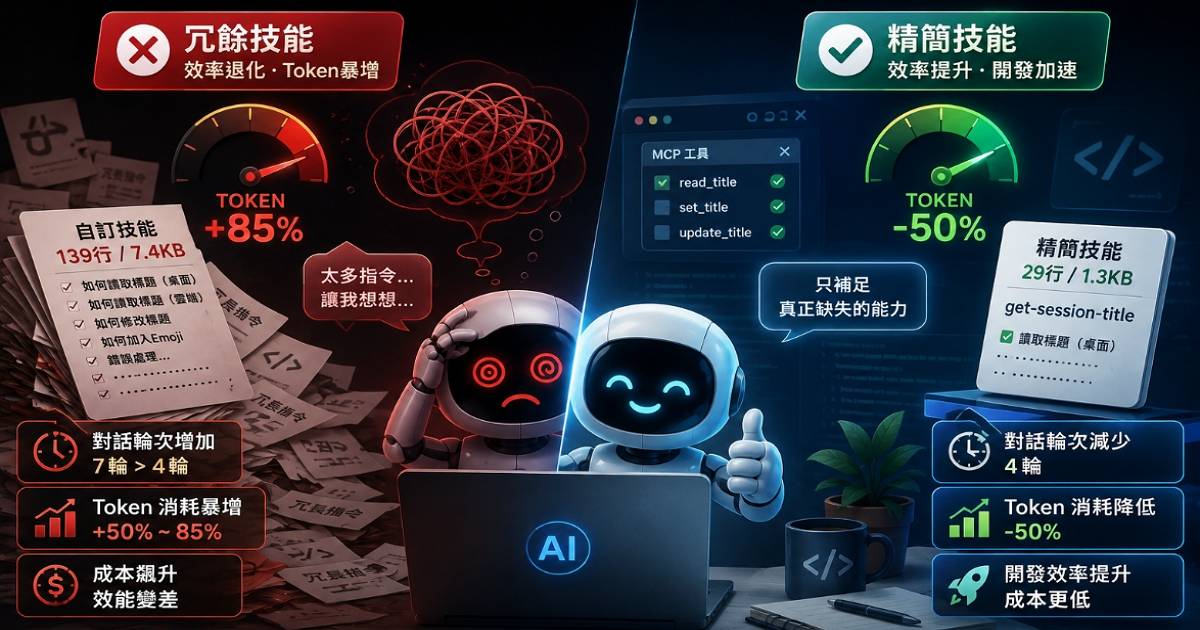
อีกด้านหนึ่งของ token bloat มาจากการออกแบบ AI skills แบบไม่ระวัง วิศวกรรายหนึ่งทดลองเพิ่ม custom skill ให้ Claude Code เพื่อจัดการชื่อ session ทั้งบนเดสก์ท็อปและคลาวด์ เขาเริ่มจากสคริปต์ราว 78 บรรทัด แล้วขยายให้ครอบคลุมทั้งสองสภาพแวดล้อมจนบวมเป็น 139 บรรทัด เพื่ออธิบายวิธีใช้เครื่องมือ MCP อย่างละเอียด แม้คลาวด์จะมีเครื่องมืออ่านและตั้งชื่อ session ในตัวอยู่แล้ว ผลจาก AI efficiency testing ในคลาวด์ชี้ชัดว่า เมื่อเปิดใช้สกิลนี้ การเปลี่ยนชื่อ เพิ่ม emoji และอ่านชื่อ session ยังสำเร็จ 100 เปอร์เซนต์เท่าเดิม แต่โทเคนที่ใช้ใน cache read กลับพุ่งขึ้นราว 11–85 เปอร์เซนต์ เท่ากับสกิลไม่ช่วยให้ทำงานเร็วขึ้น กลายเป็นเพียงข้อความส่วนเกินที่กินช่อง context window ไปฟรี ๆ เมื่อทดสอบบนเดสก์ท็อป เขาจึงหั่นสกิลให้เหลือเฉพาะความสามารถที่โมเดลไม่มีจริง ๆ คือการอ่านชื่อจากไฟล์ในเครื่อง ทำให้จำนวนรอบสนทนาลดลงและโทเคนถูกลงครึ่งหนึ่ง นี่คือภาพชัด ๆ ว่า custom skills ที่เขียนเผื่อทุกอย่างคือดาบสองคม
ถ้าอยากประหยัดงบประมาณ AI ต้องวัดต้นทุนต่อผลลัพธ์ ไม่ใช่ต่อโทเคน
ทั้งกรณี Claude model comparison และสกิลบวมของ Claude Code สะท้อนบทเรียนเดียวกัน การประหยัดงบประมาณ AI ที่ยั่งยืนต้องย้ายจาก "มองราคาต่อโทเคน" ไปสู่ "มองต้นทุนต่อผลลัพธ์ที่ตรวจสอบแล้ว" สำหรับ coding agent คือจำนวนโทเคนและรอบพูดคุยที่ใช้ต่อหนึ่งบั๊กที่ผ่านชุดเทสต์ซ่อนอยู่จริง ไม่ใช่แค่การที่โมเดลประกาศว่าซ่อมเสร็จเอง ทีมวิศวกรรมจึงควรสร้างกรอบ AI efficiency testing ของตัวเอง ตั้งสคริปต์อัตโนมัติวัดจำนวนรอบสนทนา โทเคนอินพุตและเอาต์พุต ก่อนและหลังเปิดใช้แต่ละ skill แล้วตัดทิ้งสกิลที่ทำให้โทเคนและเวลาเพิ่มขึ้นโดยไม่เพิ่มอัตราความสำเร็จเลย คำแนะนำสำคัญคือยึดหลัก "แทรกแซงให้น้อยที่สุด" เติมเฉพาะความสามารถที่โมเดลไม่มีจริง ๆ พร้อมประเมินซ้ำเป็นระยะ เพราะเมื่อโมเดลรุ่นใหม่เริ่มมีเครื่องมือ MCP ในตัวมากขึ้น สกิลเก่าอาจกลายเป็นภาระมากกว่าประโยชน์ ถ้าไม่กล้าล้างออก ต้นทุน AI coding agent ของทีมจะถูกกัดเซาะเรื่อย ๆ อย่างเงียบ ๆ