
จุดเปลี่ยนของ AI ที่ทำงานได้โดยไม่ส่งข้อมูลออกจากเครื่อง
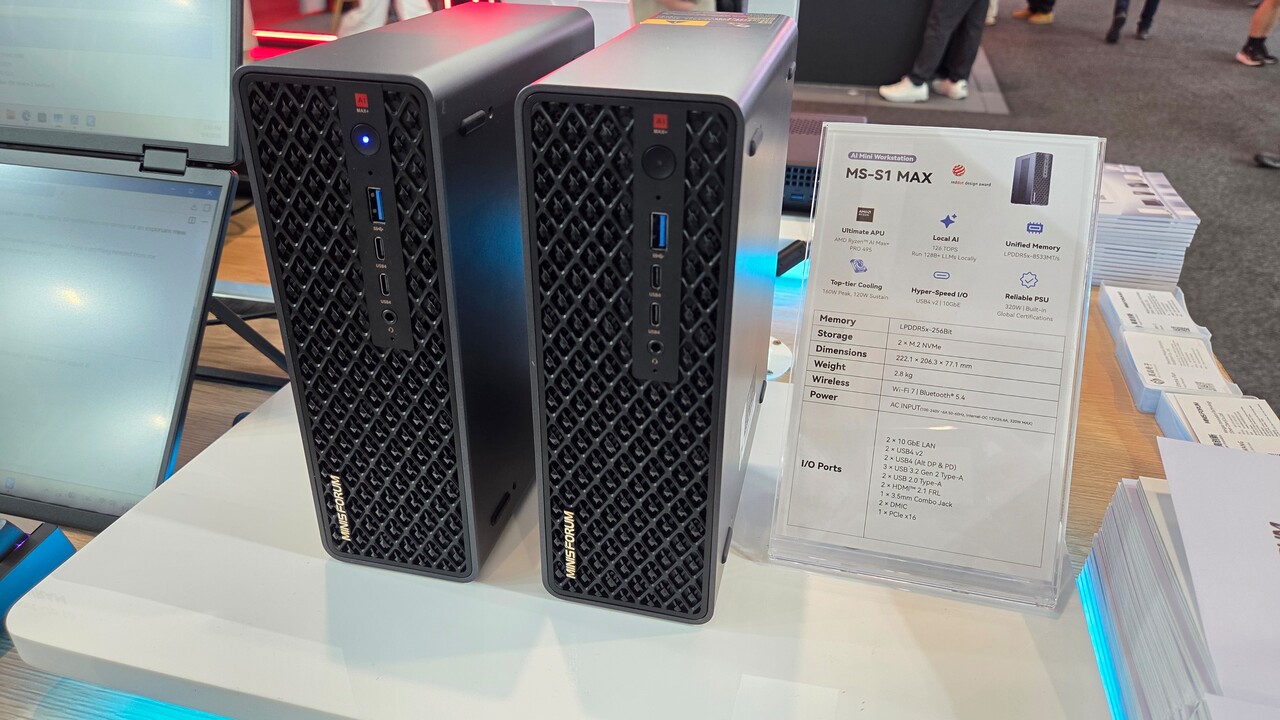
AMD Ryzen AI Max คือแพลตฟอร์มประมวลผลที่รวม CPU กราฟิก NPU และหน่วยความจำไว้ในระบบเดียว เพื่อให้ผู้ใช้พัฒนาและเรียกใช้โมเดล AI ขนาดใหญ่ในเครื่องได้ โดยไม่จำเป็นต้องส่งทุกงานไปประมวลผลบนคลาวด์ วันที่ 27 ตุลาคม 2569 พาร์ทเนอร์ของ AMD เปิดตัวระบบที่ใช้ AMD Ryzen AI Max และ Ryzen AI Max PRO 400 Series ซึ่งออกแบบมาเพื่อรองรับเอเจนต์ AI ภายในองค์กร ประเด็นสำคัญไม่ใช่แค่การเพิ่มความแรงของชิป แต่เป็นการย้ายงานที่เคยต้องพึ่งเซิร์ฟเวอร์หรือบริการออนไลน์กลับมาอยู่ใกล้ข้อมูลและผู้ใช้งานมากขึ้น การเปลี่ยนนี้ตอบโจทย์ช่วงที่เอเจนต์เริ่มทำงานหลายขั้นตอนต่อเนื่อง และองค์กรต้องตัดสินใจว่าจะให้เอเจนต์เข้าถึงข้อมูลใด รวมถึงงานแบบไหนควรอยู่ในเครื่องหรือส่งขึ้นคลาวด์ สำหรับองค์กร local AI inference จึงเริ่มมีน้ำหนักในฐานะทางเลือกใช้งานจริง ไม่ใช่เพียงการทดลองโมเดล
หน่วยความจำมากพอเปลี่ยนขนาดงานที่ทำได้
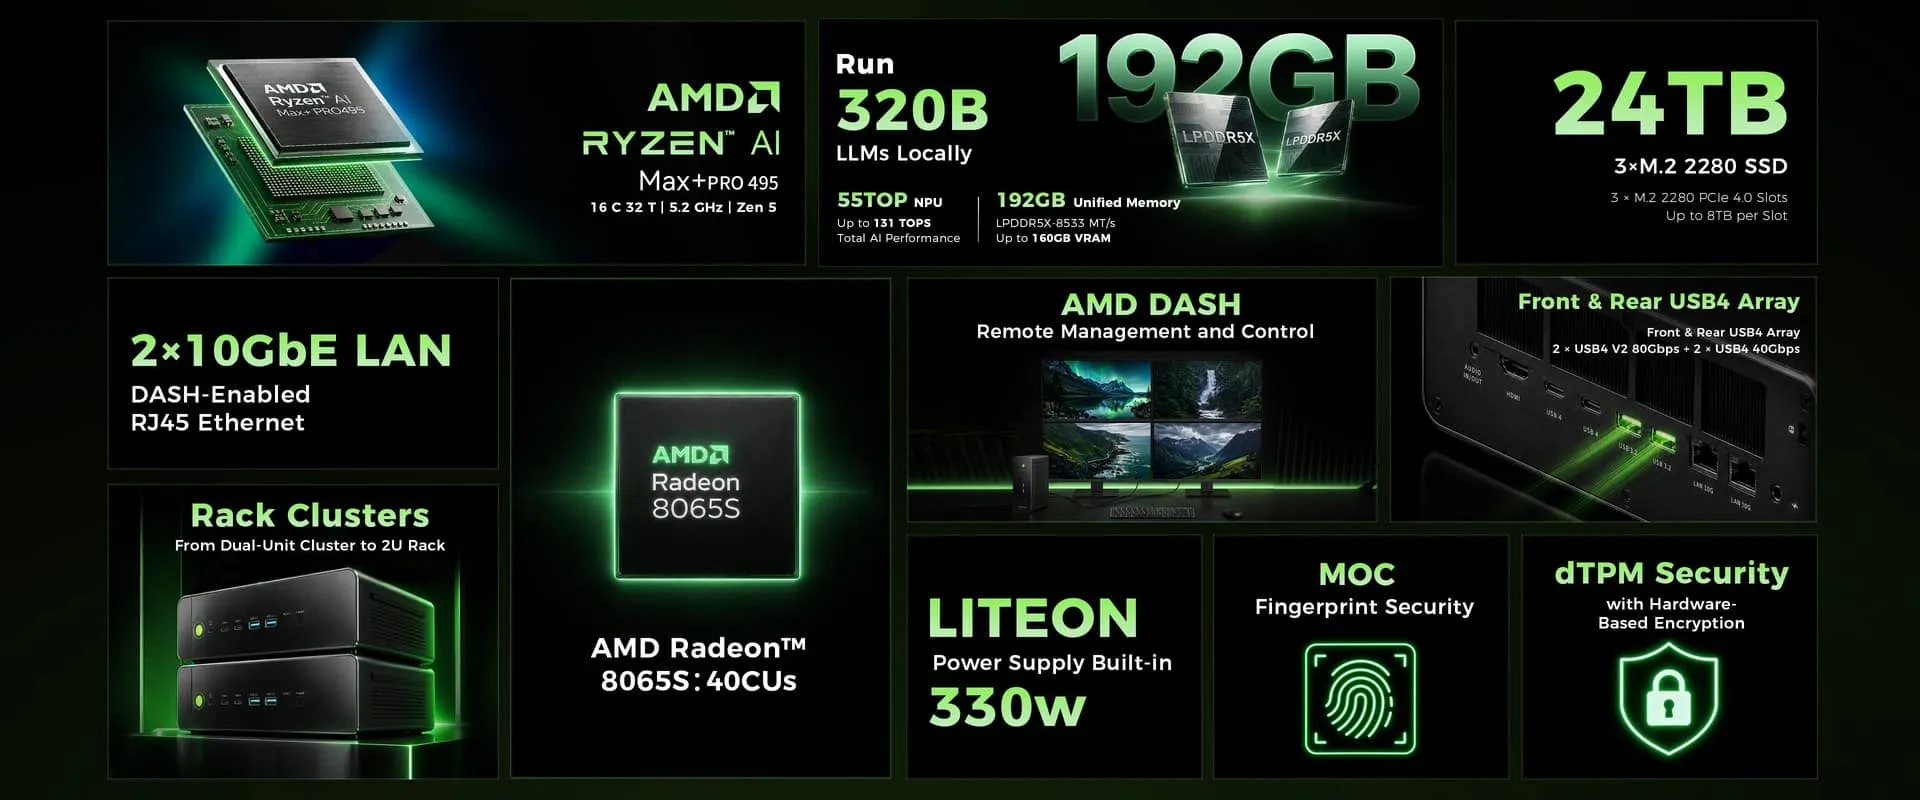
ความก้าวหน้าหลักของรุ่นใหม่คือสถาปัตยกรรม Unified Memory ที่รองรับหน่วยความจำสูงสุด 192GB และจัดสรรให้เวิร์กโหลด GPU ได้ถึง 160GB เพิ่มจากระบบรุ่น 300 Series ซึ่งรองรับสูงสุด 128GB และแบ่งให้ GPU ได้ 96GB AMD ระบุว่า Ryzen AI Max PRO 400 Series เป็นโปรเซสเซอร์ไคลเอนต์ x86 รุ่นแรกที่รันโมเดลขนาดใหญ่กว่า 3 แสนล้านพารามิเตอร์ในระดับ 4-bit Quantization ได้จบภายในเครื่อง จุดนี้สำคัญเพราะเอเจนต์มักต้องใช้หลายโมเดล มีหน้าต่างบริบทขนาดใหญ่ และเรียกดูข้อมูลจากองค์กรระหว่างทำงาน ความจุหน่วยความจำที่เพิ่มขึ้นจึงเปิดทางให้ทำงานซับซ้อนขึ้นโดยไม่ติดข้อจำกัดเดิมเร็วเกินไป แต่ตัวเลขนี้ไม่ควรถูกเข้าใจว่าโมเดลทุกชนิดจะทำงานได้เร็วเท่ากัน ประสิทธิภาพจริงยังขึ้นกับรูปแบบโมเดล งานที่มอบหมาย และการตั้งค่าระบบ
ความเป็นส่วนตัวได้ประโยชน์ แต่คลาวด์ยังมีบทบาท
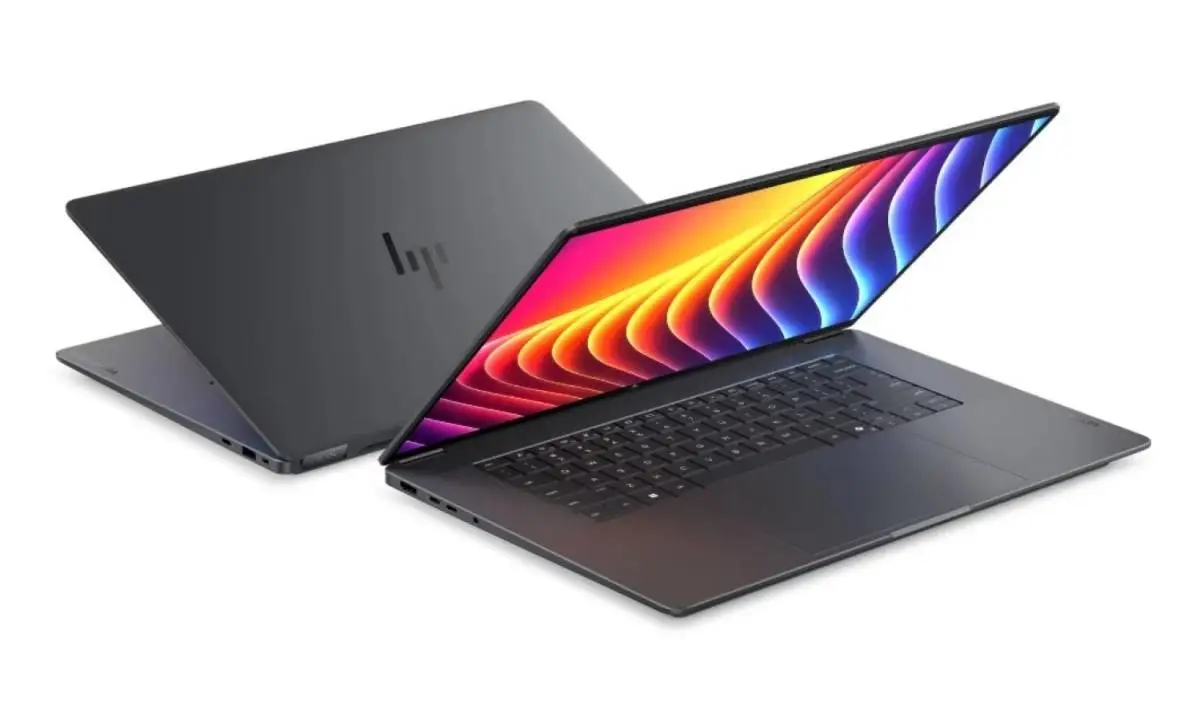
ข้อได้เปรียบที่ชัดที่สุดของการประมวลผลในเครื่องคือการควบคุมข้อมูล เอกสารภายใน ไฟล์วิศวกรรม ซอร์สโค้ด และข้อมูลอ่อนไหวสามารถอยู่ในระบบขององค์กร โดยไม่ต้องส่งข้อมูลหรือคำสั่งไปยังบริการภายนอก นี่ทำให้ on-device language models น่าสนใจสำหรับงานที่ความลับสำคัญพอ ๆ กับคุณภาพคำตอบ และลดการรอคิวหรือการเชื่อมต่อที่อาจเป็นคอขวดของงานคลาวด์ อย่างไรก็ตาม การย้ายทุกอย่างมาไว้ในเครื่องไม่ใช่คำตอบเดียว โมเดลคลาวด์ยังเหมาะกับงานที่ต้องการความสามารถสูงกว่าที่โมเดลท้องถิ่นรองรับ ขณะที่การจัดระบบแบบผสมช่วยเก็บงานทั่วไปไว้ในเครื่องและเลือกใช้คลาวด์เฉพาะเมื่อจำเป็น ตัวอย่างจาก HP แสดงการใช้ Ryzen AI Max+ PRO 495 กับโน้ตบุ๊ก ZBook Ultra G3a 16 เพื่อเปิดแอปพลิเคชันระดับมืออาชีพควบคู่กับโมเดลและเอเจนต์ในเครื่อง พร้อมสลับไปใช้โมเดลคลาวด์ได้ สำหรับผู้ใช้ทั่วไป แนวทางนี้อาจหมายถึงการทำงานกับโค้ดหรือมอบหมายโครงการได้โดยไม่ต้องส่งเวิร์กโหลดขึ้นคลาวด์ทุกครั้ง
การแข่งขันกำลังขยับสู่โมเดลที่ทำงานใกล้ผู้ใช้
การเปิดตัวของ AMD เกิดขึ้นท่ามกลางการแข่งขันเพื่อทำให้เอเจนต์ทำงานได้ตั้งแต่ระบบองค์กรไปจนถึงอุปกรณ์ปลายทาง โดย Nvidia เปิดตัว Nemotron 3.5 Super VL ซึ่งเป็นโมเดลแบบเปิดขนาด 120 พันล้านพารามิเตอร์ และ Bolt 74B-A9B ที่ออกแบบสำหรับงานเอเจนต์ในเครื่อง รุ่น Bolt ใช้พารามิเตอร์ 9 พันล้านตัวจากทั้งหมด 74 พันล้านตัวในแต่ละครั้ง และลดขนาดแบบ 2 บิตให้เหมาะกับหน่วยความจำ 24GB บริษัทระบุว่าจะปล่อยชุดข้อมูลแบบเปิดบน Hugging Face และเตรียมเปิดตัว Bolt E4B ขนาด 4GB ในช่วงปลายเดือนนี้สำหรับอุปกรณ์ปลายทาง ภาพรวมนี้ย้ำว่า local AI inference ไม่ได้มีคำตอบจากชิปเพียงอย่างเดียว แต่ต้องมีโมเดลและเครื่องมือที่เหมาะสมด้วย ข้อสรุปของ AMD จึงไม่ใช่ว่าคลาวด์หมดความสำคัญ หากเป็นการเพิ่มทางเลือกให้ทีมงานเลือกตำแหน่งประมวลผลตามความลับของข้อมูล ขนาดงาน และความสามารถที่ต้องการ