
Enterprise AI คืออะไรเมื่อมองจากมุมโครงสร้างข้อมูล ไม่ใช่แค่โมเดล
Enterprise AI คือการนำปัญญาประดิษฐ์มาเชื่อมกับข้อมูล กระบวนการ และระบบขององค์กรผ่านสถาปัตยกรรมข้อมูลที่ขยายตัวได้ มีการกำกับดูแลข้อมูลอย่างเป็นระบบ และมี machine learning pipelines ที่ต่อเชื่อมตั้งแต่การเก็บข้อมูลไปจนถึงการใช้งานจริง เพื่อแปลงข้อมูลปริมาณมหาศาลให้เป็นการตัดสินใจของธุรกิจที่ใช้ได้จริง ไม่ใช่แค่การทดลองในห้องแลบ หัวใจของบทความนี้คือ ถ้าองค์กรคิดว่า AI เท่ากับการนำโมเดลมาเทรนหรือเรียกใช้ API เพียงอย่างเดียว โครงการส่วนใหญ่มีแนวโน้มจะล้มเหลว เพราะโครงสร้างพื้นฐานข้อมูลและ AI data governance คือรากฐานที่แท้จริงของ enterprise data infrastructure การสนทนาระดับโลกกำลังชี้ชัดว่า Enterprise AI needs governed data rails, not just models การไม่มีรางข้อมูลที่ถูกกำกับทำให้โมเดลต้องทำงานบนข้อมูลที่ไม่ต่อเนื่อง ไม่สะอาด และควบคุมไม่ได้
เมื่อข้อมูลโตเร็วกว่าพื้นที่เก็บ: สเกลของปัญหาใหญ่กว่าโมเดลมาก
หากมองภาพเศรษฐกิจ AI ผ่านมุม compute เพียงอย่างเดียว วันนี้เรากำลังมองผิดจุด แกนของต้นทุนกำลังขยับจาก GPU ไปสู่ข้อมูลที่ AI ใช้และสร้างขึ้น เมื่อมีการสำรวจผู้ตัดสินใจด้าน IT และธุรกิจ 763 รายในเจ็ดประเทศ พบว่าสเกลข้อมูลโลกโตเร็วจนน่าตกใจ โลกถูกคาดการณ์ว่าจะสร้างข้อมูล 274 zettabytes ในปี 2026 และมากกว่า 718 zettabytes ในปี 2030 ขณะที่ความจุการจัดเก็บติดตั้งจริงมีประมาณ 13 zettabytes และจะเพิ่มเป็นกว่า 26 zettabytes ในช่วงเดียวกัน ช่องว่างระหว่างข้อมูลที่สร้างกับข้อมูลที่เก็บไม่ใช่เรื่องเทคนิคอย่างเดียว แต่คือคำถามเชิงกลยุทธ์ว่าข้อมูลใดคุ้มค่าที่จะรักษาไว้ เพื่อเป็น training input เป็น retrieval context เป็น compliance record หรือเป็นแหล่งสำหรับ use case ที่ยังไม่ถูกนิยาม นี่คือหัวใจของ AI data governance ที่องค์กรจำนวนมากยังไม่กล้าตัดสินใจอย่างจริงจัง
จากโมเดลเดี่ยวสู่สถาปัตยกรรมข้อมูลที่ขยายตัวได้และมีการกำกับ
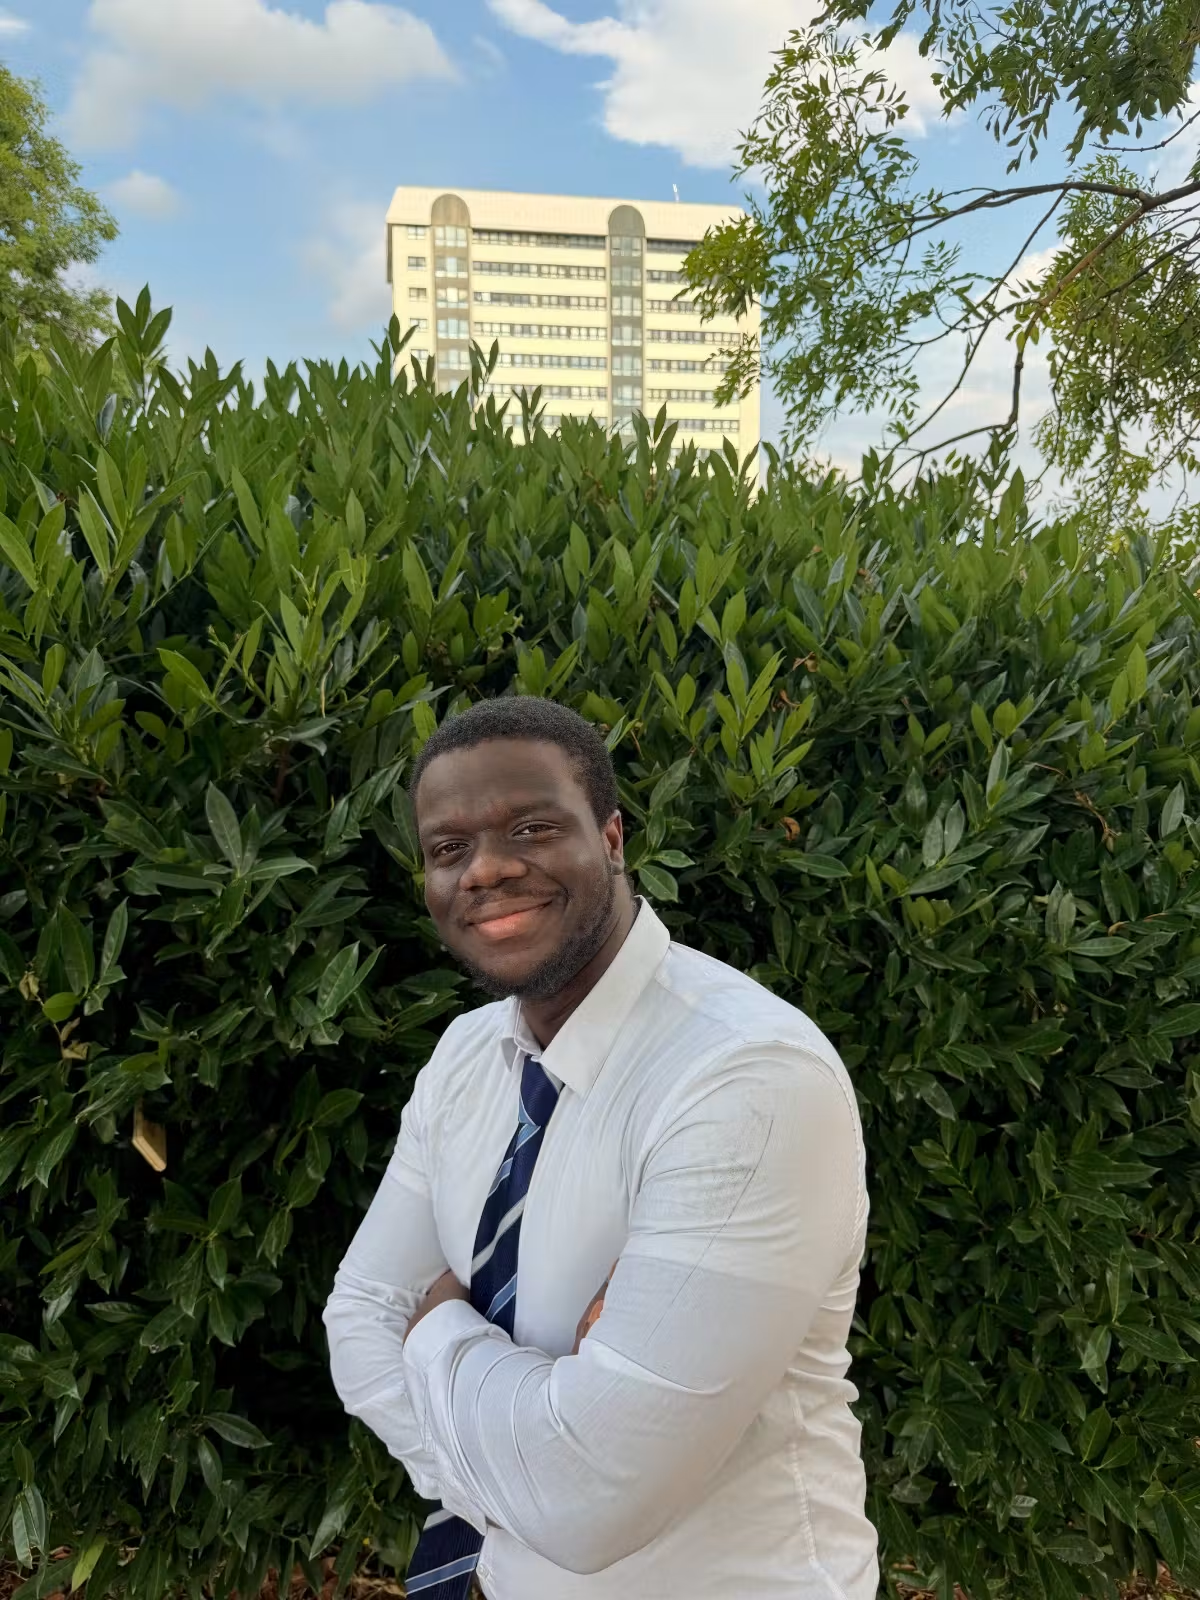
บทเรียนจากงานภาคสนามของนักวิทยาศาสตร์ข้อมูลสายผลิต เช่น David‑King Adeduntan ชี้ชัดว่า โมเดลที่เก่งไม่มีมูลค่าเลยถ้า data architecture ใต้พื้นพังทลาย เขาพัฒนา production‑ready data pipelines โมเดลทำนาย และกระบวนการ automation ที่แปลงข้อมูลไม่เป็นระเบียบให้กลายเป็น actionable intelligence และย้ำว่า failure ส่วนใหญ่ไม่ได้มาจากโมเดลแย่ แต่จาก data pipelines ที่ไม่ครบ เขาออกแบบ ETL pipelines เฟรมเวิร์ก predictive analytics ระบบตรวจจับความผิดปกติแบบอัตโนมัติ และ business intelligence ที่พร้อมผลิตจริง เพื่อให้บริษัทเดินหน้าจากการรายงานย้อนหลังไปสู่การตัดสินใจเชิงรุก นี่คือตัวอย่างชัดเจนของการผสาน AI machine learning pipelines และ scalable data architecture ให้เป็น enterprise intelligence ที่ตอบโจทย์การดำเนินงาน ไม่ใช่แค่สไลด์พรีเซนต์ในห้องประชุม
วงจรชีวิตข้อมูลใหม่: ข้อมูลไม่เย็นอย่างเดียว แต่วอร์มขึ้นลงตลอดเวลา
องค์กรจำนวนมากเคยคิดว่าข้อมูลจะค่อยๆ เย็นลงตามเวลา จาก hot ไป warm ไป cold แล้วถูกเก็บถาวร แต่การมาของ AI เปลี่ยนสมมติฐานนี้ งานวิจัยที่ได้รับการสนับสนุนจากผู้ผลิตสตอเรจชั้นนำพบว่า 74.3% ขององค์กรระบุว่า AI ทำให้ต้องเก็บข้อมูลนานขึ้น 75.9% นำข้อมูลในชั้น cold กลับมาออนไลน์เพื่อรองรับงาน AI และ 96% คาดว่าจะต้องการการดึงข้อมูลจาก archive ที่เร็วขึ้นสำหรับ inference หรือ retrieval‑augmented generation หรือ RAG ผลคือข้อมูลไม่ได้เย็นลงด้านเดียว แต่มีวงจรอุ่นเย็นสลับไปมา องค์กรบางแห่งติดตั้ง SSD ขนาดใหญ่สำหรับ training จากนั้นรื้อและแทนที่ด้วย HDD เพื่อเป็น backbone storage สำหรับ inference สิ่งนี้แสดงให้เห็นว่า enterprise data infrastructure ที่ชนะไม่ใช่การเลือกข้าง HDD หรือ SSD แต่คือ tiered system ที่ถูกปรับแต่ง end to end ตั้งแต่การใช้พลังงาน การใช้ GPU และทุกชั้นของ storage
โครงสร้างพื้นฐานและ Data Governance คือความได้เปรียบ ไม่ใช่ความเร็วโมเดล
องค์กรจำนวนมากกำลังเจ็บจาก AI implementation challenges ซ้ำเดิม พวกเขามีข้อมูลไม่เป็นโครงสร้างจำนวนมหาศาล แต่กลับขาดความสามารถในการวิเคราะห์เพื่อการตัดสินใจรวดเร็ว AI data governance ที่หายไปทำให้ไม่รู้ว่าข้อมูลไหนใช้ได้ ใช้ได้อย่างไร และอยู่ที่ไหน ส่งผลให้ pipelines ขาดช่วงและโครงการไม่ไปถึง production ข้อเท็จจริงที่ไม่ค่อยมีใครอยากยอมรับคือ token‑level costs เป็นเพียงผลลัพธ์ปลายน้ำจากการตัดสินใจด้านโครงสร้างพื้นฐานข้อมูล ไม่ใช่จุดตั้งต้นในการวางแผน มีผู้ให้ข้อมูลในงานวิจัยเดียวกันประเมินว่า ทุกหนึ่งหน่วย compute ใหม่ต้องการ storage มากกว่าเดิมสองถึงสามเท่า และเป็นความต้องการทันทีไม่ใช่อนาคต เหตุนี้จึงไม่เกินเลยที่จะบอกว่า economics ของ AI ถูกกำหนดโดยจุดที่อ่อนที่สุดในระบบ ไม่ใช่ส่วนที่เร็วที่สุด โครงสร้าง storage การจัดการข้อมูล และกรอบ governance ที่ดีจึงกลายเป็นความได้เปรียบเชิงการแข่งขันที่สำคัญกว่าความเร็วโมเดล ทางออกข้างหน้าไม่ใช่การเร่งเทรนโมเดลเพิ่ม แต่คือการวางแผนวงจรชีวิตข้อมูลทั้งเส้น ตั้งแต่การเลือกเก็บข้อมูลที่มีคุณค่า การออกแบบ machine learning pipelines ที่ต่อเนื่อง และการกำกับดูแลข้อมูลอย่างโปร่งใส องค์กรที่คิดแบบโครงสร้างนี้ตั้งแต่วันนี้จะเป็นผู้ที่แปลงสเกลของ AI ให้กลายเป็นมูลค่าที่ยั่งยืนได้ดีที่สุด