
AI agents ที่รัน 24/7 ไม่ใช่แค่โค้ดดี แต่คือการยอมจ่ายภาษีโครงสร้างพื้นฐาน
การรัน AI agents infrastructure ให้ทำงานอัตโนมัติแบบต่อเนื่อง 24/7 หมายถึงการเปลี่ยนสคริปต์ทดลองบนเทอร์มินัลให้กลายเป็นระบบที่ต้องรับผิดชอบต่อความพร้อมใช้งาน ความปลอดภัย การเฝ้าดูพฤติกรรมของโมเดล และการกู้คืนจากความล้มเหลว ซึ่งทั้งหมดนี้คือภาษีโครงสร้างพื้นฐานที่องค์กรต้องจ่ายเพิ่มบนเส้นทางสู่ AI productivity ROI แม้จะไม่ปรากฏอยู่ในใบแจ้งค่าใช้จ่ายตรงๆ ก็ตาม
ผู้สร้างเอเจนท์จำนวนมากเริ่มจากการมีสคริปต์ที่อ่านคิวงาน เรียกใช้ LLM เรียกใช้เครื่องมือ เขียนเอาต์พุต แล้ววนลูปบนแล็ปท็อปของตัวเอง มันดูน่าตื่นเต้นจนหลายทีมรีบปล่อยให้มันทำงานยาวข้ามคืน แต่เช้าวันถัดมาพบว่าแล็ปท็อปเข้าสู่โหมดพัก กระบวนการหยุดเงียบๆ หรือเอเจนต์ใช้ทรัพยากร API ไปมหาศาลเพราะติดอยู่ในลูปการลองใหม่ที่ไม่มีใครเฝ้าดู ภาพฝันด้าน AI productivity ROI จึงเริ่มเปิดเผยด้านมืดของค่าใช้จ่ายที่ไม่เคยถูกนำมารวมในสไลด์ Pitch: เวลา DevOps ที่ต้องทุ่มให้โครงสร้างพื้นฐาน และความเสี่ยงจากการปล่อยให้ระบบอัตโนมัติทำงานในสภาพแวดล้อมที่ไม่พร้อมจะรับผิดชอบมันจริงๆ
ตัวอย่าง Cloudflare: ประสิทธิภาพที่เพิ่มขึ้น 85% แลกกับวินัยด้านโครงสร้างพื้นฐานเข้มข้น
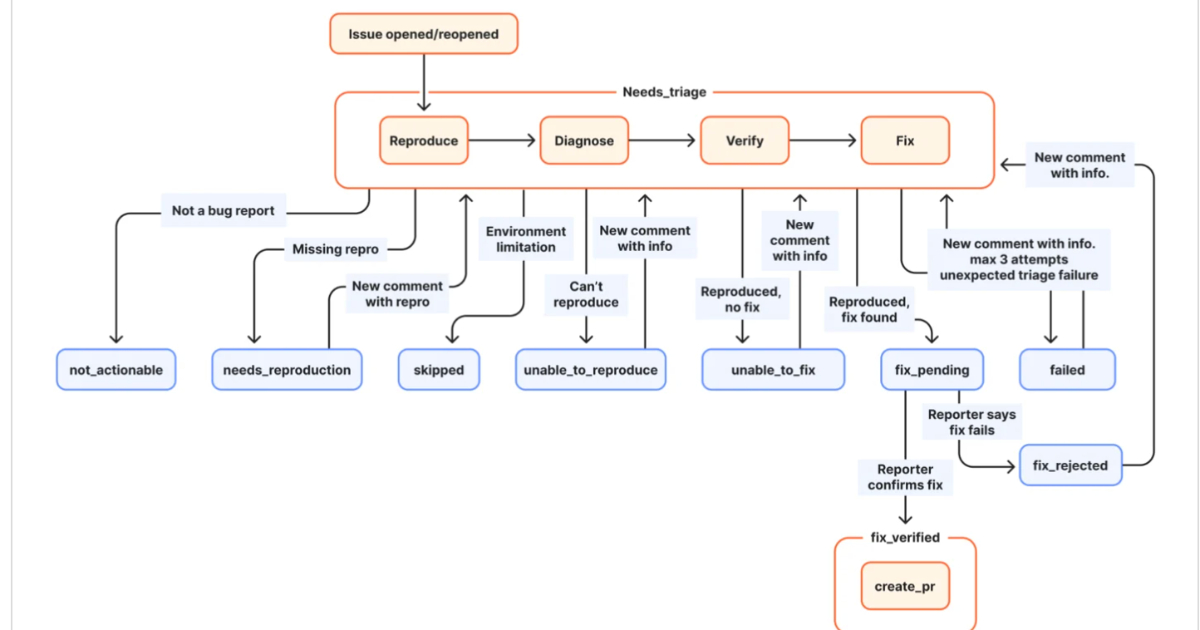
ตัวอย่างที่ชัดเจนของ AI productivity ROI คือการใช้เอเจนต์ช่วยไตรแอก GitHub issues ของเฟรมเวิร์ก Astro โดยเอเจนต์ที่รันใน GitHub Actions ถูกออกแบบให้จำลองบั๊ก ตรวจสอบสาเหตุ ยืนยันพฤติกรรม และเสนอการแก้ไขพร้อมสร้าง preview release ให้ผู้รายงานทดสอบ จากกระบวนการนี้จำนวน issues ที่เปิดอยู่ลดจากกว่า 200 เหลือประมาณ 30 หรือราว 85% และเป้าคือศูนย์ issues เปิดค้าง คำกล่าวที่ควรจดจำคือ “Astro’s open issue count fell from more than 200 to about 30, an approximately 85% reduction.”
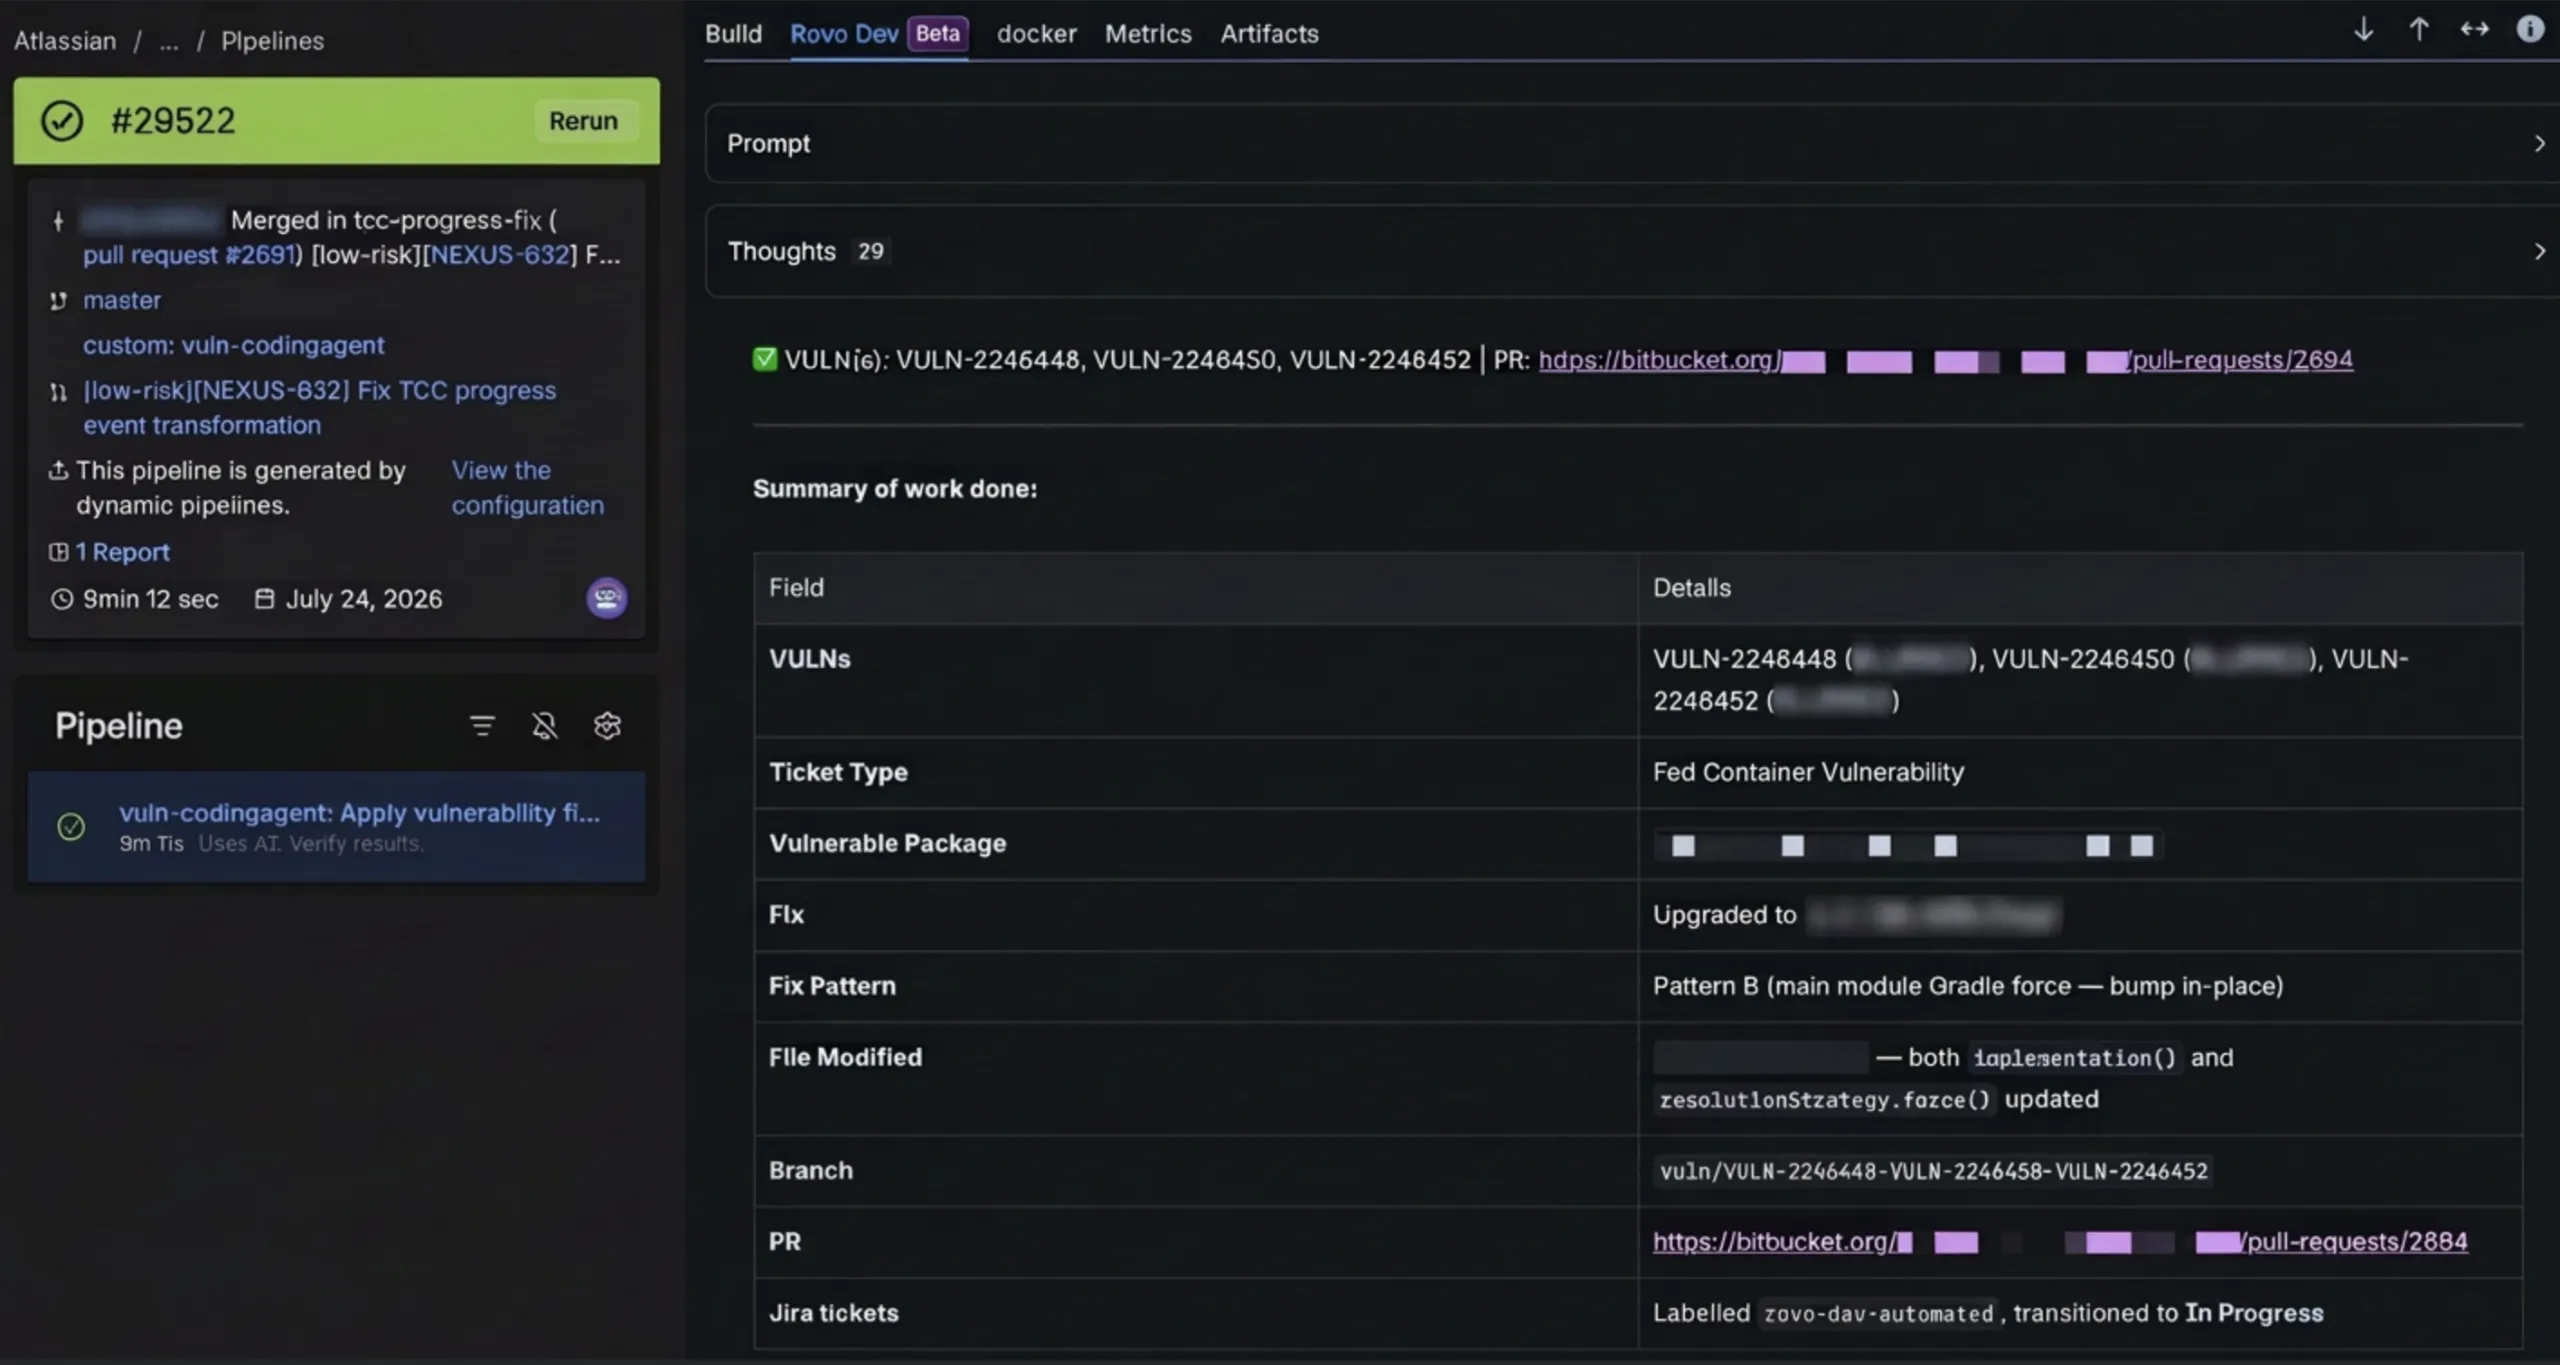
แต่เบื้องหลังความสำเร็จนั้นคือการจัดโครงสร้าง workflow เป็น state machine ที่ขับด้วยป้ายกำกับบน issue ใหม่ๆ จะถูกติดป้ายว่าต้อง triage และเมื่อมีการยืนยันการแก้ไขก็ไหลไปสู่สถานะ fix verified เมื่อเอเจนต์พบวิธีแก้ไข ระบบจะสร้าง preview release โพสต์ผลการทำงาน ล็อก และคำแนะนำการติดตั้งลงใน issue จากนั้นเปิด pull request ทันทีที่ผู้รายงานยืนยันแพตช์ ที่สำคัญ โครงสร้างนี้ทำให้เอเจนต์ทำงานใน sandbox เพื่อให้มนุษย์เห็นเฉพาะผลลัพธ์ที่ผ่านกระบวนการอัตโนมัติแล้ว และยังใช้การรันที่ล้มเหลวเป็นสัญญาณด้านการดูแลฐานโค้ดด้วย นี่คือตัวอย่างที่ดีของการยอมจ่ายภาษีโครงสร้างพื้นฐาน เพื่อให้ผลลัพธ์จากเอเจนต์มีความน่าเชื่อถือพอจะเข้าไปอยู่ใน workflow จริงของซอฟต์แวร์
AgentOps Stack: ค่าที่คุณจ่ายเพิ่มไม่ได้อยู่ที่โมเดล แต่อยู่ที่เลเยอร์ที่คนไม่ค่อยพูดถึง
เมื่อเราพูดถึง AI agents infrastructure คนส่วนใหญ่ให้ความสนใจกับคำถามว่าใช้โมเดลอะไร มีหน้าต่างบริบทเท่าไหร่ หรือเรียกใช้เครื่องมือแบบไหน ทั้งที่ในความเป็นจริง โครงสร้าง AgentOps Stack ถูกแบ่งออกเป็นสี่ชั้น: โมเดล เฟรมเวิร์ก ตรรกะการจัดการ, เลเยอร์ความสามารถในการสังเกตการณ์ และเลเยอร์โครงสร้างพื้นฐาน เลเยอร์โมเดลคือส่วนที่ทำหน้าที่ให้เหตุผล ซึ่งเปลี่ยนได้ค่อนข้างง่ายผ่านการปรับตั้งค่าในเฟรมเวิร์ก ส่วนเฟรมเวิร์กคือการแปลงการเรียก LLM ครั้งเดียวให้กลายเป็นลูปที่มีการเรียกเครื่องมือ หน่วยความจำข้ามขั้นตอน การวางแผน รวมถึงการจัดการลองใหม่และข้อผิดพลาด
เลเยอร์ความสามารถในการสังเกตการณ์คือสิ่งที่ช่วยให้ทีมเห็นว่ามีอะไรเกิดขึ้นจริงกับเอเจนต์ เช่นจำนวนโทเค็นต่อชั่วโมง การเรียกเครื่องมือที่ล้มเหลว ความหน่วงที่เปลี่ยนไป และการเสื่อมประสิทธิภาพจากบริบทที่โตเกินไป หากไม่มีเลเยอร์นี้ รูปแบบความล้มเหลวจะถูกค้นพบก็ต่อเมื่อมนุษย์พบว่าผลลัพธ์ผิดหรือค่าใช้จ่ายสูงเกินไป ไม่ใช่จากระบบแจ้งเตือน ส่วนเลเยอร์โครงสร้างพื้นฐานซึ่งรวมถึงความเสถียรของพลังงานและเครือข่าย การคงอยู่ของข้อมูล การควบคุมกระบวนการให้เริ่มใหม่ และการกู้คืนเมื่อเซิร์ฟเวอร์ล่มคือส่วนที่ถูกมองข้ามบ่อยที่สุดและมักล้มเหลวอย่างเงียบๆ เป็นวันๆ ความจริงที่น่าไม่สบายใจคือ ปริมาณงานและเวลาที่ต้องทุ่มให้เลเยอร์นี้คือหัวใจของปัญหาเมื่อคุณพยายามรันเอเจนต์อัตโนมัติแบบต่อเนื่อง
| เลเยอร์ | บทบาทหลัก | ความเสี่ยงหากละเลย |
|---|---|---|
| โมเดล LLM | ให้เหตุผลและสร้างคำตอบของเอเจนต์ | คุณภาพคำตอบต่ำลง เห็นทันทีในผลลัพธ์ |
| เฟรมเวิร์ก/ลูป ReACT | เรียกเครื่องมือ หน่วยความจำ การวางแผน การลองใหม่และจัดการข้อผิดพลาด | สิ้นเปลืองโทเค็นจำนวนมากจากการลองใหม่ในลูปแน่น |
| เลเยอร์การสังเกตการณ์ | วัดโทเค็น ความหน่วง อัตราความล้มเหลว และการเติบโตของบริบท | รู้ว่ามีปัญหาเฉพาะเมื่อมนุษย์เห็นค่าใช้จ่ายพุ่งหรือผลลัพธ์ผิด |
| โครงสร้างพื้นฐาน | เสถียรภาพของพลังงาน/เครือข่าย การคงอยู่ของข้อมูล การกู้คืนจากข้อผิดพลาด | กระบวนการหยุดเงียบๆ หลังการรีสตาร์ทหรือความล้มเหลวของเซิร์ฟเวอร์ เป็นเวลาหลายสัปดาห์ |
โครงสร้างพื้นฐาน: จากแล็ปท็อปถึง Managed Runtime และต้นทุนที่มองไม่เห็น
เมื่อถึงจุดที่คุณต้องรันเอเจนต์แบบต่อเนื่อง ทางเลือกหลักมีสามแบบคือ แล็ปท็อป VPS ที่ไม่มีการจัดการ และรันไทม์ที่มีการจัดการ การใช้แล็ปท็อปหมายถึงไม่มีการรับประกันความพร้อมใช้งาน เปิดเผยสภาพแวดล้อมส่วนตัวเต็มที่ และเสี่ยงที่โหมดสลีปหรือแบตเตอรี่จะปิดกระบวนการโดยไม่แจ้งเตือน อีกทั้งเอเจนต์ที่มีสิทธิ์เข้าถึงเชลล์และไฟล์เดียวกับเจ้าของเครื่องสามารถแตะรหัสผ่าน เซสชันเบราว์เซอร์ และเอกสารทั้งหมดที่อยู่ในเครื่อง หากการเรียกเครื่องมือผิดพลาดหรือถูกแทรกคำสั่งในพรอมต์ก็ไม่มีอะไรหยุดมันได้
VPS ที่ไม่มีการจัดการให้กล่องที่เปิดตลอดเวลาจริง แต่คุณต้องรับผิดชอบทุกอย่างตั้งแต่ความปลอดภัย SSH การจัดการคีย์ ไฟล์หน่วยของ systemd เพื่อให้กระบวนการเริ่มใหม่เมื่อเกิดข้อผิดพลาดหรือรีบูต กฎไฟร์วอลล์ ใบรับรอง SSL ไปจนถึงระบบตรวจสอบเพื่อให้เห็นความล้มเหลวก่อนผู้ใช้ ทั้งหมดนี้คือเช็กลิสต์ DevOps ที่กินเวลาเป็นวันก่อนจะเขียนโค้ดเอเจนต์จริงๆ หลายทีมยังเลือกเส้นทางนี้เพราะต้องการควบคุมเซิร์ฟเวอร์เต็มรูปแบบและยอมรับต้นทุนการตั้งค่าที่สูงเมื่อทำงานในระดับที่เหมาะกับการลงทุนด้านนี้ ส่วน Managed Runtime มอบข้อดีด้านการเข้าถึงและการลดภาระงาน DevOps แต่ต้องจ่ายในระดับราคาพรีเมียมที่สะท้อนบริการเสถียรภาพและเครื่องมือประกอบครบชุด เพื่อให้เอเจนต์มีที่อยู่อาศัยที่เชื่อถือได้
โครงสร้างพื้นฐานแบบ declarative: ทำไมการออกแบบ workflow ให้ "ทน" สำคัญเท่ากับการออกแบบให้ "ฉลาด"
ทางออกหนึ่งสำหรับภาษีโครงสร้างพื้นฐานคือการใช้แพลตฟอร์มที่มีโมเดล declarative ให้คุณนิยามบริบทของเอเจนต์ เช่นโมเดล ทักษะ sandbox และคำสั่ง โดยไม่ต้องเขียนลูป orchestration เอง การบันทึกประวัติการทำงานผ่าน event log แบบ append-only ทำให้ workflow ที่ถูกขัดจังหวะสามารถกลับมารันต่อจากสถานะเดิม ไม่ต้องเริ่มใหม่ บนสภาพแวดล้อมที่รองรับ agents ให้ทำงานเป็น Durable Objects ทำให้ได้ทั้งการรันแบบคงทนและพื้นที่เก็บข้อมูลแยกส่วน เมื่อผูกเข้ากับแนวคิด Flue model ที่ให้ agent tasks มีขอบเขตชัดเจน มี state ที่คงอยู่ มีเหตุการณ์ภายนอก และจุดอนุมัติจากมนุษย์ ผลที่ได้คือ workflow ซอฟต์แวร์ที่ทนทานแม้จะมีเอเจนต์หลายตัววิ่งอยู่ในระบบ
อย่างไรก็ตาม Managed Runtime ไม่ใช่คำตอบที่ถูกต้องเสมอไป หากปริมาณงานของคุณเป็นช่วงสั้นๆ และไม่สม่ำเสมอ แพลตฟอร์มแซนด์บ็อกซ์ที่สร้างมาเพื่อรูปแบบนี้ เช่น E2B อาจมีต้นทุนต่ำกว่าและเหมาะกับการจ่ายเพื่อการรันเป็นครั้งๆ มากกว่าการถืออินสแตนซ์เฉพาะที่เปิดตลอดเวลา เมื่อมองในกรอบ AI productivity ROI การตัดสินใจระหว่าง self-managed VPS กับ Managed Runtime จึงไม่ใช่แค่คำถามเรื่องงบประมาณ แต่คือคำถามว่าคุณอยากจ่ายด้วยเงินหรือด้วยเวลาทีม DevOps และคุณค่าที่คุณให้กับการมีโครงสร้างที่ช่วยให้เอเจนต์ล้มแล้วลุกเองได้โดยไม่ต้องให้มนุษย์มาแก้ทุกครั้ง