
คะแนนเดียวไม่อาจบอกว่าโมเดลไหนเหมาะกว่า
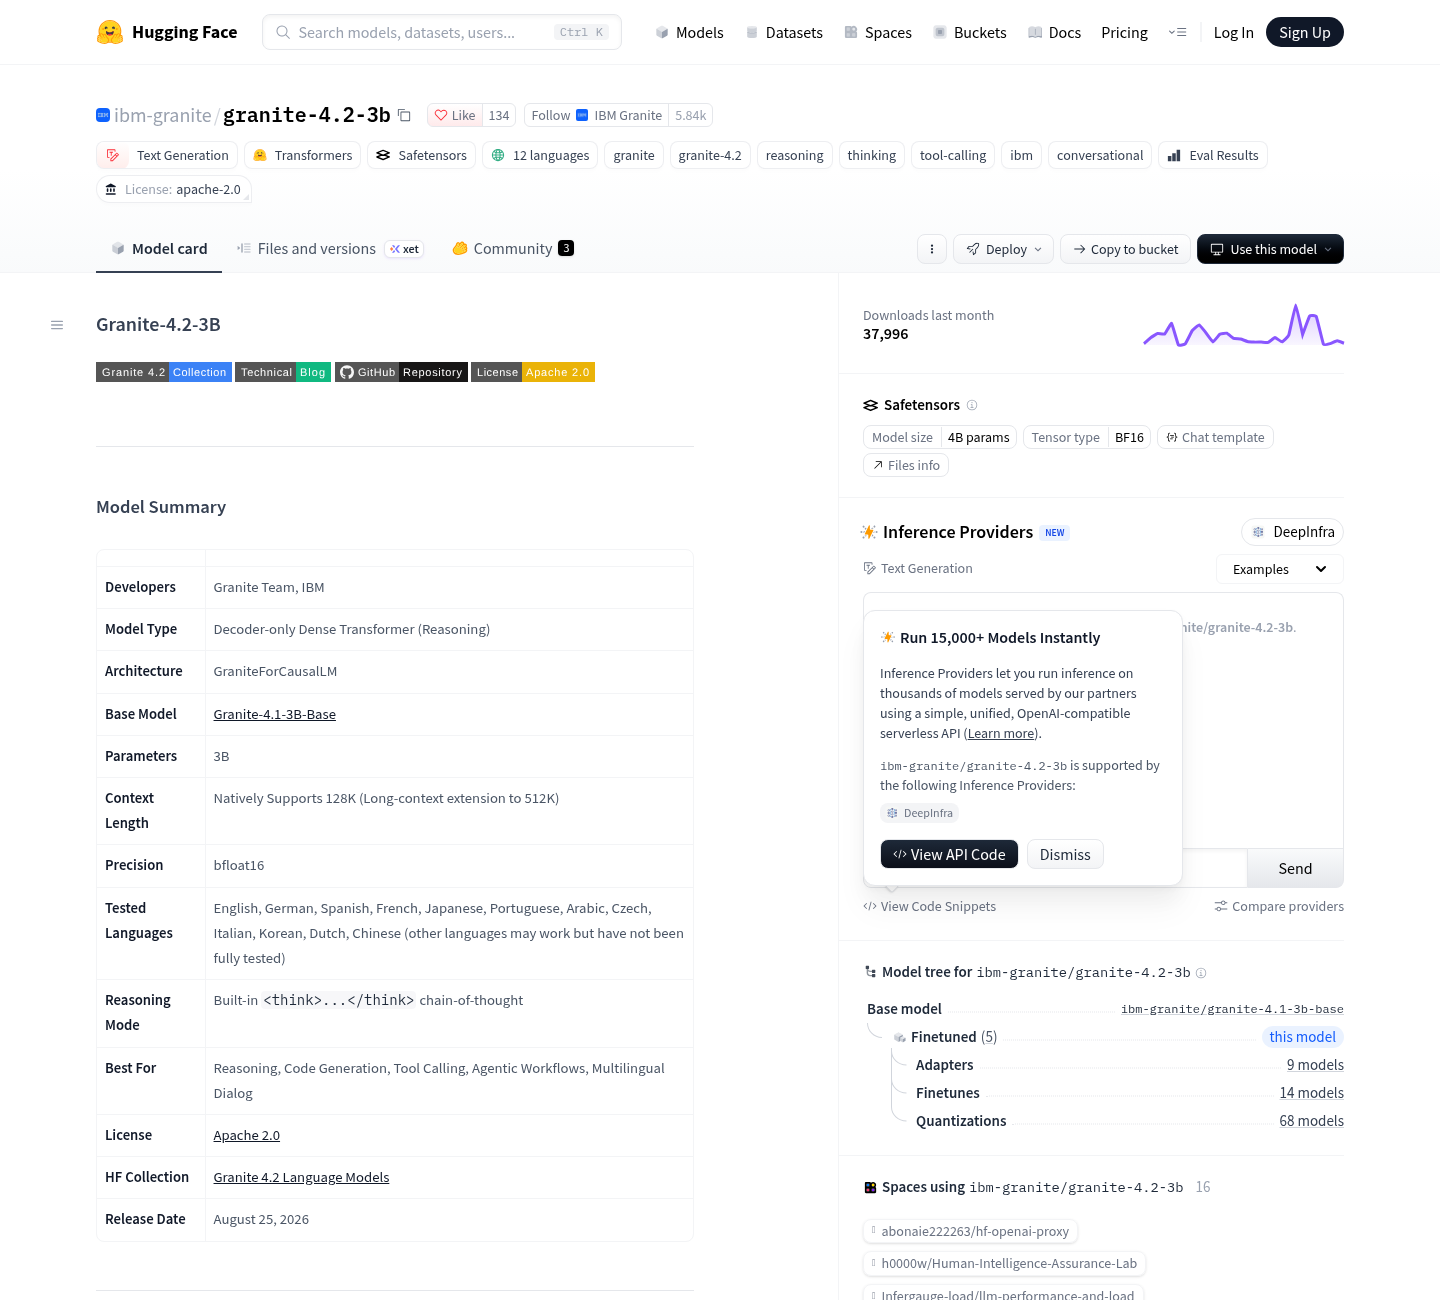
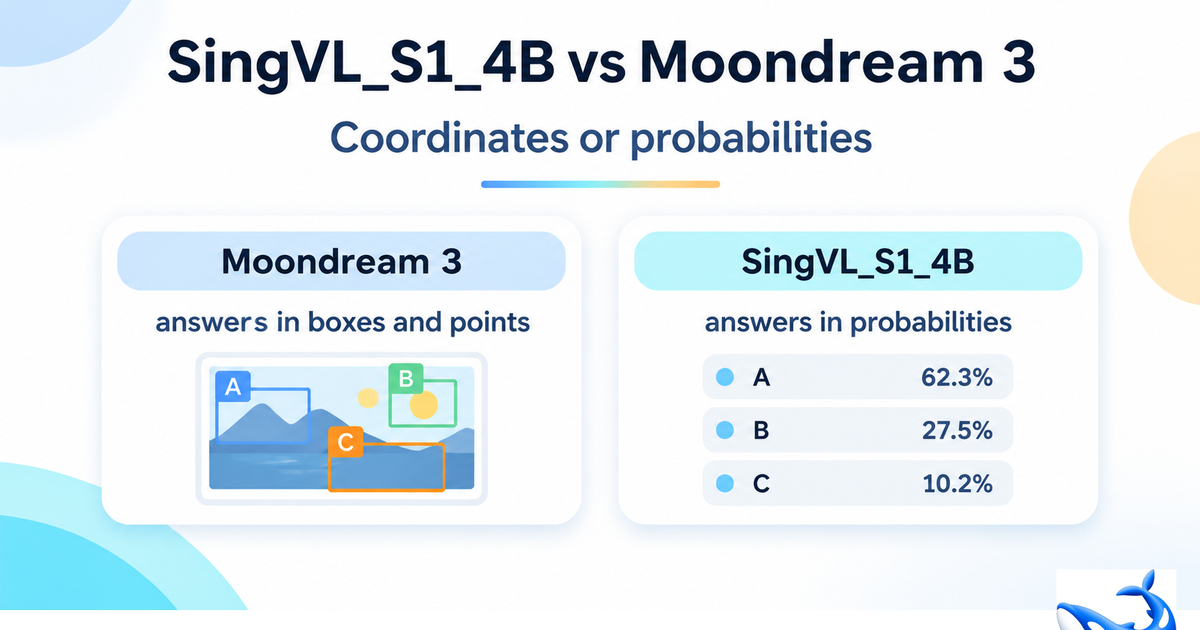
โมเดล AI อ่านภาพคือระบบที่รับภาพเป็นข้อมูลเข้าและประมวลผลเพื่อสร้างคำตอบ ซึ่งอาจเป็นข้อความ พิกัดวัตถุ หรือค่าความน่าจะเป็นตามงานที่กำหนด จึงต้องดูทั้งสิ่งที่โมเดลทำได้และรูปแบบผลลัพธ์ก่อนตัดสินจากคะแนนเบนช์มาร์ก ประเด็นนี้เห็นชัดเมื่อเทียบ ZoomGain-4B กับ Granite 4.2 3B ซึ่งเปิดตัวห่างกันไม่ถึงสิบสองสัปดาห์ แต่ไม่ได้เป็นคู่แข่งในงานเดียวกันโดยตรง ทั้งคู่เป็นโมเดลแบบเปิดที่มีขนาดใกล้เคียงกัน ทว่า ZoomGain-4B เป็นโมเดลวิชันภาษา ขณะที่ Granite 4.2 3B เป็นโมเดลข้อความล้วน ไม่มีตัวเข้ารหัสภาพและรับภาพเข้าไม่ได้ คะแนนภาพจึงไม่มีความหมายสำหรับ Granite ไม่ใช่เพราะทำได้แย่ แต่เพราะไม่ได้ถูกออกแบบให้ทำงานนั้น ZoomGain-4B ได้ 55.81 คะแนน เทียบกับ 30.03 ของ Qwen3.5-4B ที่เป็นรุ่นตั้งต้น ตัวเลขนี้บอกถึงผลในงานประเมินที่กำหนด ไม่ได้แปลว่าโมเดลนี้เหนือกว่าในงานเอกสาร การเรียกเครื่องมือ หรือการสนทนาทั่วไป
ความน่าจะเป็นกับย่อหน้า ตอบโจทย์คนละขั้นตอน
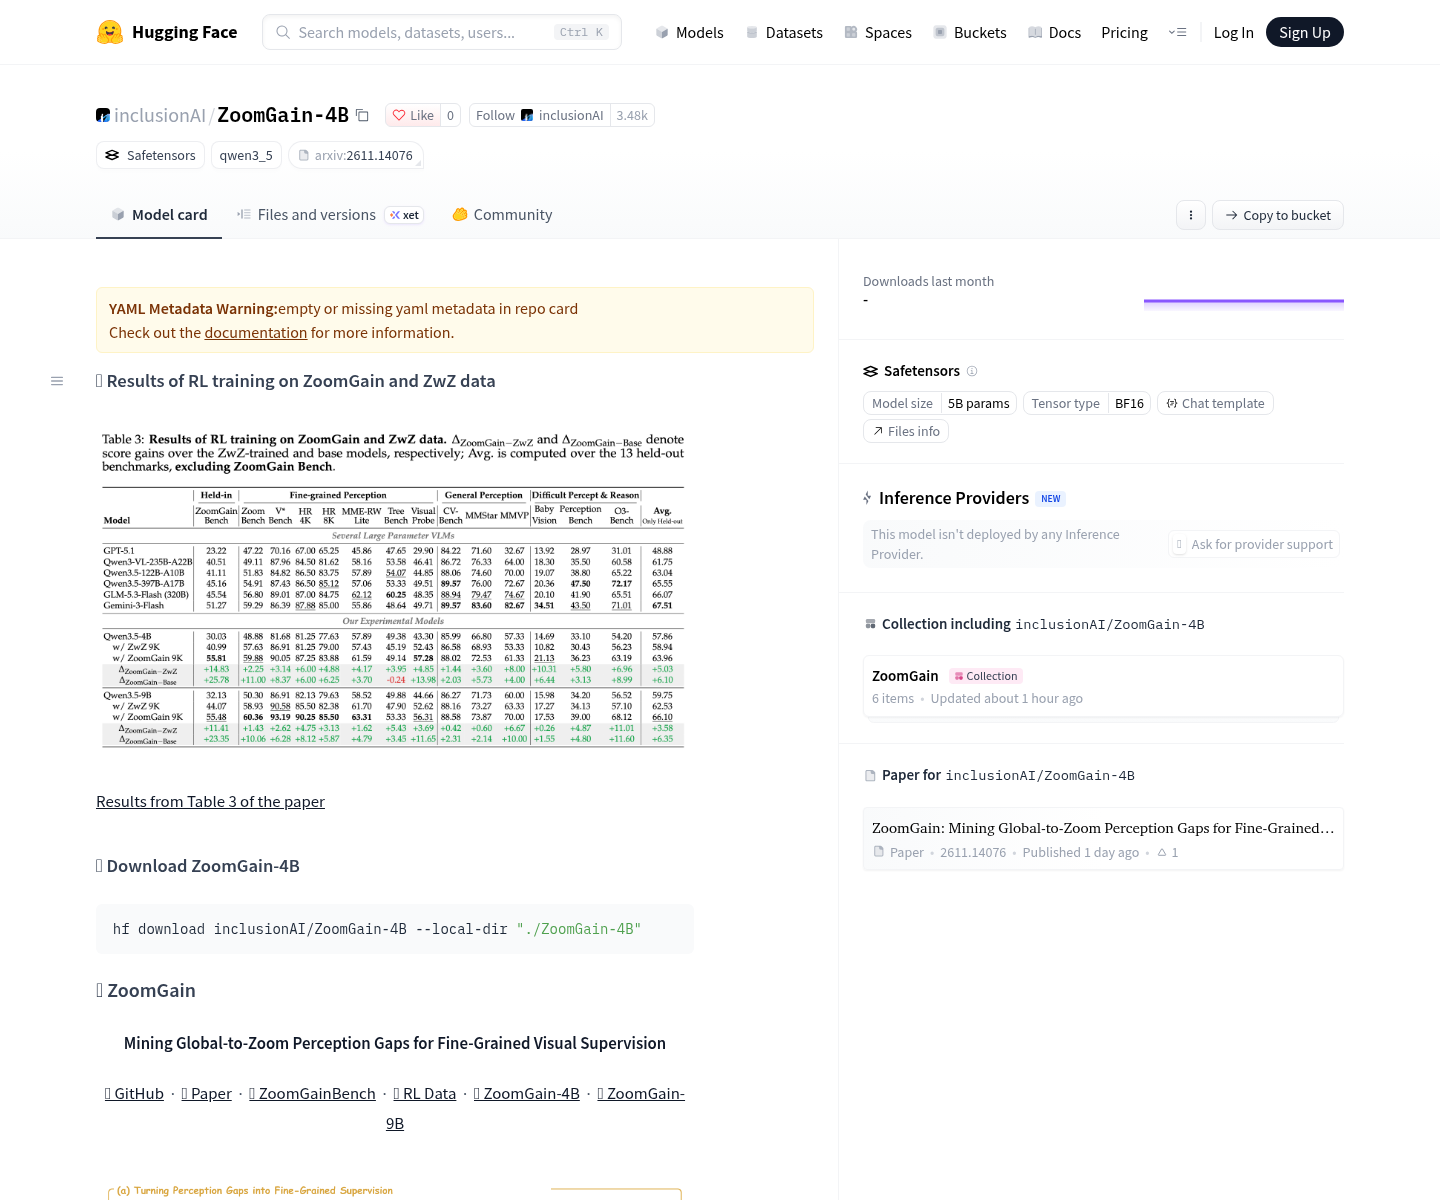
ความต่างระหว่าง SingVL_S1_4B กับ LFM2.5-VL-3B ไม่ใช่แค่คุณภาพของคำตอบ แต่คือชนิดผลลัพธ์ที่ระบบปลายทางต้องรับได้ SingVL_S1_4B คืนค่าความน่าจะเป็นให้แต่ละตัวเลือกที่ผู้ใช้กำหนด โดยไม่สร้างข้อความอิสระ ส่วน LFM2.5-VL-3B สร้างคำตอบเป็นข้อความ จึงอธิบายภาพ สนทนาต่อเนื่อง หรือถอดความเอกสารพร้อมเลย์เอาต์ได้ ถ้าระบบต้องตัดสินว่าใบแจ้งหนี้เป็นเอกสารประเภทใด หรือภาพผ่านเกณฑ์ความปลอดภัยหรือไม่ การได้คะแนนรายตัวเลือกอาจนำไปใช้งานต่อได้ตรงกว่า แต่หากต้องส่งคำอธิบายให้คนอ่าน SingVL_S1_4B ก็ไม่สามารถแทนคำตอบเป็นย่อหน้าได้ นี่ทำให้คะแนนเบนช์มาร์ก AI ที่ดูคล้ายกันอาจเทียบกันไม่ได้ เพราะ SingVL_S1_4B เลือกคำตอบจากชุดตัวเลือกที่เตรียมไว้ ขณะที่โมเดลสร้างข้อความต้องผลิตคำตอบซึ่งผู้ประเมินตรวจภายหลัง เมื่อเลือกโมเดลวิชันภาษา ควรถามก่อนว่าโปรแกรมต้องการข้อความที่อ่านรู้เรื่อง หรือค่าตัดสินที่มีโครงสร้าง ไม่ใช่เริ่มจากอันดับคะแนน
พิกัดกรอบภาพไม่ใช่ค่าความมั่นใจ
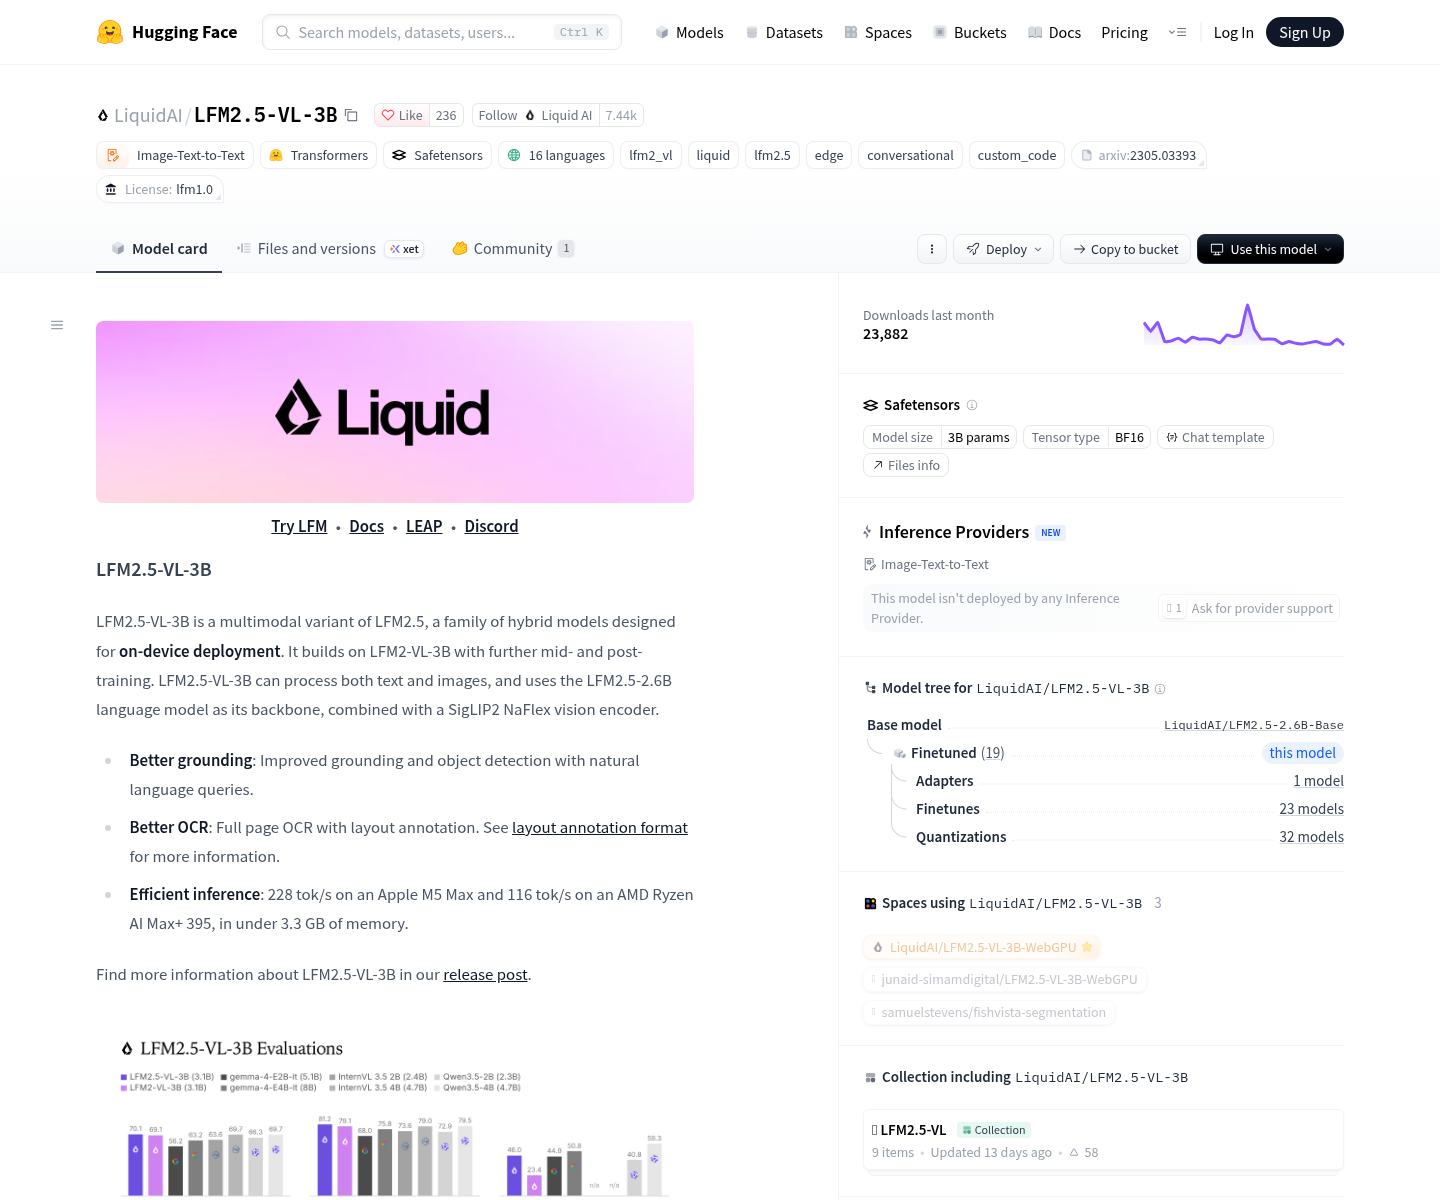
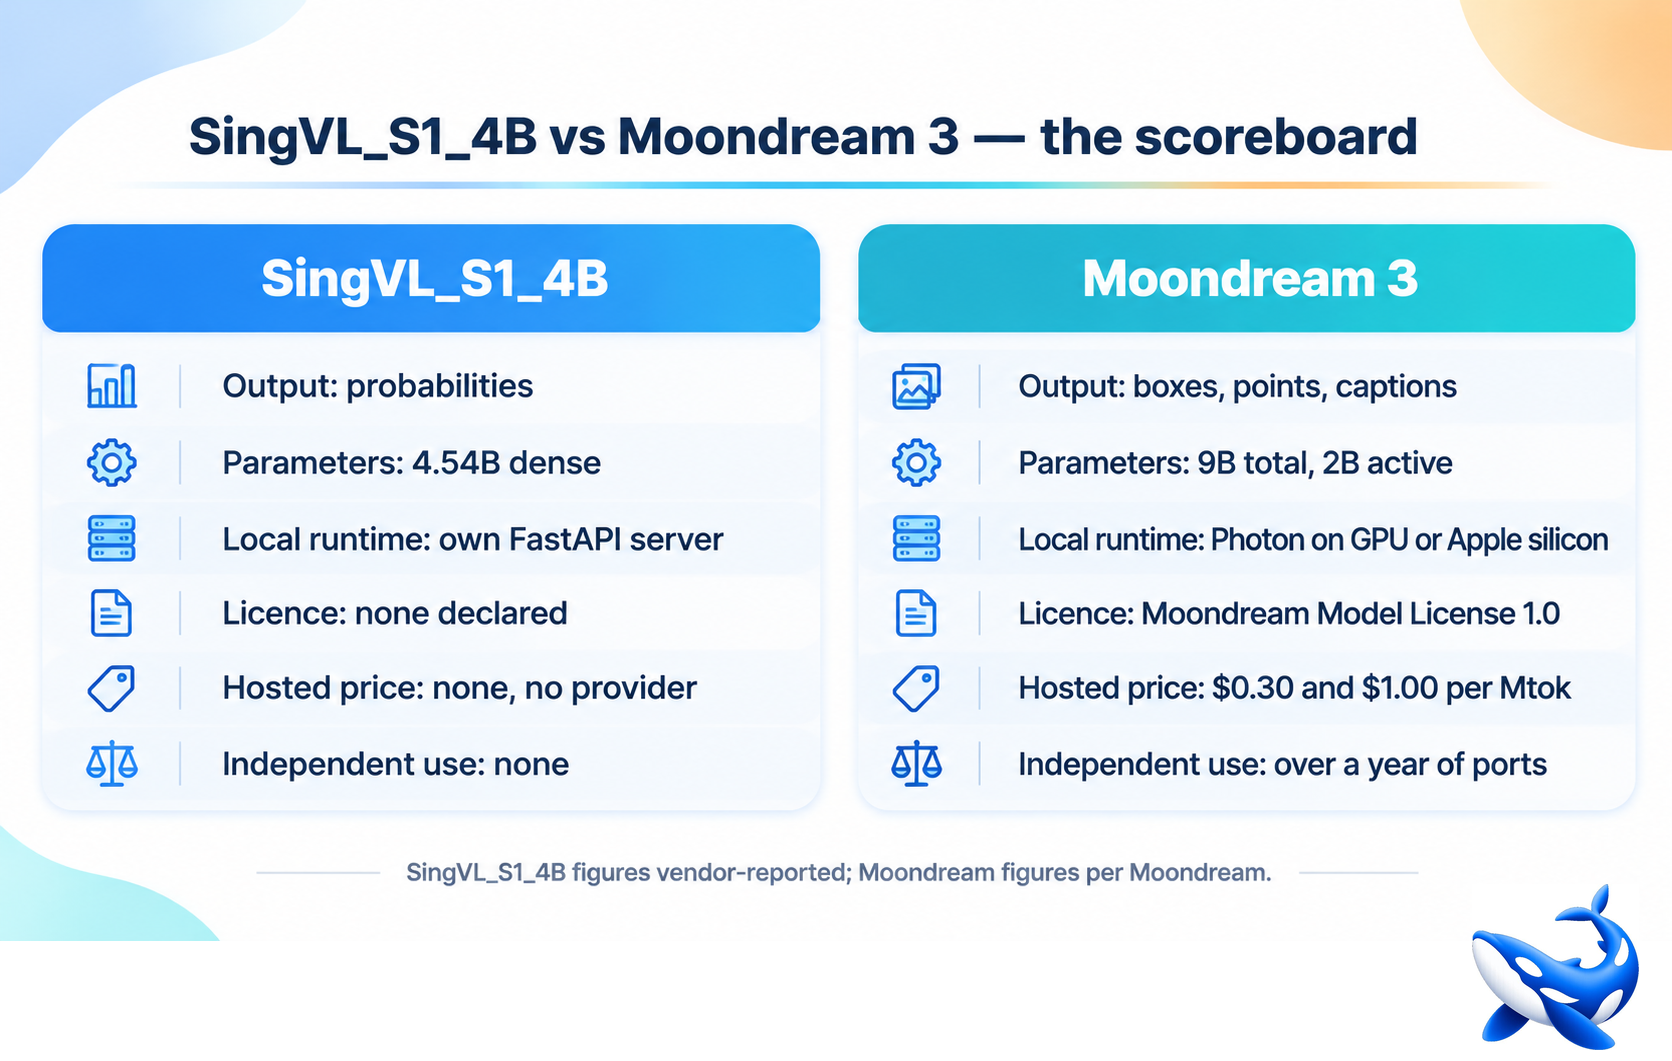
Moondream 3 กับ SingVL_S1_4B ต่างให้ผลลัพธ์แบบมีโครงสร้าง แต่โครงสร้างที่ได้ทำหน้าที่คนละอย่าง Moondream 3 สามารถคืนกรอบพร้อมป้ายกำกับเมื่อให้หาคนในภาพ หรือส่งพิกัดจุดเมื่อถามหาตำแหน่งวัตถุ ส่วน SingVL_S1_4B คืนค่าความน่าจะเป็นต่อคำตอบที่กำหนดไว้ ความต่างนี้กำหนดว่างานใดจะใช้โมเดลได้จริง หากต้องนับสินค้าในคลัง หาอะไหล่ หรือระบุตำแหน่งมือจับ พิกัดจาก Moondream 3 คือผลลัพธ์ที่ระบบนำไปใช้ต่อได้ ขณะที่ SingVL_S1_4B เหมาะกับคำถามตัดสินใจ เช่น ภาพนี้ปลอดภัยหรือไม่ เมื่อมีตัวเลือกให้ประเมิน การเรียกทั้งคู่ว่าโมเดลภาพแบบมีโครงสร้างจึงกว้างเกินไปจนกลบสิ่งสำคัญที่สุด การประเมิน AI ยังต้องระวังที่มาของคะแนนด้วย ผลที่ผู้พัฒนาเผยแพร่ใช้ชุดข้อมูลและวิธีทดสอบของตนเอง โดยชุดของ Moondream ผ่านการตรวจสอบและการนำไปใช้ซ้ำจากชุมชนมานานกว่า ส่วนชุดของ SingVL_S1_4B ยังไม่มีการตรวจสอบในลักษณะเดียวกัน คะแนนจึงควรเป็นเบาะแส ไม่ใช่คำตัดสินสุดท้าย
เลือกจากงานจริง แล้วค่อยดูวิธีประเมิน
เบนช์มาร์ก AI มีประโยชน์เมื่อโมเดลถูกวัดด้วยงานที่ตรงกับการใช้งานจริง แต่คะแนนจากชุดข้อมูลที่มีชื่อคล้ายกันหรือวัดคนละความสามารถไม่ควรถูกนำมาจัดอันดับแบบเส้นตรง ตัวอย่างเช่น ZoomGain-4B เน้นการตอบคำถามเกี่ยวกับรายละเอียดภาพ และแนวคิดของการฝึกคือช่วยให้โมเดลมองบริเวณเฉพาะในภาพได้ดีขึ้น แม้รายละเอียดนั้นจะอยู่ในภาพเต็ม คะแนนจึงสะท้อนโจทย์เฉพาะ ไม่ได้ยืนยันความสามารถครอบจักรวาล ก่อนเลือก ควรระบุให้ชัดว่าระบบต้องรับภาพหรือไม่ ต้องส่งคืนคำอธิบาย ข้อความที่สร้างขึ้น กรอบพิกัด หรือความน่าจะเป็น และผลการทดสอบมาจากชุดข้อมูลใด หากงานเป็นการอ่านสัญญาหรือเรียกใช้เครื่องมือ โมเดลข้อความอาจเหมาะกว่าโมเดลภาพโดยไม่ต้องสนใจว่าอีกฝ่ายได้คะแนนภาพสูงเพียงใด แต่ถ้าต้องหาวัตถุในภาพ โมเดลข้อความล้วนก็ไม่ใช่ตัวเลือก ข้อสรุปคือ อย่าซื้อคะแนนจากตารางโดยไม่ตรวจงานที่คะแนนนั้นวัด ความสามารถ รูปแบบคำตอบ และความน่าเชื่อถือของวิธีประเมินต้องสอดคล้องกับงานจริง จึงจะเลือกโมเดลได้อย่างมีเหตุผล