
ระดับความพยายามคือการปรับจำนวนโทเค็น ไม่ใช่ราคาต่อโทเค็น
ระดับความพยายามของ GPT-6.1 Terra คือการตั้งค่าที่กำหนดว่าโมเดลจะใช้โทเค็นคิดวิเคราะห์ก่อนตอบมากน้อยเพียงใด โดยไม่เปลี่ยนอัตราค่าบริการต่อโทเค็น แต่ส่งผลต่อต้นทุนรวมผ่านจำนวนโทเค็นที่ใช้จริง
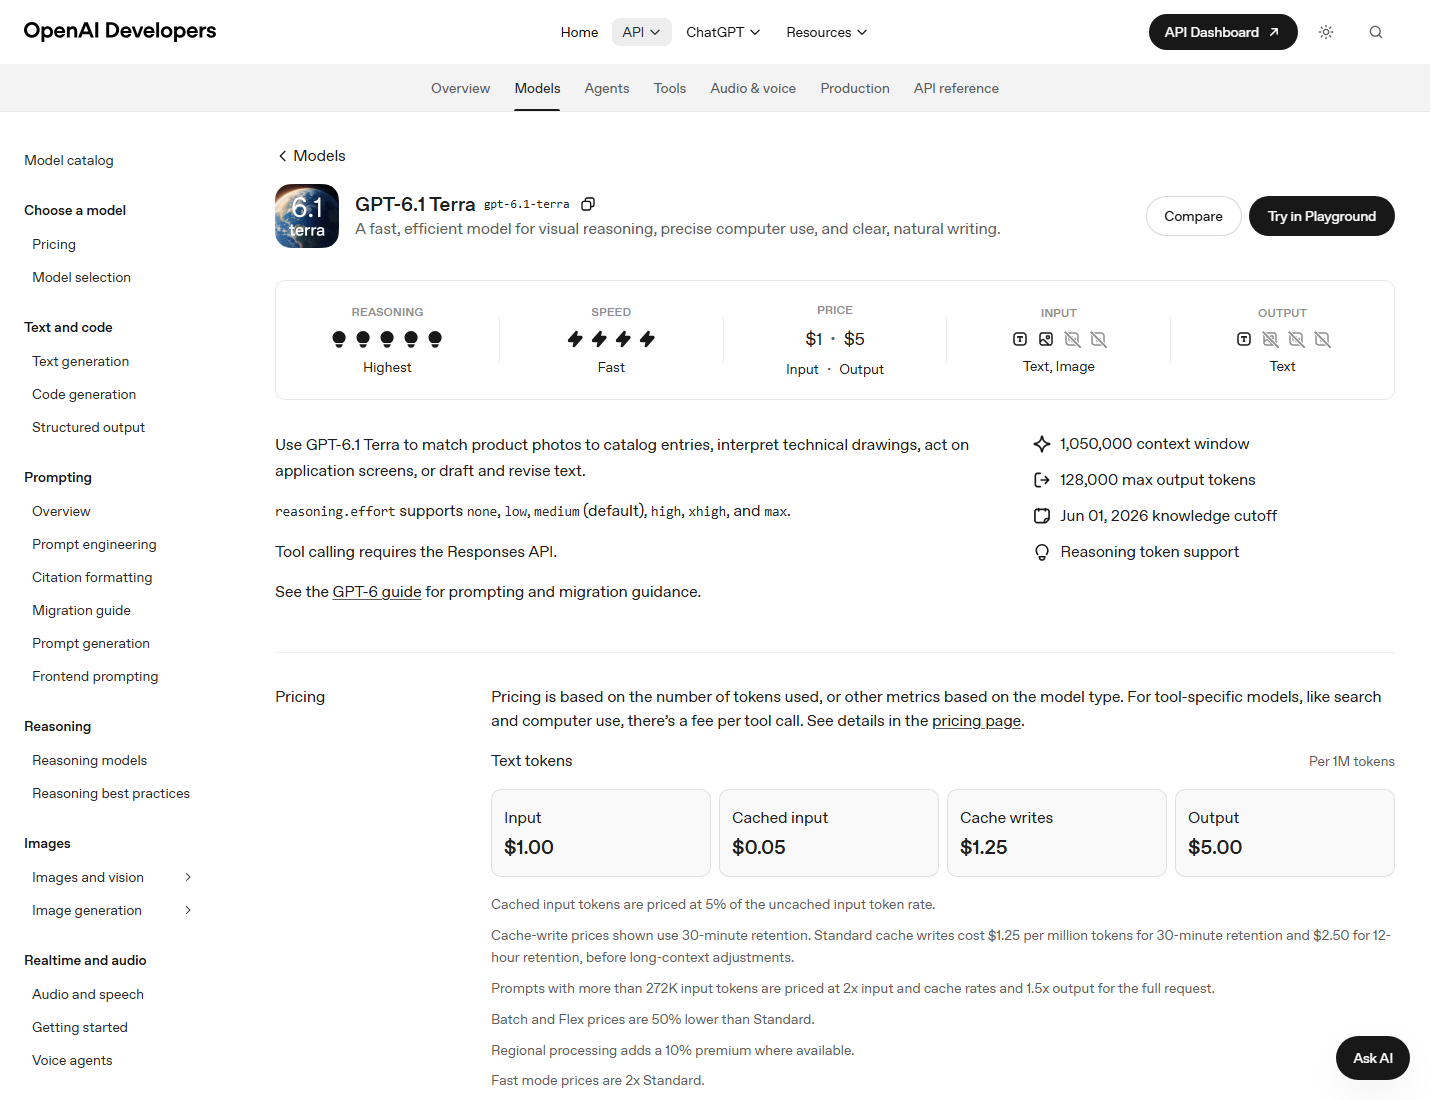
มีหกระดับ ได้แก่ none, low, medium, high, xhigh และ max โดยค่าเริ่มต้นคือ medium การเข้าใจความต่างนี้สำคัญกว่าการดูตารางราคาเพียงอย่างเดียว เพราะคำขอเดียวกันอาจสร้างโทเค็นเอาต์พุตเพิ่มขึ้นเมื่อเลือกระดับสูง แม้อัตราค่าบริการจะเท่าเดิมก็ตาม จึงไม่ควรตั้ง max ให้ทุกงานเพียงเพราะต้องการคำตอบที่ดีขึ้น
สำหรับการจัดหมวดหมู่ การกำหนดเส้นทาง การติดแท็ก หรือการดึงข้อมูลจากข้อความที่มีรูปแบบชัดเจน ให้เริ่มจาก none หรือ low ส่วน medium เป็นจุดตั้งต้นที่สมดุล ขณะที่ high เหมาะกับการวิเคราะห์หลายขั้นหรือทบทวนโค้ด และ xhigh กับ max ควรสงวนไว้ให้งานที่ความถูกต้องมีความสำคัญมากกว่าความเร็วและปริมาณโทเค็น
เลือกระดับที่ถูกที่สุดซึ่งยังผ่านเกณฑ์คุณภาพ
วิธีตั้งค่าที่คุ้มไม่ใช่เดาว่าระดับไหนดีที่สุด แต่ทดสอบงานตัวอย่างเดียวกันที่ none, low, medium และ max แล้ววัดทั้งความถูกต้องกับโทเค็นที่ใช้ ระดับที่เหมาะคือระดับต้นทุนต่ำสุดที่ยังผ่านเกณฑ์คุณภาพของงาน ไม่ใช่ระดับสูงสุดในเมนู
งานสั้นที่มีคำตอบตายตัว เช่น สกัดชื่อ วันที่ หรือป้ายกำกับ มักไม่ต้องใช้รอบคิดยาว เริ่มที่ none หรือ low แล้วตรวจผลกับชุดทดสอบจริงก่อนนำไปใช้จำนวนมาก หากความผิดพลาดมีผลต่อการตัดสินใจหรือการทำงานต่อเนื่อง ค่อยขยับไป medium หรือ high พร้อมเปรียบเทียบว่าคุณภาพที่เพิ่มขึ้นคุ้มกับโทเค็นส่วนเกินหรือไม่
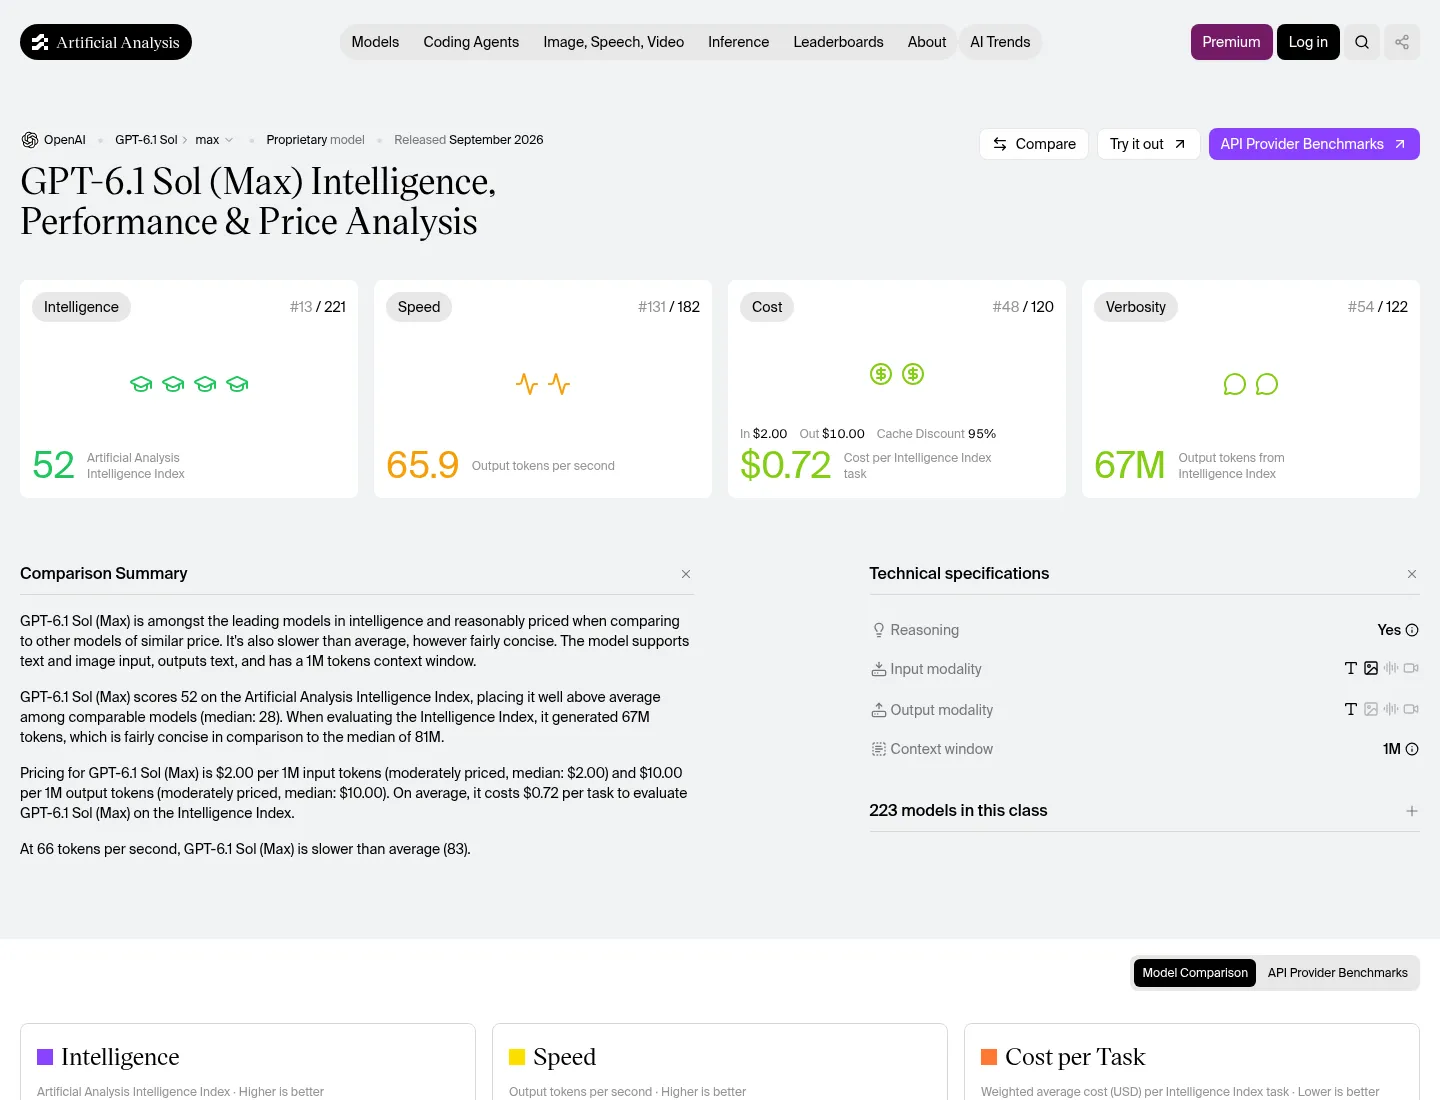
อย่าสับสนคะแนนประเมินของโมเดลกับผลที่ได้จากการตั้งค่าทุกระดับ ตัวเลขประเมินที่เผยแพร่สำหรับ GPT-6.1 Terra ใช้ระดับ max เว้นแต่จะระบุเป็นอย่างอื่น จึงไม่ควรคาดหวังว่าการตั้งค่า none จะให้ผลเท่ากัน การวัดกับงานของตัวเองเป็นทางลัดที่น่าเชื่อถือกว่าการเลือกตามชื่อเสียงของโมเดล
หน้าต่างบริบทใหญ่ แต่มีเส้นต้นทุนที่ควรหลีกเลี่ยง
หน้าต่างบริบทของ GPT-6.1 Terra รองรับได้สูงสุด 1,050,000 โทเค็น โดยรับอินพุตได้สูงสุด 922,000 โทเค็น และสร้างเอาต์พุตได้สูงสุด 128,000 โทเค็น อย่างไรก็ตาม ความจุสูงสุดไม่ได้แปลว่าการส่งเอกสารทั้งหมดในคำขอเดียวเป็นทางเลือกที่คุ้ม หรือรับประกันว่าโมเดลจะค้นข้อมูลในบริบทขนาดใหญ่มากได้แม่นยำ
จุดที่ต้องจับตาคืออินพุตเกิน 272,000 โทเค็น เมื่อข้ามเกณฑ์นี้ อัตราอินพุตของคำขอทั้งหมดเพิ่มเป็นสองเท่า และอัตราเอาต์พุตเพิ่มเป็น 1.5 เท่า ไม่ใช่เฉพาะส่วนที่เกิน นี่คือเหตุผลที่หน้าต่างบริบทกว้างกับต้นทุนที่คาดเดาได้เป็นคนละเรื่องกัน
หากคำถามต้องอาศัยภาพรวมข้ามเอกสารจริง เช่น ตรวจหาความขัดแย้งระหว่างสัญญาหลายฉบับ การส่งบริบทในคำขอเดียวอาจเหมาะสม แต่สำหรับงานส่วนใหญ่ควรแบ่งเอกสารเป็นช่วงและค้นหรือสรุปเฉพาะส่วนที่เกี่ยวข้อง วิธีนี้ช่วยควบคุมปริมาณโทเค็นและลดโอกาสที่ข้อมูลสำคัญจะจมหายในบริบทขนาดใหญ่
วางแผนงานสั้นและงานบริบทยาวให้คนละแบบ
งานสั้นควรเริ่มด้วย none หรือ low เมื่อโจทย์เป็นการแปลงหรือดึงข้อมูลที่ชัดเจน ส่วนงานที่ต้องคิดหลายขั้นให้ทดลอง medium ก่อน และเพิ่มเป็น high เมื่อชุดทดสอบแสดงว่าระดับเดิมพลาดบ่อย สำหรับงานที่ใช้บริบทยาว ให้คำนวณอินพุตก่อนส่งและตั้งเป้าไม่ให้เกิน 272,000 โทเค็น หากไม่จำเป็นต้องเห็นเอกสารทั้งชุดพร้อมกัน
- จัดประเภทข้อความหรือดึงฟิลด์ตามแบบ: ทดลอง none และ low แล้วตรวจความผิดพลาด
- วิเคราะห์หลายขั้นหรือทบทวนโค้ด: เริ่ม medium และทดสอบ high เฉพาะเมื่อคุณภาพยังไม่ถึงเกณฑ์
- เทียบข้อมูลข้ามเอกสารจำนวนมาก: ใช้บริบทครั้งเดียวเมื่อจำเป็นต้องเห็นความสัมพันธ์ภาพรวมจริง
- ค้นหรือสรุปเอกสารทั่วไป: แบ่งเป็นช่วงเพื่อลดอินพุตและจำกัดความเสี่ยงจากการข้ามเกณฑ์
ถ้ามีคำนำหน้าเอกสารยาวที่ไม่เปลี่ยนระหว่างคำขอ การแคชอาจช่วยลดต้นทุนการอ่านซ้ำได้ แต่ควรคำนึงด้วยว่าการข้ามเกณฑ์ 272,000 โทเค็นทำให้การคิดราคาแคชเปลี่ยนตามไปด้วย อย่าปล่อยให้บริบทโตเกินจำเป็นเพียงเพราะระบบรองรับ
ข้อสรุปคือแยกการตัดสินใจสองเรื่องออกจากกัน: เลือกระดับความพยายามตามคุณภาพที่งานต้องการ และออกแบบขนาดบริบทตามข้อมูลที่จำเป็นจริง การทดสอบระดับต่ำก่อนและแบ่งเอกสารเมื่อทำได้ คือแนวทางที่ช่วยให้ได้ผลลัพธ์พอเหมาะโดยไม่จ่ายต้นทุนโทเค็นจากการตั้งค่าสูงหรือบริบทเกินจำเป็น