
ภาพรวมโคลนเสียง AI และข้อสรุปแบบรวบรัด
โคลนเสียง AI คือเทคโนโลยีที่ใช้โมเดลปัญญาประดิษฐ์สร้างเสียงพูดเลียนแบบเสียงต้นฉบับของผู้พูดหรือเสียงมาตรฐานของผู้ให้บริการ โดยอาศัยการเรียนรู้จากตัวอย่างเสียงจำนวนมากเพื่อคงโทน น้ำเสียง และบุคลิกให้ใกล้เคียงต้นฉบับที่สุด เหมาะกับงานสื่อวิดีโอ ระบบตอบกลับอัตโนมัติ และคอนเทนต์หลายภาษา ที่ต้องการเสียงสม่ำเสมอและควบคุมได้ตลอดเวลา ในการเทียบ HeyGen Voice ElevenLabs และ GPT-Live-1 บทความนี้จะไม่มองสเปกแบบกลางๆ แต่จะชี้ให้ชัดว่าเครื่องมือไหนเหมาะกับงานแบบไหน HeyGen Voice เด่นด้านโคลนเสียงแบบควบคุมให้เหมือนผู้พูดคนเดิมทุกครั้ง ElevenLabs เด่นด้านคุณภาพเสียงรวมและคลังเสียงขนาดใหญ่ ส่วน GPT-Live-1 เด่นด้านการสนทนาเสียงสองทางแบบเรียลไทม์พร้อมข้อความประกอบ ผู้อ่านที่ต้องการเสียง AI ธรรมชาติสำหรับงานเฉพาะควรเริ่มจากการถามตัวเองว่า งานของคุณต้องการความเหมือนเสียงเดิม ความหลากหลายของเสียง หรือการโต้ตอบสดมากกว่ากัน
| สเปกหลัก | HeyGen Voice | Eleven v4 Turbo |
|---|---|---|
| คะแนน Elo สนาม Controlled Voice | 1,202 อันดับ 1 | 1,167 อันดับ 3 |
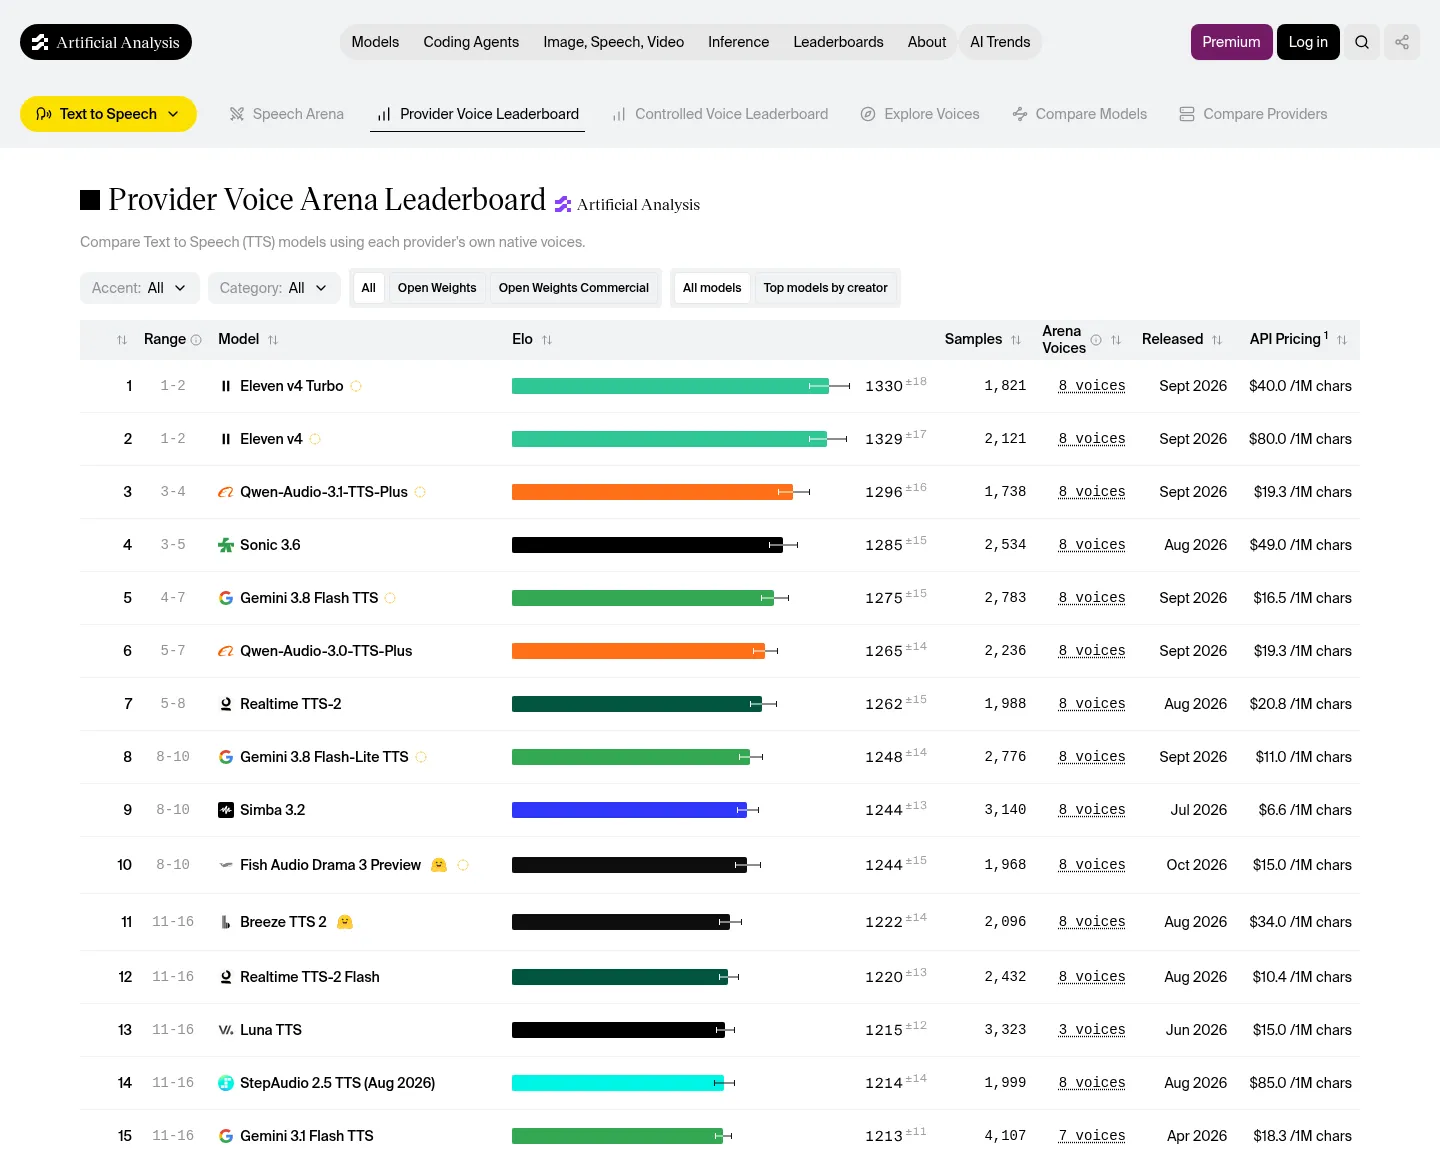
| คะแนน Elo สนาม Provider Voices | ไม่ติดอันดับ | 1,328 อันดับ 1 จาก 96 โมเดล |
| จำนวนเสียงสำเร็จรูป | มากกว่า 300 เสียง หลายสิบภาษา ไม่ระบุจำนวนภาษา | เป็นหนึ่งใน 96 โมเดลเสียงของผู้ให้บริการ |
| การครอบคลุมภาษา | ระบุเพียงว่าหลายสิบภาษา ไม่บอกตัวเลข | มากกว่า 90 ภาษา |
| การใช้งานหลัก | โคลนเสียงผู้พูดเฉพาะให้เหมือนเดิมในสนามควบคุม | สังเคราะห์เสียงพูดเรียลไทม์สำหรับตัวแทนสนับสนุน ผู้ช่วย AI และตัวละครโต้ตอบ |
| ข้อมูลความหน่วง | ไม่มีการเปิดเผยตัวเลขความหน่วง | ค่าประมวลผลมัธยฐานราว 100 มิลลิวินาที ไม่รวมแอปและเครือข่าย |
HeyGen Voice: แชมป์โคลนเสียงควบคุม เหมาะกับงานที่ต้องเหมือนเดิมเป๊ะ
เมื่อพูดถึงโคลนเสียง AI แบบควบคุมที่ต้องการให้เสียงผู้พูดคนเดิมฟังเหมือนกันทุกบรรทัด HeyGen Voice คือชื่อที่ขึ้นอันดับหนึ่งในสนาม Controlled Voice ด้วยคะแนน Elo 1,202 สนามนี้ตรึงเสียงอ้างอิงไว้ 8 เสียง แล้วให้เอนจินแต่ละตัวโคลนเสียงที่ไม่ได้เลือกเอง จึงเป็นการทดสอบความสามารถแท้จริงในการรักษาความเหมือนของเสียงเดิม จุดแข็งของ HeyGen คือการโคลนเสียงผู้พูดคนเดียวในงานยาวๆ หลายพันบรรทัดให้ฟังเหมือนคนเดิมทุกครั้ง ซึ่งตรงกับภาระงานแบบมืออาชีพ เช่น การบันทึกเสียงผู้บรรยายหลักที่ต้องใช้ซ้ำจำนวนมาก แพลตฟอร์มยังมีเสียงสำเร็จรูปมากกว่า 300 เสียงในหลายสิบภาษา แม้จะไม่เปิดเผยจำนวนภาษาแน่ชัด ข้อจำกัดสำคัญคือไม่มีตัวเลขความหน่วงให้ประเมิน และไม่ได้ติดอันดับในสนาม Provider Voices ที่เน้นเสียงเนทีฟของผู้ให้บริการ ทำให้ HeyGen Voice เหมาะกับงานที่โจทย์หลักคือความเหมือนเสียงเดิม มากกว่าการเลือกเสียงจากคลังสำเร็จรูป
ElevenLabs: คุณภาพเสียงรวมและคลังโมเดลที่ครองกระดาน
ฝั่ง ElevenLabs จุดเด่นไม่ได้อยู่แค่คะแนน Elo เดียว แต่คือการครองทั้งกระดานในสนามเสียงผู้ให้บริการ Eleven v4 Turbo ได้อันดับหนึ่งบน Provider Voices arena ด้วย Elo 1,328 และเป็นผู้นำจากโมเดลเสียง 96 ตัวของผู้ให้บริการ ในสิบห้ารายการแรกของสนามควบคุมยังมีโมเดลจากผู้ขายรายเดียวกันถึงห้าตัว ครอบคลุมสองรุ่นและสองระดับราคา รวมถึงเวอร์ชันสำหรับการสนทนาอีกหนึ่งตัว แสดงให้เห็นว่าผู้ให้บริการรายนี้ไม่ได้มีแค่โมเดลเด่นตัวเดียว แต่มีทั้งตระกูลโมเดลที่แข็งแรงหลายระดับ Eleven v4 Turbo ถูกออกแบบให้เป็นโมเดลระดับสูงสุดสำหรับการสังเคราะห์เสียงพูดแบบเรียลไทม์ เหมาะกับตัวแทนฝ่ายสนับสนุน ผู้ช่วย AI และตัวละครแบบโต้ตอบ โดยเข้าถึงผ่าน Text to Dialogue websocket ภายใต้ตัวระบุ eleven_v4_turbo ครอบคลุมมากกว่า 90 ภาษา ตั้งแต่แอฟริกานส์ อาหรับ กวางตุ้ง ฮินดี ญี่ปุ่น แมนดาริน ไปจนถึงซูลู จึงเหมาะกับงานที่ต้องการทั้งเสียง AI ธรรมชาติและการรองรับหลายภาษาในแพลตฟอร์มเดียว ข้อควรระวังคือแม้ HeyGen Voice จะนำหน้าในสนามโคลนเสียงควบคุม แต่ ElevenLabs ยังครองภาพรวมของคุณภาพเสียงผู้ให้บริการ ซึ่งไม่ควรถูกมองข้าม
GPT-Live-1 vs Gemini 3.8 Flash TTS: สนทนาเรียลไทม์หรือเสียงบรรยายราคาประหยัด
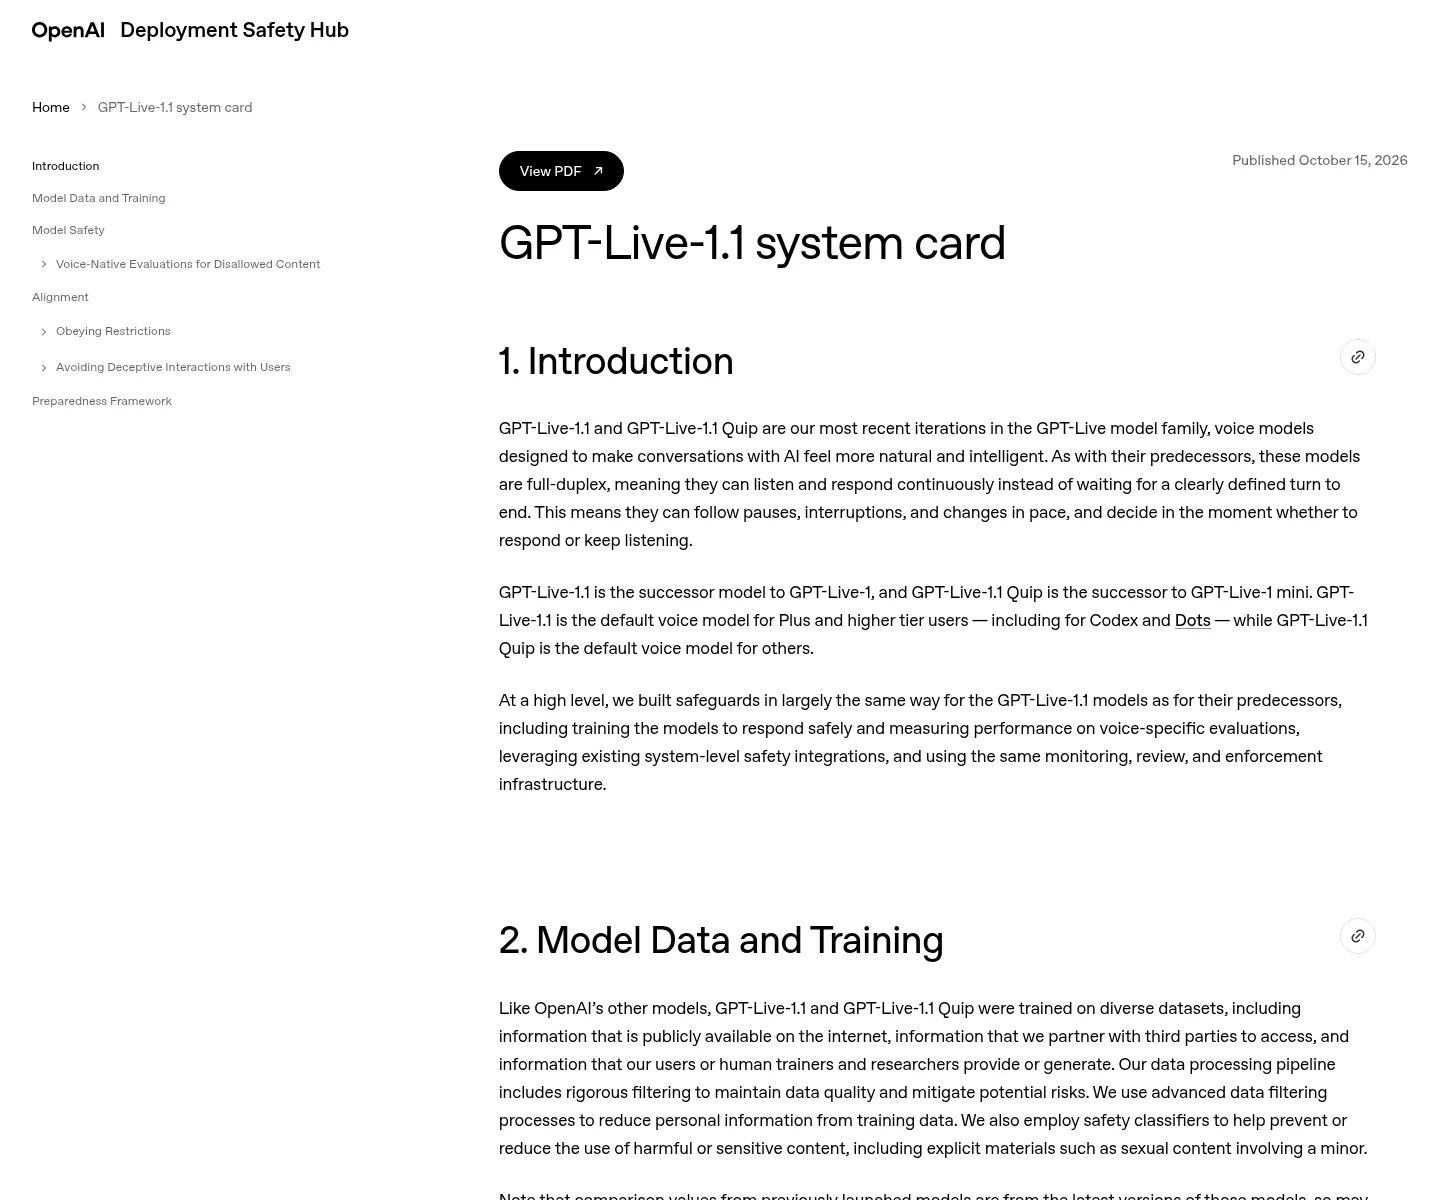
เมื่อขยับจากโคลนเสียง AI ไปสู่การใช้งานเสียงในระบบสนทนาและการบรรยาย เราต้องแยกให้ชัดระหว่าง GPT-Live-1 และ Gemini 3.8 Flash TTS แม้จะถูกนำมาเปรียบเทียบด้านค่าใช้จ่ายต่อนาที แต่ทั้งสองไม่ได้ทำงานแบบเดียวกันเลย GPT-Live-1 เป็นโมเดลสนทนาแบบฟูลดูเพล็กซ์ รับทั้งเสียงและข้อความ และส่งคืนทั้งเสียงและข้อความในเซสชันเดียว ตัดสินใจหลายครั้งต่อวินาทีว่าผู้ใช้พูดจบหรือยัง และให้ทรานสคริปต์จากการรู้จำเสียงพูดเป็นส่วนหนึ่งของเซสชัน ในทางกลับกัน Gemini 3.8 Flash TTS รับเฉพาะข้อความและส่งคืนเสียง ไม่มีการป้อนเสียง ไม่มีแนวคิดของเทิร์นสนทนา ไม่รู้จักการถูกขัดจังหวะ และไม่ส่งคืนทรานสคริปต์เพราะไม่เคยได้ยินอะไรเลย เอ็นด์พอยต์แบบ unary ส่งคืนไฟล์ WAV 24 kHz โมโน ส่วนการสตรีมส่งคืน PCM 16 บิตที่ไม่มีส่วนหัว รองรับ mulaw และ alaw พร้อมอัตราการสุ่มตัวอย่างที่ตั้งค่าได้ ด้านค่าใช้จ่าย ระบบเสียงบรรยายของ Google มีค่าใช้จ่ายประมาณ 1.35 เซนต์ต่อนาทีของคำพูดที่สร้างขึ้น ในขณะที่โมเดลสนทนาของ OpenAI คิดค่าบริการ 5 เซนต์ต่อนาทีของสายที่เปิดอยู่ รวมช่วงที่ผู้ใช้หยุดพูดหรือแบ็กเอนด์กำลังประมวลผล ทำให้เกิดช่องว่างราว 27 เท่าต่อนาที อย่างไรก็ตาม Google ไม่ได้เผยแพร่ค่าความหน่วงอย่างเป็นทางการสำหรับโมเดล TTS ทั้งสอง และตัวเลข time-to-first-audio ที่มีอยู่ล้วนมาจากบุคคลที่สามซึ่งวัดคนละอย่างกับจังหวะการสนทนาของ GPT-Live-1 ดังนั้นการเลือกใช้จึงต้องดูโจทย์งานก่อนว่าต้องการสายสนทนาโต้ตอบสด หรือการเรนเดอร์สคริปต์ข้อความเป็นเสียงบรรยายราคาประหยัด
Buy if / Skip if
- Buy the HeyGen Voice if งานหลักของคุณคือโคลนเสียงผู้พูดคนเดิมให้เหมือนเดิมในทุกบรรทัด เช่น ผู้บรรยายหลักของวิดีโอหรือคอร์สออนไลน์ ที่ต้องการคะแนน Elo สูงสุดในสนามควบคุมเพื่อความมั่นใจในความเหมือนเสียง
- Skip the HeyGen Voice if คุณต้องการเลือกเสียงจากคลังเสียงผู้ให้บริการจำนวนมากพร้อมการจัดอันดับคุณภาพเสียงเนทีฟ เพราะ HeyGen Voice ไม่ได้ติดอันดับในสนาม Provider Voices และไม่ได้ครองคลังโมเดลหลายระดับแบบ ElevenLabs
- Buy the ElevenLabs if คุณต้องการเสียง AI ธรรมชาติจากคลังเสียงผู้ให้บริการที่ครองอันดับหนึ่งในสนาม Provider Voices มีโมเดลเสียงมากถึง 96 ตัว และต้องรองรับมากกว่า 90 ภาษาในแพลตฟอร์มเดียว
- Skip the ElevenLabs if โจทย์หลักของคุณคือการโคลนเสียงผู้พูดเฉพาะในสนามควบคุมที่เน้นความเหมือนเสียงเดิมแบบสุดทาง เพราะในสนามนี้ HeyGen Voice นำหน้า Eleven v4 Turbo อยู่หนึ่งอันดับและคะแนน Elo สูงกว่า
- Buy the GPT-Live-1 if คุณต้องสร้างระบบสนทนาเสียงสองทางแบบเรียลไทม์ที่ต้องรับทั้งเสียงและข้อความ ส่งคืนเสียงและข้อความ พร้อมการตัดสินใจจังหวะพูดจบและทรานสคริปต์ในเซสชันเดียว แม้จะมีค่าใช้จ่ายต่อนาทีสูงกว่าระบบบรรยายข้อความเป็นเสียง
- Skip the GPT-Live-1 if งานของคุณคือการเรนเดอร์สคริปต์ข้อความเป็นเสียงบรรยายจำนวนมากที่ไม่ต้องโต้ตอบสด เพราะในกรณีนี้โมเดลบรรยายอย่าง Gemini 3.8 Flash TTS ที่คิดค่าบริการราว 1.35 เซนต์ต่อนาทีอาจเหมาะกว่าและประหยัดกว่า 27 เท่าเมื่อเทียบกับ GPT-Live-1
- Buy the Gemini 3.8 Flash TTS if คุณต้องการเสียงบรรยายจากข้อความอย่างเดียว รองรับมากกว่า 130 ภาษาในระดับเต็ม และต้องการต้นทุนต่อนาทีที่ต่ำกว่าสายสนทนาแบบฟูลดูเพล็กซ์ เหมาะกับการสร้างเสียง AI ธรรมชาติจากสคริปต์ที่กำหนดไว้ล่วงหน้า
- Skip the Gemini 3.8 Flash TTS if คุณต้องการระบบที่ได้ยินเสียงผู้ใช้ โต้ตอบสด มีเทิร์นสนทนา และให้ทรานสคริปต์กลับมา เพราะโมเดลนี้รับเฉพาะข้อความและไม่รองรับการป้อนเสียงหรือการสนทนาแบบไลฟ์เลย