
นิยามปัญหา โค้ดจาก AI ที่ดูดีแต่ล้มเหลวแบบเงียบ
โค้ดที่สร้างโดยเครื่องมือ AI คือโค้ดที่โมเดลภาษาขนาดใหญ่หรือเอเจนต์อัตโนมัติสร้างขึ้นจากคำสั่งของนักพัฒนา โดยมักผ่านการทดสอบอัตโนมัติขั้นพื้นฐาน แต่ยังแฝงข้อบกพร่องด้านตรรกะ ความเข้ากันได้กับระบบเดิม และความเสถียรเมื่อรันในสภาพแวดล้อมโปรดักชั่น ทำให้เกิดความล้มเหลวแบบเงียบที่ไม่ถูกจับได้จากชุดเทสต์ทั่วไป และกลายเป็นภาระให้ทีมวิศวกรรมต้องแก้ไขย้อนหลัง เครื่องมือช่วยเขียนโค้ดด้วย AI เพิ่มเอาต์พุตการพัฒนาได้ราว 25–35 เปอร์เซ็นต์ ฟังดูเหมือนชัยชนะด้านประสิทธิภาพ แต่บิลที่แท้จริงมักตามมาในอีกไม่กี่เดือนถัดมา เมื่อโค้ดที่ดูสะอาดใน PR และผ่านเทสต์ ถูกนำไปรันร่วมกับบริการอื่นและข้อมูลจริง ผลลัพธ์ที่เห็นคือบั๊กในโปรดักชั่น การวนรีวิวซ้ำ และเวลาของวิศวกรอาวุโสที่ถูกใช้ไปกับการไล่หาต้นตอปัญหาที่ AI เป็นคนเขียน ช่องว่างนี้ไม่ใช่เรื่องเทคนิคอย่างเดียว แต่เป็นปัญหาทางธุรกิจที่บั่นทอน ROI ของการลงทุนใน AI coding tools อย่างชัดเจน
ทำไมโค้ดจาก AI ถึงผ่านเทสต์แต่พังในโปรดักชั่น
หัวใจของปัญหาคือ AI เขียนโค้ดโดยไม่มีภาพรวมของระบบและบริบททั้งหมด แม้เทสต์บนฟังก์ชันเดี่ยวจะผ่าน แต่พฤติกรรมในระบบจริงกลับผิดเพี้ยน ตัวอย่างที่ชัดคือยูทิลิตีส่วนกลางที่ถูกแก้ไขโดยเอเจนต์ AI โดยไม่รู้ว่ามีอีกหกเซอร์วิสอิงอยู่ การเปลี่ยนแปลงนั้นผ่านเทสต์ PR ก็ถูกอนุมัติ แต่สองวันถัดมาเซอร์วิสปลายน้ำเริ่มทำงานผิดปกติในโปรดักชั่น นี่คือความล้มเหลวแบบเงียบที่ไม่แสดงตัวในทันที เบื้องหลังคือข้อจำกัดด้านบริบทของโมเดล AI เอเจนต์มักไม่รู้สถาปัตยกรรม แพทเทิร์น และขอบเขตของโค้ดเบสทั้งหมด จึงสร้างโค้ดที่เข้ากันไม่ได้กับระบบเดิม โดยเฉพาะเลกาซีที่มีเงื่อนไขซับซ้อน การศึกษาเชิงอุตสาหกรรมแสดงให้เห็นว่าสัดส่วนโค้ดที่คอมมิตโดยนักพัฒนาในวันนี้ราว 42 เปอร์เซ็นต์เป็นโค้ดที่ AI สร้างหรือช่วยเขียน และคาดว่าจะขึ้นไปถึง 65 เปอร์เซ็นต์ภายในไม่กี่ปีข้างหน้า เมื่อปริมาณโค้ดจาก AI เพิ่ม แต่ความเข้าใจบริบทไม่เพิ่มตาม ก็ไม่น่าแปลกที่จำนวนบั๊กและอินซิเดนต์ในโปรดักชั่นพุ่งสูง
เมื่อ QA แบบเดิมใช้ไม่ได้กับ AI ยุคใหม่
สองทศวรรษที่ผ่านมา วิศวกรคุณภาพคุ้นเคยกับสมมติฐานว่าถ้าอินพุตเหมือนกัน เอาต์พุตก็ต้องเหมือนกัน การทดสอบจึงเป็นเรื่องผ่านหรือไม่ผ่านอย่างชัดเจน แต่ระบบที่ขับเคลื่อนด้วยแมชชีนเลิร์นนิงและโมเดลภาษาขนาดใหญ่กลับทำลายสมมติฐานนั้นอย่างสิ้นเชิง เอาต์พุตของโมเดลไม่เป็นเชิงกำหนด อินพุตเดียวกันอาจให้คำตอบที่ต่างกันแต่ยังถือว่าถูกต้อง ทำให้การอ้างอิง expected result แบบเดิมใช้ไม่ได้ นี่คือเหตุผลที่การตรวจสอบคุณภาพโค้ดและ AI testing quality assurance ต้องกลายเป็นวินัยใหม่ ไม่ใช่แค่ส่วนขยายของ QA เดิม การทดสอบจำเป็นต้องแยกระดับเป็นชั้นข้อมูล ชั้นโมเดล และชั้นพรอมต์หรือเอเจนต์ แต่ละชั้นมีแนวทางตรวจสอบต่างกัน ตั้งแต่การตรวจคุณภาพข้อมูลด้วยเฟรมเวิร์กที่ประกาศเงื่อนไขเชิงสคีมาและการกระจาย การทำ perturbation testing เพื่อดูว่าโมเดลเสถียรเมื่อข้อมูลมีสัญญาณรบกวน ไปจนถึงการประเมินเชิงสถิติและเชิงความหมาย ไม่สามารถหวังพึ่งเทสต์หน่วยกับเทสต์อินทิเกรชันแบบเดิมเพียงอย่างเดียวได้อีกต่อไป
เฟรมเวิร์กการตรวจยืนยัน โครงสร้างป้องกัน production failures
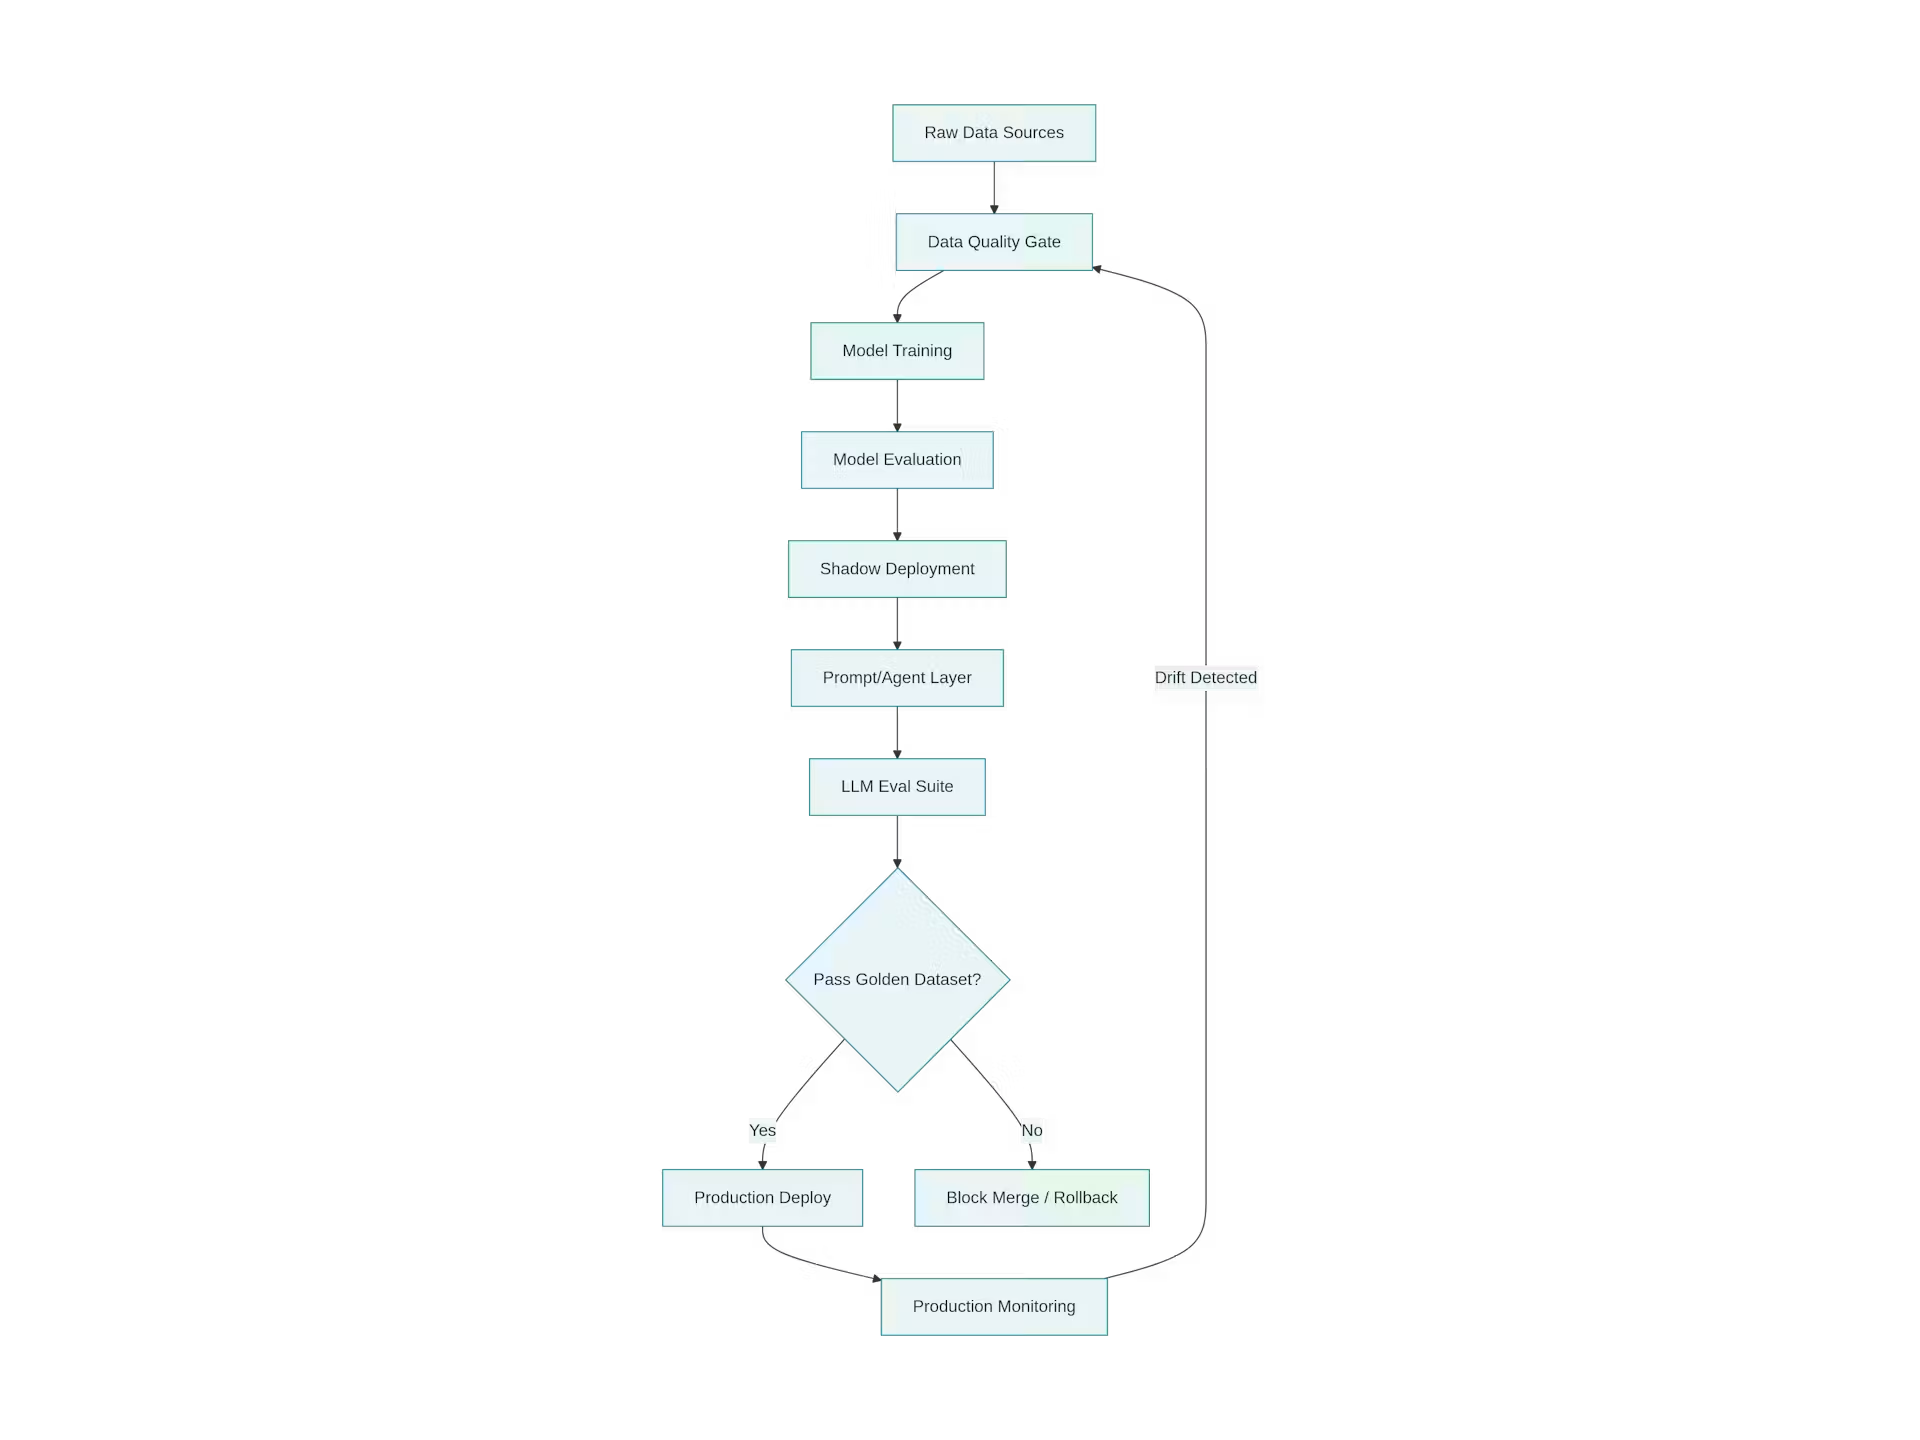
ถ้าเราไม่เปลี่ยนวิธีตรวจโค้ด โค้ดจาก AI ก็จะยังเป็นระเบิดเวลาที่รอระเบิดในโปรดักชั่น ทางออกคือการสร้าง code verification framework ที่ครอบคลุมทั้งคุณภาพ ความปลอดภัย และพฤติกรรมในระบบจริง เฟรมเวิร์กที่ดีจะรวมการตรวจข้อมูล การทดสอบความเสถียรของโมเดล และการมอนิเตอร์โปรดักชั่นเข้าด้วยกันในลูปเดียว เมื่อพบสัญญาณ drift หรือความผิดปกติในโปรดักชั่น ระบบควรเรียกกระบวนการตรวจข้อมูลใหม่ ฝึกโมเดลใหม่ และประเมินผลซ้ำ โดยไม่รอรอบรีลีสครั้งต่อไป แนวคิดอย่าง Guide → Verify → Solve ถูกเสนอเป็นวงจรศูนย์กลางรอบทุกเหตุการณ์การสร้างโค้ดด้วยเอเจนต์ เราให้บริบทและข้อจำกัดที่ถูกต้องแก่เอเจนต์ก่อนเขียนโค้ด จากนั้นใช้การตรวจยืนยันแบบ zero-trust หลายชั้น ทั้งด้านคุณภาพ ความปลอดภัย และการคอมพลายแยกจากว่าตัวใดสร้างโค้ด สุดท้ายให้ผลการตรวจเป็นอินพุตที่เฉพาะเจาะจงสำหรับการแก้ไขหรือการรีมีเดียชัน ไม่ใช่แค่สั่งให้ลองใหม่แบบกว้าง การมี AI code review tools และระบบตรวจสอบคุณภาพโค้ดอัตโนมัติที่วิเคราะห์ทั้งโค้ดมนุษย์และโค้ดจาก AI ด้วยมาตรฐานเดียวกัน และมีอัตรา false positive ต่ำ ช่วยให้ทีมจับข้อผิดพลาดก่อนหลุดไปยังโปรดักชั่น ลดต้นทุนการแก้บั๊กที่เพิ่มขึ้น 10–100 เท่าเมื่อพบในโปรดักชั่นเทียบกับช่วง PR
ปิด acceptance gap ด้วยการย้ายการตรวจไปต้นทาง
วันนี้สิ่งที่เปลี่ยนไปไม่ใช่แค่การทดลองใช้ AI coding แต่คือการนำมันเข้าสู่การพัฒนาจริงอย่างแพร่หลาย นักพัฒนาประเมินว่าราว 42 เปอร์เซ็นต์ของโค้ดที่คอมมิตในปัจจุบันมี AI ช่วยหรือสร้าง และคาดว่าจะขึ้นถึง 65 เปอร์เซ็นต์ในอีกไม่กี่ปี ขณะที่รายงานจากทีมขนาดใหญ่พบว่า median time ในการรีวิว PR เพิ่มขึ้นถึง 441 เปอร์เซ็นต์ ขนาด PR ขยาย 51.3 เปอร์เซ็นต์ จำนวนนักพัฒนาแต่ละคนมีบั๊กเพิ่ม 54 เปอร์เซ็นต์ และอินซิเดนต์ต่อ PR เพิ่ม 242.7 เปอร์เซ็นต์ แม้ task throughput จะเพิ่ม 33.7 เปอร์เซ็นต์ เวลาที่ดูเหมือนจะได้คืนตอนสร้างโค้ด กำลังถูกดึงกลับไปในขั้นตอนรีวิว เทสต์ และการแก้ไข ซึ่งก็คือ acceptance gap แก่นของ acceptance gap คือจังหวะการตรวจยืนยันที่มาช้าเกินไป การแก้ไม่ใช่การลดความเร็วในการใช้ AI แต่คือการย้ายการตรวจเข้าไปใน IDE ในขั้น pre-commit และในลูปเหตุผลของเอเจนต์เอง ข้อบกพร่องที่ถูกรับรู้และแก้ตั้งแต่จุดที่โค้ดถูกสร้างคือข้อบกพร่องที่ถูกแก้ได้ถูกที่สุด การรันวิเคราะห์คุณภาพและสแกนความปลอดภัยก่อนที่มนุษย์จะเปิด PR ช่วยให้รีวิวมนุษย์เน้นการออกแบบและเจตนาแทนที่จะเสียเวลาไปกับบั๊กพื้นฐาน กรอบคุณภาพสมัยใหม่จึงต้องมีหลายชั้น ตั้งแต่ acceptance gates ใน CI การสแกนความปลอดภัย การตรวจคอมพลาย ไปจนถึง feedback loop จากโปรดักชั่นกลับสู่ชั้นข้อมูลและโมเดล หากไม่สร้างวงจรนี้ ทีมจะยังจ่าย “ภาษีวิศวกรอาวุโส” ที่ต้องคอยดับไฟในโปรดักชั่นและแก้หนี้เทคนิคที่สะสมแบบเงียบ