
รากฐานข้อมูลสำคัญกว่าการเพิ่มโมเดล
แพลตฟอร์มข้อมูล AI คือโครงสร้างที่รวบรวม จัดวาง และเปิดใช้ข้อมูลขององค์กรให้ระบบปัญญาประดิษฐ์เข้าถึงได้อย่างเหมาะสม ภายใต้ข้อกำหนดด้านความเร็ว ความปลอดภัย และการกำกับดูแลที่องค์กรกำหนดเอง ความเคลื่อนไหวจาก Hammerspace, Hitachi Vantara และ Phison ในงาน Supercomputing 2026 ชี้ว่าโจทย์ AI ระดับองค์กรไม่ได้จบที่การเลือกโมเดล แต่เริ่มจากการทำให้ข้อมูลพร้อมใช้โดยไม่สร้างคอขวดหรือสูญเสียการควบคุม
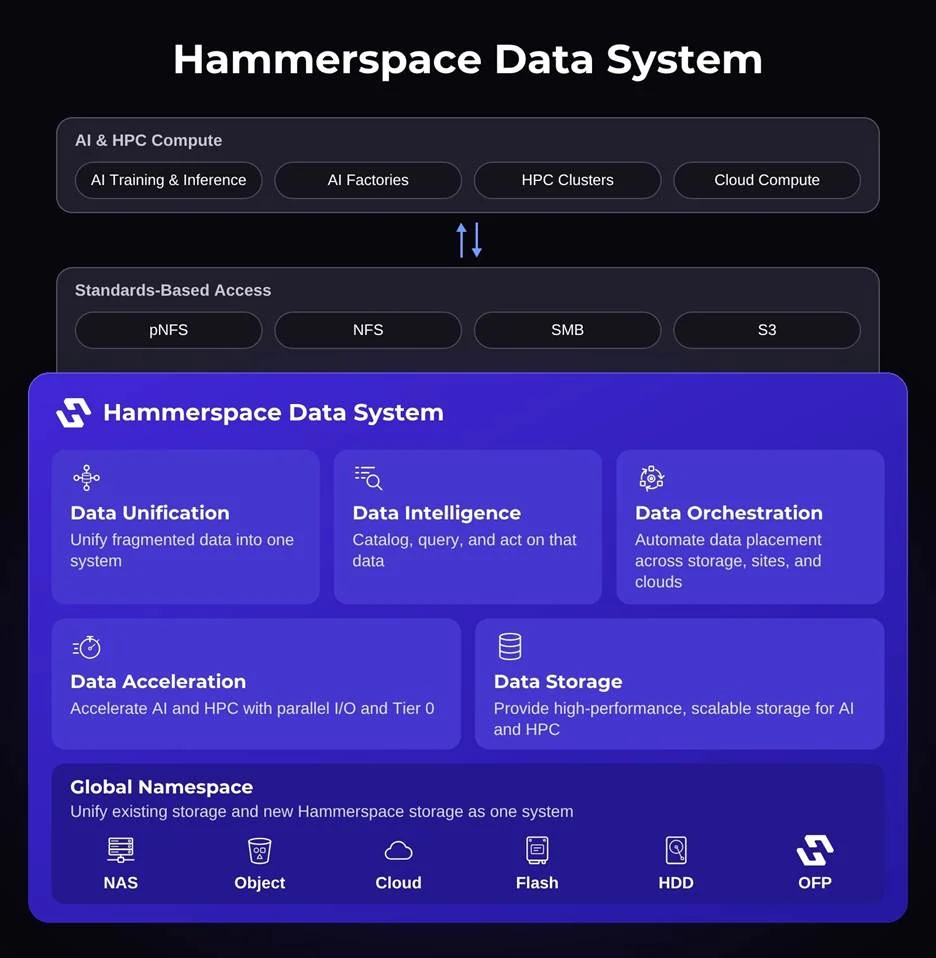
เหตุผลที่เรื่องนี้เร่งด่วนคือหลายองค์กรทดลองใช้ AI แล้ว แต่ยังขยายสู่การใช้งานทั่วทั้งกิจการได้ยาก ขณะเดียวกัน GPU มีจำกัดและถูกใช้งานไม่เต็มที่ ทั้งที่ทรัพยากรโครงสร้างพื้นฐานมีต้นทุนสูงขึ้น Hammerspace จึงเปิดตัว Hammerspace Data System ที่งานดังกล่าว โดยเน้นการจัดการข้อมูลและการรับส่งข้อมูลแบบขนาน เพื่อส่งข้อมูลที่เหมาะสมให้ AI แต่ละชนิดในเวลาที่ต้องการ ข้อสรุปที่ควรจับตาคือการเพิ่มพลังประมวลผลอย่างเดียวอาจไม่ช่วย หากข้อมูลยังไปไม่ถึงระบบที่ต้องใช้
Hammerspace เน้นลดคอขวดและจัดวางข้อมูล
แนวทางของ Hammerspace เหมาะกับองค์กรที่มีข้อมูลกระจายอยู่หลายระบบ ศูนย์ข้อมูล และคลาวด์ แต่ต้องการให้เวิร์กโหลด AI เข้าถึงข้อมูลได้รวดเร็ว แพลตฟอร์มใช้ global namespace บนระบบไฟล์แบบขนาน พร้อมความสามารถจัดวางข้อมูลให้เหมาะกับตำแหน่งและงานที่กำลังทำ การนำเซิร์ฟเวอร์จัดเก็บข้อมูลแบบเดิมออกจากเส้นทางยังอาจลดคอขวดด้าน I/O และลดความจำเป็นในการเผื่อโครงสร้างพื้นฐานเกินกว่าการใช้งานจริง
จุดเด่นนี้สัมพันธ์กับงานยุค AI Agent ซึ่งต้องเรียกใช้ข้อมูลและบริบทอย่างต่อเนื่อง รวมถึงการเพิ่ม Open Flash Platform ที่ใช้หน่วยประมวลผล DPU ช่วยแบ่งเบางานจากเซิร์ฟเวอร์ทั่วไป และแคช KV ในหน่วยความจำสำหรับจัดเก็บบริบท อย่างไรก็ตาม แนวทางนี้ไม่ได้เน้นมอบเครื่องมือวิเคราะห์ให้ผู้ใช้ธุรกิจโดยตรงเท่ากับการแก้ปัญหาการไหลของข้อมูล จึงเหมาะกับองค์กรที่มีโครงสร้างจัดเก็บซับซ้อนและต้องการเพิ่มประสิทธิภาพการใช้ทรัพยากร AI มากกว่าการเริ่มต้นจากแดชบอร์ด
Hitachi Vantara วางข้อมูลไว้ใกล้การวิเคราะห์
Hitachi Vantara ขยาย VSP One และ Hitachi iQ โดยเพิ่มความสามารถ object storage พร้อมต่อยอดดาต้าเลคเฮาส์องค์กรให้วิเคราะห์ข้อมูลได้ใกล้กับตำแหน่งที่จัดเก็บ ชุดปรับปรุงนี้ช่วยให้องค์กรเริ่มใช้งานด้วยการตั้งค่าขนาดสี่โหนดและขยายต่อเมื่อความต้องการเพิ่มขึ้น สำหรับข้อมูลรูปแบบเปิดที่รองรับ เช่น Iceberg, Parquet, JSON และ CSV ระบบสามารถสืบค้นบน VSP One Object ได้โดยตรง ลดการย้ายหรือคัดลอกข้อมูลไปยังระบบวิเคราะห์แยกต่างหาก
บริษัทระบุว่าความสามารถใหม่นี้รองรับประสิทธิภาพการสืบค้นเชิงวิเคราะห์ได้เร็วขึ้นสูงสุดห้าเท่า โดยใช้ CPU น้อยลงร้อยละ 80 นี่เป็นข้อเสนอที่ตรงกับองค์กรซึ่งต้องการเก็บข้อมูลไว้ในระบบเดิม แต่เปิดให้ทีมวิเคราะห์และ AI ใช้งานภายใต้การกำกับดูแล Hitachi iQ Studio เพิ่มส่วนสำหรับสร้าง จัดการ และกำกับแอปพลิเคชันกับเอเจนต์ AI รวมถึงเปิดการเข้าถึงข้อมูลมีโครงสร้างและไม่มีโครงสร้าง จุดแลกเปลี่ยนคือคุณค่าหลักอยู่ที่การต่อยอดระบบนิเวศ VSP One และ Hitachi iQ มากกว่าการนำเสนอ Generative BI แบบพร้อมใช้เป็นปลายทาง
Phison เน้น Generative BI และอำนาจควบคุม
Phison เลือกตอบโจทย์อีกด้านด้วย AI Data Platform หรือ AIDP ซึ่งเป็นระบบ AI แบบ sovereign ติดตั้งภายในองค์กร รวมโครงสร้างพื้นฐาน โมเดลที่โฮสต์ในเครื่อง บริการประมวลผล การวิเคราะห์ที่มีการกำกับ และพื้นที่จัดเก็บข้อมูลถาวร แพลตฟอร์มเชื่อมกับ Wren AI ให้ผู้ใช้ธุรกิจและเอเจนต์ถามคำถามด้วยภาษาธรรมชาติ สร้างข้อมูลเชิงลึกที่อิง SQL และทำแดชบอร์ดจากข้อมูลขององค์กรได้
ความต่างสำคัญคือ Phison วาง Generative BI องค์กรไว้ใกล้ผู้ใช้งาน โดยใช้บริบทและนิยามทางธุรกิจที่ได้รับอนุมัติเพื่อช่วยให้ผลวิเคราะห์สอดคล้องกับสิทธิ์และความหมายของข้อมูล ข้อมูลสำคัญ คำสั่งที่ป้อน และผลลัพธ์ AI อยู่ในสภาพแวดล้อมที่ลูกค้าควบคุมได้ จึงเหมาะกับกิจการที่ข้อจำกัดการส่งข้อมูลออกและข้อกำกับมีน้ำหนักสูง Phison ระบุว่า AIDP พร้อม GenBI เปิดให้ใช้งานแล้ว โดยปรับการติดตั้งตามความต้องการของแต่ละองค์กร แต่แนวทางระบบสำเร็จรูปนี้แก้โจทย์การวิเคราะห์และการควบคุม มากกว่าการประสานข้อมูลข้ามระบบที่กระจายตัวแบบ Hammerspace
เลือกตามปัญหาข้อมูล ไม่ใช่ตามกระแส AI
ทั้งสามรายไม่ได้เสนอแพลตฟอร์มที่แทนกันได้โดยตรง Hammerspace เด่นด้านการจัดการข้อมูลข้ามระบบและการเพิ่มความเร็ว I/O สำหรับงานที่ต้องป้อนข้อมูลให้ทรัพยากรประมวลผลต่อเนื่อง Hitachi Vantara เน้น object storage และการวิเคราะห์ข้อมูลรูปแบบเปิด ณ จุดจัดเก็บ พร้อมการกำกับการเข้าถึงผ่าน Hitachi iQ ส่วน Phison รวม AI ภายในองค์กรกับการถามตอบเชิงธุรกิจไว้ในชุดเดียว เพื่อให้ผู้ใช้ได้คำตอบโดยไม่ต้องส่งข้อมูลสำคัญออกนอกสภาพแวดล้อมที่ควบคุม
ดังนั้น การเลือกแพลตฟอร์มข้อมูล AI ควรเริ่มจากการระบุคอขวดจริง หากข้อมูลกระจัดกระจายและ GPU รอข้อมูล ให้พิจารณาการจัดวางและ parallel I/O หากองค์กรต้องการวิเคราะห์ข้อมูลเดิมโดยลดการทำสำเนา ดาต้าเลคเฮาส์ของ Hitachi คือแนวทางที่ตรงกว่า หากเป้าหมายคือให้ทีมธุรกิจถามข้อมูลได้พร้อมรักษาการควบคุมระบบ Phison ตอบโจทย์มากกว่า ท้ายที่สุด การจัดการข้อมูล AI ที่ดีไม่ใช่การซื้อทุกแนวทางพร้อมกัน แต่คือการเลือกโครงสร้างที่เชื่อมข้อมูล คน และข้อกำกับเข้ากับงานจริงได้