
เริ่มจากคำถามว่า ต้องเห็นข้อความเมื่อไร
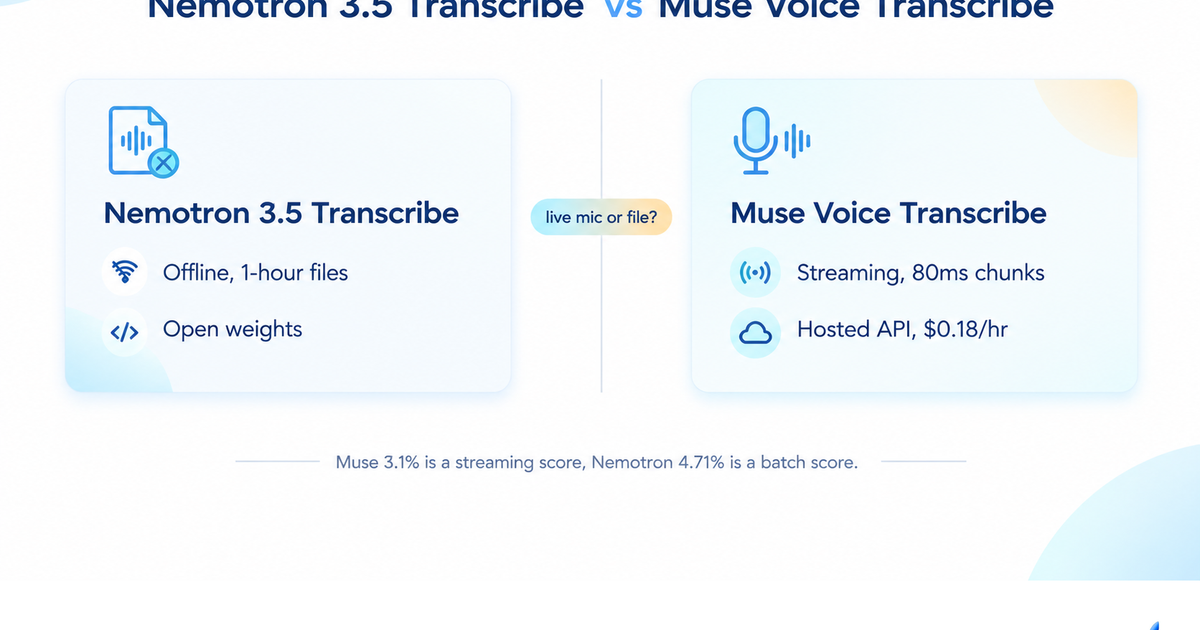
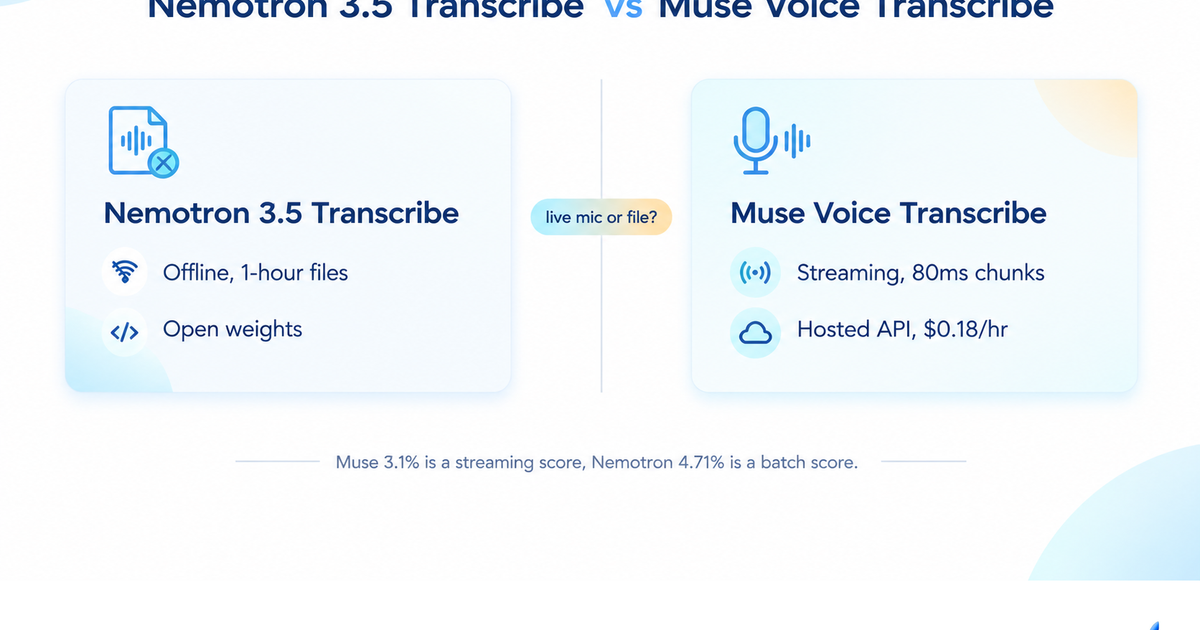
โมเดลถอดเสียง AI คือระบบที่แปลงเสียงพูดเป็นข้อความ พร้อมความสามารถเพิ่มเติมอย่างการระบุผู้พูดหรือแปลภาษา โดยแต่ละรุ่นเหมาะกับช่วงเวลาการทำงานและชนิดไฟล์ที่ต่างกัน ไม่ว่าจะเป็นเสียงสดหรือเสียงบันทึกที่ต้องนำมาประมวลผลภายหลัง หากต้องใช้ข้อความตามบทสนทนาที่กำลังเกิดขึ้น Muse Voice เป็นตัวเลือกที่ตรงกว่า เพราะรองรับการถอดเสียงแบบเรียลไทม์ ส่วน Nemotron Transcribe เหมาะกับการส่งไฟล์ให้ระบบถอดเสียงหลังการประชุมหรือหลังจบสาย การเลือกจึงไม่ควรตัดสินจากตัวเลขความแม่นยำเพียงค่าเดียว แต่ควรดูว่าความหน่วงยอมรับได้แค่ไหน ต้องแยกผู้พูดกี่คน และต้องการติดตั้งโมเดลไว้เองหรือไม่
| ประเด็น | Nemotron 3.5 Transcribe | Muse Voice Transcribe |
|---|---|---|
| รูปแบบหลัก | โมเดลเปิดน้ำหนัก ประมวลผลไฟล์แบบออฟไลน์ | ถอดเสียงแบบสตรีมมิ่ง เหมาะกับเสียงสด |
| ความหน่วงและข้อมูลเสียง | รับไฟล์ยาวได้สูงสุดหนึ่งชั่วโมง ไม่มีข้อความระหว่างประมวลผล | รับเสียงเป็นชิ้นส่วนละ 80 มิลลิวินาที ข้อความสุดท้ายตามหลังการพูดราว 0.16 วินาที |
| ความแม่นยำที่รายงาน | ค่าเฉลี่ย 5.33% WER บนชุดทดสอบภาษาอังกฤษของโมเดลเปิดน้ำหนัก | 3.1% WER ในการทดสอบแบบสตรีมมิ่ง |
| การแยกผู้พูดอัตโนมัติ | ระบุผู้พูดได้สูงสุดแปดคน และมีป้ายกำกับผู้พูด 13 ภาษา | รองรับผู้พูดมากกว่า 20 คนในไฟล์เดียว |
| ภาษาและงานเสริม | ถอดเสียง 40 ภาษา แปล 31 ภาษาไปหรือมาจากภาษาอังกฤษ | ถอดเสียงมากกว่า 25 ภาษา |
| การใช้งาน | ดาวน์โหลดน้ำหนักไปติดตั้งได้ภายใต้สัญญาอนุญาตที่กำหนด | ใช้บริการสตรีมมิ่งผ่านช่องทางเชื่อมต่อสำหรับเสียงสด |
Muse เหมาะเมื่อทุกวินาทีระหว่างประชุมมีค่า
จุดแข็งของ Muse คือการถอดเสียงระหว่างที่คนยังพูดอยู่ ระบบรับเสียงเป็นช่วงสั้นและตัดสินใจว่าจะรอบริบทอีกนานเท่าใดก่อนยืนยันข้อความ จึงเหมาะกับคำบรรยายสด การช่วยเจ้าหน้าที่ระหว่างสนทนา หรือการค้นหาประเด็นจากการประชุมที่ยังดำเนินอยู่ ตัวเลขความหน่วงราว 0.16 วินาทีหลังจบการพูดช่วยอธิบายว่าทำไมรูปแบบนี้จึงต่างจากการส่งไฟล์มารอผล Muse ยังได้เปรียบเมื่อต้องทำแยกผู้พูดอัตโนมัติในวงสนทนาขนาดใหญ่ โดยระบุว่ารองรับมากกว่า 20 คนในไฟล์เดียว อย่างไรก็ดี การรองรับจำนวนมากไม่ได้แปลว่าจะจัดการเสียงพูดซ้อนกันได้ทุกกรณี เอกสารของโมเดลระบุเงื่อนไขการแยกผู้พูดสำหรับเสียงที่ไม่พูดทับซ้อน หากเป็นประชุมที่หลายคนพูดพร้อมกัน ควรทดสอบกับเสียงจริงก่อนนำไปใช้ตัดสินใจหรือจัดทำบันทึกทางการ
ค่า WER 3.1% ที่รายงานสำหรับ Muse เป็นผลทดสอบแบบสตรีมมิ่ง ไม่ใช่คะแนนที่เทียบตรงกับผลทดสอบแบบประมวลผลเป็นชุดของ Nemotron ความต่างของชุดข้อมูลและรูปแบบทดสอบทำให้การนำตัวเลขมาลบกันไม่ใช่หลักฐานว่าโมเดลหนึ่งแม่นยำกว่าในทุกสถานการณ์ ดังนั้น หากงานของคุณคือประชุมสด ให้ประเมินจากความหน่วงและคุณภาพข้อความในสภาพเสียงจริง มากกว่าตัดสินจากตัวเลข WER ที่มาจากคนละงาน
Nemotron เด่นกับไฟล์ยาวและการควบคุมการติดตั้ง
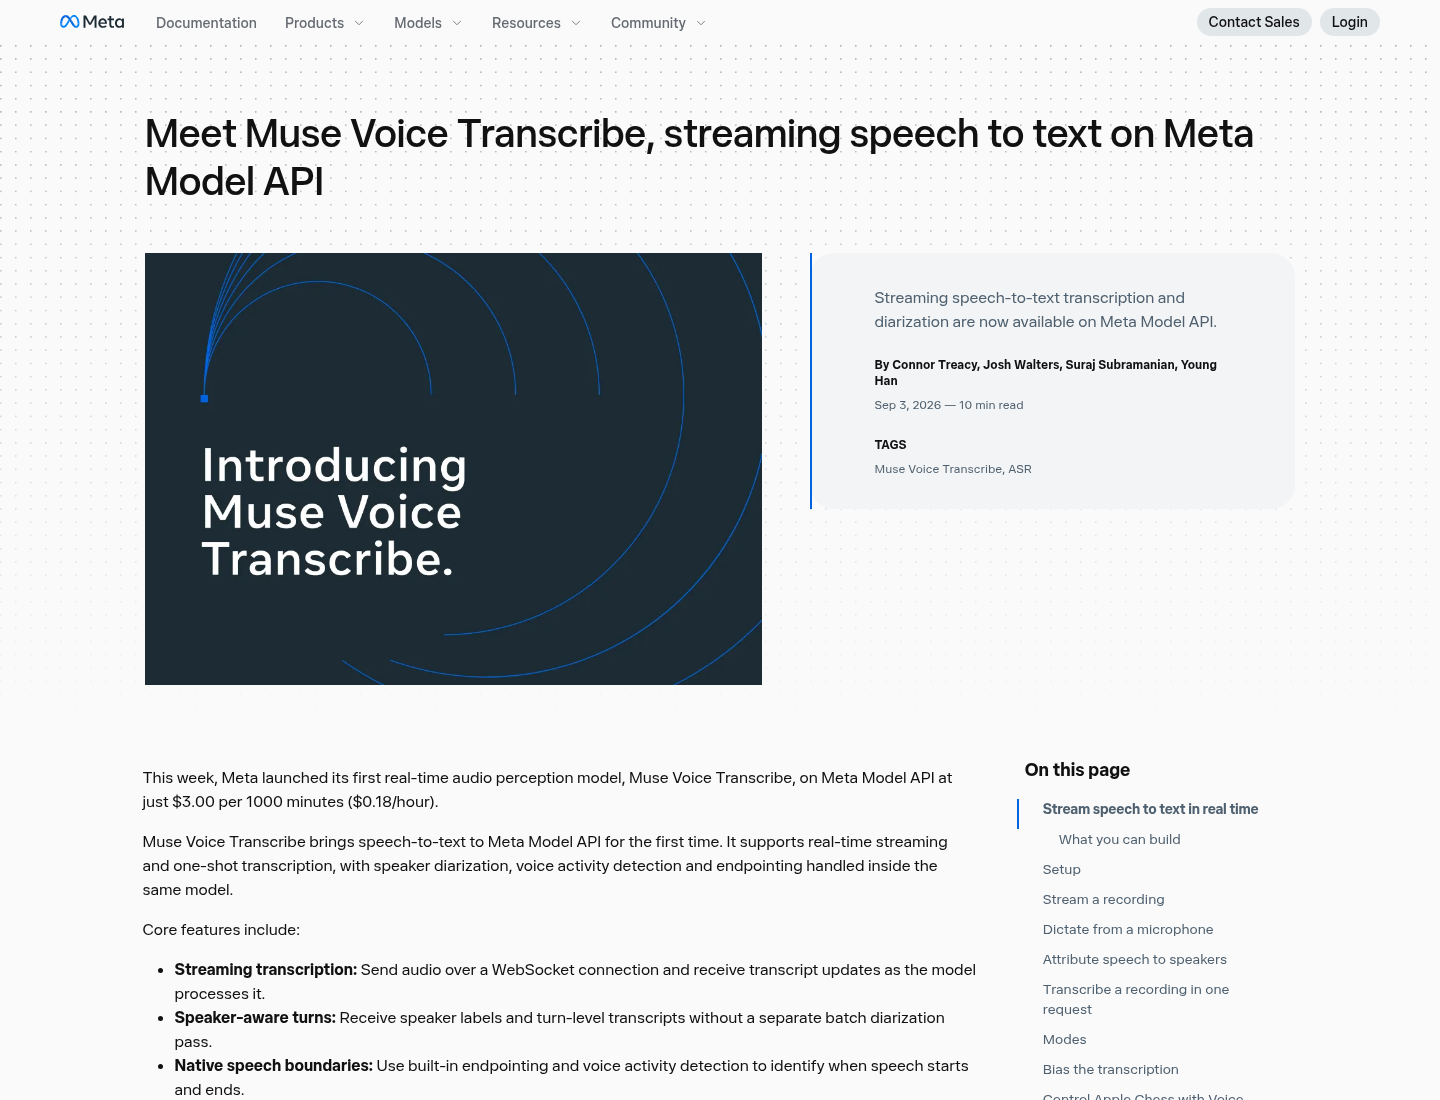
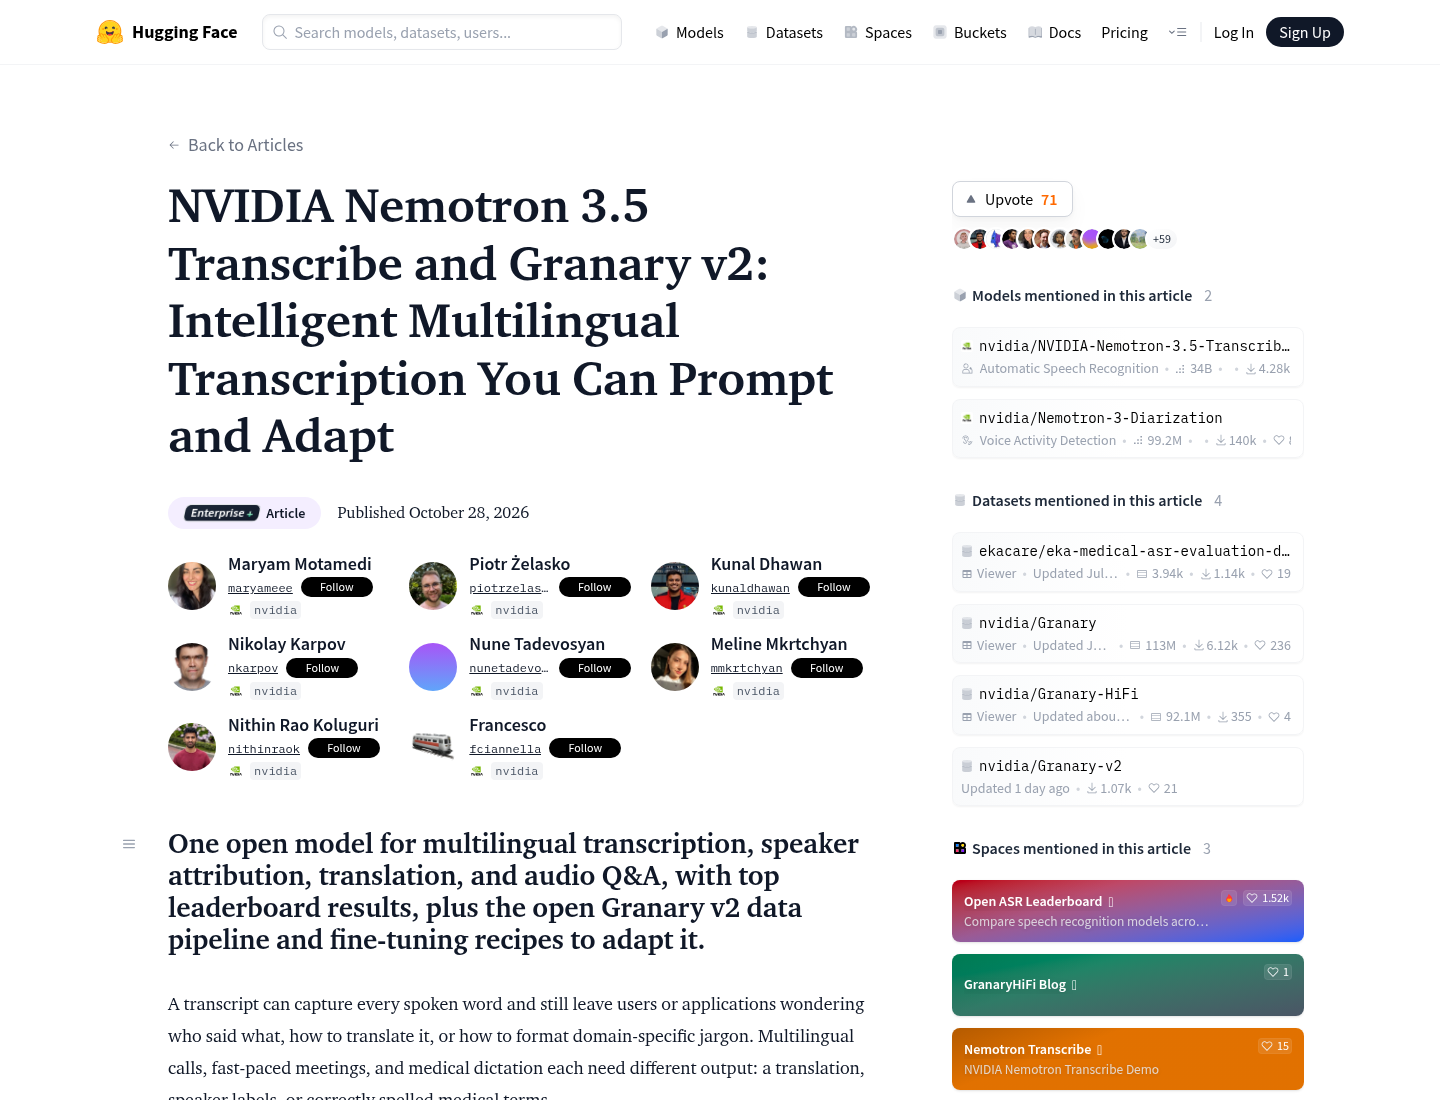
Nemotron 3.5 Transcribe เป็นโมเดลเปิดน้ำหนักที่รับไฟล์เสียงแบบออฟไลน์ได้ยาวสูงสุดหนึ่งชั่วโมง เหมาะกับงานถอดบันทึกการประชุมย้อนหลัง สายสนับสนุนลูกค้า หรือคลังเสียงที่ไม่ต้องแสดงข้อความทันที จุดสำคัญคือการแบ่งไฟล์ภายในไม่ได้ทำให้โมเดลกลายเป็นระบบสตรีมมิ่ง ผู้ใช้จึงไม่ควรเลือก Nemotron หากต้องส่งข้อความให้ผู้เข้าร่วมเห็นระหว่างการสนทนา ในด้านความสามารถ Nemotron ถอดเสียงได้ 40 ภาษา แปล 31 ภาษาไปหรือมาจากภาษาอังกฤษ และระบุผู้พูดได้ 13 ภาษา พร้อมรองรับป้ายกำกับผู้พูดสูงสุดแปดคน ตัวเลข 5.33% WER เป็นค่าเฉลี่ยที่รายงานบนชุดทดสอบภาษาอังกฤษสำหรับโมเดลเปิดน้ำหนัก จึงใช้เป็นข้อมูลประกอบได้ แต่ไม่ควรตีความเป็นคำรับรองผลในทุกภาษา สำเนียง หรือสภาพเสียง การทดสอบด้วยตัวอย่างจากงานจริง รวมถึงชื่อเฉพาะและศัพท์เฉพาะขององค์กร ยังเป็นขั้นตอนที่ควรทำก่อนใช้งาน
Nemotron ยังน่าสนใจสำหรับทีมที่ต้องการควบคุมรูปแบบติดตั้งและปรับคำสั่งให้เข้ากับงาน เช่น ถอดทุกคำตามเสียง ใส่เวลาของคำ หรือระบุศัพท์เฉพาะ ความยืดหยุ่นนี้แลกกับการต้องจัดการการประมวลผลไฟล์เองหรือเลือกบริการที่นำโมเดลไปให้บริการแล้ว อีกข้อควรระวังคือ ทั้งสองรุ่นไม่ได้เผยแพร่ค่าความเชื่อมั่นระดับคำให้ใช้ตรวจคำที่ไม่แน่ใจโดยตรง หากความผิดพลาดมีผลต่อเอกสารสำคัญ ควรมีขั้นตอนตรวจทานโดยคน
ตัดสินจากจำนวนผู้พูดและจังหวะการทำงาน
สำหรับวงสนทนาที่มีผู้พูดไม่เกินแปดคนและต้องการผลถอดเสียงหลังจบ Nemotron เป็นตัวเลือกที่มีเหตุผล โดยเฉพาะเมื่อการติดตั้งโมเดลเองและงานหลายภาษาเป็นเงื่อนไขสำคัญ แต่ถ้าการประชุมมีผู้เข้าร่วมจำนวนมากที่ผลัดกันพูด Muse มีเพดานที่ประกาศไว้สูงกว่าอย่างชัดเจน ส่วนกรณีที่หลายคนพูดทับกันจริง อย่าดูเพียงจำนวนผู้พูดสูงสุด ให้ตรวจว่าระบบแยกคำและระบุเจ้าของเสียงได้ดีเพียงใดในตัวอย่างของคุณ หากต้องการทั้งข้อความสดและบทถอดเสียงที่ตรวจทานได้จากไฟล์ภายหลัง การใช้ระบบสตรีมมิ่งระหว่างประชุมแล้วประมวลผลไฟล์เดิมด้วย Nemotron หลังจบงานเป็นแนวทางที่ตอบโจทย์คนละช่วง ไม่ใช่การเลือกโมเดลเดียวให้ทำทุกอย่าง สำหรับผู้ใช้ทั่วไป ให้เริ่มจากคำถามง่าย ๆ ว่าข้อความต้องพร้อมใช้ระหว่างสายหรือไม่ ถ้าใช่ ให้เลือก Muse หากไม่ใช่และต้องการทำงานกับไฟล์ออฟไลน์ ให้พิจารณา Nemotron
### Buy if / Skip if
- Buy the Muse Voice if ต้องแสดงข้อความระหว่างประชุมสด ใช้คำบรรยาย หรือช่วยเจ้าหน้าที่ระหว่างสนทนา
- Skip the Muse Voice if งานหลักคือประมวลผลไฟล์ย้อนหลังและไม่ต้องการบริการสตรีมมิ่ง
- Buy the Muse Voice if ต้องรองรับการแยกผู้พูดในวงสนทนาที่มีผู้เข้าร่วมมากกว่าแปดคนและส่วนใหญ่ผลัดกันพูด
- Skip the Muse Voice if การระบุผู้พูดในเสียงที่พูดทับซ้อนเป็นเงื่อนไขสำคัญ โดยยังไม่ได้ทดสอบกับเสียงจริง
- Buy the Nemotron Transcribe if ต้องการโมเดลเปิดน้ำหนักสำหรับไฟล์ออฟไลน์ ไฟล์ยาว หรือการติดตั้งที่ควบคุมได้
- Skip the Nemotron Transcribe if ต้องการข้อความแบบเรียลไทม์ระหว่างการประชุม
- Buy the Nemotron Transcribe if งานต้องถอดเสียงหลายภาษา แปลภาษา หรือใส่เวลาของคำและข้อมูลผู้พูดในไฟล์
- Skip the Nemotron Transcribe if เสียงมีผู้พูดเกินแปดคนและต้องการให้โมเดลเดียวจัดการทั้งหมด