
เอกสารธุรกิจอัตโนมัติไม่ใช่แค่ OCR เร็ว แต่คือข้อมูลที่เชื่อถือได้
การแยกข้อมูลจากเอกสารคือกระบวนการแปลงข้อความ ตัวเลข ตาราง และโครงสร้างจากเอกสารธุรกิจทั้ง PDF สแกน และไฟล์ดิจิทัลให้กลายเป็นข้อมูลเชิงโครงสร้างที่ระบบอื่นนำไปใช้ต่อได้อย่างเชื่อถือได้ โดยอาศัยทั้ง OCR ความแม่นยำ การประมวลผล PDF โมเดลตรวจจับเลย์เอาต์ ตาราง และการตรวจสอบข้อมูลโครงสร้างซ้ำก่อนบันทึกลงฐานข้อมูล เพื่อให้เอกสารธุรกิจอัตโนมัติทำงานได้จริงในสถานการณ์หน้างาน
ในโลกเอกสารธุรกิจที่เต็มไปด้วยตารางหลายหน้า เชิงอรรถ และเลย์เอาต์ครีเอทีฟ ความเร็วของ AI ไม่ได้ช่วยอะไรถ้าข้อมูลที่ออกมานำไปใช้ผิดทาง การโฟกัสแต่ OCR ความแม่นยำหรือเปอร์เซ็นต์คะแนนเดียวคือมุมมองที่อันตราย เพราะคุณสามารถอ่านทุกคำถูกแต่จับคู่ตัวเลขกับหัวคอลัมน์ผิด ส่งผลให้รายงาน การวิเคราะห์ และการตัดสินใจผิดไปทั้งชุด การประมวลผล PDF ที่ดีและการตรวจสอบข้อมูลโครงสร้างจึงสำคัญกว่าการวิ่งให้เร็ว
ทำไม OCR เก่งอ่านคำแต่ยังแยกข้อมูลผิดในเอกสารซับซ้อน
หลายทีมเชื่อว่าถ้า OCR ความแม่นยำสูงกว่าร้อยละเกือบสมบูรณ์ งานการแยกข้อมูลจากเอกสารจะจบ แต่ประสบการณ์ระบุชัดว่าความคิดนี้ผิด OCR มีบทบาทแค่เปลี่ยนหน้าเอกสารที่สแกนเป็นข้อความให้เครื่องอ่านได้เท่านั้น ความสำเร็จของ OCR จึงไม่เท่ากับความสำเร็จในการแยกข้อมูล คุณอาจจำทุกคำถูกแต่ตีความเอกสารผิดทั้งเล่มได้
ลองนึกถึงตารางสัญญาเช่าที่มีหลายคอลัมน์สำหรับวันที่ จำนวนเงิน และเงื่อนไขต่อสัญญา หากระบบทำการแยกข้อมูลโดยสูญเสียความสัมพันธ์ระหว่างค่าแต่ละช่องกับหัวคอลัมน์ แม้ข้อความจะถูกต้อง ผลลัพธ์เชิงโครงสร้างก็ผิดได้ทั้งหมด ในเอกสารการเงิน ตัวเลขเดียวอาจเป็นรายได้ ค่าใช้จ่าย หรือกำไร ขึ้นอยู่กับแถว คอลัมน์ ช่วงเวลา และป้ายกำกับรอบข้าง ดังนั้นการอ่านตัวเลขโดยไม่เข้าใจเลย์เอาต์คือสูตรสำเร็จของความผิดพลาด และเป็นเหตุผลที่ต้องมีโมเดลเลย์เอาต์และการตรวจสอบข้อมูลโครงสร้างตามมาเสมอ
เลย์เอาต์ โมเดลตาราง และการประมวลผล PDF คือหัวใจของความแม่นยำ
ปัญหาใหญ่ของการประมวลผล PDF คือการทำให้เลย์เอาต์เสียรูป มาตรฐานตัวอ่าน PDF มักดึงข้อความตามลำดับการเรนเดอร์ตัวอักษรไม่ใช่ลำดับการอ่านเชิงสายตา เมื่อเจอเรซูเมหรือเอกสารสองคอลัมน์ ระบบดั้งเดิมจะอ่านลากข้ามสองคอลัมน์จนกลายเป็นข้อความปนกันทั้งประวัติการทำงานและทักษะในบรรทัดเดียว การป้อนข้อความแบบนี้เข้าโมเดลภาษาจะสิ้นเปลืองบริบทและลดความแม่นยำลงอย่างหนัก
ทางออกจึงต้องเริ่มจากการประมวลผล PDF เชิงพื้นที่ โดยจัดเรียงข้อความตามพิกัดแนวนอนและแนวตั้ง แยกบล็อกจากแต่ละคอลัมน์ แล้วแปลงเป็นบล็อกมาร์กดาวน์ที่มีโครงสร้างคงที่ก่อนจะส่งต่อเข้าโมเดล เมื่อผสานกับโมเดลเลย์เอาต์ที่ตรวจจับหัวเรื่อง ย่อหน้า ตาราง และโซนคู่ค่า รวมถึงโมเดลตรวจจับตารางที่ช่วยสร้างแถวและคอลัมน์กลับคืนมา ระบบจึงสามารถจัดการเอกสารธุรกิจอัตโนมัติที่ไม่ใช้เทมเพลตมาตรฐานได้ดีขึ้น เพราะเข้าใจทั้งข้อความและโครงสร้างไปพร้อมกัน
แยกปัญหาเป็นหลายสเตจ แล้วตรวจสอบด้วยสคีมาไม่ให้ข้อมูลหลุดผิด
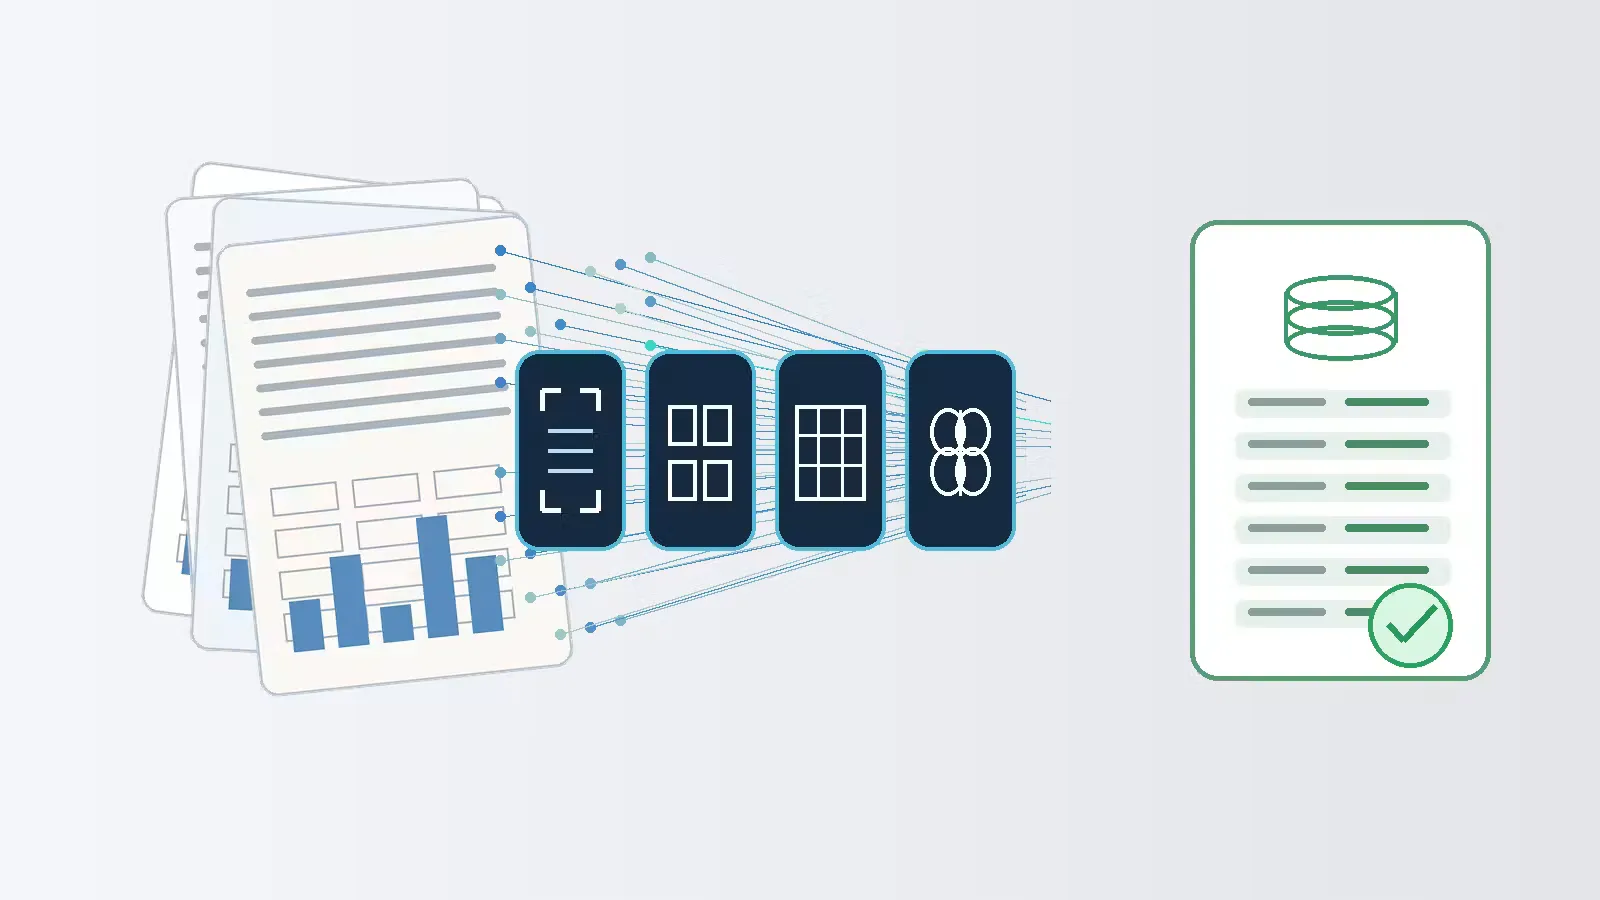
แนวทางที่ใช้งานได้ดีคือสร้างสายงานแบบหลายสเตจที่แต่ละส่วนรับผิดชอบคนละปัญหา ส่วนหนึ่งดูแลคุณภาพหน้าและภาพ อีกส่วนอ่านข้อความ โมเดลเลย์เอาต์ระบุหัวเรื่อง ย่อหน้า ตาราง และโซนคู่ค่า โมเดลตารางประกอบแถวและคอลัมน์ จากนั้นโมเดลสกัดข้อมูลจึงแมปข้อมูลสำคัญลงสคีมาเป้าหมาย ข้อดีคือความผิดพลาดแต่ละชนิดจะถูกแยกและทดสอบได้ง่ายขึ้น และระบบมีหลักฐานมากขึ้นก่อนถามโมเดลภาษาให้ตีความเอกสาร
สายงานที่ดีมักเป็นเส้นตรงและแยกส่วนชัดเจน เริ่มจากการรับเอกสาร การทำความสะอาดเลย์เอาต์ การประกอบพรอมป์ การส่งเข้าทำนาย และการตรวจสอบสัญญาด้วยตัวตรวจสอบสคีมาก่อนบันทึกฐานข้อมูล บทเรียนสำคัญคือไม่ควรเชื่อผลโมเดลที่ไม่ผ่านการตรวจสอบเสมอ ผลลัพธ์จากโมเดลควรถูกปฏิบัติเหมือนอินพุตจากผู้ใช้ภายนอก และต้องมีขอบเขตการตรวจด้วยสคีมาอย่างชัดเจนระหว่างโมเดลและสถานะของแอปพลิเคชัน นี่คือเกราะคุ้มกันไม่ให้ข้อมูลผิดหลุดไปทำลายการเงิน กฎหมาย หรือระบบตัดสินใจอื่น
เปอร์เซ็นต์ความแม่นยำไม่เล่าเรื่องจริง การตรวจสอบโครงสร้างจึงเป็นตัวชี้ขาด
การรายงานตัวเลขความแม่นยำระดับ 99.5 เปอร์เซ็นต์ฟังดูสวย แต่ตัวเลขเดียวสามารถซ่อนปัญหาได้มาก ระบบอาจทำงานดีบนตารางการเงินที่สะอาดแต่ล้มเหลวบนสัญญาเช่าสแกน สิ่งที่ผู้ใช้ปลายทางสนใจไม่ใช่คะแนนเฉลี่ย แต่คือคำถามว่าข้อมูลที่ส่งเข้าโมเดลวิเคราะห์ รายงาน หรือระบบตัดสินใจนั้นเชื่อถือได้ในแต่ละกรณีหรือไม่
นี่คือเหตุผลว่าทำไมการประมวลผล PDF และการทำความสะอาดเลย์เอาต์จึงคิดเป็นสัดส่วนใหญ่ของความแม่นยำ การเพิ่มขนาดโมเดลไม่สามารถแก้ข้อมูลดิบที่ยุ่งเหยิงได้ การจัดเลย์เอาต์เป็นมาร์กดาวน์เชิงความหมายก่อนทำนายให้ผลลัพธ์ที่เชื่อถือได้มากกว่าการเร่งเพิ่มพารามิเตอร์โมเดล และเมื่อข้อมูลที่เคยเข้าถึงยากถูกแปลงเป็นข้อมูลเชิงโครงสร้างแล้ว มันจึงสามารถเสริมพลังระบบวิเคราะห์ โมเดลข้อมูล รายงาน การค้นหา และระบบตัดสินใจต่อเนื่องได้ โดยมีเงื่อนไขว่าทีมปลายทางต้องเชื่อใจข้อมูลชุดนั้นก่อน สุดท้ายแล้วความเร็วของ AI จึงแพ้ให้กับความแม่นยำแบบตรวจสอบได้ในโลกเอกสารธุรกิจอัตโนมัติ