
เมื่อเกณฑ์ยังไม่ชัด AI ไม่ควรเป็นผู้ตัดสินเพียงลำพัง
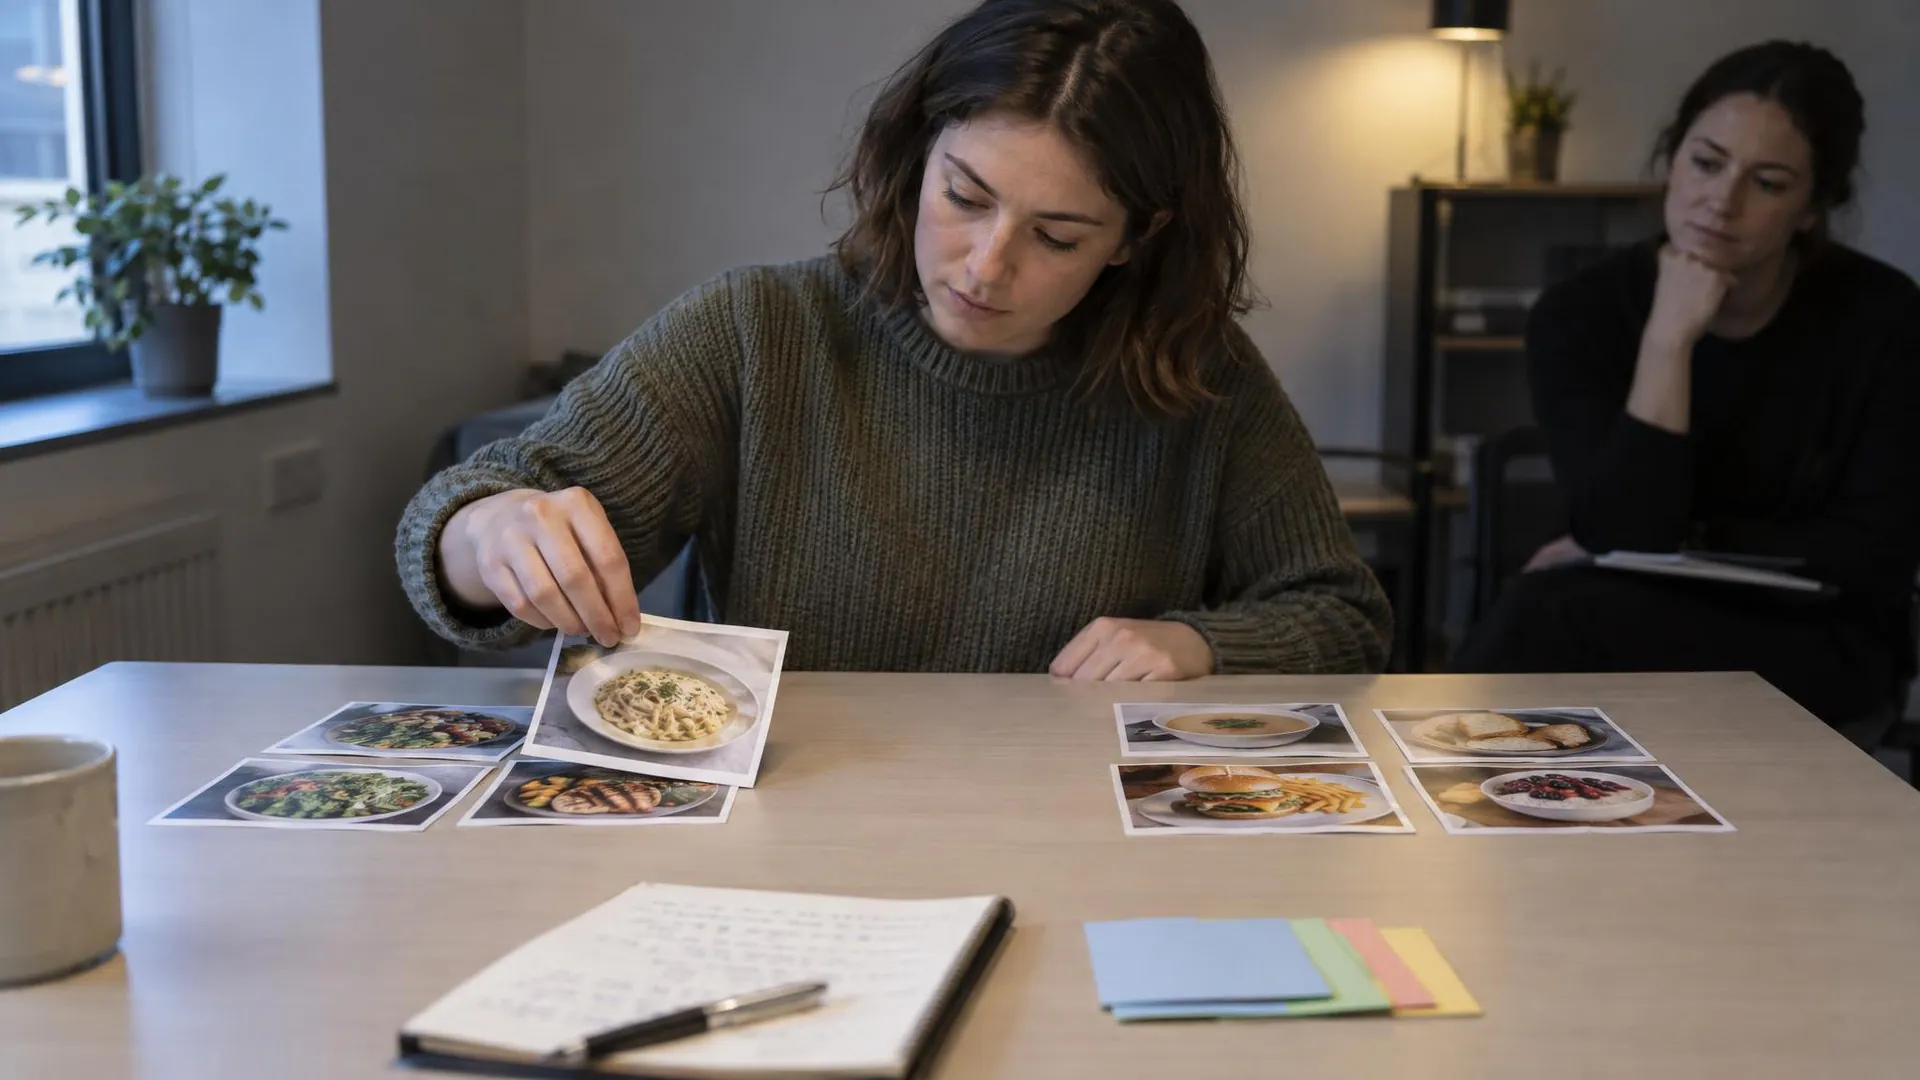
Agile Deliberation คือกรอบการทำงานแบบโต้ตอบที่ให้มนุษย์ร่วมกำหนดและปรับนิยามของหมวดหมู่ซับซ้อน ก่อนนำเกณฑ์ที่พัฒนาขึ้นไปสร้างตัวจำแนกรูปภาพ AI ให้สอดคล้องกับวิจารณญาณของผู้ใช้และบริบทที่เกี่ยวข้อง Google Research นำเสนอกรอบนี้เมื่อวันที่ 4 พฤศจิกายน 2026 พร้อมเผยแพร่โค้ดโอเพนซอร์สและเดโมในโน้ตบุ๊กให้ทดลองใช้ แนวคิดนี้สำคัญเพราะคำอย่าง “อาหารเพื่อสุขภาพ” หรือ “งานศิลปะที่สร้างแรงบันดาลใจ” ไม่มีเส้นแบ่งที่ทุกคนยอมรับตรงกัน เกณฑ์อาจเปลี่ยนตามวัฒนธรรม นโยบาย หรือความเข้าใจของแต่ละคน การฝึกโมเดลแบบเดิมมักสมมติว่ามนุษย์มีนิยามตายตัวตั้งแต่ก่อนเริ่มติดป้ายภาพ แต่ในความเป็นจริง ผู้คนมักค้นพบข้อยกเว้นและปรับความคิดเมื่อเห็นตัวอย่างจริง หากบังคับให้ตัดสินเร็ว ป้ายกำกับย่อมไม่สม่ำเสมอ และ AI ก็อาจสร้างคำตอบที่ดูเด็ดขาดทั้งที่เกณฑ์ยังคลุมเครือ
จากการตั้งนิยาม สู่การทดสอบภาพก้ำกึ่ง
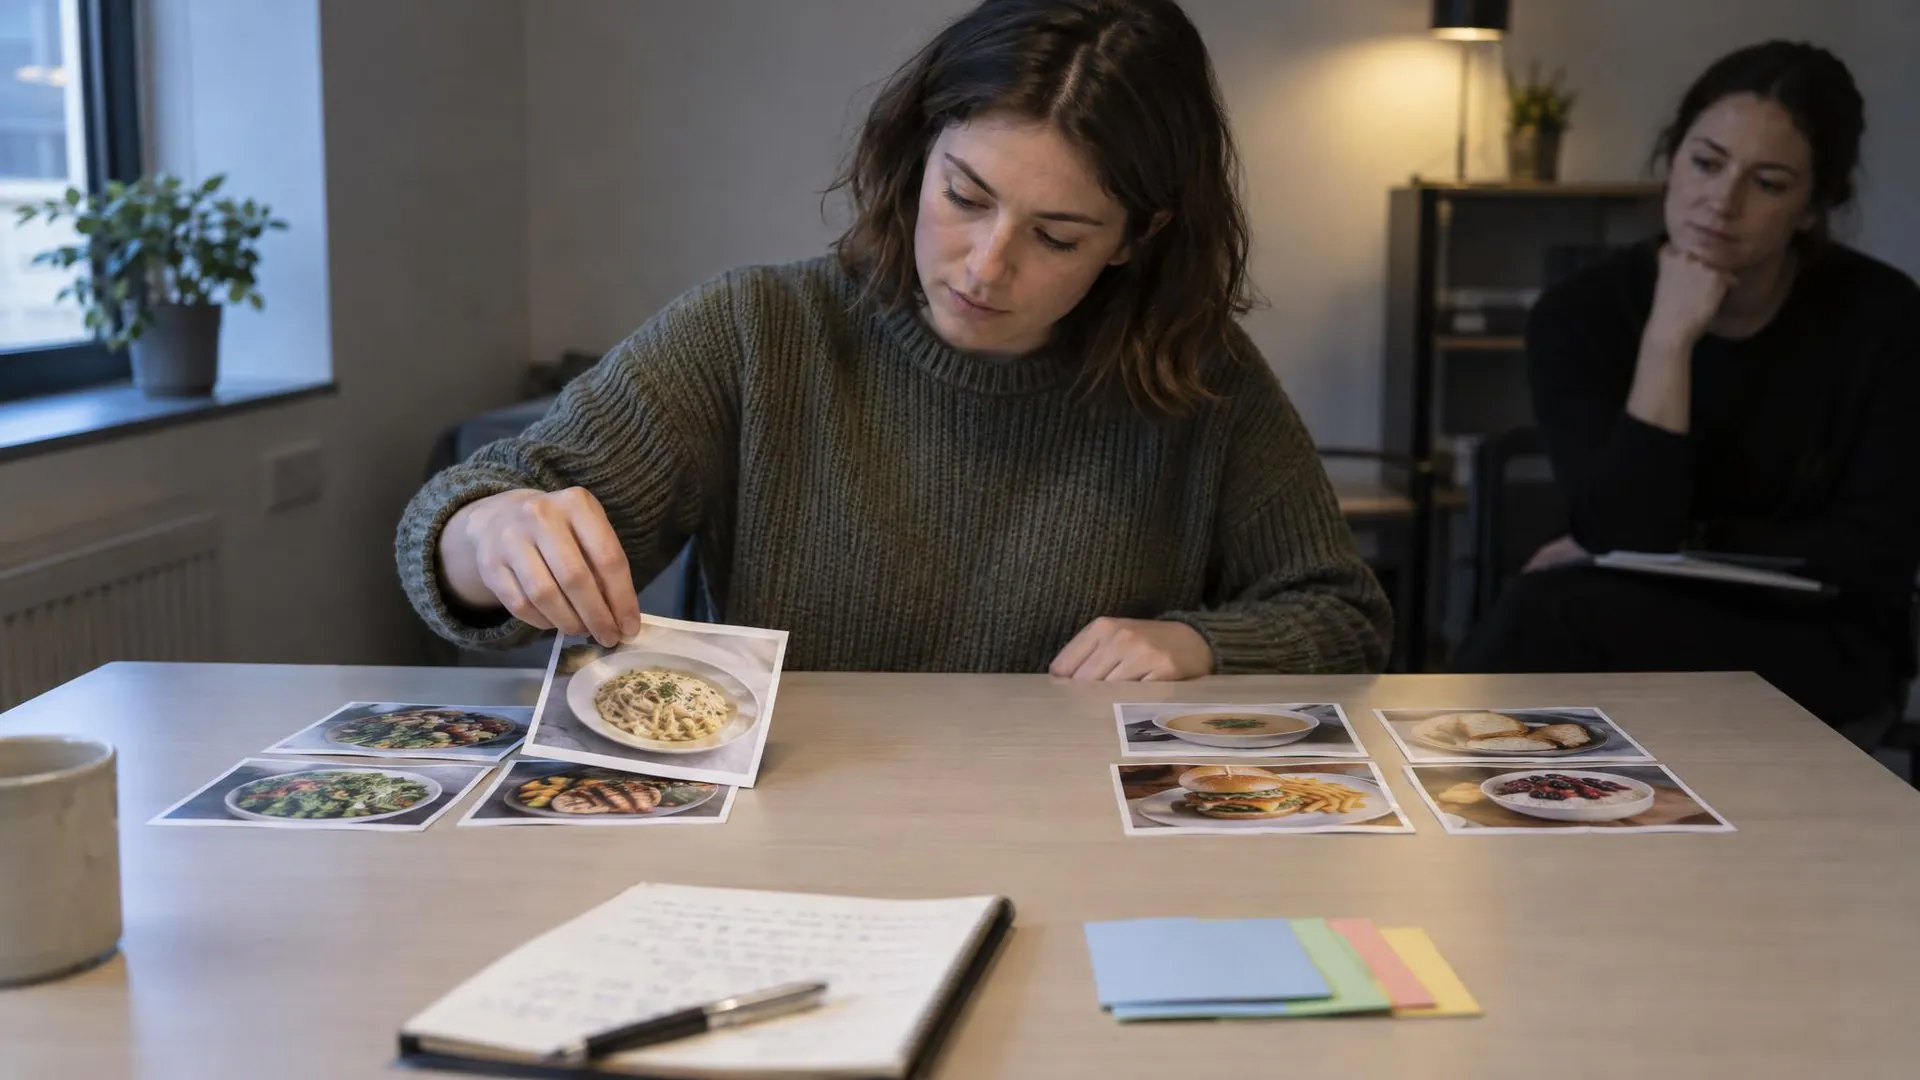
จุดแข็งของ Agile Deliberation คือเปลี่ยนการสร้างตัวจำแนกจากการป้อนป้ายกำกับทางเดียว ให้เป็นวงสนทนาที่มนุษย์กับระบบช่วยกันขัดเกลาความหมาย นิยามที่เปลี่ยนแปลงระหว่างทางจะถูกแปลงเป็นทั้งข้อกำหนดที่คนอ่านเข้าใจและพรอมป์ต์สำหรับโมเดลภาษากับภาพ นี่คือแนวทางมนุษย์กำกับ AI ที่มองความเห็นของคนเป็นส่วนหนึ่งของการออกแบบ ไม่ใช่แค่ข้อมูลตั้งต้น กระบวนการเริ่มจากการแยกแนวคิดกว้างให้เป็นส่วนที่อยู่ในขอบเขตและอยู่นอกขอบเขต เช่น ระบุว่าสลัดอยู่ในกลุ่มอาหารเพื่อสุขภาพ แต่ตัดอาหารแปรรูปบางประเภทออก จากนั้นระบบจะเสนอภาพที่อาจตีความได้หลายแบบ เช่น สมูทตี้ที่มีน้ำตาลสูง เพื่อให้ผู้ใช้ชี้แจงว่าเกณฑ์ควรอยู่ตรงไหน การใช้ภาพโต้แย้งช่วยเปิดเผยจุดบอดได้ดีกว่าการให้ผู้ใช้คิดคำค้นหาและแก้พรอมป์ต์เอง อย่างไรก็ดี AI ยังทำหน้าที่ค้นหาและทดสอบตัวเลือก ส่วนการตัดสินความหมายสุดท้ายยังควรอยู่กับมนุษย์
ผลทดลองน่าสนใจ แต่ยังไม่ใช่คำตอบสุดท้าย
การประเมินครอบคลุม 18 เซสชันจากผู้เข้าร่วม 9 คน โดยเปรียบเทียบการใช้ระบบกับการพิจารณาด้วยตนเองในหัวข้ออาหารเพื่อสุขภาพและเนื้อหาแบบจ่ายเพื่อเล่น ผู้เข้าร่วมทุกคนชอบ Agile Deliberation มากกว่าการทำงานด้วยตนเอง และรายงานว่าต้องใช้ความพยายามเฉลี่ย 3.11 เทียบกับ 4.67 คะแนน ขณะที่คะแนนความไม่มั่นใจ ความเครียด หรือความหงุดหงิดอยู่ที่ 1.67 เทียบกับ 3.00 ด้านผลจำแนก คะแนน F1 ในกรณีจ่ายเพื่อเล่นเพิ่มขึ้น 11% เมื่อเทียบกับฐานแบบซีโร่ช็อต ส่วนการพิจารณาด้วยตนเองเพิ่มขึ้น 8% จากฐานของวิธีนั้น สำหรับอาหารเพื่อสุขภาพ ระบบดีขึ้น 10% ขณะที่การพิจารณาด้วยตนเองลดลง 3% ตัวเลขนี้สนับสนุนว่าการชี้ให้เห็นตัวอย่างยากช่วยให้เกณฑ์ใช้งานได้ดีขึ้น แต่การทดลองมีผู้เข้าร่วมจำนวนน้อย และไม่ควรขยายผลไปทุกบริบทโดยไม่ทดสอบเพิ่ม ดังนั้น คุณค่าของงานนี้ไม่ได้อยู่ที่การประกาศว่า AI เข้าใจความหมายแทนคนได้ หากอยู่ที่การทำให้ความเห็นต่างและข้อยกเว้นถูกหยิบมาพิจารณาอย่างเป็นระบบ
ข้อสรุป: ให้ AI ช่วยคิด ไม่ใช่ยึดอำนาจนิยาม
หมวดหมู่อัตวิสัยเป็นโจทย์ที่การมีข้อมูลจำนวนมากไม่ได้รับประกันว่าเกณฑ์จะถูกต้อง เพราะปัญหาอาจอยู่ที่ผู้คนยังตกลงกันไม่ได้ว่าคำว่า “ถูกต้อง” หมายถึงอะไร Agile Deliberation เสนอทางเลือกที่เหมาะกว่าแนวคิดปล่อยให้โมเดลเลือกเส้นแบ่งเอง นั่นคือให้มนุษย์เห็นตัวอย่างก้ำกึ่ง อธิบายเหตุผล และปรับนิยามจนตัวจำแนกสะท้อนเจตนาที่ชัดขึ้น การเปิดโค้ดและเดโมให้ทดลองเป็นก้าวที่ดี เพราะช่วยให้คนตรวจสอบวิธีทำงานและนำไปประเมินกับโจทย์ของตนได้ แต่ผลจากการทดลองขนาดเล็กยังเป็นหลักฐานเบื้องต้น ไม่ใช่คำรับรองว่าจะใช้ได้กับทุกวัฒนธรรมหรือทุกนโยบาย ข้อสรุปจึงชัดเจน: เมื่อเกณฑ์มีพื้นที่สีเทา ควรออกแบบ AI ให้เป็นคู่คิดที่ถามกลับและเรียนรู้จากการพิจารณาร่วมกัน ไม่ใช่ผู้ตัดสินที่ซ่อนสมมติฐานไว้หลังคำตอบมั่นใจ