
AI Coding Agent ในโปรดักชันคืออะไร และทำไมทีมต้องคิดใหม่
AI Coding Agent ในโปรดักชันคือระบบอัตโนมัติที่ใช้โมเดลภาษาขนาดใหญ่เพื่อเขียนโค้ด เรียกใช้เครื่องมือ และตัดสินใจบนโครงสร้างแอปที่ใช้งานกับผู้ใช้จริงอย่างต่อเนื่อง โดยมีพฤติกรรมเปลี่ยนได้จากการอัปเดตโมเดล พร็อมป์ หรือดาต้าโดยไม่ต้องดีพลอยโค้ดใหม่ จึงต้องมีเลเยอร์กำกับ การทดสอบที่ทำซ้ำได้ และกลไกหยุดความเสียหายระหว่างรันที่ชัดเจน ทีมส่วนใหญ่ยังคิดด้วยโมเดลเว็บแอปเดิม เช่นคอนเทนเนอร์ stateless หลังโหลดบาลานเซอร์ autoscale ตาม CPU หรือ queue และ CI/CD ที่รีสตาร์ตเซอร์วิสเมื่อ health check ตาย โมเดลนี้แม้ยังใช้ได้กับเว็บทั่วไปแต่ใช้ไม่ได้กับ AI agent ที่รันแบบ persistent และมีงานของตัวเอง การมองว่าเป็นแค่เว็บแอปที่โทรหา LLM จะอยู่รอดบนโปรดักชันเพียงประมาณหนึ่งสัปดาห์ก่อนเริ่มมี incident ที่ไม่มีบทใน runbook เดิมรองรับ ถ้าทีมยังคิดว่าปัญหานี้แก้ด้วย VPS ใหญ่ขึ้น จะพลาดว่าช่องว่างเป็นเรื่องสถาปัตยกรรม ไม่ใช่ทรัพยากร ดังนั้นบทความนี้จะโต้แย้งให้จัดการ AI agent แบบระบบใหม่ทั้งชุด ตั้งแต่ code governance machine learning ไปจนถึง feature flag infrastructure และ reproducible AI testing
ชั้นกำกับแบบ Demotion Ladder และการแบ่งสิทธิ์เขียนเพื่อหยุดโค้ดหลุดราง
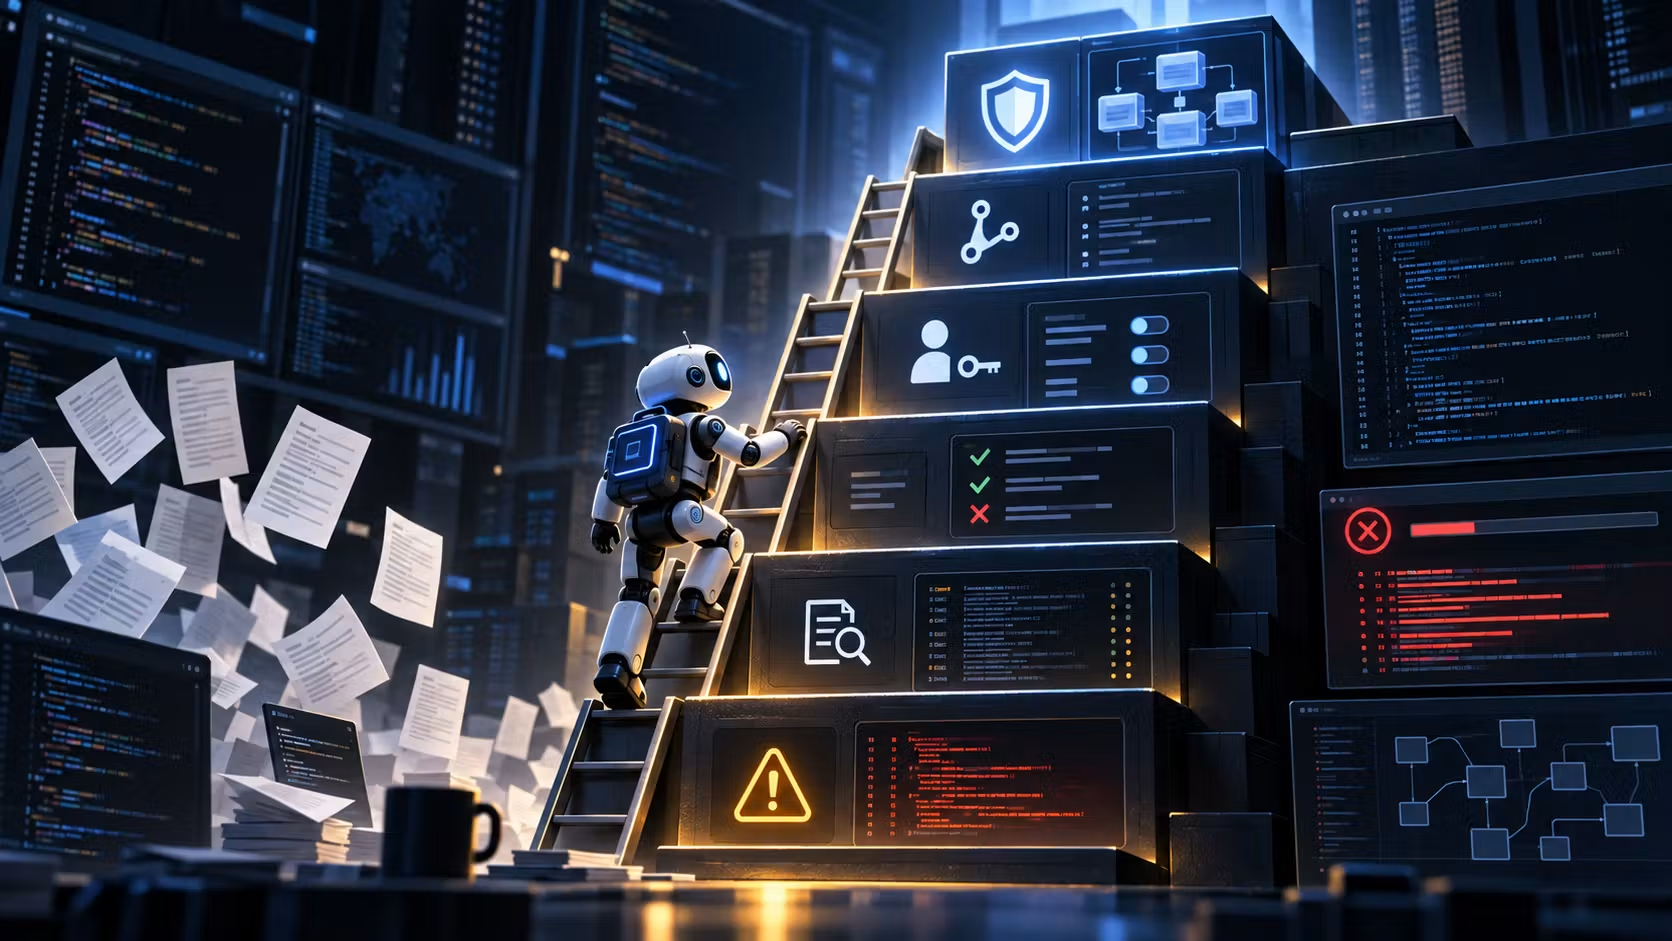
ปัญหาใหญ่ของ AI Coding Agent ไม่ใช่ว่ามันไม่อ่านคู่มือ แต่คือคู่มือยาวจนกลายเป็นเสียงรบกวน นักพัฒนาคนหนึ่งให้ agent ทำงานกับโปรดักชันที่มีราว 1,000 endpoint และส่วนประกอบซับซ้อนสารพัดตั้งแต่สัญญา API แบบ generate export Excel/PDF ระบบแจ้งเตือน เท็มเพลตหน้า และข้อยกเว้นเยอะมาก ตลอด 14 เดือนเอกสารกฎเพิ่มเป็นประมาณ 18 ไฟล์ ไฟล์ละ 250–750 บรรทัด รวมมากกว่า 5,000 บรรทัด แต่พอให้ทำฟีเจอร์ CRUD ใหม่ที่ทุกอย่างมีตัวอย่างอยู่แล้ว agent กลับผลิต MVP ที่เหมือนโค้ดจากจูเนียร์ 10 คนคนละสไตล์ ทั้งโครง endpoint ผิด ไม่ใช้ client ที่ generate ธีมไม่ตรง เท็มเพลตไม่ reuse และเทสต์ขาดจนระบบ build ไม่ผ่าน คำตอบไม่ใช่เขียนคู่มือเพิ่ม แต่ต้องเปลี่ยนจากกฎแบบร้อยแก้วมาเป็นชั้น governance ที่บังคับใช้ได้จริง Demotion Ladder ทำแบบนั้นโดยให้ทุกกฎเริ่มต้นเป็นคำอธิบาย และเมื่อ agent ฝ่าฝืน กฎนั้นจะถูกส่งลงบันไดหนึ่งขั้น แต่ละขั้นทำให้ agent ข้ามยากขึ้น และต้นทุนดูแลสูงขึ้นตาม เมื่อจำเป็นก็แบ่งสิทธิ์เขียนออกตามบทบาท อ่านและ grep เปิดหมดเพราะการอ่านไม่เคยสร้างความเสียหาย แต่สิทธิ์เขียนคือต้นตอ ขั้นสูงสุดคือทำให้สถานะผิดกฎหมายแทบไม่สามารถแทนในโค้ดได้ เช่นบังคับให้ใช้ client ที่ generate เป็นทางเดียวที่คอมไพล์ผ่าน หรือวางขอบเขตโมดูลให้ build ตรวจได้ นี่คือ code governance machine learning แบบที่ไม่ฝากความหวังไว้กับการที่ agent จะจำกฎได้เอง
ทำให้การรันของ AI Agent ทำซ้ำได้ ตรวจสอบได้ และใช้ทดสอบอัตโนมัติ
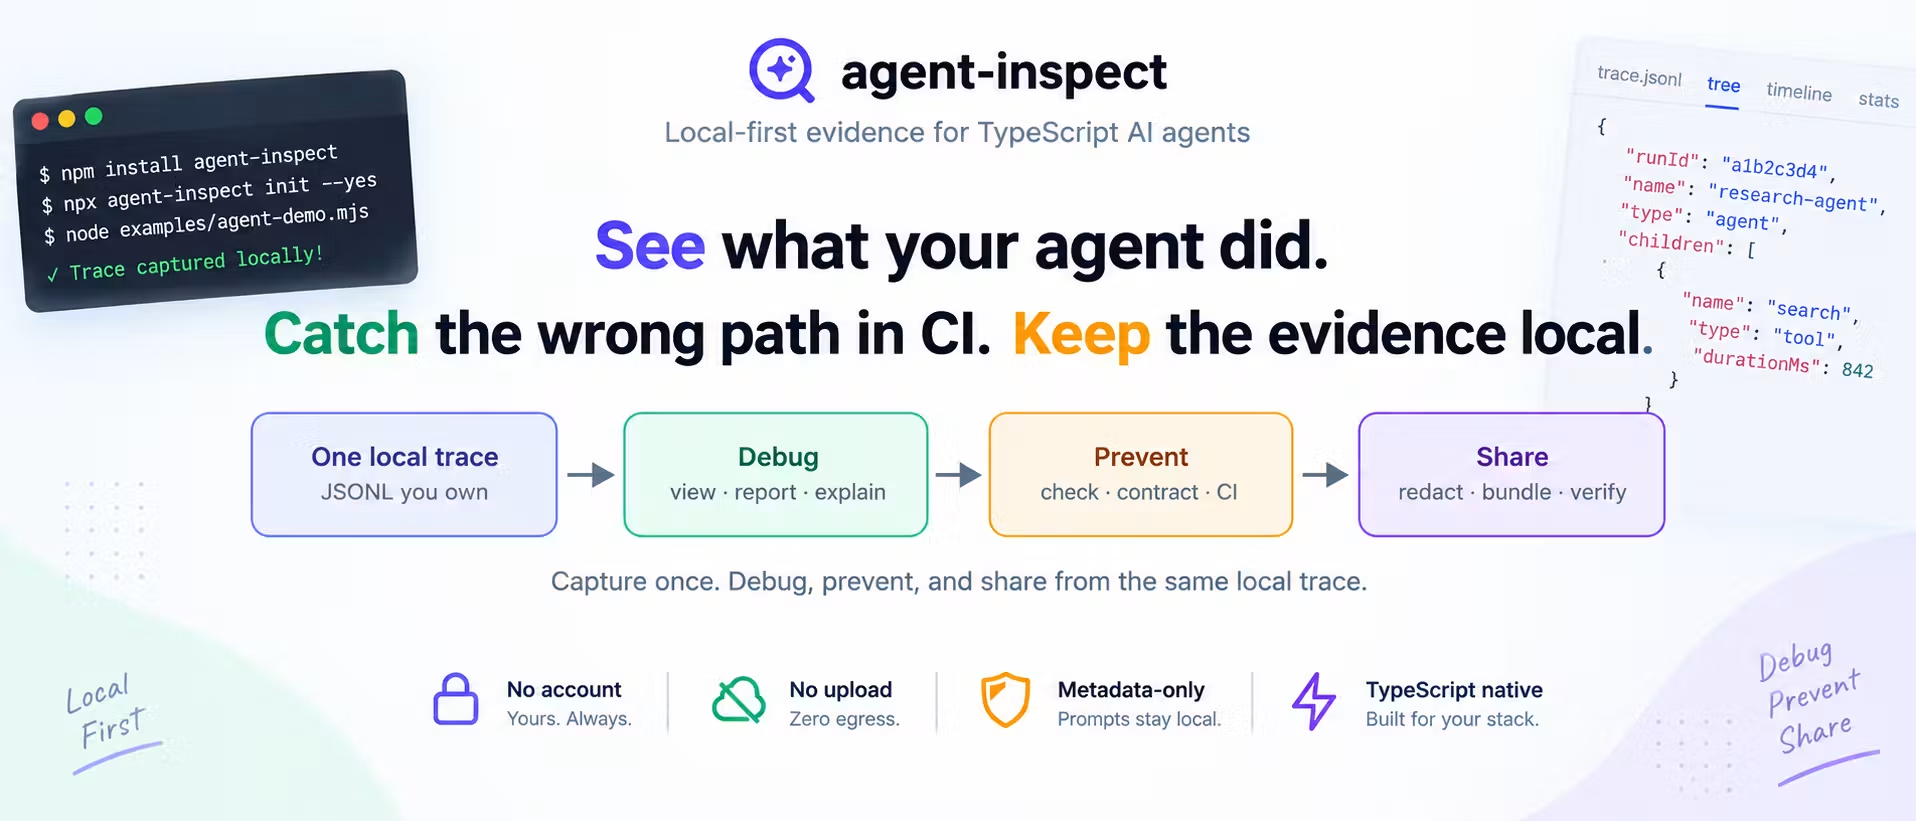
ในโลก AI agent ประโยคที่ว่า “มันผ่านบนเครื่องผม” กลายเป็น “มันผ่านบนพร็อมป์ผม” นักพัฒนารัน agent โลคัล เห็นคำตอบดูดี แล้วสรุปว่าระบบทำงานถูกต้อง แต่เมื่ออยู่ใน pull request เปลี่ยนอินพุตเล็กน้อยหรือโมเดลถูกอัปเดต ผลลัพธ์อาจต่าง ทั้งที่ข้อความยังดูน่าเชื่อถือ เอเจนต์สนับสนุนลูกค้าอาจสร้างคำตอบก่อนดึง policy เรียกเครื่องมือซ้ำ ใช้ fallback ที่ไม่อนุมัติ แต่ยังผลิตข้อความดูดีจนเทสต์แบบดู output ผ่านหมด จุดอันตรายคือทีมไม่มีหลักฐานชัดว่ามันเดินเส้นทางผิดอย่างไร ดังนั้นแต่ละการรันควรถูกยกระดับเป็น artifact วิศวกรรมที่ทำซ้ำและตรวจสอบได้ ต้องมี execution tree ที่บันทึกลำดับการเรียกเครื่องมือและสถานะให้ตรวจสอบ trajectory correctness ว่าใช้เครื่องมือถูกและครบ รวมถึง evidence correctness ว่าคนอื่นสามารถเปิดดูรันนั้นได้โดยไม่ต้องพึ่งสกรีนช็อตหรือข้อมูลดิบ เส้นทางหนึ่งจะกลายเป็น artifact ที่ส่งเข้าวงจร capture → normalize → inspect → check → redact → package → verify → แนบเข้ากับงานที่รีวิว จากนั้น CI สามารถใช้กฎเชิงดีเทอร์มินิสติกตรวจ trajectory โดยไม่ต้องเรียกโมเดลอีก การมี run ที่ทำซ้ำได้แบบนี้คือหัวใจของ reproducible AI testing และเป็นฐานให้ทีมรีวิวและ rollback พฤติกรรมได้เมื่อเกิดความผิดปกติ หนึ่งในตัวอย่างโอเพ่นซอร์สที่ใช้แนวทางนี้คือ AgentInspect ซึ่งเป็นเครื่องมือดีบักหลักฐานและเทสต์ trajectory สำหรับ TypeScript AI agents
Feature Flag และ Release Engineering สำหรับ AI: ไม่ใช่แค่เปิดปิดโค้ด
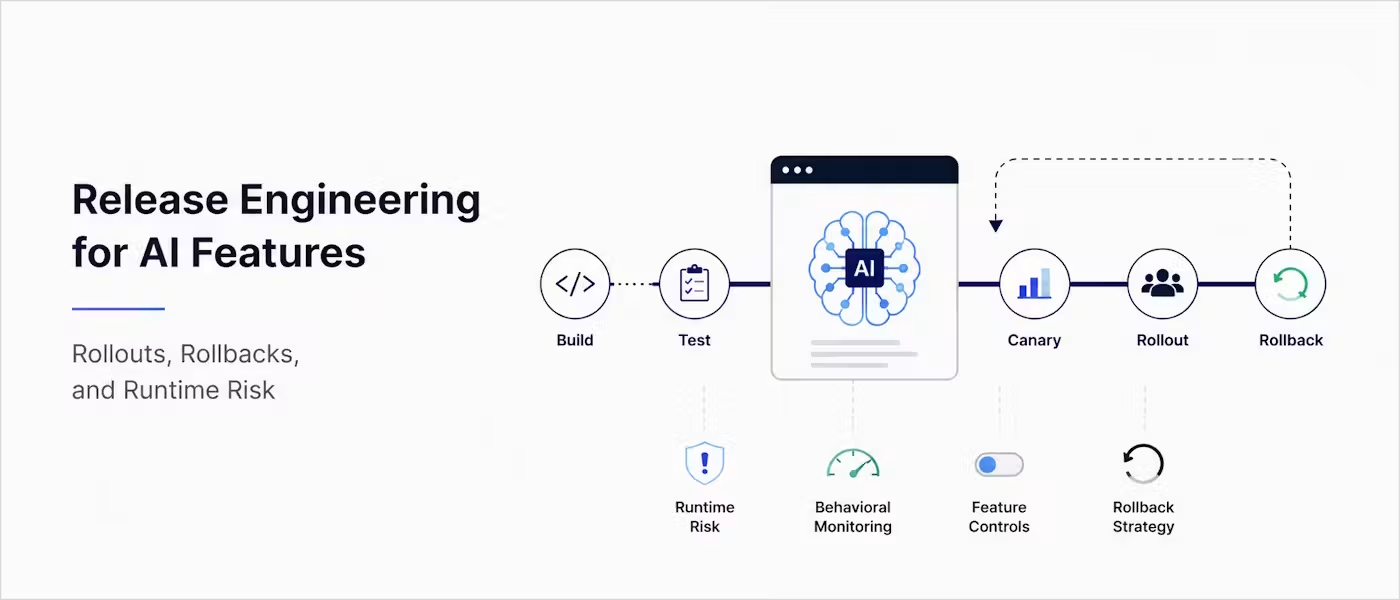
หลายทีมติดตั้ง feature flag แบบง่ายๆ เพื่อสลับฟีเจอร์โดยไม่ต้องดีพลอย เช่น if (featureFlags.newCheckout) แล้วเลือกคอมโพเนนต์ใหม่หรือเก่า เมื่อแอปโตขึ้น ธงเหล่านี้กลับควบคุมพฤติกรรมโปรดักชันจริง ตั้งแต่ flow การจ่ายเงิน การทดลองราคา onboarding การย้าย API ไปจนถึงเมคานิซึมหยุดฉุกเฉิน เมื่อถึงจุดนี้ feature flag infrastructure ไม่ใช่แค่ if-else แต่เป็นส่วนหนึ่งของระบบโปรดักชัน เปลี่ยน flag จึงมีความเสี่ยงไม่ต่างจากการเปลี่ยนโค้ด เพราะการเปิด flow จ่ายเงินที่ไม่สมบูรณ์ให้ลูกค้าทั้งหมดสร้างผลกระทบเท่ากันไม่ว่าจะมีดีพลอยหรือไม่ อีกด้านหนึ่ง AI features ทำให้สมมติฐานว่าของที่ทดสอบคือของที่ผู้ใช้จะได้ใช้เริ่มสั่นคลอน เพราะพฤติกรรมแอปเปลี่ยนได้แม้โค้ดไม่เปลี่ยน ผู้ให้บริการโมเดลอาจอัปเดตโมเดล เปลี่ยนพร็อมป์ รีเฟรช retrieval index เปลี่ยน schema ของเครื่องมือ หรือแก้กฎความปลอดภัย เส้นทางคำขอจึงเลี้ยวไปอีกทางโดยไม่มีสัญญาณดีพลอยใดๆ Release engineering สำหรับ AI จึงต้องบริหารทั้งโค้ดและพฤติกรรม ไม่ใช่แค่ commit และเวอร์ชันคอนฟิก แต่ต้องมี release manifest ที่ระบุ build ของแอป เวอร์ชันพร็อมป์ ชื่อและเวอร์ชันโมเดล snapshot ดาต้าเรียกค้น schema เครื่องมือ กฎนโยบาย ชุดการประเมิน และเส้น fallback เพื่อให้ตอบได้ว่ามีอะไรเปลี่ยน ใครอนุมัติ และทราฟฟิกไหนโดนผลกระทบ นอกจากนี้ feature flag ของ AI ต้องควบคุมมากกว่าการมองเห็น เช่นสัดส่วนทราฟฟิกที่ส่งเข้าโมเดลใหม่ เส้นทาง fallback หรือโหมดทดลอง และต้องมี kill path สำหรับ runtime risk ที่รอรอบดีพลอยไม่ได้
การสังเกตการณ์ สิทธิ์ และการเก็บกวาด: เงื่อนไขสุดท้ายก่อนปล่อย AI Agent สู่โปรดักชัน
เมื่อ AI agent เริ่มรัน unattended กับงานจริงต่อเนื่อง ทีมไม่มีสิทธิ์คิดว่าตัวเองเป็นคนเขียนโค้ดคนเดียวอีกต่อไป ระบบต้องถูกวางเพื่อรองรับการมี “ผู้ช่วยเขียนโค้ด” ที่อาจทำสิ่งไม่คาดคิดตลอดเวลา หนึ่งในแนวทางคือรัน agent แต่ละตัวแบบแยกอิสระพร้อมแบ็กอัปอัตโนมัติทุกครั้งที่ดีพลอย เพื่อจัดการ state และ recovery ให้ปลอดภัยกว่าการรีสตาร์ตเซอร์วิสธรรมดา ในภาพใหญ่ AI agent production deployment ต้องมี observability ที่ไม่ใช่แค่ล็อกข้อความ แต่รวม execution tree การตรวจ trajectory และ dashbord ที่ดูพฤติกรรมรวม เพื่อให้ทีมเห็นปัญหาที่ไม่โผล่ใน output ได้ทันเวลา ฝั่ง feature flag ความสามารถของธงเมื่อโตขึ้นจะกลายเป็นตัวแทนพฤติกรรมโปรดักชันจริง การตัดสินใจผ่านธงกำหนดว่าใครเห็นฟีเจอร์อะไร ทดสอบฟีเจอร์ใหม่อย่างไร จะ rollout เปลี่ยนทีละขั้นแบบไหน และทีมจะตอบสนองเวลามีปัญหาได้เร็วแค่ไหน ข้อเท็จจริงนี้ทำให้ Permissions และ audit history สำคัญขึ้นมาก ต้องกำหนดว่าใครเปลี่ยน flag ใครอนุมัติ และมีบันทึกชัดเจน ขณะเดียวกันทีมควรรีวิว inventory ของธงอย่างต่อเนื่องเพื่อหาธงค้างที่ไม่ใช้และลบออก การเก็บกวาดเหล่านี้ควรถูกมองเป็นส่วนหนึ่งของการ “จบฟีเจอร์” ไม่ใช่งานบำรุงรักษาที่ผลักไปเรื่อยๆ ในแง่ governance งานวิจัยหนึ่งวัดผลการย่อกฎความปลอดภัยใน 1,323 episode พบว่าการย่อกฎทำให้สัดส่วนการละเมิดเพิ่มจากศูนย์เมื่อให้ policy เต็ม ไปถึง 30% หลังย่อ และสูงสุดที่ 59% บางโมเดล แต่เมื่อข้อจำกัดสำคัญรอดไปอยู่ในสรุป อัตราละเมิดกลับเป็นศูนย์เช่นเดิม นี่คือประโยคที่น่าอ้างอิง เพราะมันเตือนให้ทีมรู้ว่าการจัดการกฎผิดวิธีอาจเพิ่มความเสี่ยงแบบทวีคูณในโปรดักชัน และย้ำว่าการออกแบบเลเยอร์กำกับให้ดีตั้งแต่ต้นสำคัญกว่าเขียนคู่มือยาวขึ้นอย่างเดียว สุดท้าย AI release engineering ไม่ใช่กระบวนการครั้งเดียวที่จบเมื่อ rollout ถึง 100% โมเดล พฤติกรรมดาต้า และนโยบายจะยังเปลี่ยนตลอดเวลา ถ้าทีมไม่มีแผนระยะยาวสำหรับ observability สิทธิ์ และการเก็บกวาด โอกาสที่ AI agent จะทำลายโปรดักชันโดยไม่มีใครเห็นไว้ก่อนก็สูงขึ้นตาม เวลาเหมาะที่สุดที่จะออกแบบ safety layer คือก่อน deployment ไม่ใช่หลังเหตุการณ์ใหญ่ครั้งแรก