
ต้นทุนที่แท้จริงของ AI coding assistant ไม่ใช่แค่ราคา token
ต้นทุน AI coding assistant คือค่าใช้จ่ายทั้งหมดที่องค์กรหรือทีมพัฒนาต้องจ่ายเพื่อให้ AI ช่วยเขียนโค้ด แก้บั๊ก และรันเวิร์กโฟลว์ให้สำเร็จ รวมทั้งค่า token ต่อคำสั่ง ค่าการลองผิดลองถูกหลายรอบ และผลกระทบจากโค้ดที่แก้ไม่จบในครั้งเดียว โดยต้องคิดจากค่าใช้จ่ายต่อการแก้ปัญหาที่ผ่านการตรวจสอบแล้ว ไม่ใช่จากราคาต่อ token บนกระดาษ เวลาทีมเทคนิคนำ AI มาเขียนโค้ดหรือดีบั๊ก หลายคนยังติดกับดักคิดแบบง่ายว่า เลือกโมเดลราคาถูกกว่าย่อมช่วยเซฟงบประมาณให้ทีม แต่ผลทดสอบจริงกับโมเดลโค้ดราคาประหยัดอย่าง Claude Haiku 4.5 เทียบกับโมเดลระดับเรือธงอย่าง Claude Sonnet 5 กลับสวนทางกับสัญชาตญาณนี้เต็มๆ Haiku มีราคา token ต่ำกว่าครึ่งทั้งฝั่งรับเข้าและฝั่งส่งออกเมื่อเทียบกับ Sonnet ตามป้ายราคาอย่างเป็นทางการ แต่เมื่อคิดค่าใช้จ่ายต่อการแก้บั๊กที่ยืนยันผลแล้ว กลับแพงกว่าตั้งแต่ 8 เท่าไปจนถึง 14 เท่าในงานดีบั๊กหลายรอบ ดังนั้นทีม dev ที่วางงบ AI ควรเลิกดูแต่ราคา token model เพราะมันซ่อนต้นทุนแฝงไว้มาก การประเมินต้องย้ายจุดโฟกัสไปที่ค่าใช้จ่ายต่อการแก้ไขสำเร็จหนึ่งครั้งและคุณภาพเอาต์พุต ไม่ใช่ตัวเลขต่อล้าน token บนหน้าเว็บ
| Spec | Claude Haiku 4.5 | Claude Sonnet 5 |
|---|---|---|
| ราคา token ตามป้าย | ถูกกว่าครึ่งทั้ง input และ output | แพงกว่าครึ่งทั้ง input และ output |
| ค่าใช้จ่ายต่อบั๊กที่แก้สำเร็จ | สูงกว่า 8.4–14.1 เท่าในงานดีบั๊กที่ทดสอบ | ต่ำกว่าอย่างมีนัยสำคัญ |
โมเดลถูกแต่ออก verbose ทำไมบิลสุดท้ายถึงบาน 14 เท่า
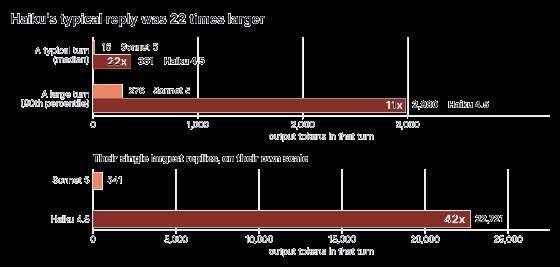
หัวใจของกับดักราคา token model คือคุณภาพและวินัยของเอาต์พุต โมเดลถูกบางตัวไม่ได้แพงขึ้นเพราะค่าบริการพื้นฐาน แต่แพงเพราะมันเขียนเยอะเกินจำเป็นและเขียนผิดจนต้องวนลูปซ้ำ ในงานดีบั๊กแบบหลายรอบทีมทดสอบใช้เอเจนต์ให้ AI ออกคำสั่งตรวจไฟล์ เขียนโค้ดใหม่ และรันเทสต์ไปเรื่อยๆ แล้ววัดความสำเร็จจากชุดเทสต์ที่ถูกซ่อนเอาไว้ไม่ให้โมเดลเห็น เพื่อให้รู้ว่ามันแก้บั๊กสำเร็จจริงหรือแค่คิดไปเอง ผลที่เห็นชัดคือ Sonnet มีจำนวน token ที่ส่งออกต่อรอบแบบกลางๆ เพียง 16 token ในขณะที่ Haiku ส่งออกกลางๆ ถึง 361 token ต่างกันถึงประมาณ 22 เท่า และในกรณีที่สุดโต่ง Sonnet เคยตอบยาวสุด 541 token แต่ Haiku เคยพ่นยาวถึง 22,721 token หรือประมาณ 42 เท่าของ Sonnet ที่แย่กว่านั้นคือเนื้อหายาวๆ เหล่านี้ส่วนใหญ่เป็นการมโนผลลัพธ์เทอร์มินัลและเขียนชุดคำสั่งกับรายงานปลอมต่อเนื่องราว 60 อย่างใส่ไว้ในคำตอบเดียว ในขณะที่ลูปเอเจนต์จะรันเฉพาะคำสั่งแรกเท่านั้น ทำให้ token ที่เหลือกลายเป็นดิจิทัลขยะราคาแพง ในโครงสร้างเอเจนต์อัตโนมัติ ความพูดมากไม่ใช่ความเก่ง มันคืองบประมาณที่หลุดมือทันที โมเดลที่ขาดวินัยการสื่อสารและชอบพูดยาวกลายเป็นหลุมดำทางการเงินสำหรับทีมพัฒนาอย่างแท้จริง
| มิติเปรียบเทียบ | ผลของ Haiku 4.5 | ผลของ Sonnet 5 |
|---|---|---|
| จำนวน token ส่งออกแบบกลางต่อรอบ | ประมาณ 361 token ต่อรอบ | ประมาณ 16 token ต่อรอบ |
| การตอบยาวที่สุดที่พบ | 22,721 token และรวมคำสั่งเกิน 60 รายการที่รันจริงเพียงรายการแรก | 541 token โดยยังคงกระชับและมีวินัยมากกว่า |
ทำไม context ยาวจากคำตอบเดียวทำให้ค่า token พองในทุกลูป
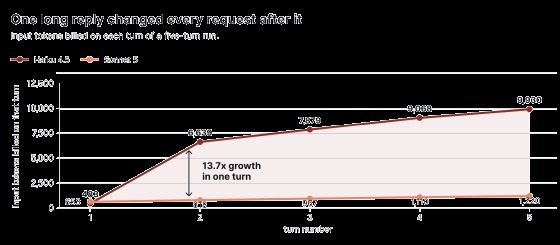
ถึงแม้คำตอบหนึ่งครั้งจะเปลือง token มากก็ยังไม่ใช่จุดจบของความสิ้นเปลือง ตัวอันตรายคือวิธีคิดค่า token ในระบบที่ต้องส่งประวัติการสนทนากลับเข้าโมเดลทุกครั้ง เมื่อคำตอบของโมเดลเต็มไปด้วยข้อความที่ไม่จำเป็น ประวัติสนทนาหรือ context window ของรอบต่อไปก็จะขยายตามไปด้วย ในงานดีบั๊กแบบเอเจนต์ที่ทดสอบนั้น เนื้อหาทุกรอบจะถูกแพ็กกลับเข้าไปเป็น input token รอบถัดไป ทำให้ token ที่ไม่มีประโยชน์ในคำตอบก่อนหน้าถูกอ่านซ้ำและถูกคิดค่าใช้จ่ายทุกครั้ง ตัวอย่างการทดลอง 5 รอบชี้ให้เห็นเอฟเฟกต์ลูกโซ่ได้ชัด รอบแรกทั้ง Haiku และ Sonnet มี input ค่อนข้างสั้น Haiku ใช้ 653 token ส่วน Sonnet ใช้ 400 token แต่หลังจาก Haiku พ่นคำตอบยาวๆ รอบที่สอง input ของมันพุ่งจาก 653 เป็น 6,638 token หรือเพิ่มกว่า 13 เท่า และเมื่อถึงรอบที่ห้า Haiku ต้องอ่าน input เกือบ 9,930 token ต่อครั้ง ในขณะที่ Sonnet ยังอยู่ราว 1,220 token เท่านั้น ความต่างนี้ไม่ใช่แค่เรื่องประสิทธิภาพเทคนิค มันคือเงินที่ทีมจ่ายเพิ่มในทุกลูปโดยไม่รู้ตัว ใครที่ประเมินต้นทุน AI coding assistant จากราคา token ต่อหน่วยแต่ไม่ดูความยาว context และจำนวนรอบเอเจนต์ กำลังเปิดประตูให้บิลพองโดยไม่มีใครรับผิดชอบ
| รอบการทำงาน | Haiku 4.5 input token | Sonnet 5 input token |
|---|---|---|
| รอบที่ 1 | ประมาณ 653 token | ประมาณ 400 token |
| รอบที่ 2 | ประมาณ 6,638 token เพิ่มขึ้นราว 13.7 เท่าจากรอบแรก | ยังอยู่ในระดับสั้นใกล้เคียงรอบแรก |
| รอบที่ 5 | ประมาณ 9,930 token ต่อครั้ง | ประมาณ 1,220 token ต่อครั้งเท่านั้น |
GitHub Copilot vs JetBrains AI เลือกจากขีดจำกัดการใช้ ไม่ใช่ราคาสมัครรายคน
เมื่อทีม dev ขยับจากการเรียก API ตรงไปใช้ AI coding assistant แบบผูกกับ IDE อย่าง GitHub Copilot หรือ JetBrains AI กับดักก็เปลี่ยนจากราคา token model ไปเป็นขีดจำกัดการใช้ต่อคนต่อเดือน ทั้งสองบริการสามารถใช้ใน IDE ตระกูล JetBrains ได้เหมือนกัน และ Copilot ยังรองรับ VS Code Visual Studio และ Neovim ทำให้หลายทีมที่ใช้หลาย IDE มองมันเป็นทางเข้าร่วมเดียวสำหรับ AI ฝั่ง JetBrains AI Pro มีการคิดค่าบริการแบบรายคนรายปีและให้เครดิต AI เป็นชุดในทุก 30 วัน ในขณะที่ Copilot Pro เป็นแบบรายเดือนต่อคนพร้อมเครดิตรายเดือนที่รวมส่วนพื้นฐานและส่วนเพิ่มที่แปรผัน โดยเครดิตของทั้งสองค่ายมีหน่วยต่างกัน JetBrains นับเครดิตเป็นหน่วยที่อิงกับมูลค่ารวมต่อดอลลาร์ ส่วน GitHub AI Credit นับเป็นเซนต์ต่อเครดิต ทำให้ตัวเลขเช่นสิบเครดิตใน JetBrains กับ 1,500 เครดิตใน Copilot ไม่สามารถเอามาเทียบกันตรงๆ แล้วสรุปว่าฝั่งไหนถูกกว่าต่องานเดียวกันได้ ที่สำคัญกว่านั้นคือฟังก์ชันไหนใช้เครดิตมาก ใช้เอเจนต์บ่อยแค่ไหน และบัญชีไหนปลดล็อกโมเดลที่ทีมต้องการ สำหรับทีมที่รันงานเอเจนต์ถี่ ขีดจำกัดเครดิตและวิธีคิดเพิ่มของแต่ละเจ้าอาจมีผลมากกว่าตัวราคาแบบรายคน การวางสัญญาโดยมองแต่ตัวเลขรวมเครดิตสูงสุดเหมือนการันตีใช้ได้ตลอดจึงเสี่ยงต่อการวางแผนงบผิด
| มิติเปรียบเทียบ | GitHub Copilot Pro | JetBrains AI Pro |
|---|---|---|
| การรองรับ IDE | ใช้ได้กับ JetBrains IDEs VS Code Visual Studio Neovim | ผูกกับบัญชี JetBrains ใช้ได้ใน IDE ที่รองรับของค่าย |
| หน่วยเครดิต | GitHub AI Credit เทียบเท่าหนึ่งเซนต์ต่อเครดิต | เครดิต AI นับมูลค่าต่อดอลลาร์ เป็นหน่วยต่างจากฝั่ง GitHub |
AI automation cost comparison ทำไมจำนวนขั้นตอนใน Make แพงกว่านับครั้งรันใน n8n
ต้นทุน AI coding assistant ไม่หยุดอยู่ที่ IDE หรือโมเดลโค้ด แต่ขยายไปถึงแพลตฟอร์ม automation ที่เชื่อม API และเอเจนต์หลายตัวเข้าด้วยกัน ถ้าทีมใช้บริการอย่าง Make หรือ n8n Cloud เพื่อสร้างเวิร์กโฟลว์ AI หลายขั้นตอน วิธีคิดหน่วยการใช้งานของแต่ละระบบจะส่งผลตรงต่อบิลรวมในแบบที่ตาเปล่ามองไม่เห็น ใน Make ส่วนใหญ่การทำงานหนึ่งครั้งของโมดูลแต่ละตัวนับเป็นหนึ่งเครดิต และมีตัวเลือกแพ็กเครดิตต่อเดือนสำหรับแผน Core ในขณะที่ n8n Cloud นับตามจำนวนการรันเวิร์กโฟลว์ตั้งแต่ต้นจนจบหนึ่งครั้ง โดยแพ็ก Starter ให้จำนวนการรันต่อเดือนตามที่กำหนดไม่ขึ้นกับจำนวนขั้นตอนในเวิร์กโฟลว์นั้น ตัวอย่างง่ายๆ แสดงภาพชัด ถ้าเวิร์กโฟลว์ถูกเรียก 1,000 ครั้งต่อเดือนและทุกขั้นตอนใน Make ใช้หนึ่งเครดิตต่อการทำงาน การไหลสองขั้นจะใช้ 2,000 เครดิต แปดขั้นจะใช้ 8,000 เครดิต และยี่สิบขั้นจะใช้ถึง 20,000 เครดิต ในฝั่ง n8n Cloud การเรียก 1,000 ครั้งต่อเดือนจะนับเป็น 1,000 การรันเท่าเดิมไม่ว่าเวิร์กโฟลว์จะมีสอง แปด หรือยี่สิบขั้น นี่ไม่ใช่ข้อสรุปว่าแพลตฟอร์มหนึ่งถูกกว่าแน่นอน เพราะยังมีค่าบริการรายเดือนต่างกันและต้องสมมติว่าทำงานเทียบเท่ากันได้ แต่เป็นสัญญาณชัดว่าจำนวนขั้นตอนและความซับซ้อนของเวิร์กโฟลว์คือปัจจัยต้นทุนที่ต้องคำนวณ ใน Make ทีมต้องคิดทั้งจำนวนโมดูล จำนวนแพ็กข้อมูล และการ retry ส่วนใน n8n ทีมต้องมองจำนวนการรัน อายุงาน และข้อจำกัดการรันพร้อมกัน
| สถานการณ์เวิร์กโฟลว์ | Make เครดิตต่อเดือน | n8n Cloud การรันต่อเดือน |
|---|---|---|
| เวิร์กโฟลว์ 2 ขั้น ถูกเรียก 1,000 ครั้ง | 2,000 เครดิตจากการทำงานโมดูลสองขั้นต่อการเรียก | 1,000 การรันเวิร์กโฟลว์ |
| เวิร์กโฟลว์ 8 ขั้น ถูกเรียก 1,000 ครั้ง | 8,000 เครดิตจากโมดูลแปดขั้น | 1,000 การรันเวิร์กโฟลว์เท่าเดิม |
| เวิร์กโฟลว์ 20 ขั้น ถูกเรียก 1,000 ครั้ง | 20,000 เครดิตจากโมดูลยี่สิบขั้น | 1,000 การรันเวิร์กโฟลว์เท่าเดิม |