
ชิปเฉพาะทางสะท้อนโจทย์ AI ที่เปลี่ยนไป
ชิป TPU คือหน่วยประมวลผลเฉพาะทางของ Google ที่ออกแบบมาเพื่อเร่งงานปัญญาประดิษฐ์ ตั้งแต่การฝึกโมเดลไปจนถึงการให้บริการคำตอบ โดยชิปแต่ละแบบปรับแต่งให้เหมาะกับภาระงานและข้อจำกัดของระบบที่ต่างกัน
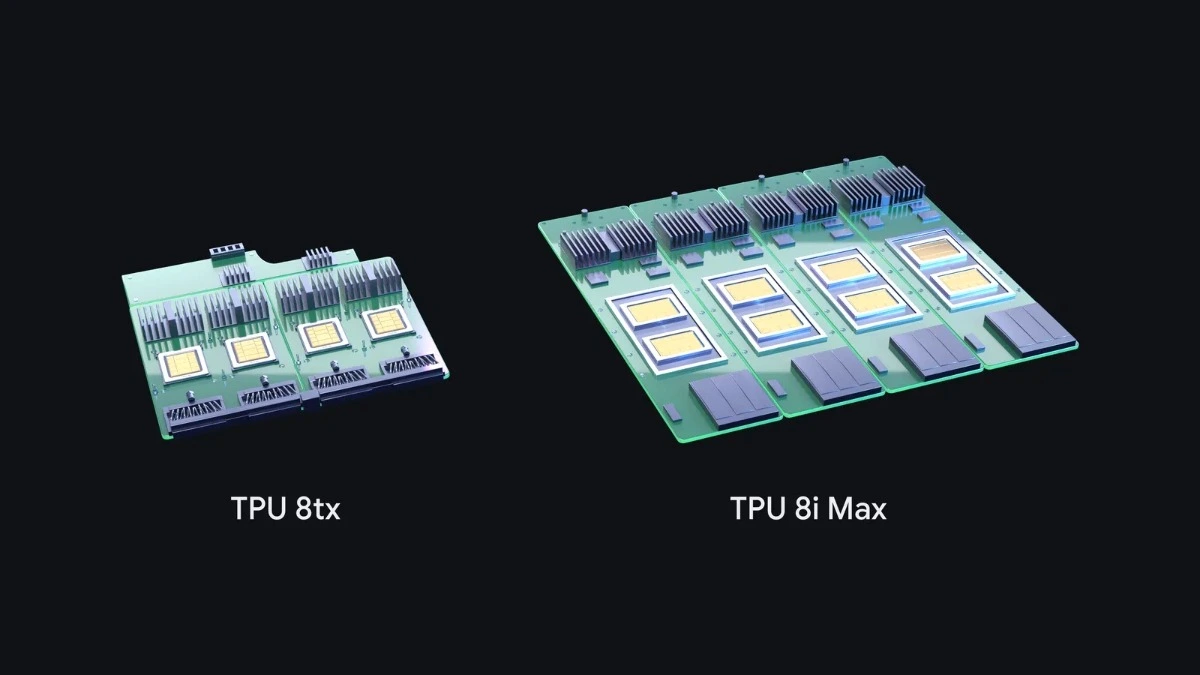
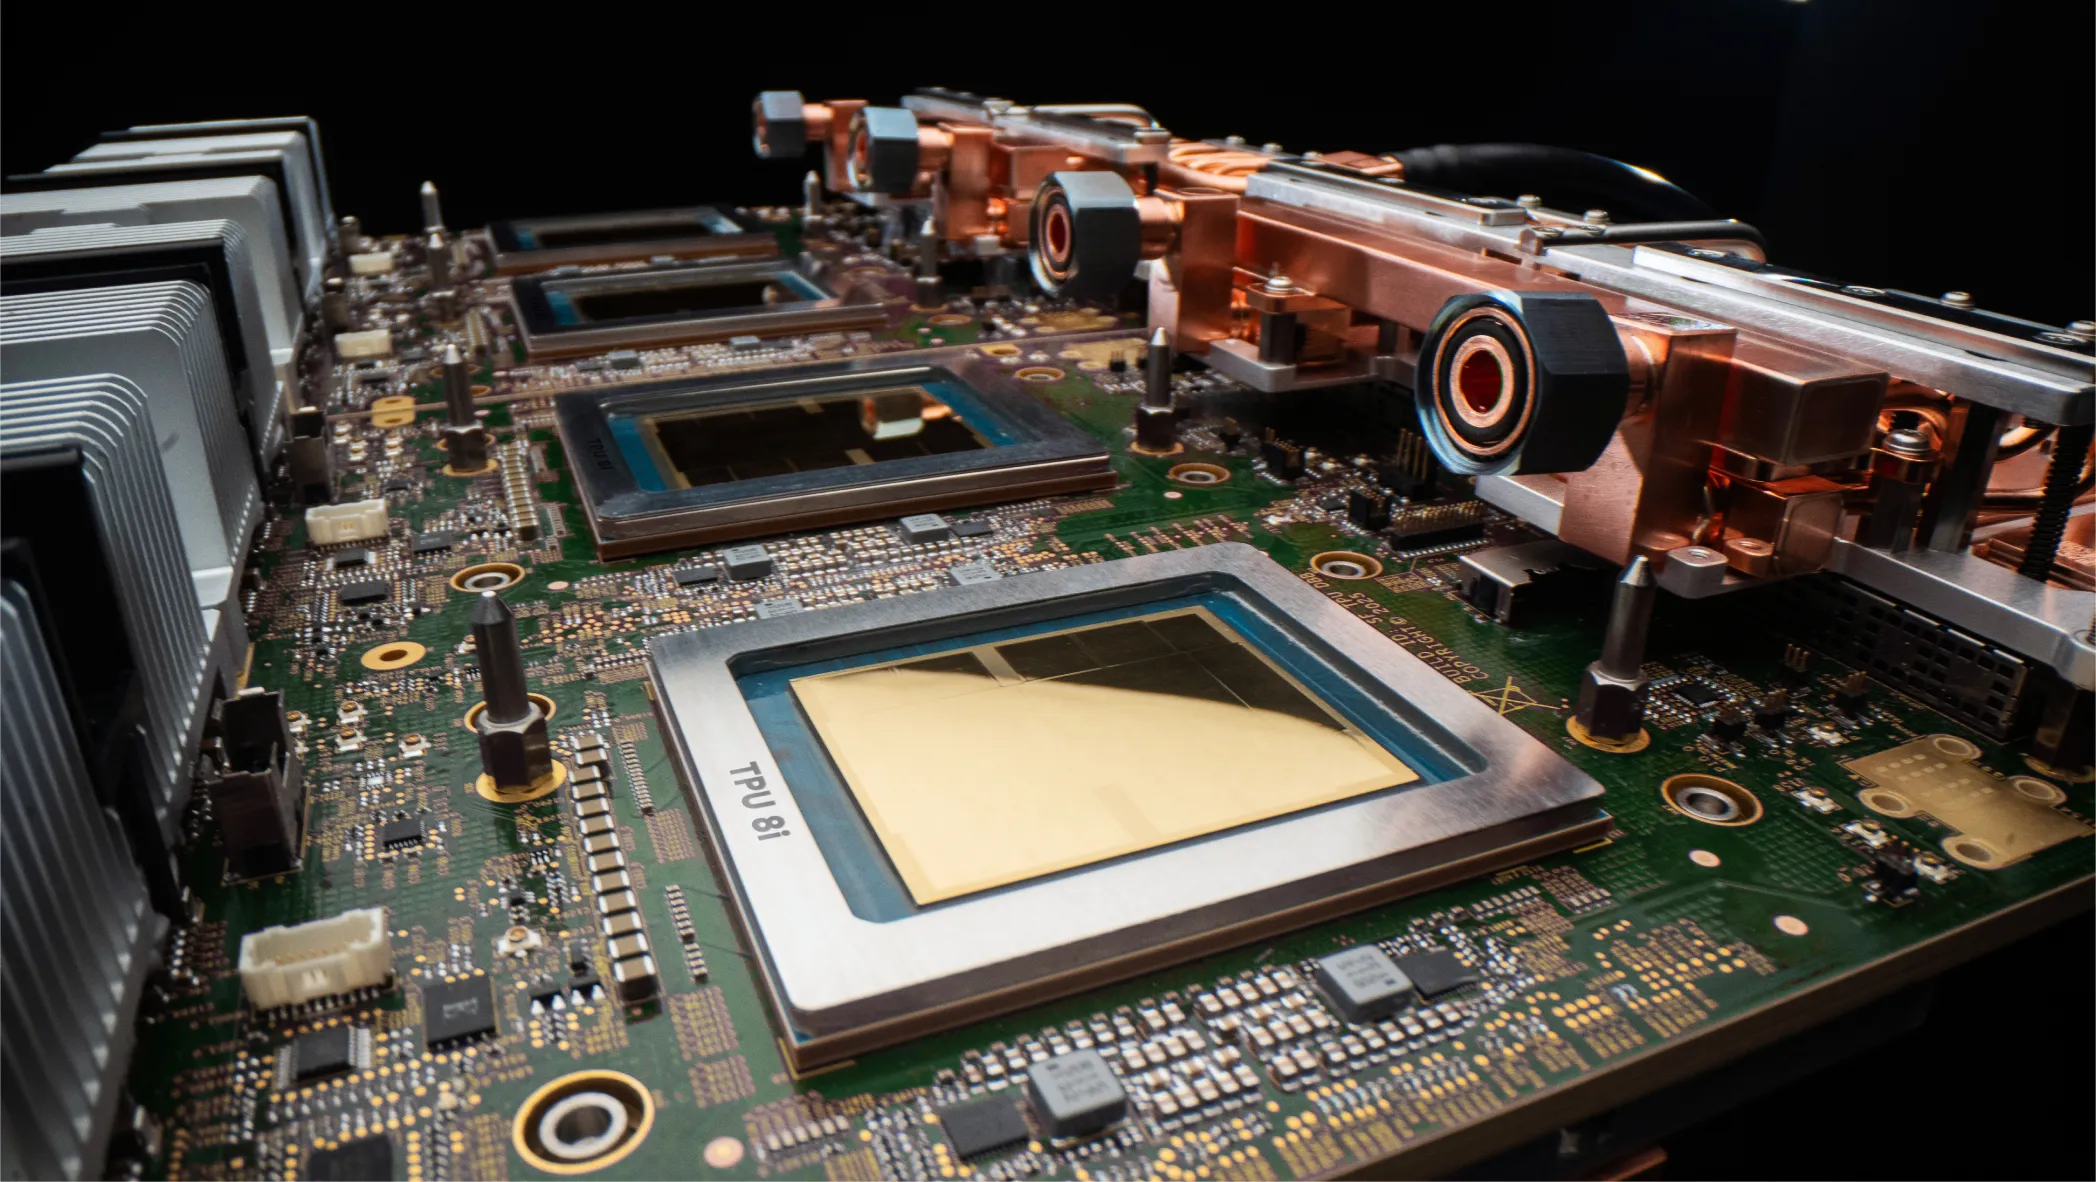
Google เปิดตัว Google TPU 8tx และ TPU 8i Max เป็นชิป Tensor Processing Unit เจเนอเรชันที่ 8 เพื่อขยายความสามารถด้าน AI สำหรับคลาวด์และองค์กร โดยระบุว่าจะเปิดให้ใช้งานในปีหน้า การเปิดตัวนี้ไม่ใช่แค่การเพิ่มรุ่นสินค้า แต่เป็นสัญญาณว่าโครงสร้างพื้นฐาน AI กำลังแยกตัวตามงานจริงมากขึ้น ทั้งการคุ้มครองข้อมูลระหว่างประมวลผลและการรองรับบริบทขนาดใหญ่
เหตุผลที่ตัวเร่งประมวลผลเฉพาะทางสำคัญ คือเวิร์กโหลด AI ไม่ได้มีรูปแบบเดียว การฝึกโมเดลต้องการกำลังคำนวณสูง ส่วนการให้เหตุผลและการทำงานของ Agent ต้องตอบสนองต่อเนื่องและเข้าถึงข้อมูลได้รวดเร็ว การจับคู่ชิปกับงานจึงอาจช่วยให้ใช้ทรัพยากรได้เหมาะกว่าการพึ่งหน่วยประมวลผลทั่วไปเพียงอย่างเดียว
พื้นฐานของเจเนอเรชันนี้ก็มีตัวเลขที่ชวนจับตา โดย TPU 8t และ TPU 8i มีประสิทธิภาพการฝึกโมเดลสูงขึ้นถึง 2.7 เท่า และความคุ้มค่าต่อราคาในการประมวลผลดีขึ้น 80% เมื่อเทียบกับ TPU รุ่นก่อนหน้า
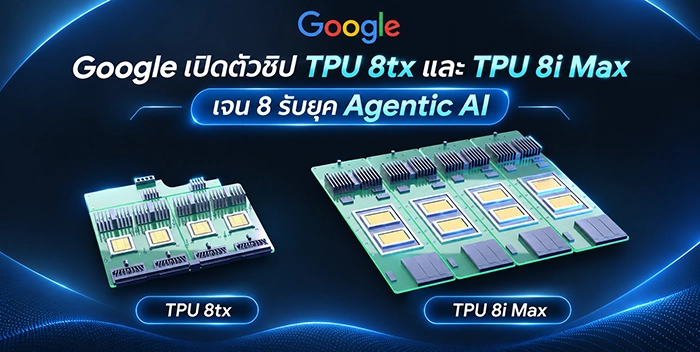
8tx เน้นข้อมูลลับ ส่วน 8i Max เน้นบริบทขนาดใหญ่
Google TPU 8tx วางตำแหน่งสำหรับหน่วยงานรัฐและธุรกิจที่มีกฎกำกับเข้มงวด ซึ่งต้องใช้โมเดลหรือ Agent กับข้อมูลที่ต้องคุ้มครองเป็นพิเศษ จุดสำคัญคือการรักษาความปลอดภัยระดับฮาร์ดแวร์ระหว่างข้อมูลกำลังถูกประมวลผล ไม่ใช่เพียงเข้ารหัสขณะจัดเก็บหรือส่งผ่านเครือข่าย รุ่นนี้ทำงานร่วมกับหน่วยประมวลผลกลางจาก AMD และต่อยอดสถาปัตยกรรมของ TPU 8t
อีกด้านหนึ่ง TPU 8i Max มุ่งแก้คอขวดด้านหน่วยความจำเมื่อ AI ต้องอ่านข้อมูลยาวหรือทำงานหลายอย่างพร้อมกัน ทั้งการเขียนโค้ด การค้นคว้ายา และงานคณิตศาสตร์ Google ระบุว่าประสิทธิภาพการประมวลผล หน่วยความจำ SRAM และแบนด์วิดท์ HBM เพิ่มขึ้นเป็น 2 เท่าเมื่อเทียบกับ TPU 8i อีกทั้งรองรับการติดตั้งชิปได้มากขึ้น 2 เท่าภายในพื้นที่แร็กขนาดเดิม
ความต่างนี้ชัดเจนและมีเหตุผล: 8tx ซื้อความมั่นใจให้เวิร์กโหลดข้อมูลละเอียดอ่อน ส่วน 8i Max เพิ่มพื้นที่ให้โมเดลจัดการบริบทกว้างโดยไม่สะดุดง่าย ทั้งสองรุ่นจึงไม่ได้แย่งงานกันตรง ๆ แต่ตอบโจทย์คนละคอขวดของระบบ AI
เดิมพันไม่ได้อยู่ที่ชิปอย่างเดียว
ตัวเร่งประมวลผลจะมีความหมายก็ต่อเมื่อทำงานร่วมกับระบบซอฟต์แวร์ เครือข่าย และหน่วยความจำได้ลงตัว การออกแบบชิปให้เหมาะกับงานฝึก งานอนุมาน และงานที่ต้องรักษาความลับ ช่วยให้องค์กรปรับระบบตามลักษณะข้อมูลและความต้องการของบริการได้ แทนที่จะต้องยอมรับข้อจำกัดจากชิปแบบเดียว
แนวโน้มนี้เกิดขึ้นพร้อมกับการที่องค์กรเริ่มนำ Agent อัตโนมัติมาใช้จริง และผู้ให้บริการคลาวด์กับผู้ผลิตชิปต่างลงทุนในตัวเร่ง AI นอกเหนือจากตัวเลือกของ Nvidia การแข่งขันจึงไม่ได้วัดกันแค่ความเร็วสูงสุด แต่รวมถึงความหน่วง ความจุหน่วยความจำ ความปลอดภัย และความสะดวกในการนำไปใช้งาน
ผลต่อผู้ใช้ทั่วไปอาจไม่เห็นเป็นชื่อชิปโดยตรง แต่ TPU เป็นส่วนหนึ่งของการฝึกและให้บริการ Gemini รวมถึงงาน Agent และบริการ Google Cloud หากระบบรองรับบริบทที่ยาวขึ้นหรือประมวลผลได้คล่องขึ้น ก็อาจเปิดทางให้บริการจัดการเอกสาร โค้ด หรือข้อมูลซับซ้อนได้ดีขึ้น อย่างไรก็ตาม ประโยชน์ปลายทางยังขึ้นกับซอฟต์แวร์และการนำไปใช้งานจริง
บทสรุป: ออกแบบโครงสร้างพื้นฐานตามภาระงาน
การเปิดตัว TPU 8tx และ TPU 8i Max แสดงให้เห็นว่า Google กำลังขยายชิป AI คลาวด์จากแนวคิดกำลังประมวลผลอย่างเดียว ไปสู่ระบบที่จัดการข้อมูลลับและบริบทขนาดใหญ่ได้โดยเฉพาะ รุ่น 8tx ตอบโจทย์ความปลอดภัย ส่วน 8i Max มุ่งเพิ่มกำลังและแบนด์วิดท์หน่วยความจำ
ทิศทางนี้น่าเชื่อถือกว่าการไล่เพิ่มตัวเลขสมรรถนะเพียงด้านเดียว เพราะงาน AI ในองค์กรมีเงื่อนไขจริงทั้งข้อมูล กฎระเบียบ และความหน่วง แต่การประกาศยังไม่ใช่หลักฐานว่าลูกค้าจะได้ผลลัพธ์ตามที่คาด ต้องรอดูการเปิดใช้งานในปีหน้าและประสิทธิภาพเมื่ออยู่ในงานจริง
ท้ายที่สุด ชิป TPU รุ่นใหม่ทั้งสองไม่ได้ทำให้ทุกงาน AI เร็วขึ้นแบบเหมารวม แต่ชี้ว่าการแข่งขันกำลังมุ่งสร้างโครงสร้างพื้นฐานที่เลือกเครื่องมือให้ตรงกับภาระงาน หาก Google ทำให้ฮาร์ดแวร์ ซอฟต์แวร์ และการเข้าถึงใช้งานร่วมกันได้ดี ก็มีโอกาสขยายบทบาทในตลาดคลาวด์ AI ได้มากขึ้น