
คอนเท็กซ์คือหัวใจของความแม่นยำ ไม่ใช่ความเร็ว
AI context คือชุดข้อมูล ความสัมพันธ์ และกติกาการทำงานที่บอกให้โมเดลเข้าใจว่าอะไรสำคัญในสถานการณ์หนึ่งๆ ตามวิธีทำงานขององค์กร เพื่อให้มันตัดสินใจได้ถูกเรื่อง ถูกเวลา และถูกคน แทนที่จะตอบจากความรู้ทั่วไปแบบลอยๆ โดยไม่รู้รายละเอียดธุรกิจของเราเอง Context คือข้อมูลที่ AI ต้องใช้เพื่อเข้าใจว่าอะไรสำคัญในช่วงเวลาหนึ่งตามวิธีทำงานขององค์กร ไม่ใช่แค่ดึงข้อมูลดิบมารวมกัน แต่ต้องเชื่อมโยงให้ระบบเดินจากจุด A ไปจุด B ข้ามเครื่องมือและหัวข้อได้อย่างตรงคำถามและไม่เปลืองรอบประมวลผล
มุมที่หลายทีมมองพลาดคือรีบไล่ความเร็ว เช่น ตอบแชตไว สรุปเอกสารทันที แต่ไม่ถามเลยว่าระบบคิดจากคอนเท็กซ์อะไร ถ้าคอนเท็กซ์ผิด ความเร็วจะกลายเป็นเครื่องเร่งความผิดพลาดแทน แถมยังขยายไปทั้งองค์กรด้วย สิ่งที่คงที่และเป็นแต้มต่อจริงของกลยุทธ์ AI ไม่ใช่ตัวโมเดล แต่คือคอนเท็กซ์ขององค์กรที่สะสมมานานและโตขึ้นทุกวัน ถ้าเราไม่ทำให้คอนเท็กซ์นี้อ่านออกและใช้ได้โดย AI ผลลัพธ์ที่ได้จะเร็วแต่ใช้การไม่ได้

เมื่อคอนเท็กซ์แชร์ได้ ความสม่ำเสมอก็มาพร้อมรัศมีความพัง
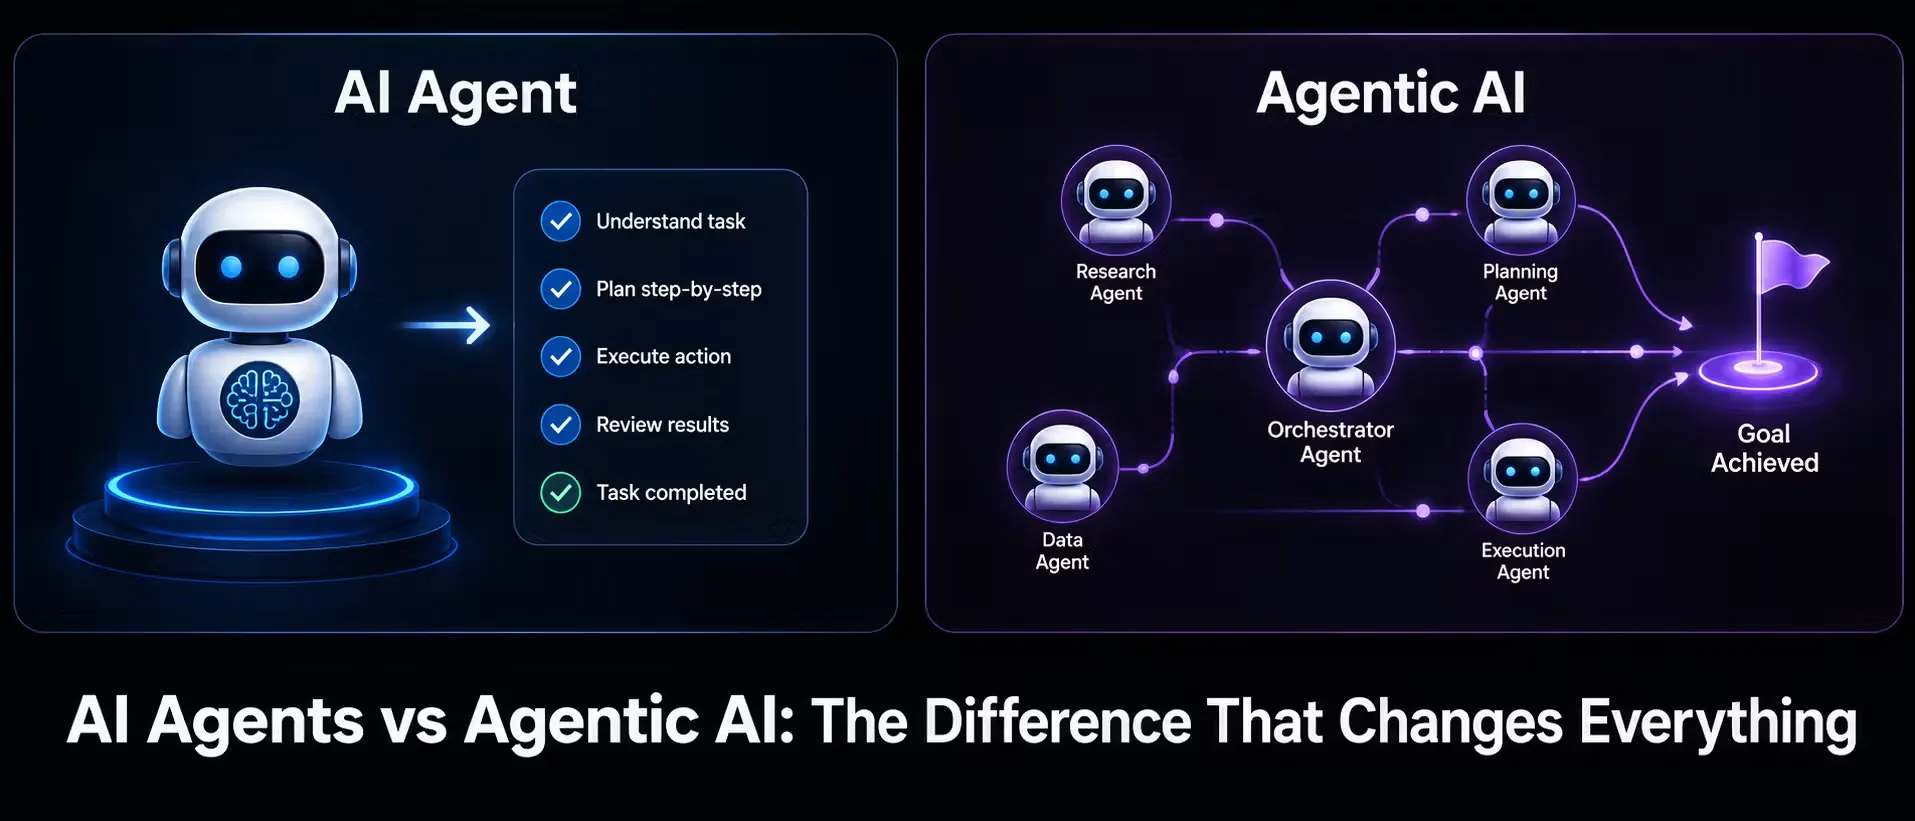
หลายแพลตฟอร์มผลักดันแนวคิด shared context เพราะมันช่วยให้ AI เข้าใจธุรกิจ ทีม และลูกค้าแบบเดียวกันทั้งระบบ ตัวอย่างเช่นการมี Growth Context ที่รวมภาพรวมของธุรกิจ ทีม และลูกค้า แล้วกระจายเข้าไปใน AI ทุกตัว ทำให้ไม่ต้องมานั่งป้อนข้อมูลพื้นฐานซ้ำไปซ้ำมาทุกครั้งที่เปิดผู้ช่วยใหม่ หรือสร้าง agent ใหม่ Context Home ยังทำให้ความรู้ฐานถูกแชร์เข้าถึงได้ทั่วเครื่องมือ AI ส่วนโปรเจ็กต์ก็สามารถแนบคำสั่ง ไฟล์ เนื้อหาในระบบ แหล่งความรู้ และแอปที่เชื่อมต่อเพิ่มเติมได้ ขณะที่ agent ใช้ข้อมูล CRM และเครื่องมือที่ได้รับอนุญาตเพื่อทำงานให้จบหนึ่งภารกิจ
แต่ข้อดีด้านความสม่ำเสมอนี้มีด้านมืดที่อันตรายกว่าที่คิด คือ blast radius เมื่อคอนเท็กซ์ถูกแชร์กว้าง คำสั่งผิดหนึ่งบรรทัด ไฟล์ที่ครอบคลุมเกินไป แนวทางตกยุค หรือความทรงจำที่ไม่เหมาะสม สามารถปนเปื้อนผลลัพธ์ได้จำนวนมากในครั้งเดียว ปัญหาจึงไม่ใช่ว่า AI ขาดคอนเท็กซ์ แต่คือมันมีคอนเท็กซ์มากเกินไปโดยไม่มีขอบเขตชัดเจน ถ้าองค์กรไม่ออกแบบขอบเขตคอนเท็กซ์ให้ดี productivity ที่เพิ่มขึ้นจะแลกด้วยความเสี่ยงเชิงชื่อเสียงและการตัดสินใจผิดแบบเป็นวงกว้าง
Least-Context Architecture: ให้เท่าที่จำเป็นต่อภารกิจเดียว
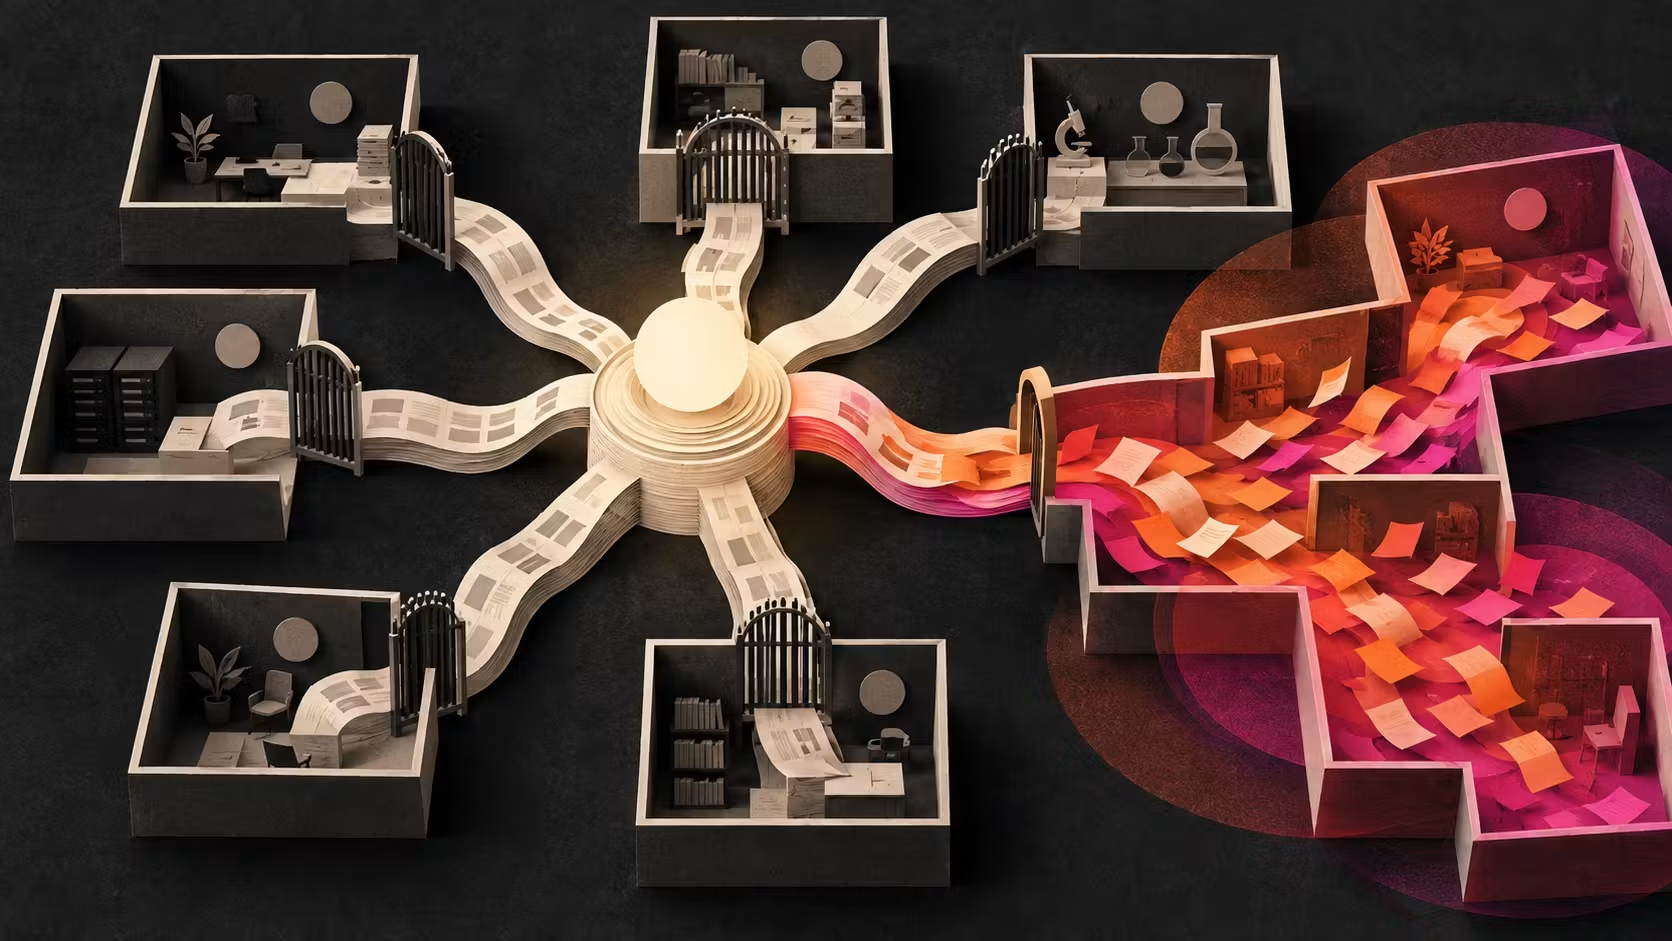
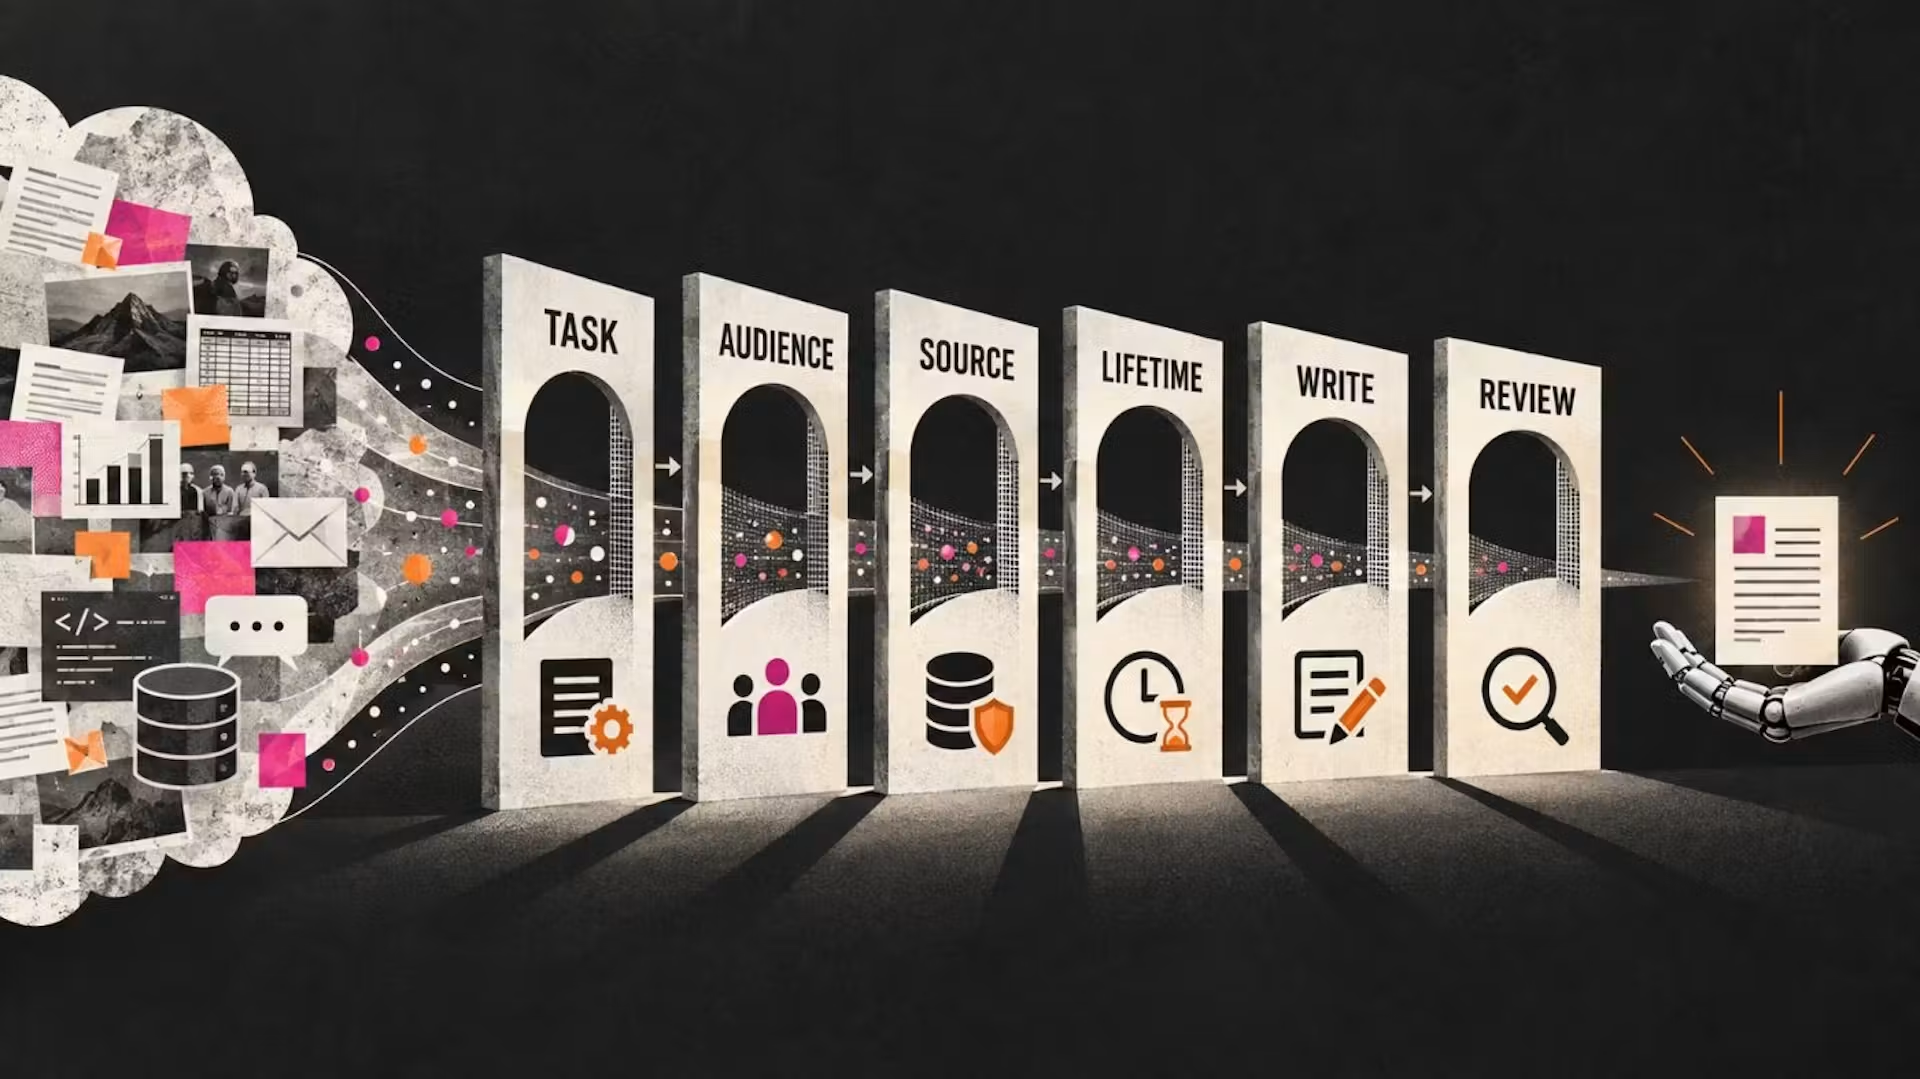
ทางออกหนึ่งคือแนวคิด Least-Context Architecture ที่เสนอให้ AI แต่ละงานเข้าถึงเฉพาะชุดความรู้ที่จำกัดที่สุด เท่าที่จำเป็นและได้รับอนุญาต เพื่อสร้างผลลัพธ์ที่มีประโยชน์ แนวคิดนี้ต่างจากการให้สิทธิ์กว้างแบบเดิมที่โฟกัสแค่ว่าอ่านข้อมูลได้หรือไม่ เพราะในโลกของ enterprise AI control แค่มีสิทธิ์อ่านยังไม่พอ ต้องถามต่อว่าข้อมูลนั้นควรมีอิทธิพลต่อการตัดสินใจครั้งนี้หรือไม่ สิทธิ์คือการควบคุมการเข้าถึง ส่วนคอนเท็กซ์คือการควบคุมอิทธิพล และการกำกับดูแลข้อมูลขององค์กรยุคใหม่ต้องมีทั้งสองด้าน
โมเดลการออกแบบนี้ใช้เกต 6 ชั้น ได้แก่ task, audience, source, lifetime, write และ review เพื่อลดก้อนคอนเท็กซ์ขนาดใหญ่ลงเหลือการกระทำของ AI ที่ถูกล้อมกรอบชัดเจน แต่ละเกตคือ productivity guardrails เช่น เกต audience ระบุว่าใครจะได้รับหรือพึ่งพาผลลัพธ์ ทำให้เราแยกได้ว่าอะไรเป็นดราฟต์ภายใน อะไรคือเมลถึงลูกค้า หรือข้อมูลที่จะเขียนกลับเข้า CRM ซึ่งมีต้นทุนความผิดพลาดต่างกัน เกต review ก็กำหนดความลึกของการตรวจ เช่น สรุปภายในอาจใช้การตรวจแบบสุ่ม แต่ข้อความถึงภายนอกหรือการเปลี่ยนแปลงสิทธิ์ต้องมีการยืนยันที่เข้มกว่า
AI context management ต่างจากแค่ต่อระบบ และเกี่ยวอะไรกับผู้ใช้
หลายทีมสับสนระหว่างการเชื่อมระบบกับการจัดการคอนเท็กซ์ มาตรฐานอย่าง Model Context Protocol ช่วยให้ agent ต่อกับระบบหลายตัวได้ง่ายขึ้น แต่คอนเท็กซ์ยังคงกระจัดกระจาย และ agent ต้องเสียรอบและโทเคนเพื่อเย็บข้อมูลกลับเข้าหากันทุกครั้งที่รัน ฝั่ง context engineering จึงโฟกัสอีกขั้น คือช่วยคิดว่าโมเดลต้องใช้อะไรบ้างจึงจะทำงานได้ดี เช่น ควรดึงข้อมูลชุดไหนผ่านกราฟความรู้ จะเก็บประวัติการสนทนาแค่ไหน จะต่อเครื่องมือใดผ่านโปรโตคอล และจะจัดลำดับเอกสารอย่างไรให้โมเดลใช้ข้อมูลที่เกี่ยวข้องที่สุด
ในสายตาผู้ใช้ สิ่งนี้แปลเป็นประสบการณ์ตรงมาก เช่น agent ที่ไม่มีคอนเท็กซ์ไม่รู้เลยว่าองค์กรคุณมีโปรเจกต์ชื่อ Project Titan สามโครงการ แต่คุณสนใจแค่โปรเจกต์ของทีมตัวเอง หรือไม่รู้ว่าการประชุมเมื่อวานได้กลับคำตัดสินที่บันทึกไว้ในเพจสัปดาห์ก่อนแล้ว ผลคือ AI ทำงานรวดเร็วแต่ผิดโจทย์ ไม่ได้ช่วยให้ทีมจบงาน การทำให้คอนเท็กซ์อ่านออกโดย AI จึงกลายเป็นโอกาสใหญ่ที่สุดในการเพิ่มทั้งประสิทธิภาพและคุณภาพของคำตอบ
วาง AI decision boundaries จากต้นทุนความผิด ไม่ใช่จากความเทพของโมเดล
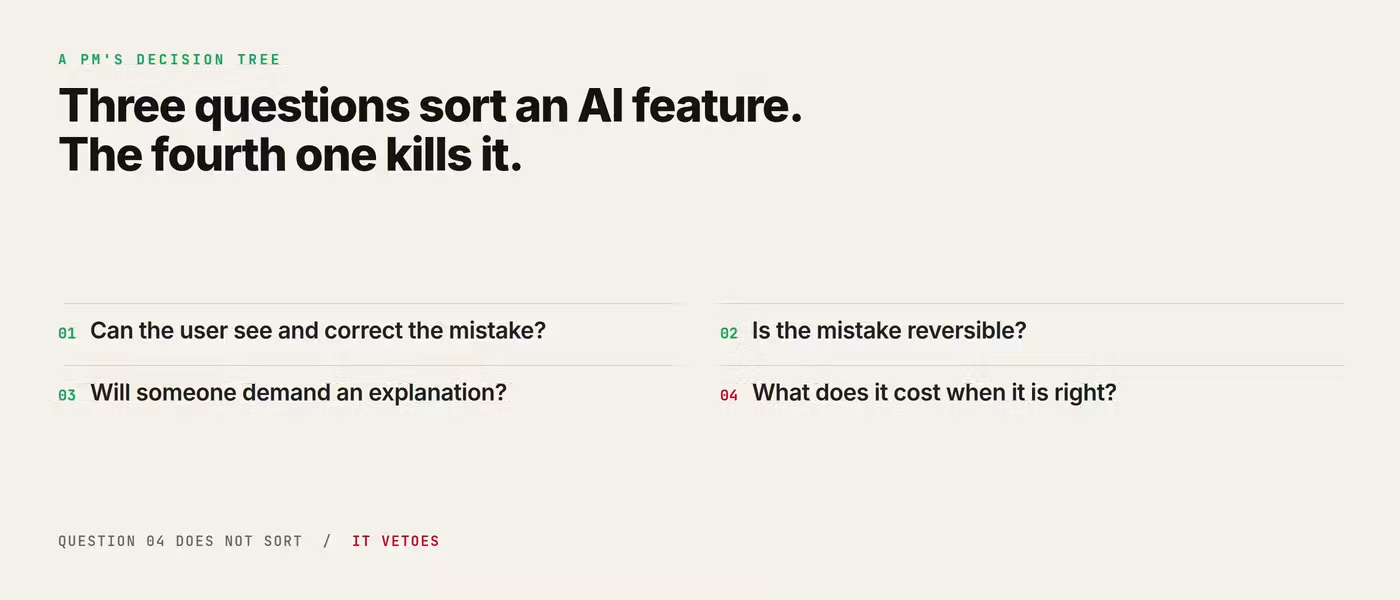
ภายใต้แรงกดดันให้เพิ่มฟีเจอร์ AI หลายทีมถามแต่ว่าโมเดลทำได้ไหม ซึ่งคำตอบเกือบทุกกรณีคือ “ทำได้” เพราะ AI เขียนเมล จัดหมวดหมู่ ตัดเกรดลูกค้า หรืออนุมัติคำขอได้อยู่แล้ว แต่คำถามนี้ไม่ช่วยตัดสินอะไรเลย สิ่งที่ควรถามคือ เมื่อโมเดลผิด ใครเป็นคนรับต้นทุน และต้นทุนนั้นสูงแค่ไหน การอัตโนมัติเปลี่ยนไม่ใช่อัตราผิด แต่มันเปลี่ยน “รูปทรงของความผิดพลาด” เพราะมนุษย์อาจผิดทีละเคส ในทิศทางกระจัดกระจาย แต่โมเดลที่ตั้งค่าไม่ดีอาจผิดหมื่นเคสในทิศทางเดียวก่อนพักกลางวันโดยไม่มีใครตอบว่าเกิดอะไรขึ้น
นี่คือแกนของ AI decision boundaries ในมุมผลิตภัณฑ์ ฟีเจอร์ที่ให้ผู้ใช้เห็นและแก้ไขความผิดได้ย่อมมีความเสี่ยงต่ำกว่าสิ่งที่ไปเปลี่ยนข้อมูลหรือสิทธิ์ในระบบทันที การออกแบบขอบเขตจึงต้องผูกกับ data governance AI ตั้งแต่แรก ทั้งสิทธิ์เข้าถึงและระดับคอนเท็กซ์ รวมถึงขั้นตอนตรวจทานที่เหมาะกับผลกระทบ บรรทัดฐานไม่ควรคือ “AI ทำได้ไหม” แต่คือ “เรายอมให้มันผิดแบบนี้ได้หรือไม่ และมีรั้วกันผิดอะไรบ้าง” ในโลกที่ผู้บริหารกำลังพยายามพิสูจน์ผลตอบแทนของ AI การเพิ่มประสิทธิภาพและคุณภาพผ่านคอนเท็กซ์คือโอกาสใหญ่ที่สุดในการเปลี่ยน AI จากของเล่นเป็นโครงสร้างพื้นฐานการทำงาน