
นิยามปัญหาใหม่ให้ชัด: AI agent ไม่ลืม แต่สถานะหาย
ปัญหาหลักของ AI agent สถานะคือการที่ระบบไม่สามารถรักษาและอัปเดตข้อมูลที่เป็นความจริงล่าสุดของโลกงานที่กำลังจัดการ ทำให้การตัดสินใจต่อเนื่องผิดไปแม้โมเดลจะจำบทสนทนาและข้อมูลเดิมได้ครบ แต่สถานะที่สะท้อนความจริง เช่น ขั้นตอน workflow ปัจจุบัน ผลการทำรายการ หรือข้อจำกัดที่ยังมีผล กลับถูกบีบอัดหรือทิ้งหายระหว่างทาง การออกแบบ context management ระบบที่เน้นสถานะที่ถูกต้องจึงสำคัญกว่าการเพิ่มขนาดความจำหรือโหลดประวัติย้อนหลัง
ทุกครั้งที่เราเห็น AI agent ทำตัวเหมือนความจำสั้น ถามข้อมูลซ้ำ ทำผิดเงื่อนไข หรือไม่ทำตามข้อตกลงเดิม สัญชาตญาณทีมมักคือเพิ่ม memory ใส่ vector database ขยาย context window หรือสรุปบทสนทนาเพิ่ม วิธีคิดนี้ใช้ได้กับ agent แบบแชตที่ตอบข้อความ แต่เริ่มพังทันทีเมื่อ agent เริ่มทำงานจริง เช่นจัดการ refund สร้าง ticket หรือไปยุ่งกับระบบธุรกิจอื่นๆ เพราะข้อมูลที่เก็บแบบ “ความจำ” ไม่ตอบคำถามสำคัญที่สุดว่า ณ ตอนนี้อะไรคือความจริง ระบบไหนเป็นเจ้าของสถานะ และเวอร์ชันไหนที่ยังใช้ได้อยู่ นี่คือปัญหา state management ไม่ใช่ปัญหาขีดจำกัดความจำ

จากแชตบอตสู่ distributed systems: ทำไมสถานะกลายเป็นเรื่องใหญ่
ทันทีที่ AI agent เริ่มเรียก API จัดการฐานข้อมูล รออีเวนต์ และเปลี่ยนแปลงโลกจริง ปัญหาวิศวกรรมกลายร่างเป็นปัญหาระบบกระจายตัว distributed systems AI เต็มรูปแบบ ต่อให้หน้าตายังเหมือนแชต แต่เบื้องหลังไม่ได้แค่สร้างข้อความตอบผู้ใช้ ระบบกำลังประสานการเปลี่ยนสถานะข้ามหลายบริการ ต้องรับมือฐานข้อมูล การยืนยันตัวตน network ล้ม การ retry ข้อมูลค้าง workflow ยาวเป็นชั่วโมง สิทธิ์การเข้าถึง และการกู้คืน ปัญหาเหล่านี้ไม่ได้หายไปเพราะใช้ LLM ตัดสินใจ ตรงกันข้ามยิ่งโมเดลทำงานได้กว้างขึ้น ผลพลาดก็ยิ่งกระจายเสียหายหลายระบบ
สถาปัตยกรรมที่ใช้งานได้จริงจึงไม่ใช่เอาโมเดลไปนั่งบนทุกระบบธุรกิจโดยตรง แต่ต้องมีขอบเขตชัดเจนระหว่างส่วนที่ใช้เหตุผลกับส่วนที่ลงมือทำ รูปแบบที่มีประโยชน์คือทำให้โมเดลเหมือนกระบวนการไร้สถานะ ในขณะที่ runtime รอบตัวเป็นคนจัดการ stateful ทั้ง session สถานะการรัน การบันทึกข้อมูล การเรียกเครื่องมือ และการกู้คืน โมเดลทำหน้าที่คิด ส่วน runtime รับบทดูแลความต่อเนื่องและความน่าเชื่อถือ นี่ไม่ใช่เรื่อง prompt engineering แต่มันคือปัญหาระบบกระจายตัวเต็มๆ
เมื่อ compaction ทำข้อมูลสำคัญหล่น: อย่าโทษโมเดลก่อนดู context
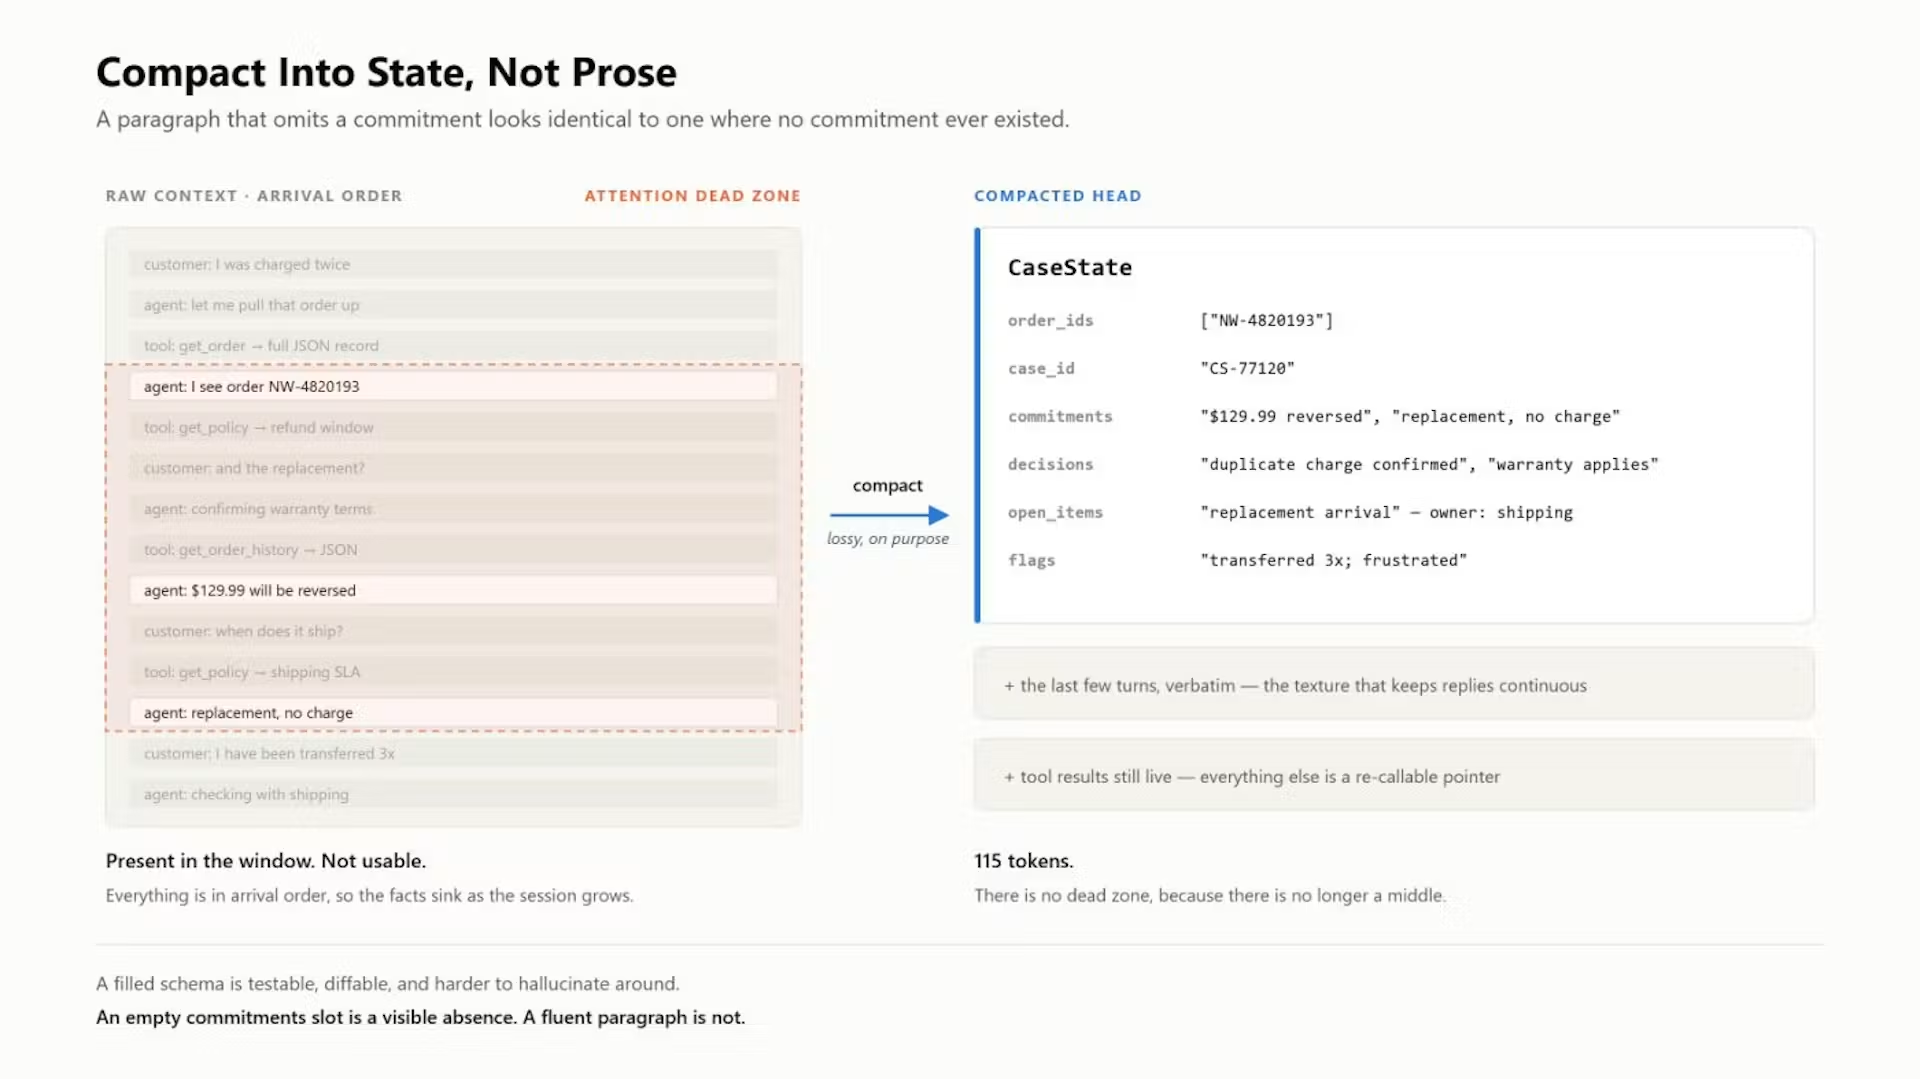
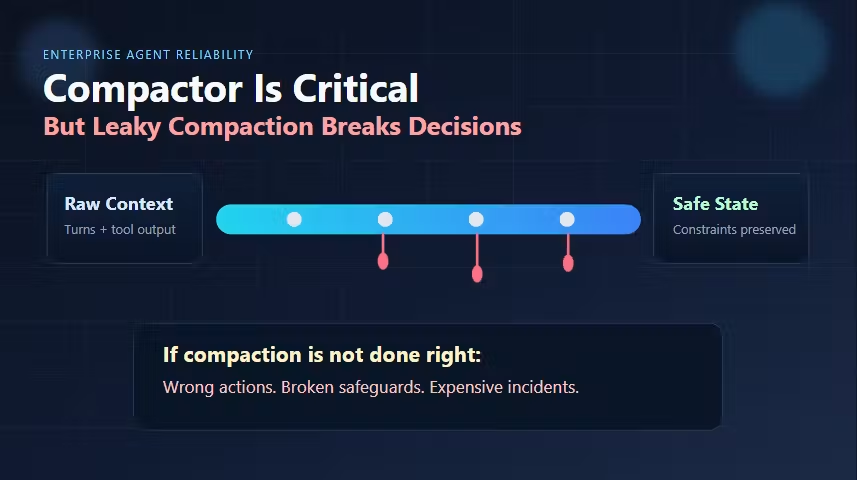
เหตุการณ์ล้มเหลวในระบบ AI จำนวนมากดูเผินๆ เหมือนโมเดลโง่หรือหลอน ตัวช่วยถามข้อมูลซ้ำที่ผู้ใช้บอกไปแล้ว ฝ่าฝืน constraint ที่ระบุชัด หรือเสนอคำแนะนำที่ไม่สนข้อตกลงเก่า เรามักรีบด่วนสรุปว่าโมเดล hallucinate แต่บ่อยครั้งโมเดลแค่ทำตามสิ่งที่เห็นใน context ปัจจุบัน ข้อผิดพลาดจริงคือขั้นตอน context compression ที่บีบข้อมูลทำสรุปจนทำให้สถานะสำคัญหายไปก่อนโมเดลถูกเรียกใช้งาน Context compression จึงไม่ใช่แค่การลด token แต่เป็นพื้นผิวความน่าเชื่อถือของระบบ
สรุปที่อ่านลื่นไหลอาจใช้งานไม่ได้ในเชิงปฏิบัติ “Readable summaries can still be operationally wrong” เป็นประโยคที่ควรติดผนังทีม agent ทุกทีม แทนที่จะถามว่าอ่านครบไหม เราต้องถามว่า สถานะที่จำเป็นต่อการตัดสินใจครั้งต่อไปยังอยู่หรือไม่ ตัวอย่างในหลายโดเมน เช่นข้อห้ามยาใน healthcare หรือเพดานอนุมัติใน finance มีความถี่ในข้อความต่ำ แต่ส่งผลต่อการกระทำสูง เมื่อ state หล่น พฤติกรรมถัดไปของโมเดลจะดูไร้เหตุผล แม้จริงๆ แล้วมันแค่ตอบตาม context ที่ถูกบีบอัดผิดรูปเท่านั้น
แยก memory ออกจาก state: เจ้าของสถานะและความจริงล่าสุด
สาเหตุหนึ่งที่ทำให้ทีมงงคือเราใช้คำว่า “memory” ครอบทุกอย่าง ตั้งแต่ประวัติแชต เอกสารที่ดึงมา ผลเครื่องมือ checkpoint workflow ไปจนถึง preference ผู้ใช้ เมื่อมองไกลๆ มันเหมือนกันหมดคือ “สิ่งที่อาจใช้ในอนาคต” แต่ในเชิงสถาปัตยกรรม คุณสมบัติมันต่างกันมาก สิ่งสำคัญคือแยกให้ชัดว่าอะไรคือความทรงจำเพื่อค้นหา และอะไรคือสถานะที่บอกความจริง ณ ตอนนี้ เช่น การอนุมัติจ่ายเงินอาจมีอายุแค่ไม่กี่วินาที ในขณะที่ preference การแจ้งเตือนอยู่ได้หลายเดือน ถ้าเอาทุกอย่างมาปนเป็น memory เราจะหลบคำถามสำคัญที่สุดไปคือ ข้อมูลชิ้นนี้หมายถึงอะไร
เมื่อหยุดมองข้อมูลคงอยู่ทั้งหมดว่าเป็น memory คำถามต่อไปจะโผล่ขึ้นทันทีว่า ใครเป็นเจ้าของสถานะ โมเดลไม่ใช่ฐานข้อมูล และ vector search ไม่ใช่ระบบพิสูจน์ความจริง “Relevance Is Not the Same as Truth” การค้นเจอเอกสารที่เกี่ยวข้องไม่ได้แปลว่ามันเป็นความจริงล่าสุด ระบบธุรกิจที่เป็นต้นทางเช่น payment service CRM หรือระบบคลังสินค้าคือตัวบอกความจริง ตัว agent ต้องถามเจ้าของ state ทุกครั้งที่ต้องรู้สถานะล่าสุด ไม่ใช่คาดเดาจากสิ่งที่เคยจำไว้ สถาปัตยกรรมที่ดีจึง keep LLM ให้ไร้สถานะ แล้วใช้ runtime ที่มี timestamp เวอร์ชัน concurrency optimistic idempotency transaction event log checkpoint และ semantics การกู้คืนมาจัดการ state management reliability ให้ระบบเชื่อถือได้
ทำให้การสูญหายสถานะตรวจสอบได้: typed summaries และ probe
ถ้า context management ระบบยังเป็นการเขียนสรุปเล่าเรื่องด้วยภาษาธรรมชาติ เราแทบไม่มีทางรู้เลยว่าตอนบีบอัดข้อมูล เราทำ state สำคัญตกหล่นหรือไม่ วิธีที่ดีกว่าคือ compact สถานะให้เป็น typed state แทน narrative เล่าเรื่อง เมื่อเปลี่ยนเป็นฟิลด์ที่มีชนิดชัด เช่น เจ้าของเคส เพดานอนุมัติ สถานะ workflow เราสามารถเขียน probe ซึ่งเป็น “คำถามที่รันได้บน state” เพื่อเช็กว่าการบีบอัดยังรักษาข้อมูลที่จำเป็นต่อการตัดสินใจอยู่หรือไม่ วิธีนี้ทำให้ correctness กลายเป็นสิ่งที่ทดสอบได้ ไม่ใช่การไล่อ่านสรุปด้วยสายตา
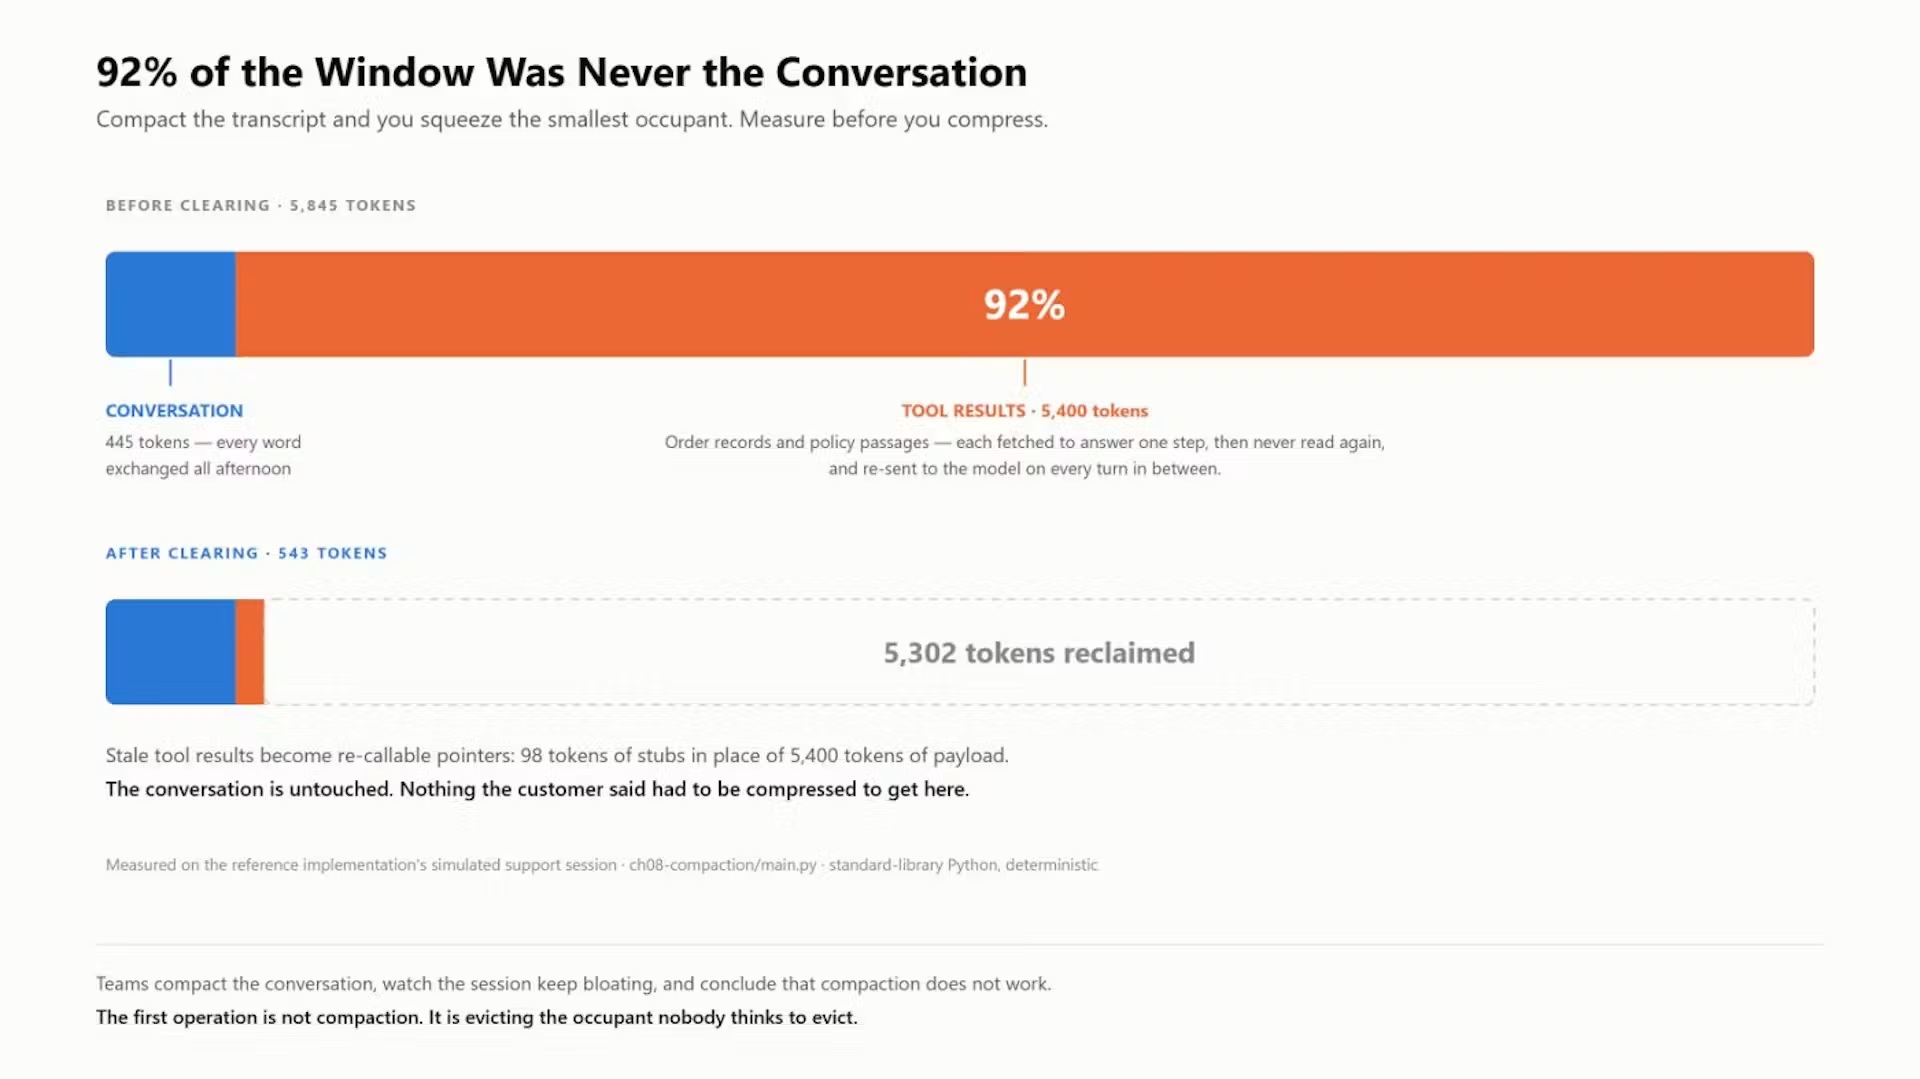
เมื่อมี probe และคะแนนตรวจวัด ทีมจะหยุดเดาแล้วหันมาออกแบบเชิงวิศวกรรม “Once compaction is measurable, teams stop guessing and start engineering” คือประโยคที่สรุปประโยชน์ของ pattern นี้ได้ดี เราสามารถเอา harness นี้เข้าไปอยู่ใน CI โดยไม่ต้องเรียกโมเดลจริงใน unit test แต่ทดสอบบน typed state แทน Tool payload มักพองบวมจนเป็นปัญหามากกว่าความยาวบทสนทนา การ compact เป็น typed state ช่วยย่อให้เล็กลงโดยยังคงความถูกต้อง และการให้ probe ให้คะแนนทำให้ความกังวลที่เคยคลุมเครือกลายเป็น regression ที่จับต้องได้และแก้ได้ทีละจุด