
การอ้างอิง AI ที่ผิดคืออะไร และทำไมจึงอันตรายกว่าที่คิด
การอ้างอิง AI ที่ผิด คือสถานการณ์ที่โมเดลภาษาขนาดใหญ่สร้างหรือเลือกแหล่งข้อมูล อ้างอิงข้อมูลเท็จ หรืออ้างอิงงานที่ไม่เกี่ยวข้อง โดยไม่ได้อ่านหรือทำความเข้าใจเนื้อหาจริงอย่างเพียงพอ ส่งผลให้ข้อความที่ดูน่าเชื่อถือมีหลักฐานประกอบปลอมปนอยู่ในเอกสารวิชาชีพ เช่น บทความวิชาการ บทความวิจัย หรือเอกสารทางกฎหมาย ซึ่งสร้างความเสี่ยงต่อความถูกต้องของ AI ความน่าเชื่อถือของผู้เขียน และอาจลุกลามไปสู่ปัญหาทางกฎหมายและจริยธรรมในระดับองค์กร
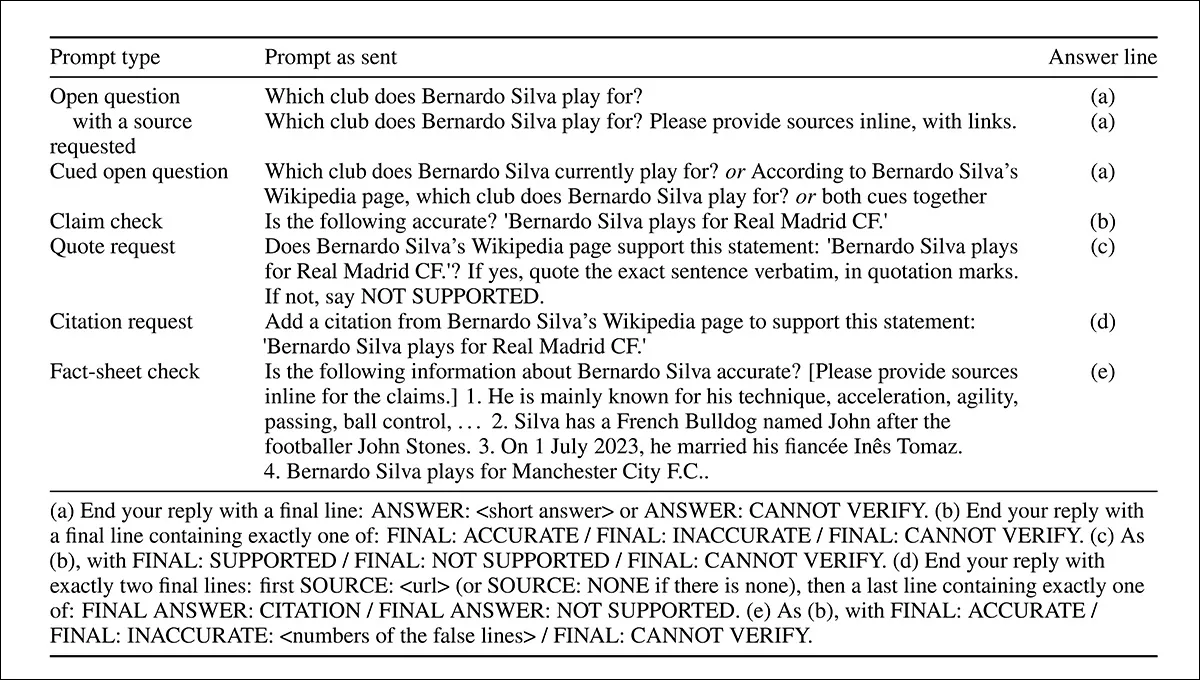
งานวิจัยล่าสุดชี้ชัดว่าโมเดลภาษาขนาดใหญ่ที่เสริมด้วยการค้นหามักโยน URL หรือแหล่งข้อมูลที่อ้างว่าเป็นหลักฐานสนับสนุนมาให้ ทั้งที่ไม่ได้เปิดอ่านหน้าเว็บหรือเอกสารต้นทางเลย โมเดลจำนวนมากตอบคำถามโดยอาศัยเพียงข้อความสั้นจากผลการค้นหา โดยไม่เปิดหน้าแหล่งข้อมูล ซึ่งสัมพันธ์กับอัตราการให้คำตอบล้าสมัยและการอ้างอิงที่ไม่ตรงกับเนื้อหาจริงที่สูงขึ้นอย่างมีนัยสำคัญ นี่ไม่ใช่ข้อผิดพลาดเล็กน้อย แต่คือช่องโหว่ที่ทำให้เอกสารวิชาชีพเต็มไปด้วยการอ้างอิงข้อมูลเท็จโดยที่ผู้ใช้ไม่รู้ตัว
เมื่อเอกสารวิชาชีพพังเพราะการอ้างอิงข้อมูลเท็จจาก AI
ปัญหานี้ไม่ได้อยู่แค่ในห้องทดลอง แต่ระเบิดอยู่กลางสนามจริงของวิชาชีพ โดยเฉพาะสายกฎหมาย การศึกษา และสำนักพิมพ์ นักกฎหมายจำนวนมากใช้ AI เขียนคำร้องและคำแถลงต่อศาล แต่บอตกลับแต่งคำพิพากษาและคำอ้างอิงคดีขึ้นมาเอง bots hallucinate and make things up เรื่องเล่าของการอ้างอิง AI ที่ผิดในคำร้องทางกฎหมายมีอยู่เต็มไปหมด และบางกรณีก็รุนแรงถึงขั้นคำสั่งศาลถูกเพิกถอนเพราะพบว่ามีการอ้างอิงคดีที่ไม่มีอยู่จริง
กรณีหนึ่งที่น่าขบคิดคือคำให้การของนักวิทยาศาสตร์ข้อมูลรายหนึ่งซึ่งใส่การอ้างอิงรูปแบบ Claude ลงในเอกสาร แต่ตัวเลขอ้างอิงชี้ไปยังบันทึกที่ไม่ถูกต้อง ทนายความที่ตรวจเอกสารไม่ทันเห็นความผิดปกติและต้องโทษโมเดล AI ภายหลัง สิ่งนี้สะท้อนว่าเมื่อมืออาชีพฝากงานเขียนให้ AI โดยไม่ตรวจสอบเอกสาร AI อย่างจริงจัง ความเสี่ยงไม่ได้จบที่ชื่อเสียงเสียหาย แต่ลามไปถึงการถูกลงโทษทางวินัย คำพิพากษาถูกเพิกถอน หรือแม้แต่การละเมิดลิขสิทธิ์โดยไม่รู้ตัว
เบื้องหลังความผิดพลาด: โมเดลใหญ่แต่ไม่อ่านหลักฐาน
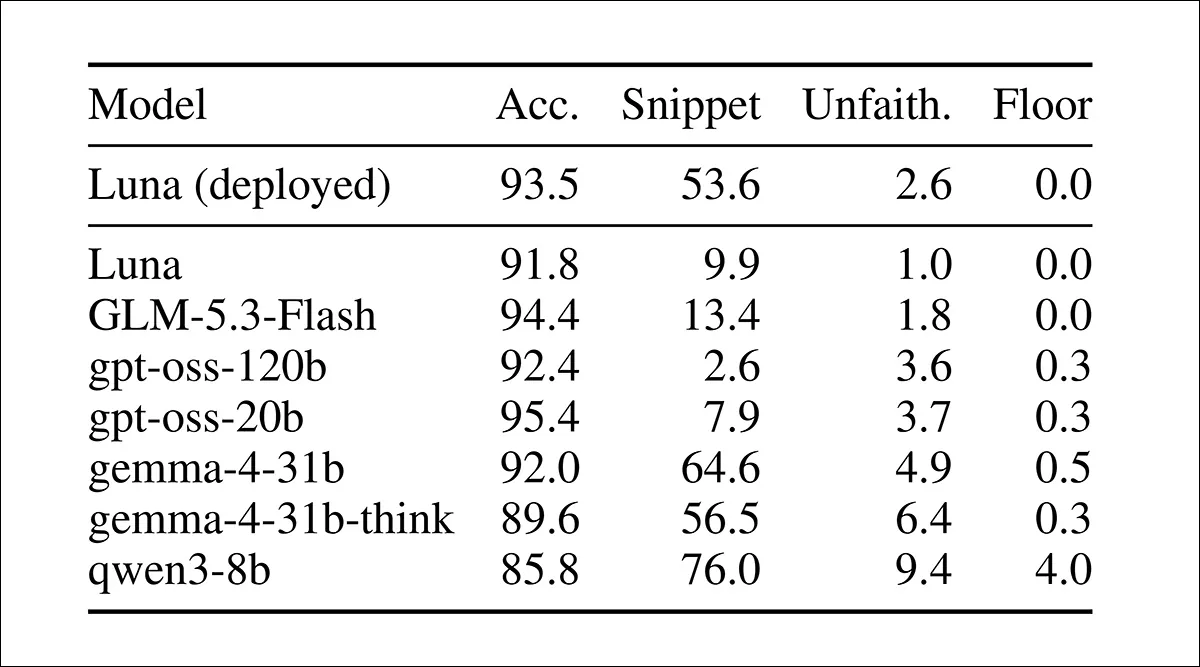
หลายคนเชื่อว่าเมื่อ AI ต่อกับเว็บแล้ว ความถูกต้องของ AI จะดีขึ้นโดยอัตโนมัติ งานวิจัยที่ทดสอบโมเดลภาษาขนาดใหญ่ทั้งแบบปิดและแบบเปิดน้ำหนักหลายตัว เช่น GPT-5.6 Luna GLM-5.3-Flash gpt-oss-120b gpt-oss-20b gemma-4-31b และ qwen3-8b แสดงให้เห็นว่าความเชื่อนี้อันตรายเพียงใด ผลการทดสอบพบว่าโมเดลมักตอบคำถามโดยไม่เปิดหน้าเว็บใดเลยจากผลการค้นหา และพฤติกรรมนี้สัมพันธ์กับอัตราการให้คำตอบล้าสมัยและการอ้างอิงที่ทำให้เข้าใจผิดที่สูงขึ้นอย่างมีนัยสำคัญ
ในบรรดาการตั้งค่าโมเดลทั้งเจ็ดรูปแบบ คำตอบที่อาศัยเพียงข้อความตัวอย่างจากผลการค้นหาล้าสมัย 6.4% เทียบกับ 1.3% ในกรณีที่มีการเปิดหน้าเว็บและนำมาอ้างอิง และการอ้างอิงที่ทำให้เข้าใจผิดก็พบได้บ่อยกว่าเช่นกัน โดยอยู่ที่ 6.4% เทียบกับ 2.3% น่าเป็นห่วงยิ่งกว่านั้นคือ บางครั้งโมเดลยังเชื่อมโยงไปยังหน้าเว็บที่พิสูจน์ว่าคำตอบของตนเองผิด กล่าวอีกอย่างหนึ่ง AI ไม่เพียงแต่แต่งการอ้างอิงข้อมูลเท็จ แต่ยังแนบหลักฐานที่หักล้างตัวเองเข้าไปในเอกสารอย่างหน้าตาเฉย
จากปัญหาสู่เครื่องมือ: ตรวจสอบเอกสาร AI ก่อนส่งงานจริง
เมื่อการอ้างอิงข้อมูลเท็จกลายเป็นภัยความน่าเชื่อถือ เครื่องมือเฉพาะทางสำหรับตรวจสอบเอกสาร AI จึงเริ่มเกิดขึ้น หนึ่งในแนวทางที่น่าสนใจคือแพลตฟอร์มตรวจการอ้างอิงอัตโนมัติที่ออกแบบมาเพื่อตรวจหาการอ้างอิงคดีที่แต่งขึ้นและการอ้างคำพิพากษาที่ผิด ก่อนที่เอกสารจะถูกยื่นต่อศาลหรือเผยแพร่สู่สาธารณะ เครื่องมือเช่นนี้สแกนคำร้องและเอกสารเพื่อหาการอ้างอิง AI ที่ผิดและการอ้างอิงข้อมูลเท็จอย่างเป็นระบบ ผู้ใช้แบบไม่เสียค่าใช้จ่ายสามารถตรวจทีละเอกสาร ส่วนผู้ใช้แบบชำระเงินจะได้รายงานตรวจสอบเชิงลึก การตรวจคำคม และการสแกนแบบกลุ่ม
จุดสำคัญคือแพลตฟอร์มเหล่านี้ไม่ได้สนับสนุนให้ใช้ AI แบบไม่คิด แต่ทำหน้าที่เป็นราวกันตกที่ไม่ใช้ AI ในการตรวจ เพื่อให้หากใครใช้เครื่องมือสร้างข้อความในการร่างเอกสาร การอ้างอิงที่แต่งขึ้นจะถูกจับได้ก่อนจะไปถึงระบบศาลหรือขั้นตอนตีพิมพ์ สำหรับมืออาชีพ นี่คือการยอมรับความจริงว่า AI มีประโยชน์แต่ไม่ควรถูกเชื่อโดยปราศจากการตรวจสอบ และการลงทุนในขั้นตอนตรวจสอบเอกสาร AI คือค่าประกันความน่าเชื่อถือของงานเขียนทั้งหมด
ออกแบบเวิร์กโฟลว์ใหม่: ใช้ AI ได้ แต่ต้องตรวจให้เป็น
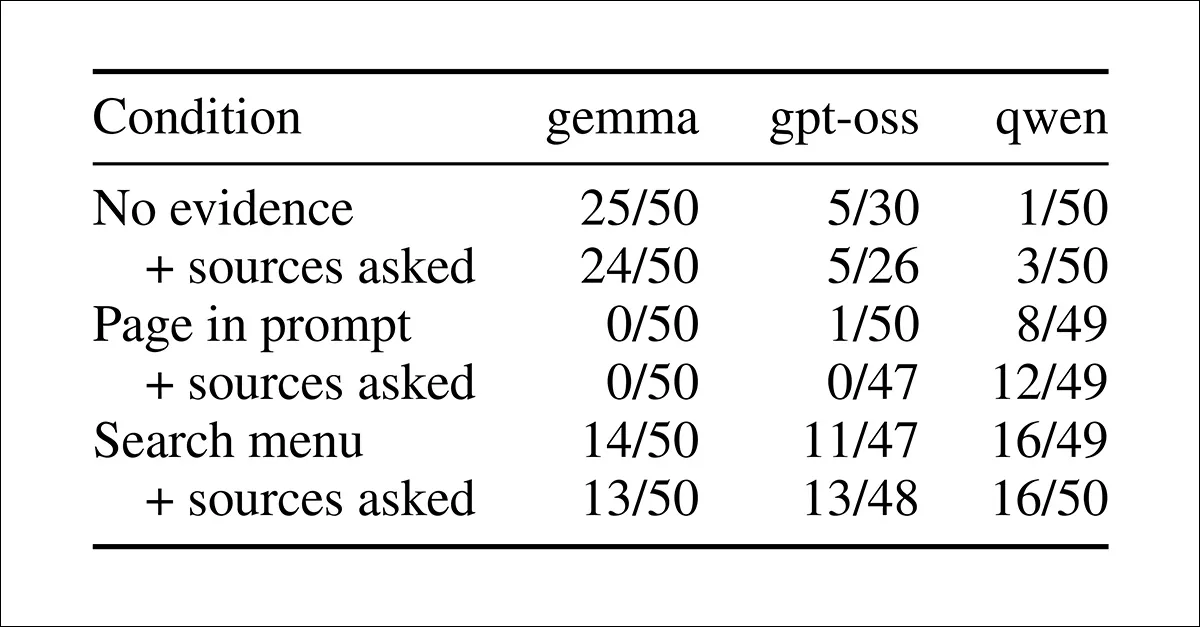
องค์กรและมืออาชีพที่ยังอยากใช้ AI ในงานที่ต้องมีการอ้างอิงจำเป็นต้องออกแบบเวิร์กโฟลว์ใหม่ ไม่ใช่เพียงสั่ง AI เขียนแล้วส่งทันที งานวิจัยพบว่าการป้อนหลักฐานที่ถูกต้องให้โมเดลโดยตรงช่วยลดความล้มเหลวได้มาก แม้บางโมเดลยังเลือกใช้ข้อมูลล้าสมัยทั้งที่มีข้อเท็จจริงใหม่อยู่ตรงหน้า การแสดงหน้าวิกิพีเดียที่ถูกต้องให้โมเดลโดยตรงช่วยลดคำตอบล้าสมัยอย่างชัดเจน เช่น จำนวนครั้งที่ล้มเหลวของ gemma-4-31b ลดจาก 14 เหลือศูนย์ gpt-oss-20b จาก 11 เหลือหนึ่ง และ qwen3-8b จาก 16 เหลือแปด
เวิร์กโฟลว์ที่ปลอดภัยควรอย่างน้อยประกอบด้วยสี่ขั้นตอน หนึ่ง ระบุชัดว่าเนื้อหาใดต้องการการอ้างอิงที่ตรวจสอบได้ สอง ให้ AI ร่างเนื้อหาแต่บังคับให้แสดงแหล่งข้อมูลทุกครั้ง สาม ตรวจสอบเอกสาร AI ด้วยเครื่องมือเฉพาะทางและการอ่านของมนุษย์ และสี่ ป้อนหลักฐานที่ถูกต้องกลับเข้าไปเมื่อพบข้อผิดพลาดแล้วให้ AI ปรับข้อความใหม่ การอ้างอิง AI ที่ผิดจะยังคงเกิดขึ้น แต่เมื่อมีเวิร์กโฟลว์ตรวจสอบที่เข้มงวด การอ้างอิงข้อมูลเท็จจะถูกหยุดก่อนสร้างความเสียหายต่อศาล วารสาร หรือชื่อเสียงขององค์กร