
สรุปก่อนเลือก: ราคาต่อโทเค็นไม่ใช่คำตอบทั้งหมด
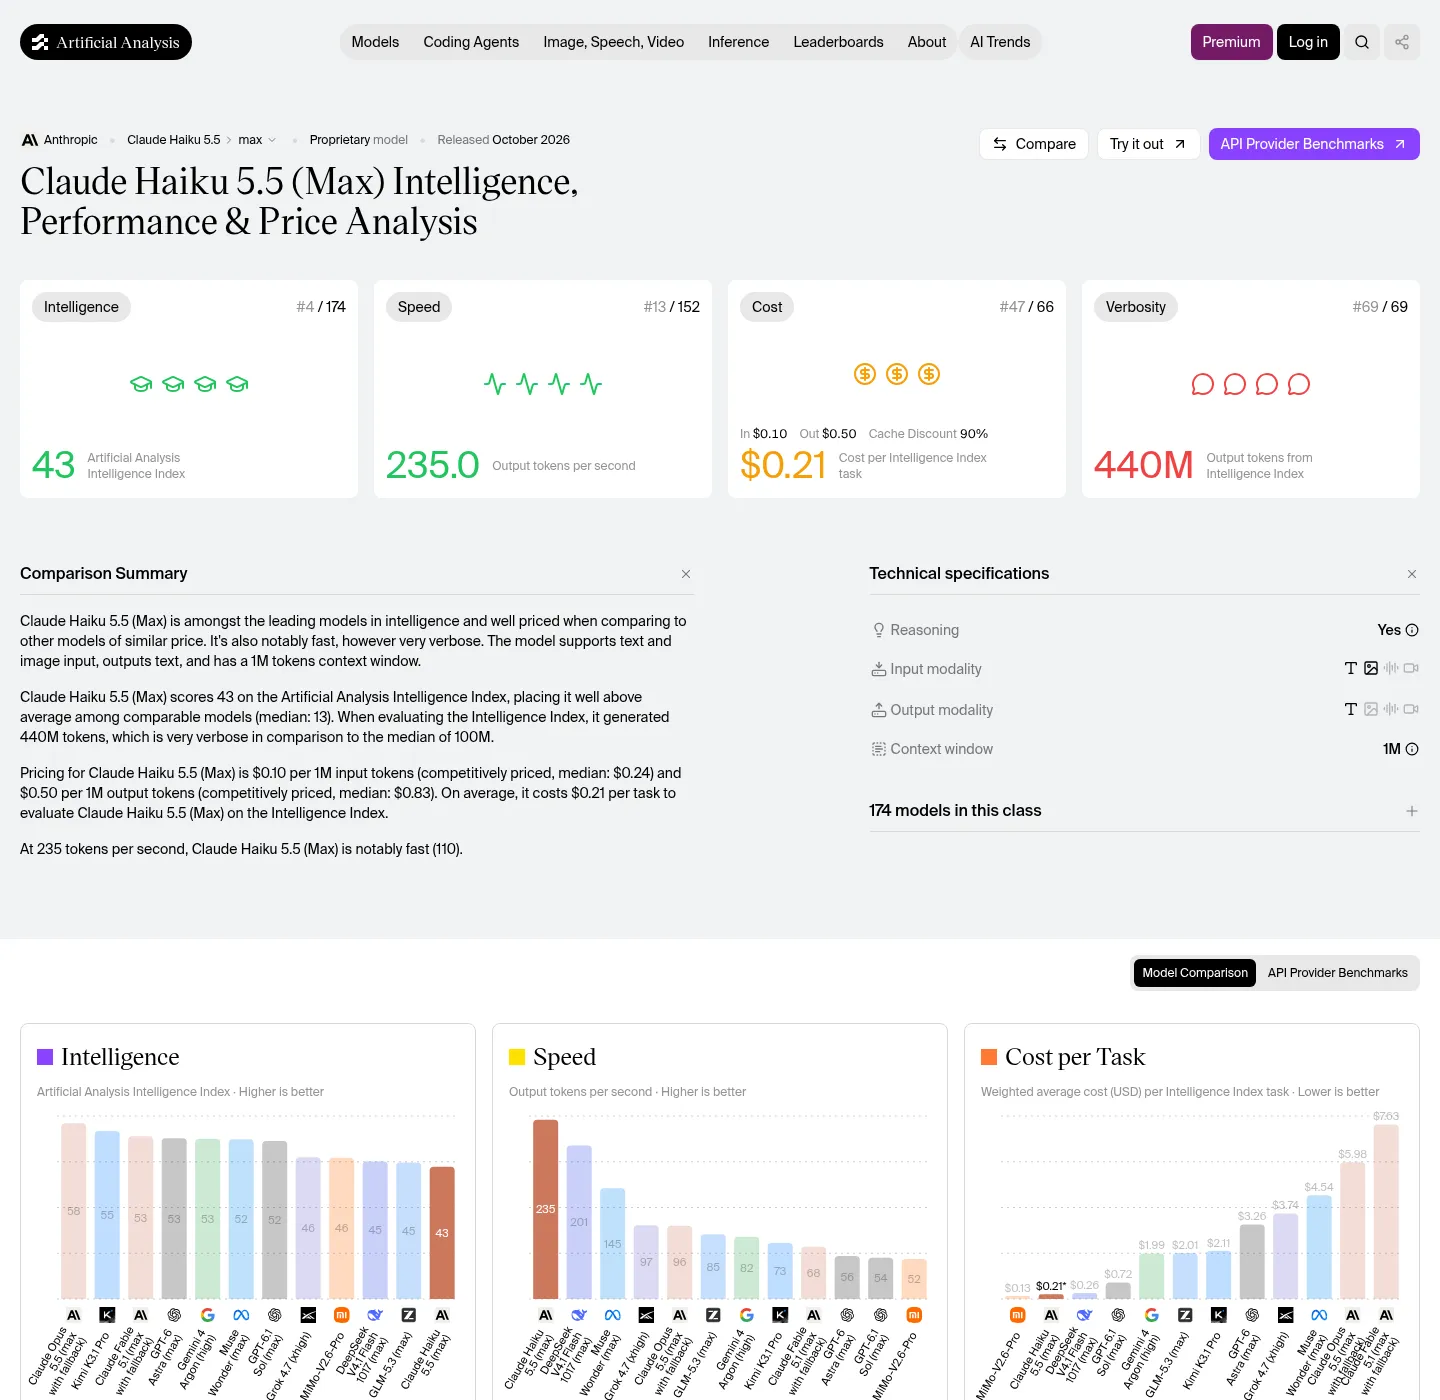
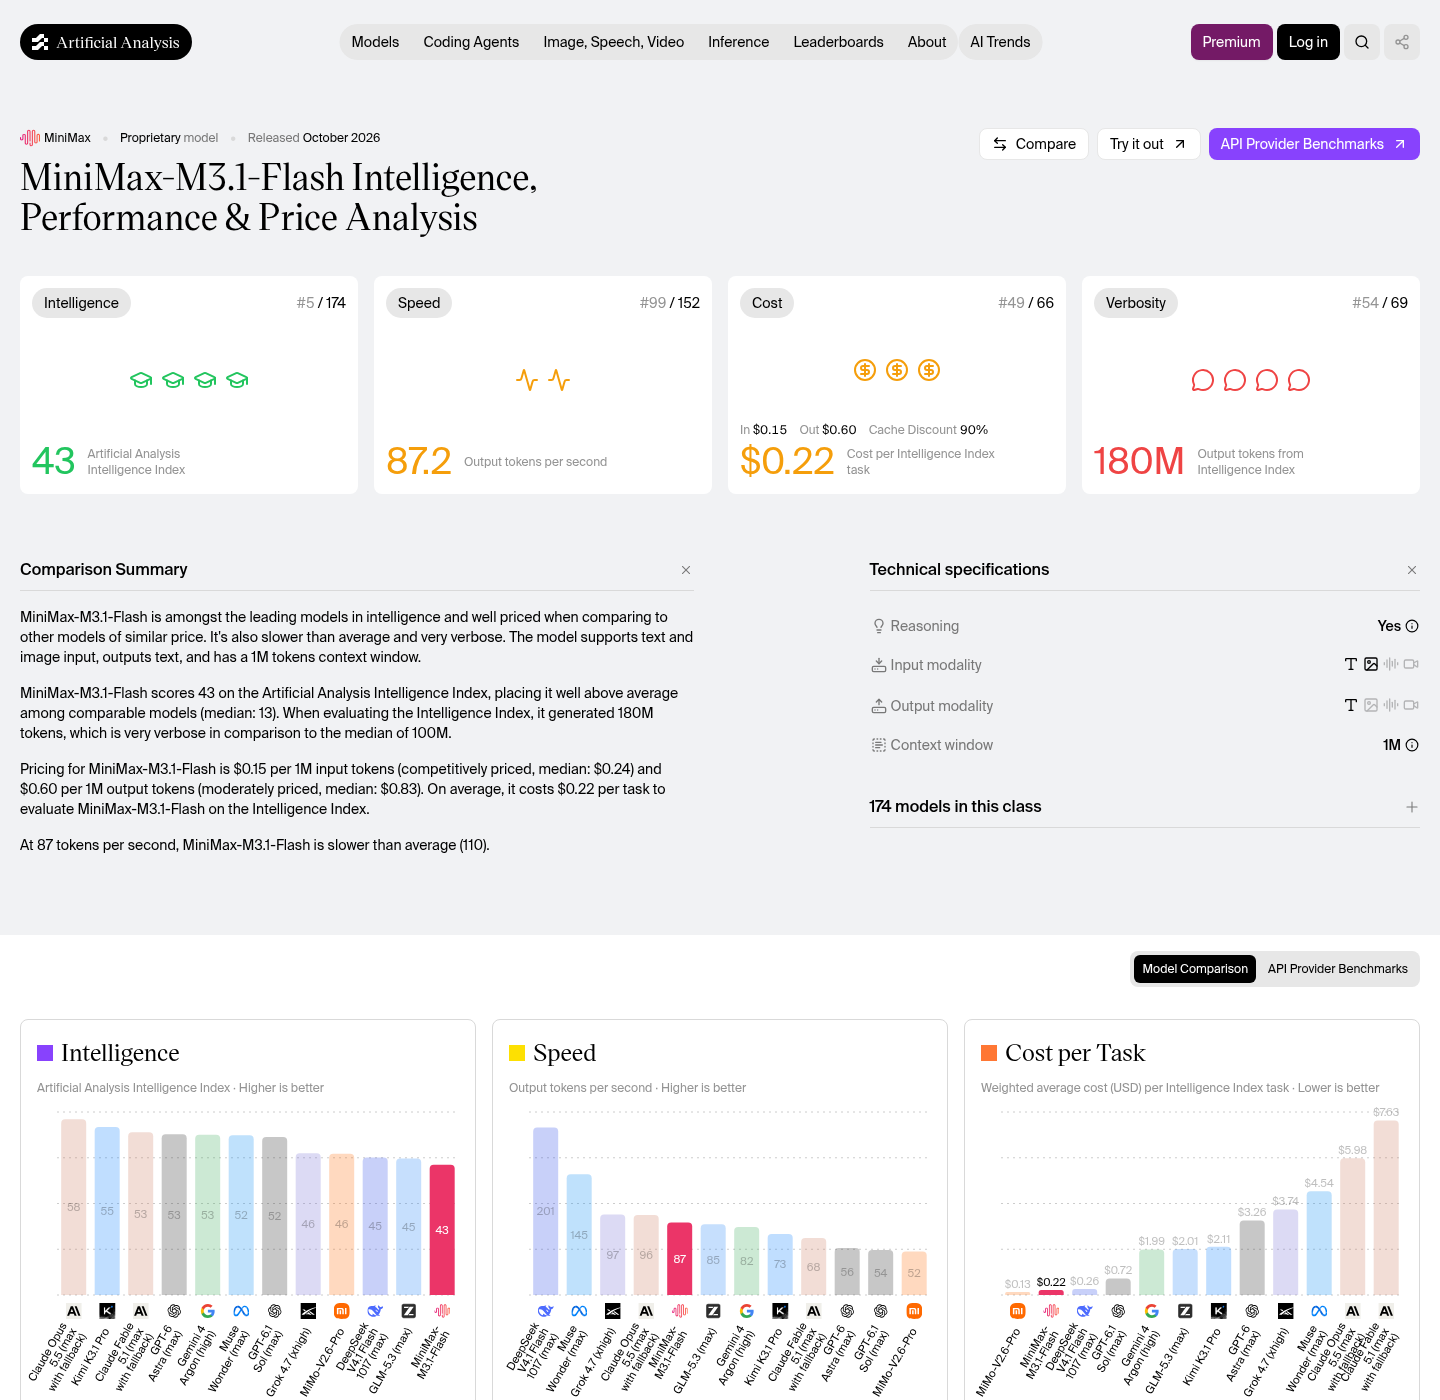
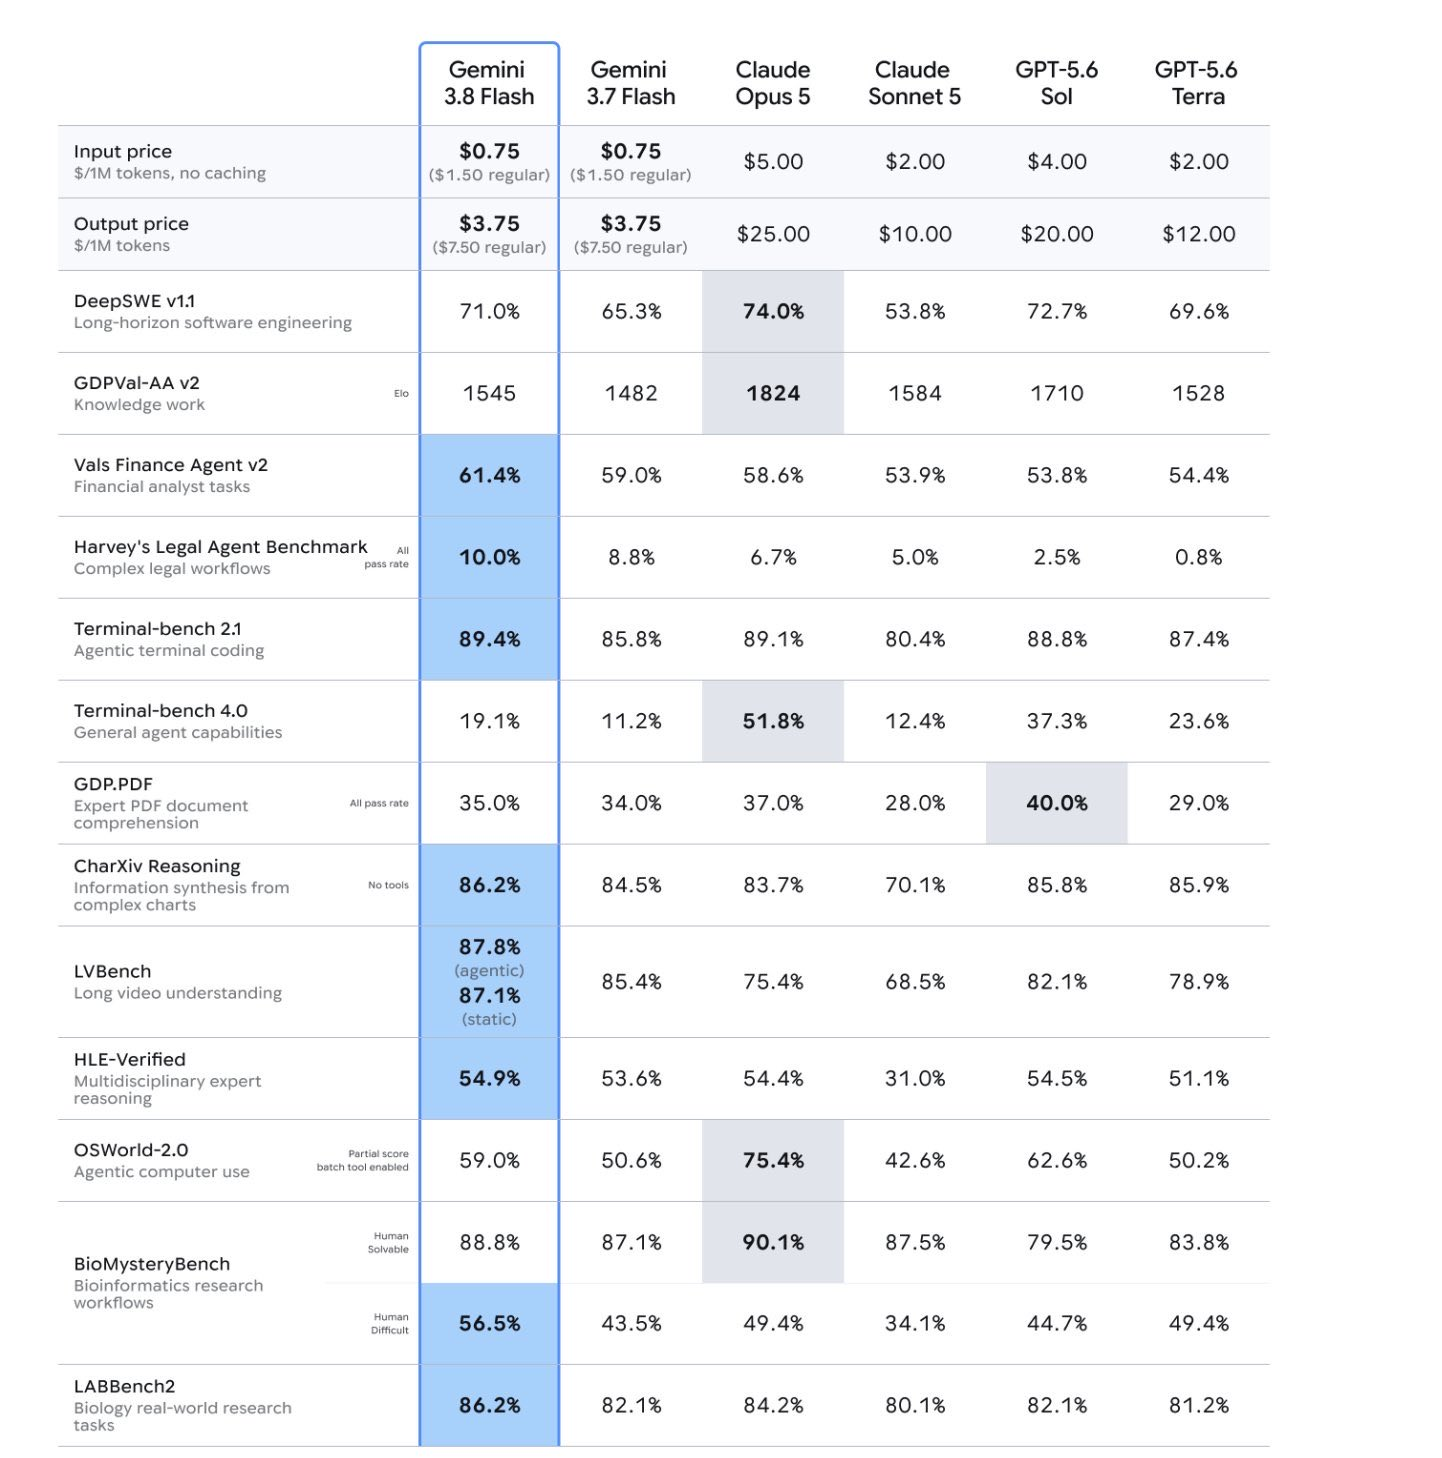
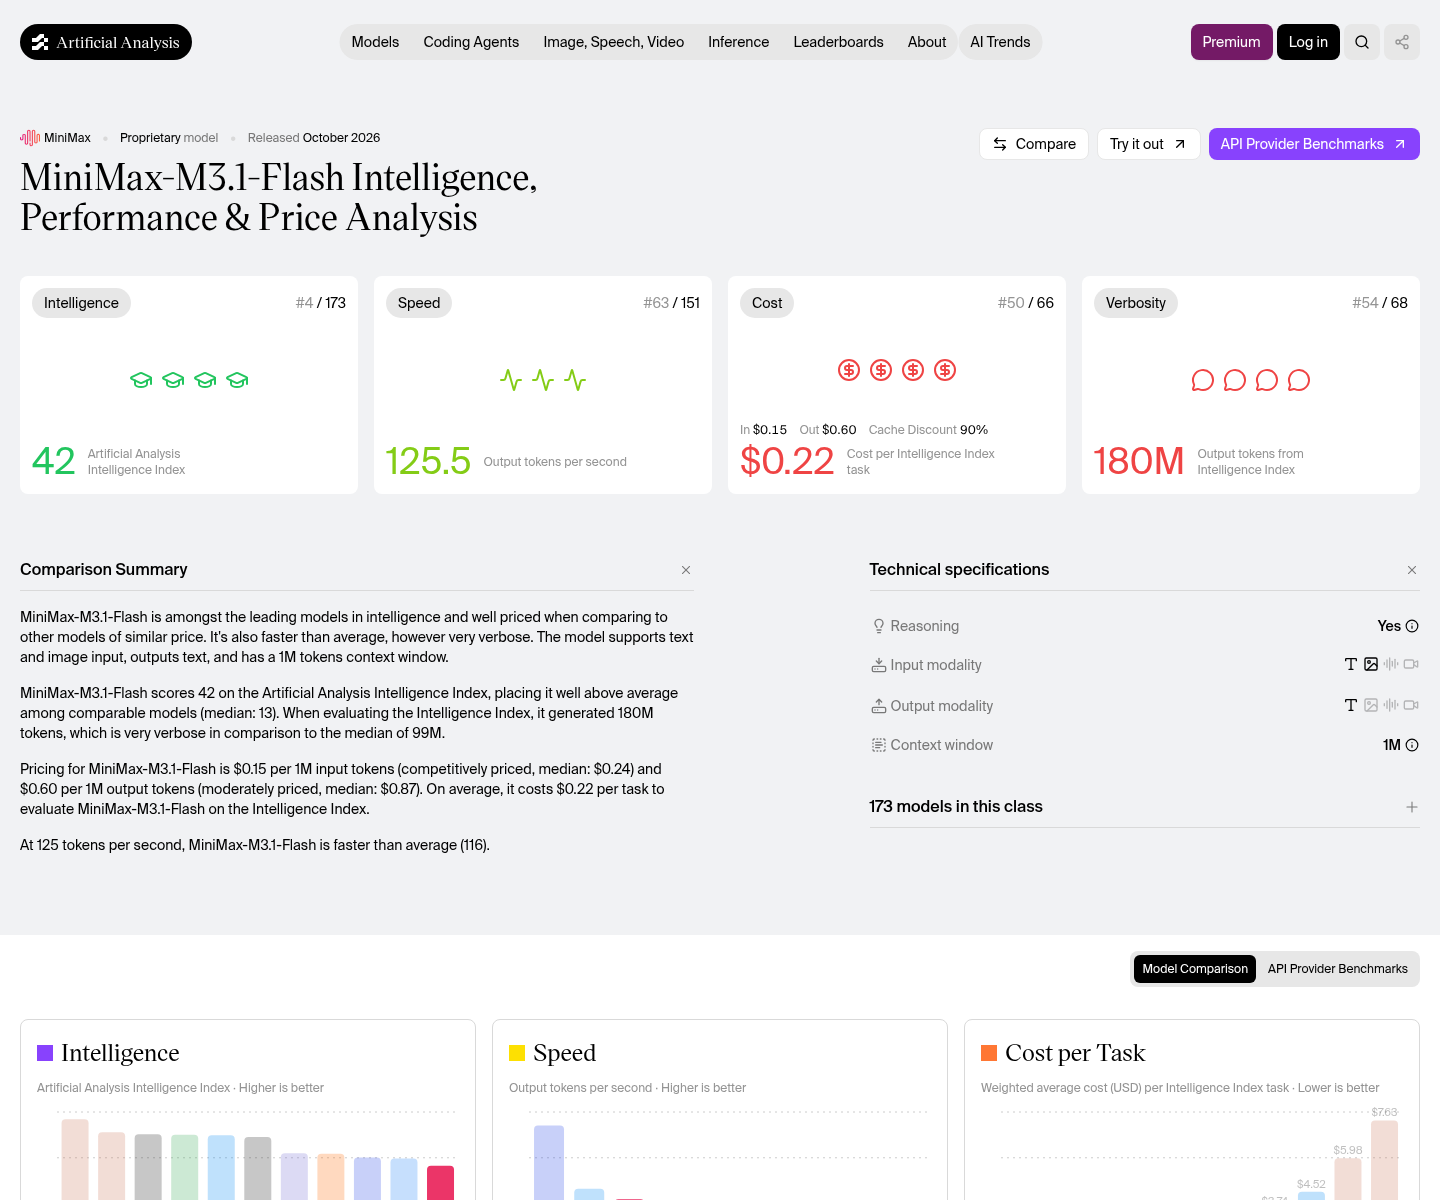
โมเดล AI แบบแฟลชคือโมเดลที่ออกแบบมาให้ตอบสนองรวดเร็ว เหมาะกับงานที่เรียกใช้บ่อยและต้องคุมค่าใช้จ่าย โดยความคุ้มค่าขึ้นกับทั้งอัตราคิดต่อโทเค็น ความยาวพรอมป์ต์ และปริมาณคำตอบที่โมเดลสร้าง MiniMax M3.1 Flash เหมาะกับงานบริบทขนาดยาวและเอาต์พุตมาก ส่วน Claude Haiku 5.5 ได้เปรียบเมื่อพรอมป์ต์ไม่เกิน 100,000 โทเค็น ขณะที่ Gemini 3.5 Flash-Lite น่าสนใจเมื่อวัดจากต้นทุนต่อภารกิจ ไม่ใช่ราคาโทเค็นอย่างเดียว ตารางนี้ช่วยแยกความต่างของราคาและขีดจำกัดที่กระทบการตัดสินใจ ก่อนเลือกควรนำสัดส่วนอินพุตกับเอาต์พุตของงานจริงมาคิดด้วย เพราะโมเดลที่ราคาต่อหน่วยต่ำกว่าอาจไม่ได้ทำให้งานหนึ่งชิ้นมีต้นทุนต่ำกว่าเสมอ
| ข้อมูลเปรียบเทียบ | MiniMax M3.1 Flash | Claude Haiku 5.5 | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| แนวโน้มราคาอินพุต | อัตราคงที่ แม้พรอมป์ต์ยาว | ได้เปรียบเมื่อพรอมป์ต์ไม่เกิน 100,000 โทเค็น และสูงขึ้นเมื่อเกินเกณฑ์ | สูงกว่า MiniMax ต่อโทเค็น |
| แนวโน้มราคาเอาต์พุต | อัตราคงที่ | ต่ำกว่า MiniMax สำหรับพรอมป์ต์สั้น แต่สูงขึ้นมากเมื่อข้ามเกณฑ์ | สูงกว่า MiniMax ต่อโทเค็น |
| บริบทสูงสุด | 1 ล้านโทเค็น | 1 ล้านโทเค็น | 1 ล้านโทเค็น |
| เอาต์พุตสูงสุด | 524,288 โทเค็น | 128,000 โทเค็น | 65,536 โทเค็น |
| ดัชนีความฉลาด | 43 | 43 | 22 |
MiniMax กับ Claude: จุดตัดอยู่ที่ความยาวพรอมป์ต์
ถ้างานส่วนใหญ่ของคุณเป็นคำถามสั้น การจัดประเภท หรือการสกัดข้อมูลจากพรอมป์ต์ที่ไม่ยาว Claude Haiku 5.5 มีต้นทุนต่อโทเค็นต่ำกว่า MiniMax M3.1 Flash จึงเป็นตัวเลือกที่ชวนประหยัดกว่าในรูปแบบนี้ แต่ข้อได้เปรียบกลับด้านเมื่อพรอมป์ต์เกิน 100,000 โทเค็น เพราะ Claude ปรับอัตราค่าบริการขึ้นกับคำขอทั้งหมด ขณะที่ MiniMax คงอัตราเดิมตลอดหน้าต่างบริบท ดังนั้นเอเจนต์ที่ส่งเอกสารหรือบริบทจำนวนมากซ้ำ ๆ อาจควบคุมค่าใช้จ่ายได้ง่ายกว่าด้วย MiniMax แม้ความเร็วก็มีผลต่อประสบการณ์ใช้งาน โดยข้อมูลที่ให้มาระบุว่า Claude สร้างเอาต์พุตได้เร็วกว่า อย่างไรก็ตาม ทั้งคู่ได้คะแนนดัชนีความฉลาดเท่ากัน จึงไม่มีเหตุผลด้านคะแนนนี้ให้เลือกตัวใดตัวหนึ่งแทนการวัดรูปแบบทราฟฟิกจริง

MiniMax กับ Qwen: อินพุตราคาเดียวกัน แต่ไม่ใช่โมเดลแบบเดียวกัน
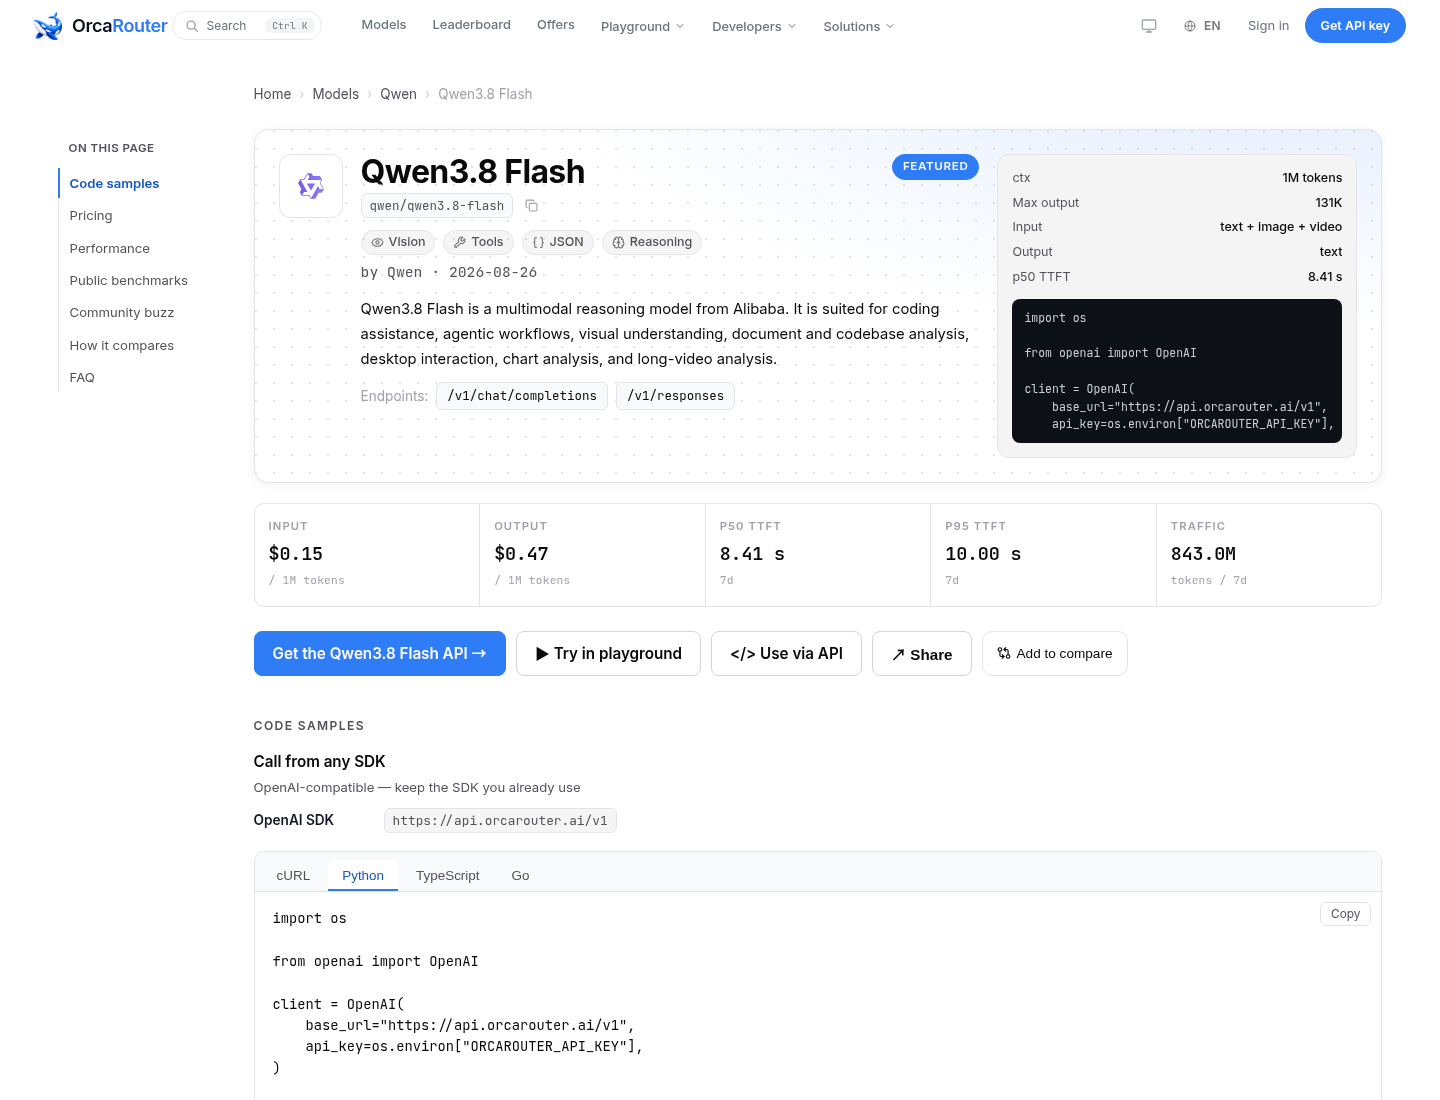
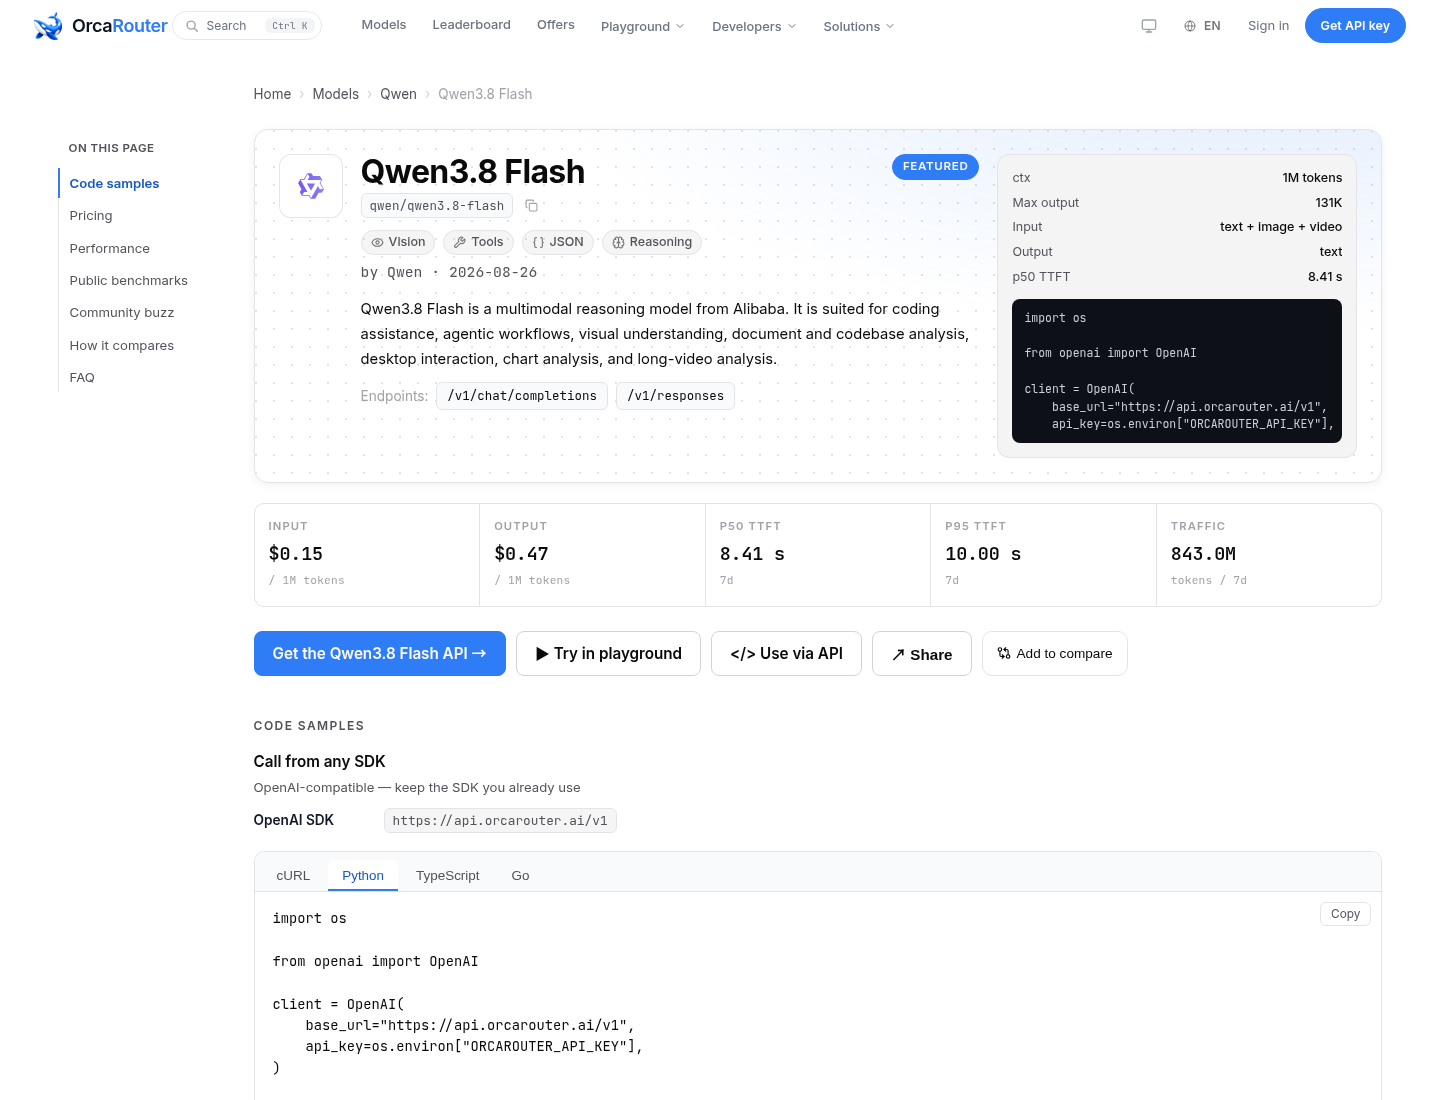
MiniMax M3.1 Flash และ Qwen 3.8 Flash มีอัตราอินพุตเท่ากัน แต่ความต่างอยู่ที่วิธีทำงานและต้นทุนฝั่งเอาต์พุต MiniMax ให้เหตุผลทุกครั้งที่เรียกใช้และสร้างคำตอบได้เร็วกว่า ส่วน Qwen ใช้สถาปัตยกรรมแบบผสมผู้เชี่ยวชาญและมีอัตราเอาต์พุตต่ำกว่า จึงอาจเหมาะกับงานที่ต้องการคำตอบกระชับและไม่เน้นความเร็วสูงสุด จุดที่ต้องระวังคือผลทดสอบอิสระที่เผยแพร่สำหรับ Qwen เป็นของ Flash-Next ซึ่งดาวน์โหลดได้ ไม่ใช่รุ่น Flash แบบโฮสต์ การนำคะแนนหรือพฤติกรรมของสองรุ่นมาแทนกันจึงไม่ควรทำโดยไม่มีการทดสอบเอง สำหรับทีมที่เลือกจากต้นทุน MiniMax Flash เพียงอย่างเดียว การดูแค่ราคาอินพุตจะไม่พอ ควรตรวจจำนวนโทเค็นคำตอบและความเร็วที่งานต้องใช้ก่อนตัดสินใจ
Gemini Flash: แพงกว่าต่อโทเค็น แต่อาจถูกกว่าต่องาน
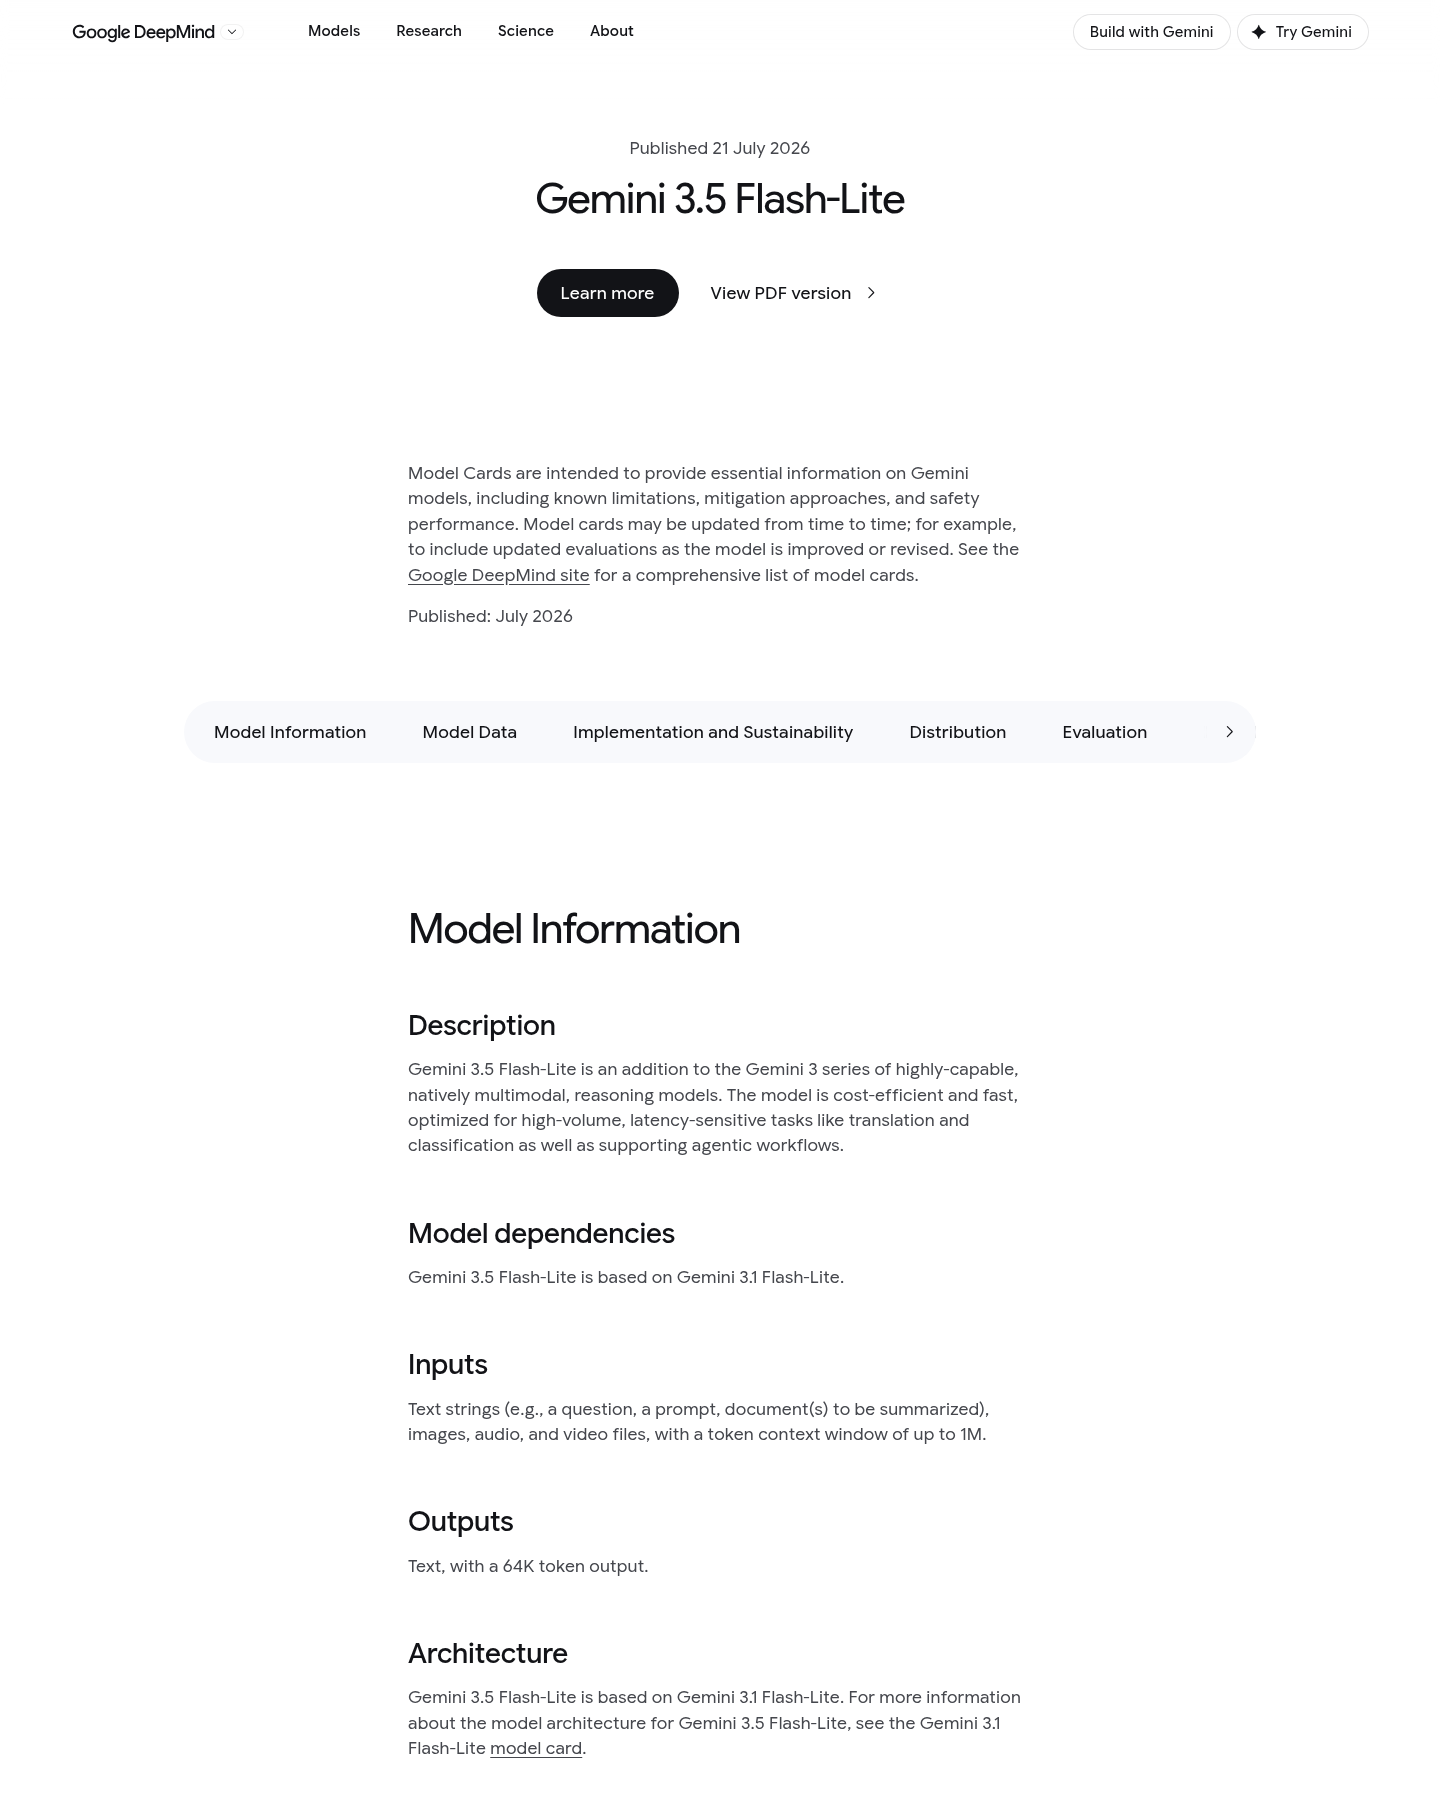
Gemini 3.5 Flash-Lite มีอัตราต่อโทเค็นสูงกว่า MiniMax M3.1 Flash ทั้งฝั่งอินพุตและเอาต์พุต แต่ผลเปรียบเทียบต้นทุนต่อภารกิจของ Artificial Analysis กลับระบุว่า Gemini ใช้ต้นทุนน้อยกว่าในงานที่นำมาวัด นี่คือเหตุผลที่คำค้นอย่าง Gemini Flash ประหยัด ไม่ควรตัดสินจากเรตราคาอย่างเดียว เพราะจำนวนโทเค็นที่โมเดลใช้ทำงานให้สำเร็จก็เป็นส่วนหนึ่งของบิล MiniMax มีคะแนนดัชนีความฉลาดสูงกว่าและรองรับเอาต์พุตได้ยาวกว่า จึงเหมาะกับงานซับซ้อนหรือเอเจนต์ที่สร้างคำตอบยาว ส่วน Gemini อาจตอบโจทย์เมื่อภารกิจมาตรฐานมีต้นทุนรวมต่ำกว่าและไม่ต้องใช้เอาต์พุตยาวมาก หากระบบรองรับการประมวลผลแบบชุด Gemini ยังมีระดับราคาสำหรับงานลักษณะนี้ แต่ควรคำนวณแยกตามสัดส่วนเอาต์พุตของทีม
Buy if / Skip if
- Buy the MiniMax M3.1 Flash if งานมีพรอมป์ต์ยาวเกิน 100,000 โทเค็น ต้องการบริบทขนาดใหญ่ หรือสร้างเอาต์พุตยาว
- Skip the MiniMax M3.1 Flash if งานส่วนใหญ่เป็นพรอมป์ต์สั้นและต้องการลดต้นทุนต่อโทเค็นให้ต่ำที่สุด
- Buy the Claude Haiku 5.5 if งานมักอยู่ต่ำกว่า 100,000 โทเค็นและให้ความสำคัญกับต้นทุนของพรอมป์ต์สั้น
- Skip the Claude Haiku 5.5 if เอเจนต์ของคุณส่งบริบทเกิน 100,000 โทเค็นเป็นประจำและต้องการเลี่ยงการปรับอัตราค่าบริการ
- Buy the Gemini 3.5 Flash-Lite if ผลทดสอบงานของคุณยืนยันว่าต้นทุนต่อภารกิจต่ำกว่า และไม่จำเป็นต้องสร้างเอาต์พุตยาว
- Skip the Gemini 3.5 Flash-Lite if งานต้องการคะแนนความสามารถสูงกว่า หรือใช้เอาต์พุตเกินขีดจำกัดของโมเดล
- Buy the Qwen 3.8 Flash if งานเน้นคำตอบกระชับและต้องการพิจารณาอัตราเอาต์พุตที่ต่ำกว่า MiniMax
- Skip the Qwen 3.8 Flash if คุณต้องอาศัยผลทดสอบของรุ่น Flash-Next มาแทนพฤติกรรมของรุ่น Flash แบบโฮสต์โดยไม่ทดสอบเอง