
ความเก่งของโมเดลไม่ได้วัดด้วยขนาดเพียงอย่างเดียว
โมเดล AI ขนาดเล็กคือโมเดลที่มีพารามิเตอร์จำนวนน้อยกว่าโมเดลขนาดใหญ่ แต่ยังออกแบบให้ทำงานเฉพาะด้านได้ดี โดยใช้หน่วยความจำและกำลังประมวลผลน้อยลง เหมาะกับการนำไปใช้บนโทรศัพท์และอุปกรณ์ปลายทางที่มีทรัพยากรจำกัด แนวโน้มล่าสุดชี้ว่าโมเดลกลุ่มนี้ไม่ได้เป็นเพียงทางเลือกสำรองอีกต่อไป แต่เริ่มทำคะแนนไล่ทันหรือแซงรุ่นใหญ่ในงานบางประเภท อย่างไรก็ตาม คะแนนเหล่านี้ไม่ใช่หลักฐานว่าโมเดลเล็กเก่งกว่าทุกด้าน เพราะผลขึ้นอยู่กับชนิดของงาน ชุดทดสอบ และวิธีวัดด้วย การเปรียบเทียบ benchmark AI จึงควรดูว่าทั้งสองรุ่นทำข้อสอบชุดเดียวกันหรือไม่ มากกว่าหยิบตัวเลขจากคนละตารางมาเทียบกันตรง ๆ
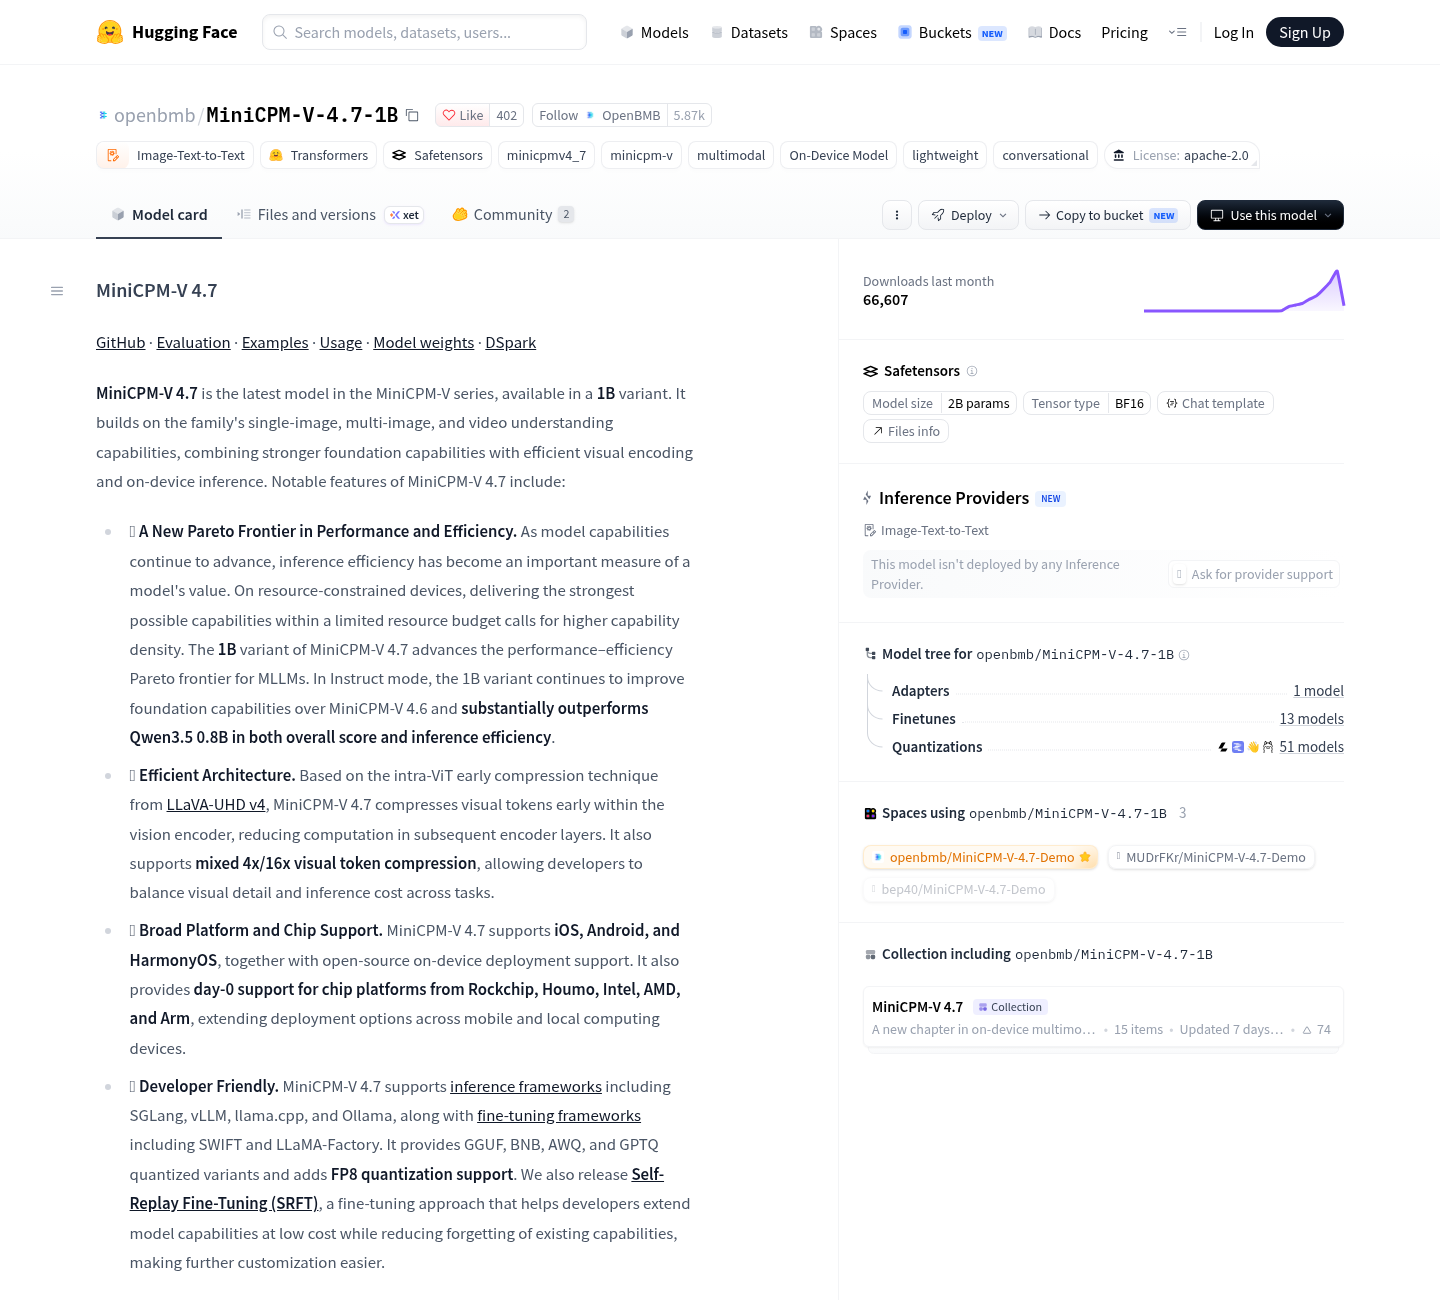
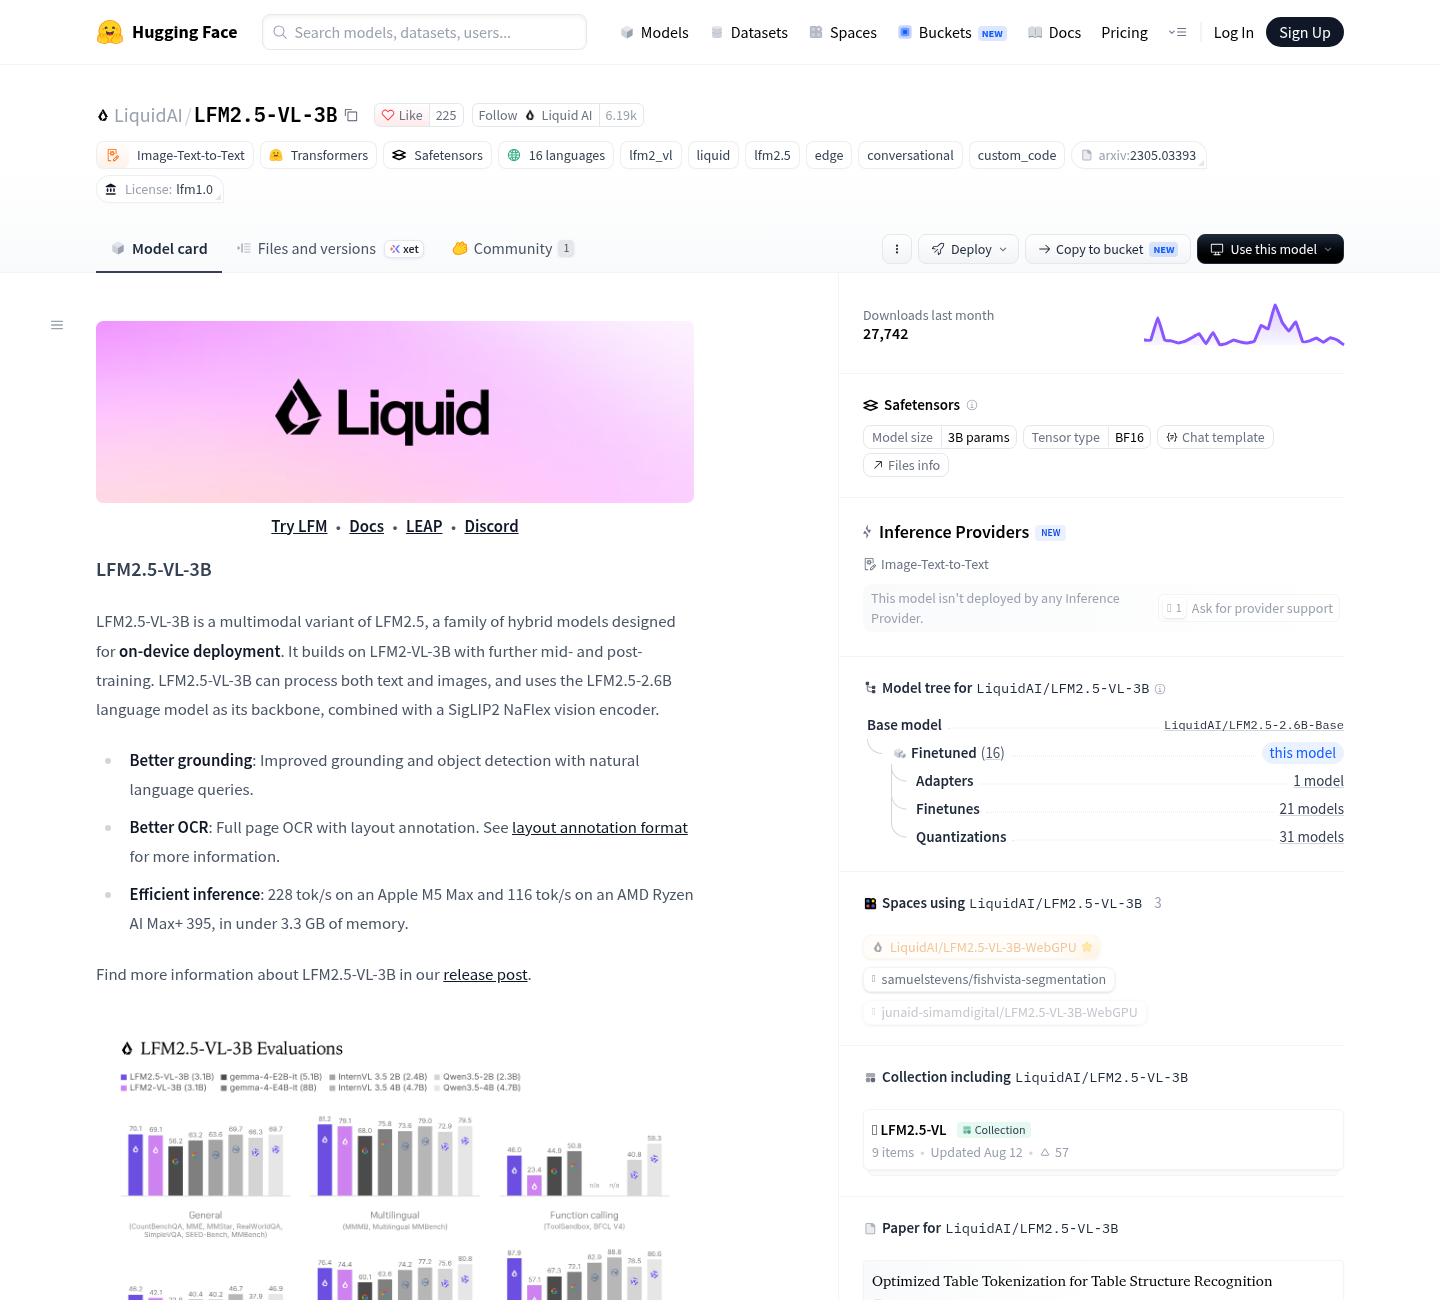
ตัวอย่างที่สะดุดตาคือ MiniCPM-V 4.7 1B ซึ่งมี 1.55 พันล้านพารามิเตอร์ เทียบกับ LFM2.5-VL 3B ที่มี 3.12 พันล้านพารามิเตอร์ ทั้งคู่เป็นโมเดลภาพและภาษาที่ออกแบบมาสำหรับโทรศัพท์และคอมพิวเตอร์ขนาดเล็ก โดยรุ่นแรกถูกอัปโหลดเมื่อวันที่ 6 ตุลาคม 2026 และมีบันทึกเปิดตัววันที่ 12 ตุลาคม ส่วนรุ่นหลังเผยแพร่เมื่อวันที่ 11 สิงหาคม 2026 จุดชวนสนใจไม่ใช่แค่การมีโมเดลเล็กกว่า แต่คือการที่ OpenBMB อ้างว่ารุ่น 1B นำหน้าในงาน OCR การให้เหตุผลจากแผนภูมิ และการเข้าใจวิดีโอ ซึ่งทำให้คำถามเรื่องความคุ้มค่าด้านทรัพยากรมีน้ำหนักขึ้น
คะแนนภาพและเอกสารต้องอ่านพร้อมข้อจำกัด
บน MathVista ซึ่งเป็นชุดทดสอบร่วมที่ทั้งสองฝ่ายรายงาน MiniCPM-V 4.7 1B ได้ 74.3 คะแนน เทียบกับ 68.5 ของ LFM2.5-VL 3B นับเป็นช่องว่าง 5.8 คะแนนตามข้อมูลจากผู้พัฒนา ตัวเลขนี้หนุนข้อสังเกตว่าโมเดลขนาดเล็กอาจทำงานบางอย่างได้ดีเกินคาด แต่ข้ออ้างด้าน OCR ยังเทียบกันตรง ๆ ไม่ได้ เพราะ MiniCPM ใช้ OCRBench ขณะที่ Liquid AI รายงานชุดย่อยภาษาอังกฤษของ OCRBenchv2 ส่วนการเหนือกว่าในการให้เหตุผลจากแผนภูมิและการเข้าใจวิดีโอเป็นข้ออ้างที่ OpenBMB เผยแพร่ โดยอีกฝ่ายไม่ได้ตอบโต้ด้วยผลเทียบชุดเดียวกัน จึงควรอ่านว่าเป็นสัญญาณที่น่าสนใจ ไม่ใช่ข้อสรุปว่าโมเดลหนึ่งชนะทุกงานภาพ
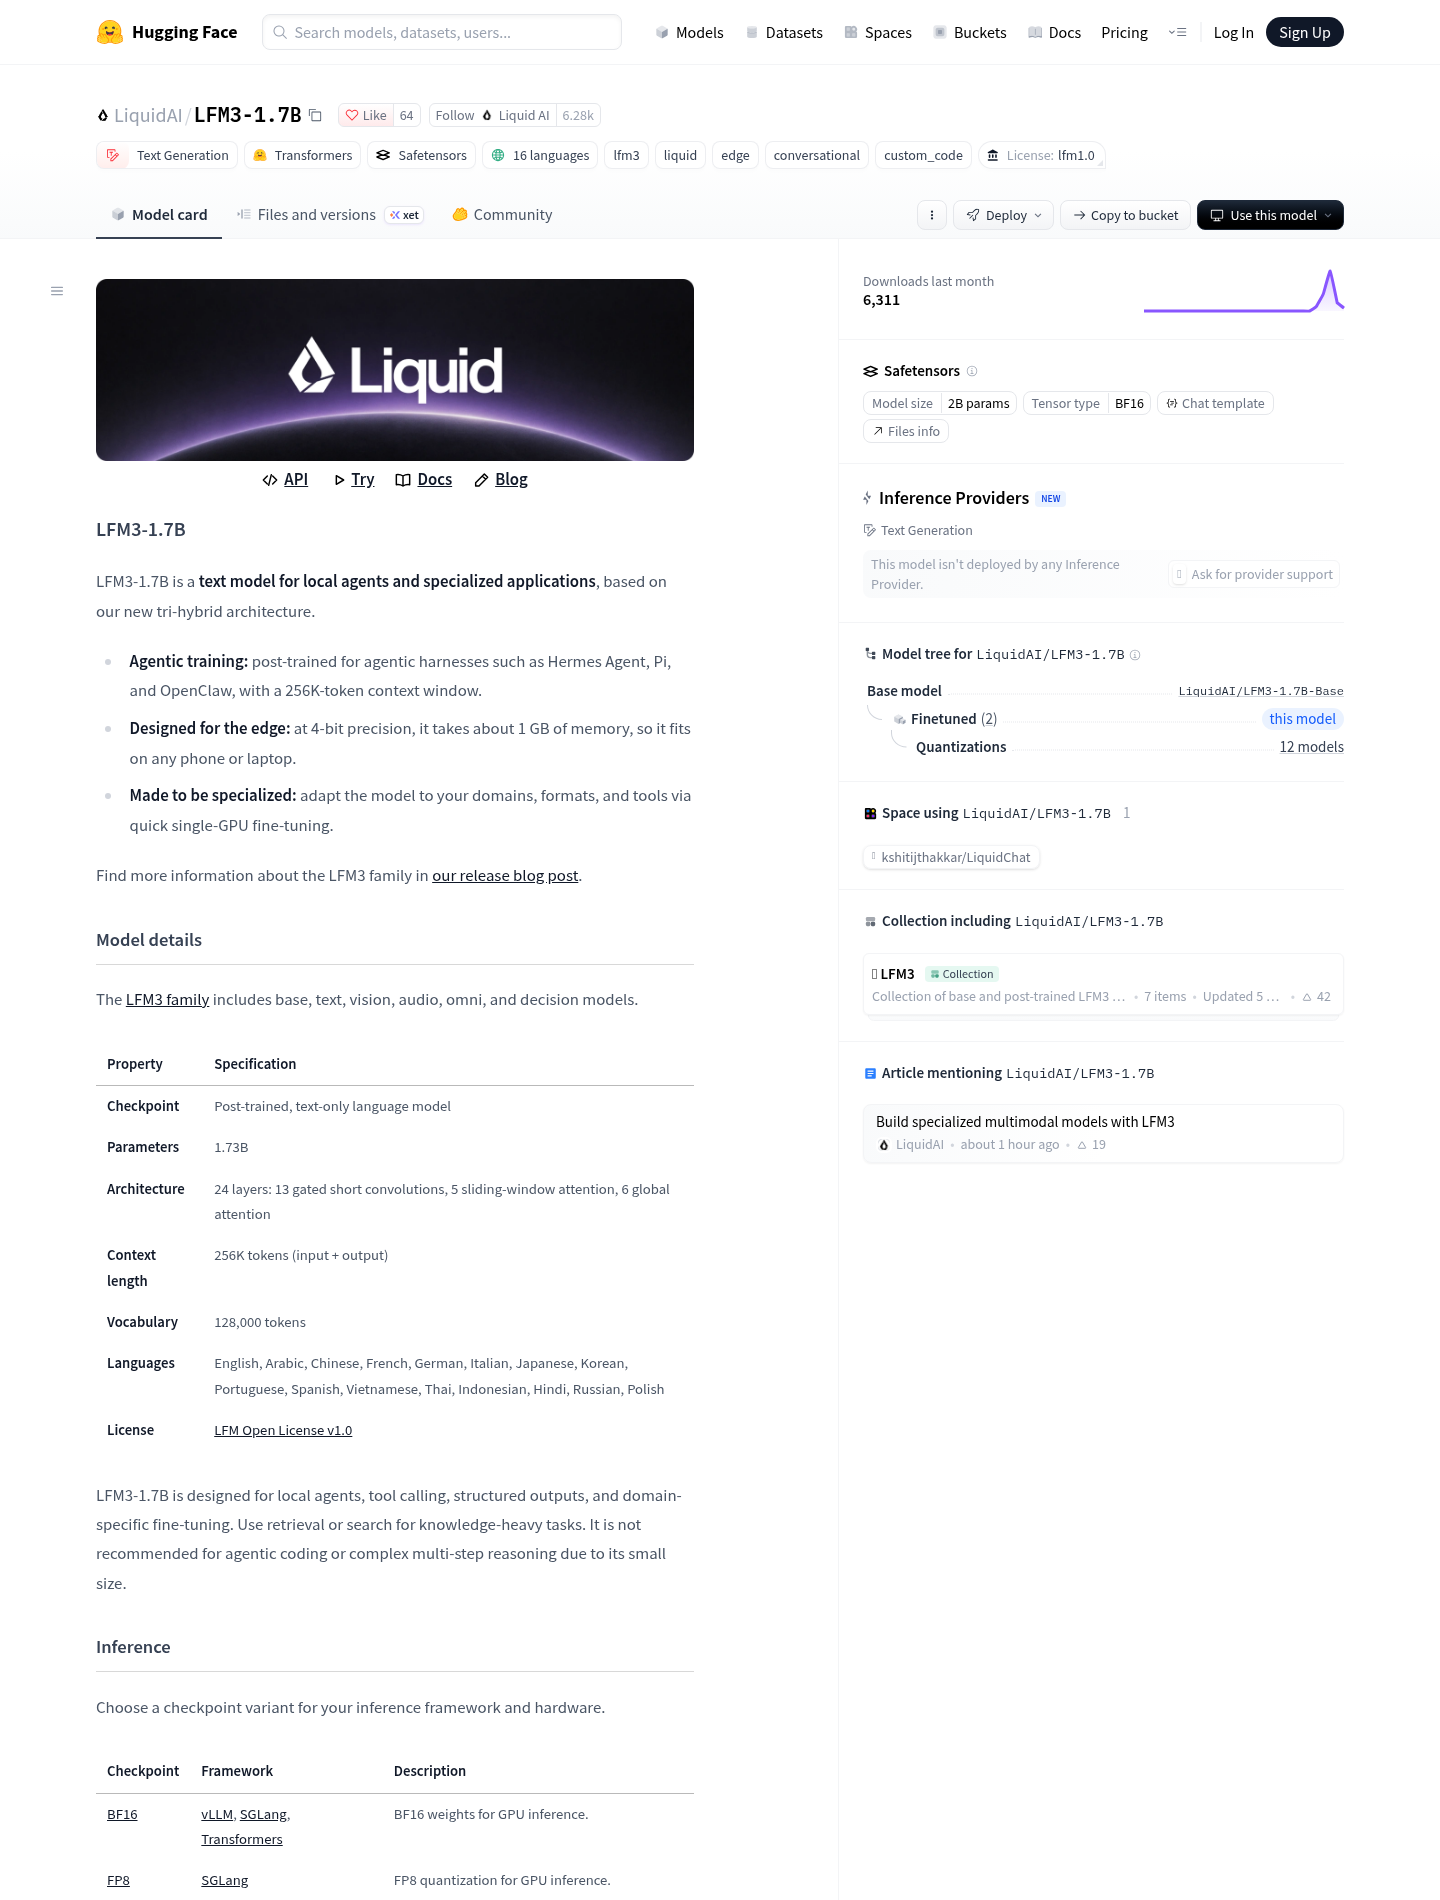
ความต่างด้านขนาดมีผลกับการใช้งานจริงด้วย MiniCPM-V 4.7 1B เมื่อบีบอัดแบบ Q4 พร้อมโปรเจกเตอร์ใช้พื้นที่ประมาณ 1.8 GB สำหรับโมเดลภาษา LFM3-1.7B ระบุการใช้หน่วยความจำราว 1 GB ที่ความละเอียด 4 บิต เทียบกับประมาณ 7 GB สำหรับ Gemma 4 12B บนโทรศัพท์ ช่องว่างนี้อาจเป็นตัวตัดสินว่าแอปทำงานต่อได้หรือถูกระบบปิด โดยเฉพาะอุปกรณ์ระดับกลาง นี่คือข้อได้เปรียบที่จับต้องได้กว่าคำโฆษณาว่าโมเดลเล็กเร็วหรือฉลาดกว่าเสมอ เพราะช่วยเปิดทางให้ประมวลผลบนอุปกรณ์โดยตรง แทนการพึ่งเครื่องที่มีทรัพยากรมากกว่า
งานเขียนโค้ดเผยให้เห็นว่าคะแนนขึ้นกับโจทย์
อีกกรณีที่ควรจับตาคือ LFM3-1.7B เทียบกับ Gemma 4 12B บน LiveCodeBench v6 รุ่นเล็กได้ 73.46 คะแนน ส่วนรุ่นใหญ่ได้ 72.0 แม้ Gemma มีพารามิเตอร์มากกว่าราว 6.9 เท่า แต่ตัวเลขทั้งสองมาจากผู้ขายคนละรายและยังไม่มีผู้ประเมินอิสระทำซ้ำ จึงยังไม่ควรพาดหัวว่าโมเดล 1.7B เอาชนะโมเดล 12B ในงานเขียนโค้ดโดยรวม ที่สำคัญ ทั้งสองไม่ได้เสมอกันทุกด้าน: Gemma 4 12B ทำคะแนน GPQA Diamond ได้ 78.8 ขณะที่ LFM3-1.7B ได้ 63.37 ผลแบบนี้ไม่ขัดแย้งกัน เพราะ LiveCodeBench วัดโจทย์เขียนโปรแกรมแข่งขัน ส่วน GPQA Diamond เน้นความรู้และการให้เหตุผลทางวิทยาศาสตร์
ผลของ LFM3 เมื่อเทียบกับ MiniCPM5 ก็ย้ำว่าต้องดูทั้งชุดทดสอบและรุ่นที่นำมาเทียบ ตารางของ Liquid AI ระบุว่า LFM3-1.7B ที่ผ่านการฝึกหลังการสร้างพื้นฐานชนะ 23 จาก 27 รายการ ส่วน MiniCPM5-2B ชนะ 4 รายการ อย่างไรก็ตาม คะแนนดังกล่าวเป็นข้อมูลที่ผู้พัฒนารายงาน และไม่ควรเหมารวมไปถึงโมเดลฐานที่ไม่มีผลประเมินในตารางเดียวกัน เมื่อดูผลทดสอบคนละชุด คะแนนก็เปรียบเทียบหรือนำมาหักลบกันไม่ได้ นี่คือเหตุผลที่จำนวนพารามิเตอร์ไม่ใช่คำตอบสำเร็จรูป: โมเดลเล็กอาจทำได้ดีในงานที่ตรงกับการฝึก แต่ยังเสียเปรียบเมื่อโจทย์ต้องอาศัยองค์ความรู้กว้างหรือความสามารถอีกแบบ
ทางเลือกที่เหมาะกับอุปกรณ์ปลายทางต้องพิสูจน์ด้วยงานจริง
สำหรับผู้ใช้และนักพัฒนา ประโยชน์ของโมเดล AI ขนาดเล็กไม่ได้จำกัดอยู่ที่คะแนน benchmark แต่รวมถึงการใช้หน่วยความจำต่ำและโอกาสประมวลผลบนโทรศัพท์หรืออุปกรณ์ปลายทางได้สะดวกขึ้น ทว่า AI ประสิทธิภาพสูงไม่ได้หมายถึงโมเดลที่ชนะทุกตาราง หากต้องทำงานหลายขั้นตอนหรือใช้ความรู้เฉพาะทาง ผลทดสอบอีกชุดอาจให้ภาพที่ต่างออกไปด้วยซ้ำ ตัวอย่างเช่นคะแนน RULER 128K ที่ Liquid AI รายงานสำหรับ LFM3-1.7B อยู่ที่ 65.56 ขณะที่ Qwen3.5 9B ได้ 87.11 ซึ่งเป็นความต่างที่ควรตรวจสอบต่อ ไม่ใช่ใช้ตัดสินโมเดลทั้งหมด การเลือกจึงควรยึดงานจริง อุปกรณ์ และข้อจำกัดด้านหน่วยความจำเป็นหลัก
ข้อสรุปที่สมเหตุผลในตอนนี้คือโมเดลขนาดเล็กกำลังทำให้ความสัมพันธ์ระหว่างขนาดกับความสามารถซับซ้อนขึ้น MiniCPM-V และ LFM3 แสดงให้เห็นว่ารุ่นที่ใช้ทรัพยากรน้อยอาจเทียบชั้นรุ่นใหญ่ได้ในงานเฉพาะ แต่ตัวเลขจากผู้พัฒนายังต้องผ่านการทำซ้ำอย่างเป็นอิสระ ก่อนจะใช้ยืนยันประสิทธิภาพในโลกจริง สิ่งที่ควรจับตาต่อไปคือผล LiveCodeBench หรือ SWE-bench ที่บุคคลที่สามทำซ้ำได้ และการประเมินหลายโมเดลบนมาตรวัดเดียวกัน เมื่อหลักฐานเหล่านี้ชัดขึ้น โมเดลเล็กอาจไม่ใช่แค่ตัวเลือกสำหรับอุปกรณ์จำกัด แต่เป็นทางเลือกหลักสำหรับงานที่ต้องการความเร็วและประหยัดทรัพยากร