
Grok Voice 3.0 คืออะไร และเหมาะกับใคร
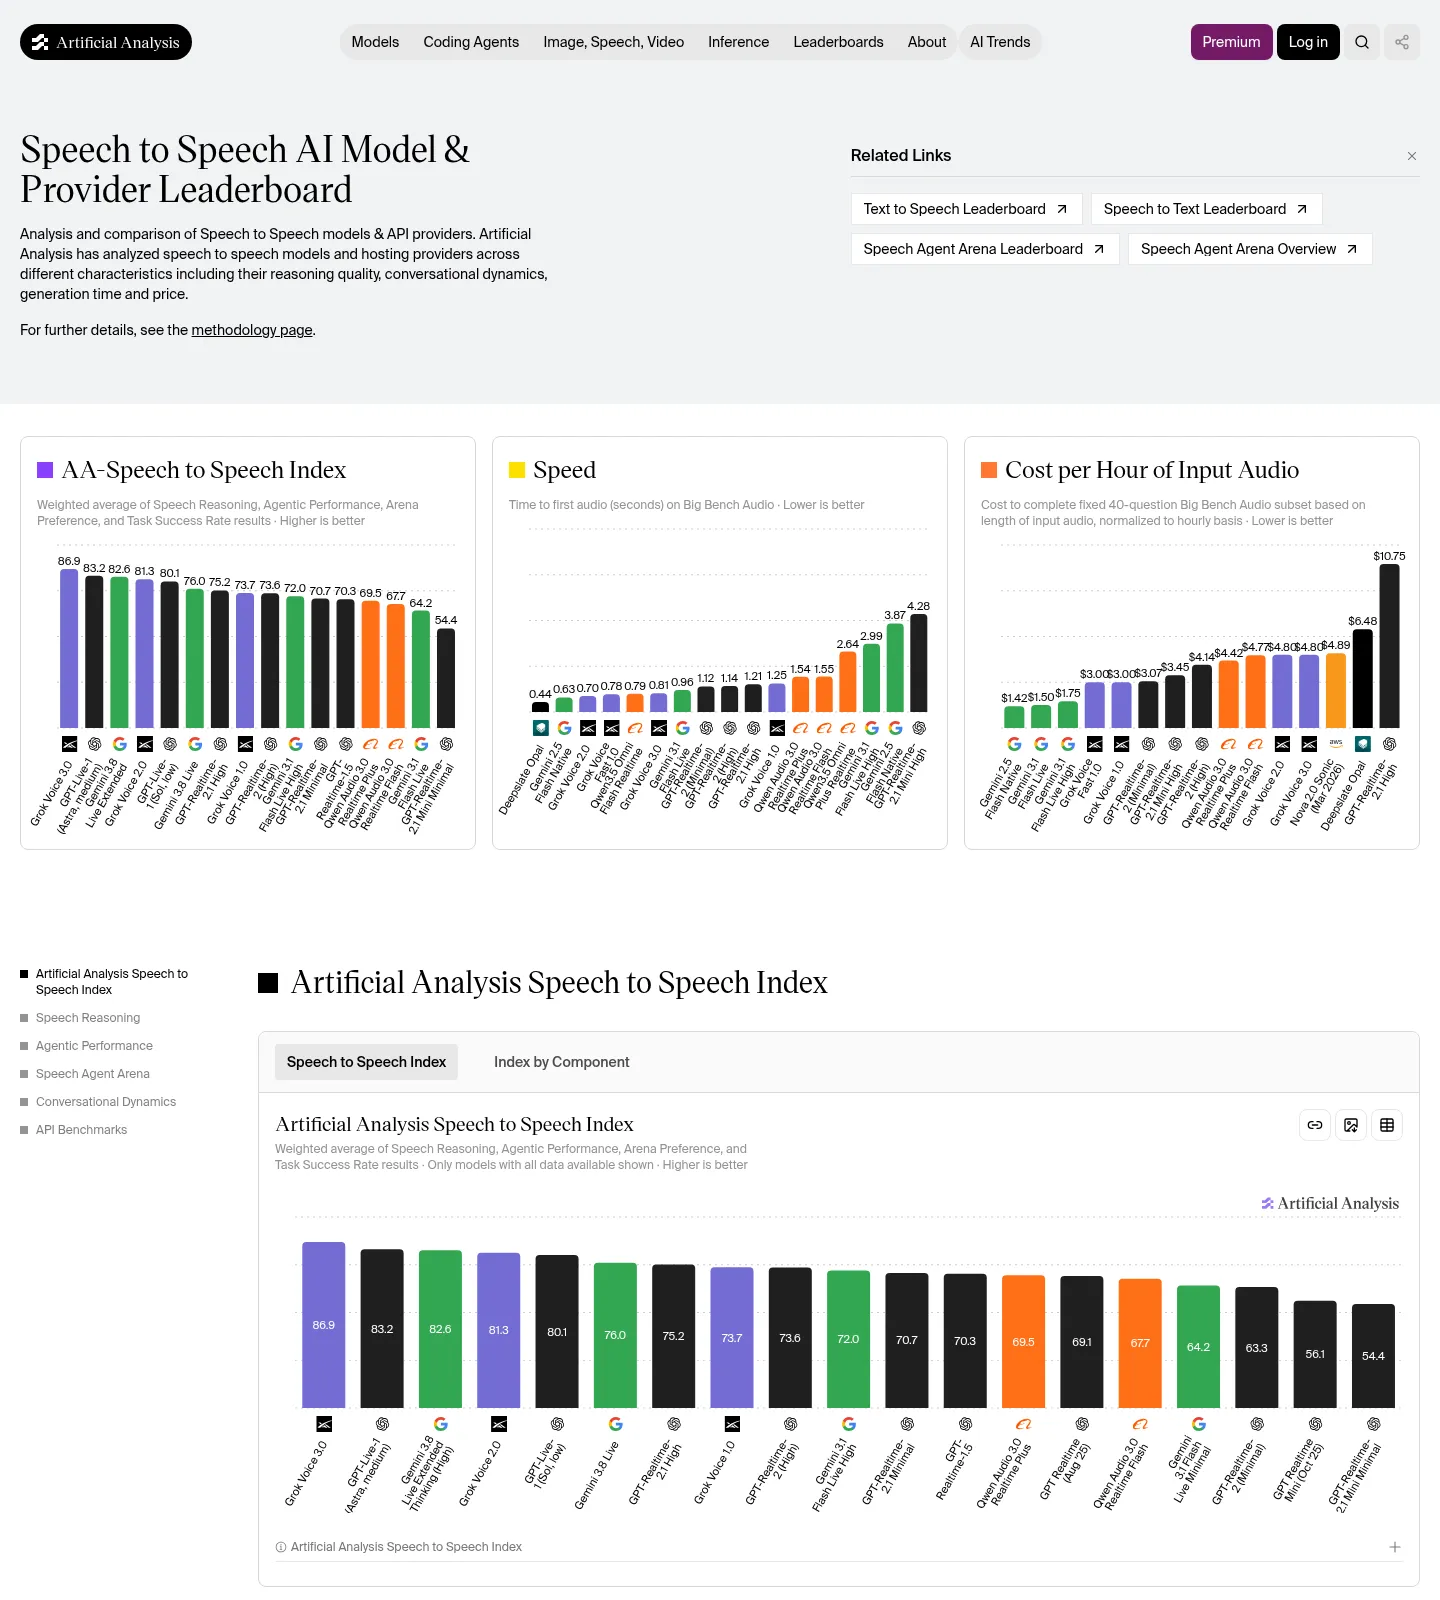
Grok Voice 3.0 คือโมเดลสนทนาด้วยเสียงแบบเรียลไทม์ที่ออกแบบมาให้รับเสียงพูดของผู้ใช้และตอบกลับเป็นเสียงโดยตรงผ่าน API เดียวกันกับรุ่นก่อน เน้นการเป็นเอเจนต์ที่ทำงานหลายขั้นตอนในบทสนทนาได้ดีขึ้น มีความหน่วงต่ำระดับต่ำกว่าหนึ่งวินาที และถูกจัดอันดับบนกระดาน speech to speech index ของ Artificial Analysis ว่าเป็นหนึ่งในโมเดลเสียงแนวหน้าสำหรับงานสนทนาอัตโนมัติด้วยเสียง
ถ้าคุณกำลังคิดจะทำ voice agent API ใช้งานในระบบคอลเซ็นเตอร์ แชตบอตเสียง หรืออินเทอร์เฟซที่ผู้ใช้พูดคุยกับระบบโดยไม่ต้องแตะหน้าจอ Grok Voice 3.0 เป็นตัวเลือกที่น่าลอง เพราะมันใช้ปลายทาง WebSocket แบบเรียลไทม์เดียวกับ Grok Voice 2.0 และไม่ต้องเปลี่ยนวิธีเชื่อมต่อมากนัก จุดที่ต้องคิดคือคุณต้องการความเร็วตอบกลับสูงสุด หรือยอมแลกเวลาเริ่มพูดเพิ่มเล็กน้อยเพื่อได้เอเจนต์ที่ฉลาดขึ้นในงานหลายรอบสนทนา

ขั้นตอนตั้งค่า Grok Voice 3.0 ให้พร้อมคุยด้วยเสียง
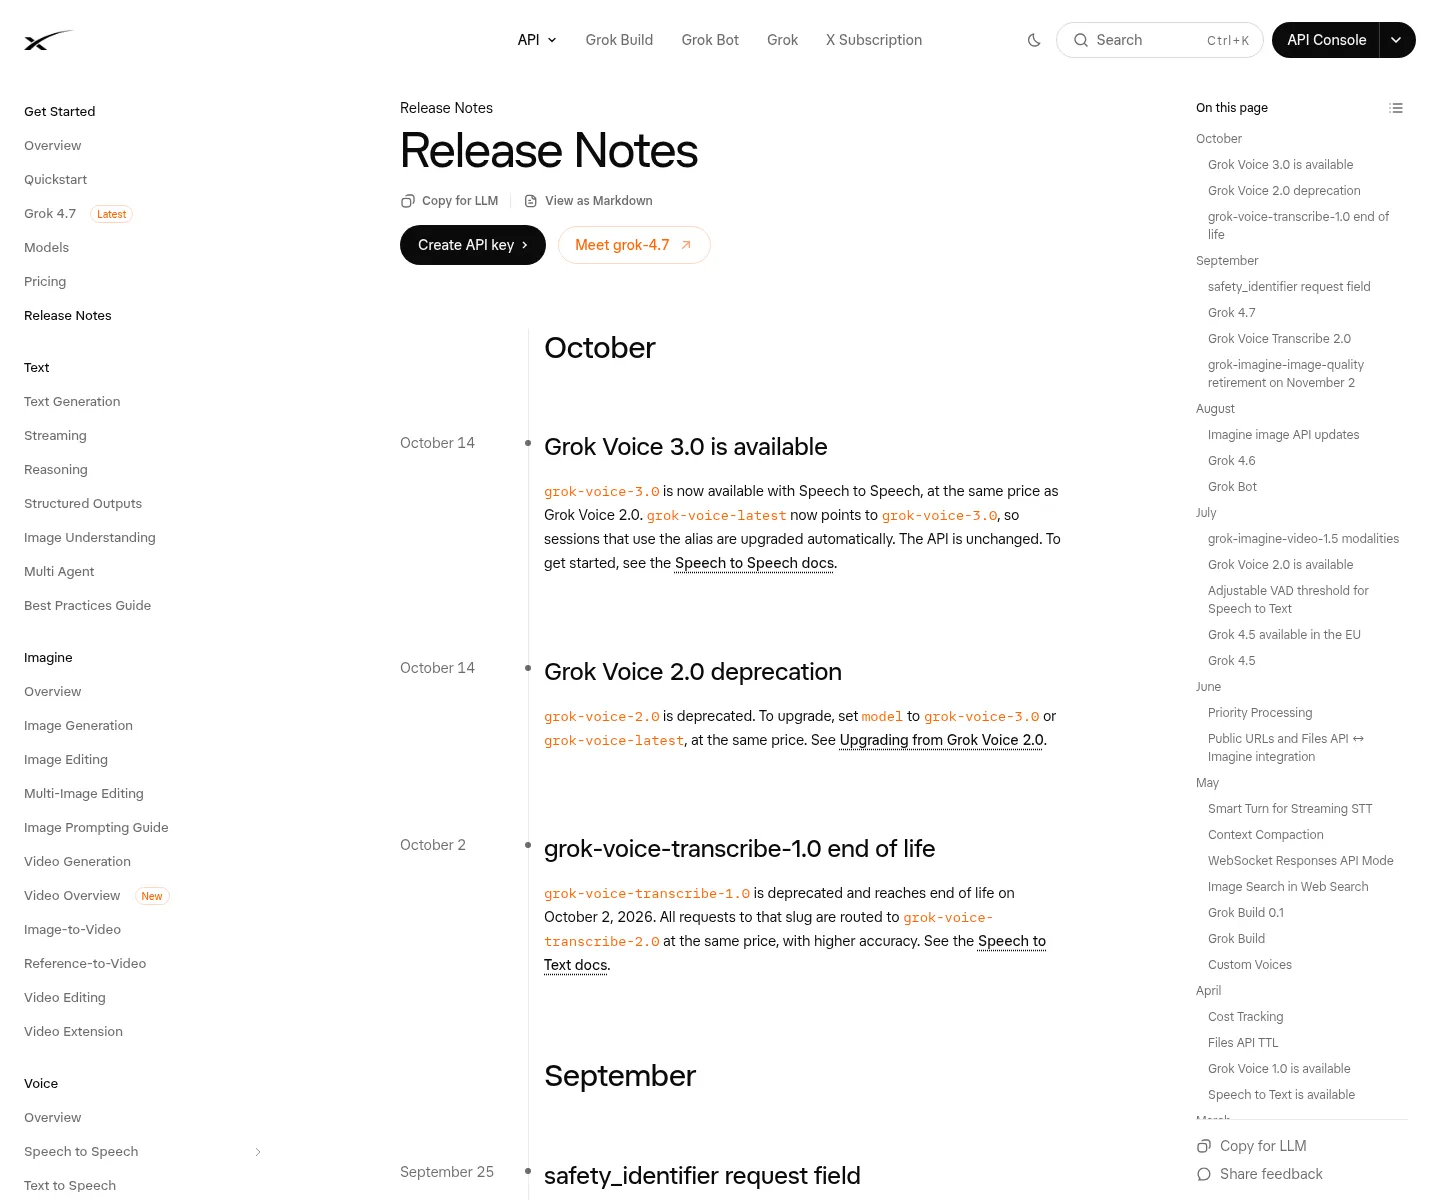
แม้เอกสารของ xAI จะย้ำว่าพื้นผิว API ยังเหมือนเดิม แต่การตั้งค่าให้ Grok Voice 3.0 ทำงานลื่นในระบบของคุณก็ยังมีจุดที่ควรระวัง โดยเฉพาะเรื่อง alias และการทดสอบจังหวะเสียง เพราะ grok-voice-latest ถูกย้ายไปชี้รุ่นใหม่แล้ว ทีมที่เคยใช้ alias นี้อาจถูกอัปเกรดแบบเงียบ ๆ โดยไม่รู้ตัว การทำตามขั้นตอนแบบมีลำดับจะช่วยให้คุณควบคุมการเปลี่ยนผ่านได้มากขึ้น
- ตรวจสอบโค้ดฝั่งเซิร์ฟเวอร์และไคลเอนต์ว่าตั้งค่าฟิลด์ model เป็น grok-voice-latest หรือระบุเป็น grok-voice-2.0 แบบตายตัวอยู่หรือไม่ จากนั้นตัดสินใจก่อนว่าจะใช้ alias ต่อหรือเปลี่ยนไประบุ grok-voice-3.0 โดยตรง
- ทบทวนการตั้งค่าเซสชันบน realtime endpoint ว่าฟิลด์ต่าง ๆ เช่นการเลือกเสียง การตั้งค่าโทเคนชั่วคราว และการยืนยันตัวตนแบบ bearer ยังตรงกับเอกสารรุ่นล่าสุด เนื่องจากเอนด์พอยต์และรูปแบบการจับมือยังไม่เปลี่ยน คุณจึงเน้นตรวจ logic มากกว่าการเปลี่ยน URL
- รันชุดทดสอบเสียงเดิมที่เคยใช้กับ Grok Voice 2.0 โดยเน้นวัดเวลาถึงเสียงแรกและจังหวะการสลับผลัดกันพูด เพื่อดูผลกระทบจากความหน่วงใหม่ของ Grok Voice 3.0 ที่อยู่ราว 0.81 วินาที เทียบกับตัวเลขเดิมของระบบคุณ
- ปรับแต่งการเลือกเสียงสำเร็จรูปหรือเสียงกำหนดเองให้เหมาะกับงาน เช่น สายบริการลูกค้า หรือ voice assistant ในแอป โดยใช้คลิปอ้างอิงเสียงเดิมที่มีอยู่ แล้วตรวจว่าการฝึกเสียงกำหนดเองยังทำงานได้กับโมเดลใหม่ทั้งบน realtime API และ text-to-speech แบบสตรีมมิง
- ทดสอบการใช้งานจริงกับผู้ใช้กลุ่มเล็ก เช่น ทีมซัพพอร์ตหรือผู้ใช้ภายในองค์กร เพื่อเก็บฟีดแบ็กด้านความเป็นธรรมชาติของบทสนทนาและความเร็วตอบกลับ ก่อนขยายไปใช้กับผู้ใช้ปลายทางจำนวนมาก
จุดที่มักพลาดคือการปล่อยให้ alias grok-voice-latest ทำงานต่อโดยไม่รู้ว่ามันถูกย้ายไป Grok Voice 3.0 แล้ว ทำให้ระบบโทรศัพท์ที่มีการทดสอบอิงกับจังหวะเสียงเดิมอาจเปลี่ยนพฤติกรรมโดยไม่ผ่านขั้นตอนรีวิว การตั้งค่าอย่างมีสติและทดสอบกับสายจริงสักระยะจะช่วยให้คุณเห็นว่าการเปลี่ยนโมเดลส่งผลต่อประสบการณ์ผู้ใช้มากน้อยแค่ไหน
AI voice latency เปรียบเทียบ และตัวเลขบน speech to speech index
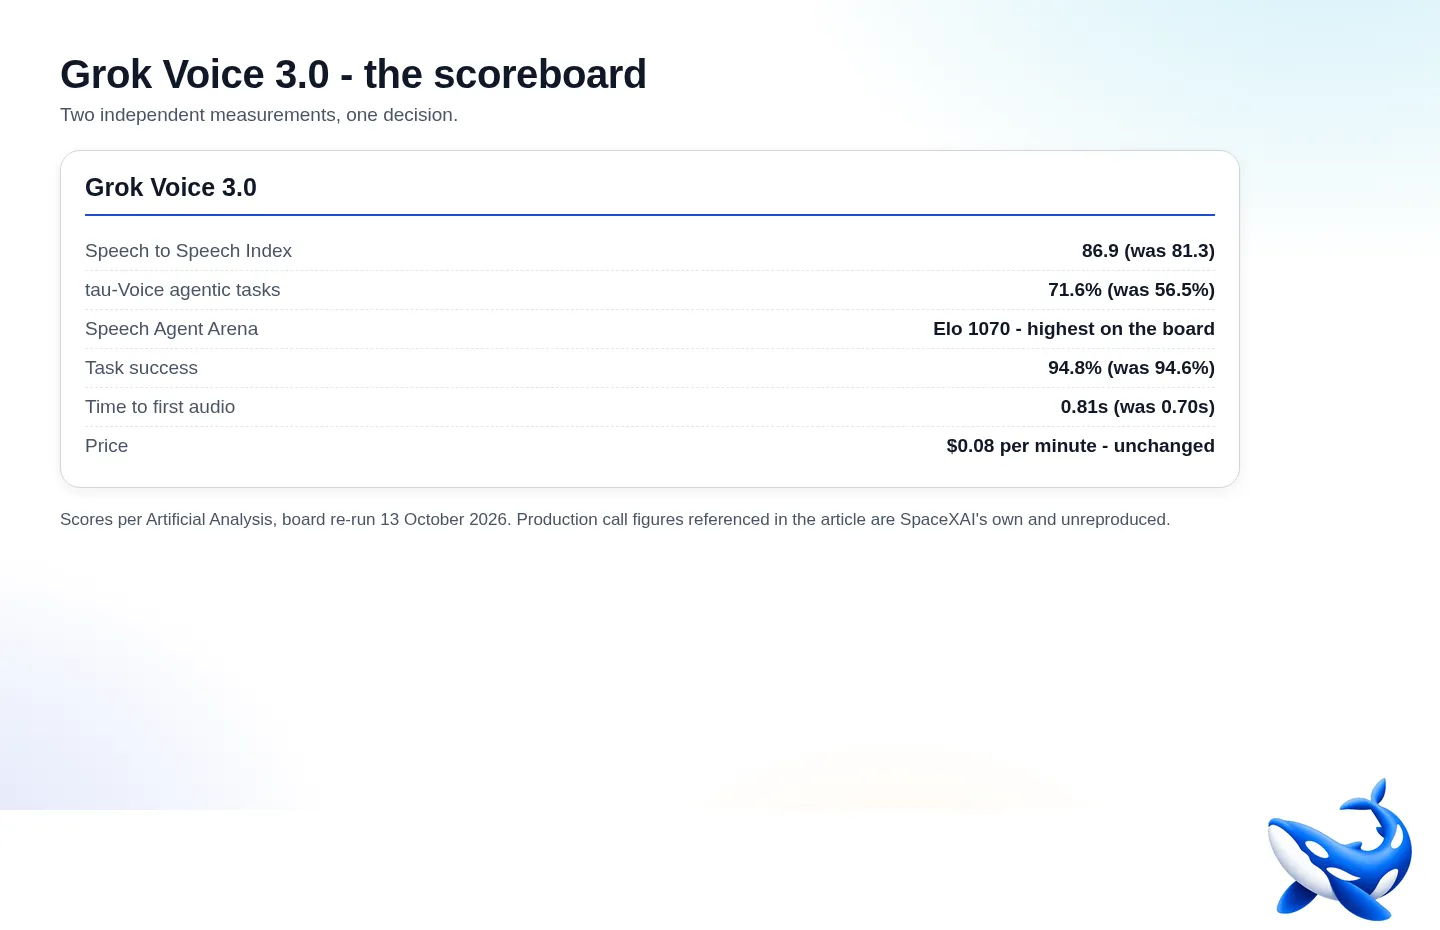
เมื่อพูดถึง AI voice latency เปรียบเทียบ การวัดเวลาตั้งแต่ผู้ใช้พูดจนถึงเสียงตอบกลับแรกคือจุดสำคัญสำหรับประสบการณ์สนทนา Grok Voice 3.0 ใช้เวลาถึงเสียงแรกที่ 0.81 วินาที ซึ่งเร็วกว่า GPT-Live-1 ในคอนฟิก Astra ระดับกลางที่ถูกวัดไว้ที่ 1.34 วินาที แต่ช้ากว่า Grok Voice 2.0 ที่เคยเริ่มพูดภายใน 0.70 วินาทีอยู่เล็กน้อย ตัวเลขเหล่านี้ทำให้เห็นว่ารุ่นใหม่เลือกแลกความเร็วบางส่วนเพื่อคุณภาพเอเจนต์ที่สูงขึ้น
บนกระดาน speech to speech index ของ Artificial Analysis Grok Voice 3.0 ทำคะแนนรวมได้ 86.9 เทียบกับ 81.3 ของ Grok Voice 2.0 และยังนำหน้า GPT-Live-1 และ Gemini 3.8 Live Extended Thinking ตามตัวเลขที่เผยแพร่ การเพิ่มขึ้น 5.6 จุดนี้ไม่ได้มาจากความเร็วตอบกลับ แต่เกิดจากองค์ประกอบด้านประสิทธิภาพแบบเอเจนต์และความชอบของมนุษย์ใน Speech Agent Arena ที่ขยับขึ้นชัดเจน ทำให้มันกลายเป็นโมเดลเสียงที่ถูกจัดว่าเป็นเรือธงบนกระดานทดสอบในปัจจุบัน
| Spec | Grok Voice 3.0 | Grok Voice 2.0 / Think Fast 2.0 |
|---|---|---|
| Speech to Speech Index | 86.9 | 81.3 |
| เวลาเสียงแรก | 0.81 วินาที | 0.70 วินาที |
| τ-Voice งานเอเจนต์ | 71.6% | 56.5% |
| Task success ดิบ | 94.8% | 94.6% |

ควรอัปเกรดจาก Grok Voice Think Fast 2.0 หรือไม่
คำถามใหญ่สำหรับหลายทีมคือควรอัปเกรดจาก Grok Voice Think Fast 2.0 หรือ Grok Voice 2.0 ไป Grok Voice 3.0 หรือไม่ โดยเฉพาะเมื่อ alias grok-voice-latest ถูกย้ายไปแล้วในระบบจำนวนมาก ตามบอร์ดของ Artificial Analysis ประสิทธิภาพแบบเอเจนต์ τ-Voice กระโดดจาก 56.5% ไปเป็น 71.6% ซึ่งห่างกันสิบห้าจุดในงานหลายรอบสนทนา นี่คือความต่างระหว่างเอเจนต์ที่รับมือสายที่เขียนบทไว้ตายตัว กับเอเจนต์ที่รับมือสายที่มีทางแยกและสถานการณ์ซับซ้อนได้ดีขึ้น
ข้อดีของการอัปเกรด
- คุณภาพการทำงานแบบเอเจนต์ดีขึ้นอย่างมีนัยสำคัญในงานหลายขั้นตอนและหลายรอบสนทนา
- คะแนนความชอบใน Speech Agent Arena สูงขึ้น ทำให้บทสนทนาดูเป็นธรรมชาติมากขึ้นสำหรับผู้ใช้
- ไม่ต้องเปลี่ยนเอนด์พอยต์หรือรูปแบบการยืนยันตัวตน ทำให้การย้ายระบบเชิงเทคนิคค่อนข้างตรงไปตรงมา
ข้อควรระวัง
- เวลาเริ่มพูดช้าลงเล็กน้อยจาก 0.70 เป็น 0.81 วินาที ซึ่งอาจมีผลกับระบบที่ต้องการตอบกลับทันที
- ทีมที่พึ่งพาจังหวะเสียงเดิมในชุดทดสอบ regression ต้องรันทดสอบใหม่เพื่อให้แน่ใจว่าระบบยังผ่านเกณฑ์
- หากงานส่วนใหญ่เป็นคำขอแบบเทิร์นเดียวที่ไม่ซับซ้อน ความต่างด้าน task success แทบไม่เห็นในทางปฏิบัติ
สำหรับระบบที่เน้นบทสนทนาสั้น ๆ แบบถามตอบครั้งเดียว การอัปเกรดอาจไม่ให้ผลต่างมากนัก เพราะ task success ดิบของทั้งสองรุ่นอยู่ใกล้กันมาก แต่ถ้าคุณใช้ voice agent API ใช้งานกับสายที่มีหลายขั้นตอน เช่น การแก้ปัญหา การนำทางผู้ใช้ผ่านตัวเลือกหลายทาง หรือการสนทนาที่ยืดเยื้อ การอัปเกรดไป Grok Voice 3.0 มักคุ้มค่า แม้จะต้องยอมรับความหน่วงที่เพิ่มขึ้นเล็กน้อยในช่วงเริ่มบทสนทนา
สรุปการใช้งานจริง และกรอบคิดก่อนอัปเกรด
เมื่อดูภาพรวม Grok Voice 3.0 เป็นการอัปเดตที่เน้นยกระดับความสามารถด้านเอเจนต์และคุณภาพบทสนทนา มากกว่าการลดความหน่วงให้เร็วที่สุด การที่ alias grok-voice-latest ถูกชี้ไปยังรุ่นใหม่ทำให้หลายทีมได้รับการอัปเกรดแบบอัตโนมัติอยู่แล้ว แต่การเข้าใจตัวเลข latency และคะแนนบน speech to speech index จะช่วยให้คุณประเมินได้ว่าระบบของคุณได้สิ่งที่ต้องการหรือไม่
กรอบคิดง่าย ๆ คือ ถ้างานของคุณต้องการให้สายรู้สึกว่าระบบตอบแทบจะทันที และมีการออกแบบสคริปต์คงที่อยู่แล้ว การยึดกับรุ่นที่เร็วกว่าอาจยังมีเหตุผล แต่ถ้าคุณกำลังสร้างเอเจนต์เสียงที่ต้องรับมือสถานการณ์หลากหลาย มีการตัดสินใจหลายขั้นตอน และต้องการให้ผู้ใช้รู้สึกว่าคุยกับผู้ช่วยที่เข้าใจบริบท การอัปเกรดไป Grok Voice 3.0 มักจะคุ้มในระยะยาว สิ่งที่ควรจับตาคือการทดสอบกับสายจริงอย่างต่อเนื่อง เพื่อให้แน่ใจว่าความหน่วงและพฤติกรรมบทสนทนาใหม่สอดคล้องกับประสบการณ์ที่คุณอยากให้ผู้ใช้ได้รับ