
เลือกวิธีให้เหมาะกับเอกสาร
AI ค้นเอกสาร คือการให้โมเดลภาษาค้น อ่าน และสรุปข้อมูลจากไฟล์หรือแหล่งข้อมูลที่เราเลือก แทนการตอบจากความรู้ทั่วไป จึงช่วยหาคำตอบพร้อมย้อนตรวจต้นทางได้ เหมาะกับคนที่มีคู่มือ สัญญา บันทึก หรือเอกสารหลายชิ้น แต่ก่อนเริ่มต้องรู้ว่าไฟล์ที่ส่งเข้าเครื่องมือออนไลน์อาจถูกประมวลผลบนเซิร์ฟเวอร์ของผู้ให้บริการ
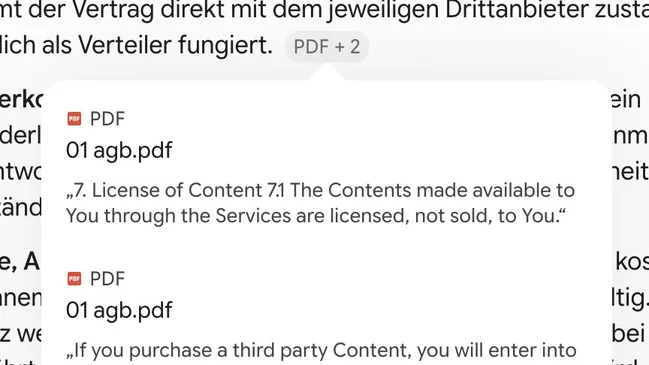
ถ้าต้องการถามเรื่องจากเอกสารไม่กี่ชุด ฟังก์ชันสมุดบันทึกใน Gemini เป็นจุดเริ่มที่ไม่ซับซ้อน เพราะระบบในโหมดนี้อ้างอิงเฉพาะเอกสารที่เพิ่มเข้าไป และแสดงตำแหน่งข้อความที่ใช้ตอบให้ตรวจสอบได้ วิธีนี้เหมาะกับการถามว่าเงื่อนไขในกรมธรรม์อยู่ตรงไหน หรือคู่มือระบุขั้นตอนดูแลเครื่องอย่างไร มากกว่าการคาดหวังให้แชตจำทุกอย่างข้ามครั้ง
ส่วนเอกสารสุขภาพ รายการเดินบัญชี หรือข้อมูลที่ไม่อยากส่งออกจากเครื่อง ควรพิจารณา AI อ่านไฟล์ส่วนตัวด้วยโมเดลที่ทำงานในเครื่อง การรันโมเดลในเครื่องช่วยเรื่องความเป็นส่วนตัว แต่หากโมเดลเปิดอ่านไฟล์ไม่ได้ ประโยชน์ก็ยังไม่ต่างจากแชตบอตทั่วไป ก่อนเลือกจึงควรชั่งน้ำหนักระหว่างความสะดวก การตรวจสอบคำตอบ และความอ่อนไหวของข้อมูล
เริ่มถามคำถามจากเอกสารของตัวเอง
วิธีนี้เหมาะเมื่ออยากได้คำตอบหรือสรุปจากแหล่งข้อมูลชุดหนึ่ง โดยไม่ต้องจัดระบบความรู้ทั้งหมดก่อน เตรียมไฟล์ข้อความ หรือคัดลอกลิงก์และข้อความที่ต้องการใช้เป็นแหล่งอ้างอิง หากเอกสารเป็นข้อมูลลับ ให้หยุดพิจารณาก่อนอัปโหลดและเลือกใช้ระบบในเครื่องแทน
- เปิด gemini.google.com ในเบราว์เซอร์ แล้วเลือกสมุดบันทึกจากเมนูด้านซ้ายและสร้างสมุดบันทึกใหม่
- ตั้งชื่อโปรเจกต์ให้บอกหัวข้อชัดเจน จากนั้นเลือกเพิ่มแหล่งข้อมูล แล้วอัปโหลดไฟล์ข้อความหรือวางลิงก์และข้อความที่ต้องการใช้
- เมื่อเพิ่มแหล่งข้อมูลครบแล้ว ปิดหน้าต่างแหล่งข้อมูล แล้วพิมพ์คำถามเฉพาะเจาะจงในช่องแชต เช่น ขั้นตอนการขจัดคราบตะกรันตามคู่มือ
- ตรวจคำตอบโดยเปิดดูตัวเลขอ้างอิงหรือแหล่งข้อมูลที่แนบมากับคำตอบ แล้วเทียบกับข้อความต้นฉบับก่อนนำไปใช้
หลังจากนั้นใช้การสรุปเอกสารด้วย AI กับงานที่มีขอบเขตชัด เช่น ขอใจความสำคัญของสัญญา หรือรวบรวมวันที่และอาการจากบันทึกหลายฉบับ สิ่งที่ควรระวังคือคำตอบที่อ้างว่ามาจากเอกสารไม่ได้แปลว่าถูกเสมอ จึงควรตรวจข้อความอ้างอิงทุกครั้ง และถามให้ระบุข้อเท็จจริงแยกจากข้อสรุป
เมื่อต้องการให้โมเดลในเครื่องอ่านหลายไฟล์
การแนบไฟล์ทีละชิ้นใช้ได้กับงานเล็ก แต่ถ้าคำถามต้องเทียบข้อมูลข้ามเอกสาร การให้โมเดลเข้าถึงโฟลเดอร์ที่กำหนดไว้จะคล่องกว่า เครื่องมือรันโมเดลอย่าง LM Studio รองรับการแนบเอกสารในแชต ส่วนการเปิดอ่านไฟล์จากโฟลเดอร์สามารถทำผ่านเครื่องมือเชื่อมต่อระบบไฟล์แบบ MCP หรือพื้นที่ทำงาน AI ในเครื่องที่รองรับได้
เมื่อมีทางเข้าถึงไฟล์ โมเดลอาจช่วยหาข้อมูลที่กระจายอยู่หลายฉบับ หรือเรียบเรียงบันทึกส่วนตัวให้อยู่ในรูปสรุปพร้อมใช้ เช่น รวมอาการและวันที่เพื่อเตรียมไปพบแพทย์ การเชื่อมต่อโฟลเดอร์ช่วยให้ค้นทั้งชุดได้โดยไม่ต้องแนบไฟล์ทีละรายการ แต่ให้สิทธิ์เฉพาะโฟลเดอร์ที่จำเป็น และตรวจว่าเครื่องมือไม่ได้ส่งข้อมูลออกไปยังบริการภายนอกโดยไม่ตั้งใจ
ข้อผิดพลาดที่พบบ่อยมีสองอย่าง หนึ่ง ไฟล์ PDF ที่เป็นภาพสแกนอาจไม่มีข้อความให้โมเดลอ่าน ต้องใช้ระบบรู้จำตัวอักษรจากภาพก่อน สอง โมเดลขนาดเล็กบางตัวอาจเดาเนื้อหาแทนการเปิดอ่านไฟล์จริง จึงควรขอให้ระบุชื่อไฟล์และข้อความหลักฐาน พร้อมตรวจเองเมื่อข้อมูลมีผลสำคัญ
จากแชตชั่วคราวสู่ LLM wiki
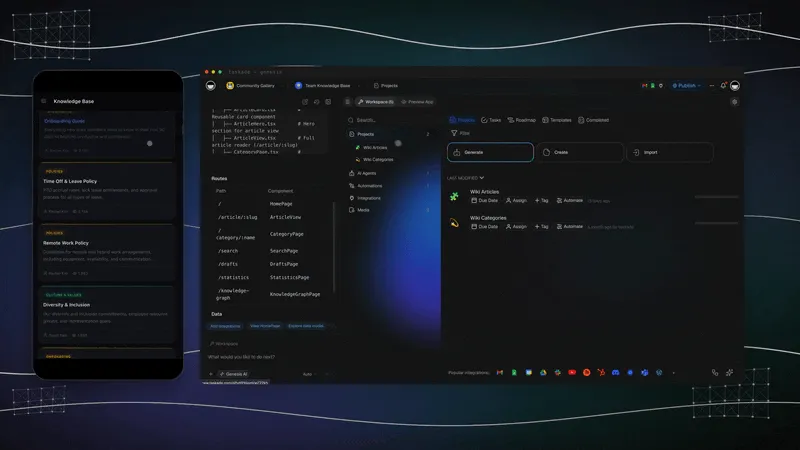
ถ้าต้องค้นข้อมูลเดิมซ้ำและอยากให้คำตอบที่ดีไม่หายไปกับประวัติแชต ค่อยต่อยอดเป็น LLM wiki หรือวิกิความรู้ที่ AI ช่วยดูแล แทนที่จะตอบแล้วจบ โมเดลอ่านแหล่งข้อมูลดิบ เขียนหน้าสรุปเป็นไฟล์ Markdown และเชื่อมหน้าที่เกี่ยวข้องกัน แต่ละหน้าเป็นข้อความธรรมดาพร้อมลิงก์ไปยังหน้าอื่น จึงเปิดอ่านหรือแก้ไขด้วยเครื่องมือทั่วไปได้
โครงสร้างเริ่มต้นมีสามส่วน ได้แก่ แหล่งข้อมูลต้นฉบับที่เก็บไว้โดยไม่แก้ไข วิกิที่มีหน้าสรุปและหน้าหัวข้อ และไฟล์คำสั่งที่กำหนดวิธีตั้งชื่อ เชื่อมโยง และปรับปรุงหน้า เมื่อเพิ่มเอกสารใหม่ AI อ่านเนื้อหา สร้างหรือแก้หน้าที่เกี่ยวข้อง อัปเดตดัชนีและบันทึกการเปลี่ยนแปลง จากนั้นจึงตอบคำถามโดยอ้างอิงหน้าที่อ่าน
จุดสำคัญคือการกำหนดกติกาให้ชัด และตรวจหาข้อมูลล้าสมัย ความขัดแย้ง หรือลิงก์ที่ขาดเป็นระยะ คำตอบเปรียบเทียบที่บันทึกเป็นหน้าไว้ยังกลับมาใช้ต่อได้ภายหลัง ไม่เหมือนคำตอบในแชตที่อาจค้นคืนยาก เริ่มจากการค้นในสมุดบันทึกก่อนก็ได้ หากงานมีแหล่งข้อมูลเพิ่มขึ้นและต้องสะสมคำตอบค่อยทำวิกิ ส่วนข้อมูลอ่อนไหวควรเก็บในระบบที่ควบคุมการเข้าถึงได้