
TPU บน OCI เปลี่ยนภาพคลาวด์สำหรับงาน AI
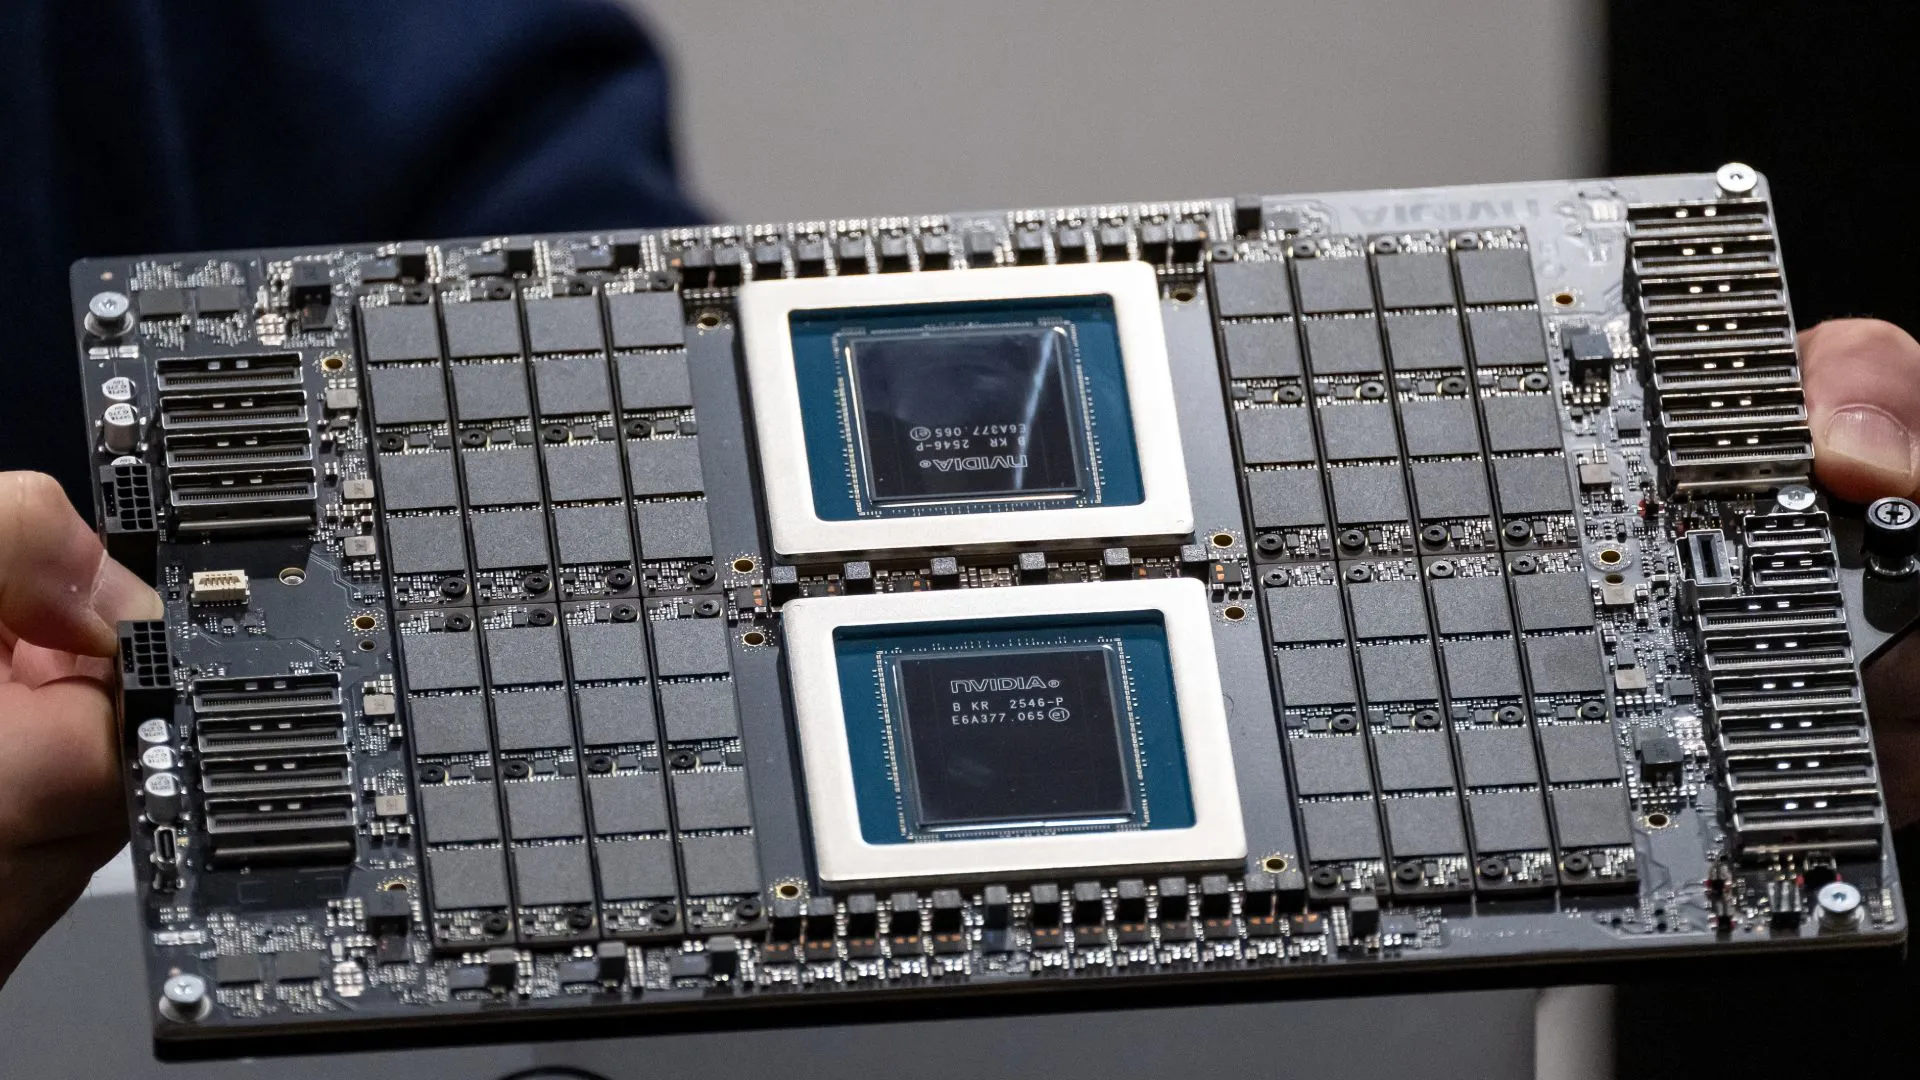
TPU คือหน่วยประมวลผลเฉพาะทางที่ออกแบบมาเพื่อเร่งงานปัญญาประดิษฐ์ โดยมีจุดเด่นด้านประสิทธิภาพแตกต่างจากชิปที่รองรับงานคอมพิวเตอร์ได้หลากหลายประเภท การเพิ่มชิปชนิดนี้ในคลาวด์จึงเปิดทางให้องค์กรจับคู่กำลังประมวลผลกับงาน AI ได้เหมาะขึ้น Oracle และ Google ประกาศเมื่อวันที่ 27 ตุลาคม 2026 ในงาน Oracle AI World ที่ลาสเวกัสว่า TPU ของ Google จะเปิดให้ใช้ผ่าน Oracle Cloud Infrastructure หรือ OCI ในปี 2027 โดย OCI เป็นแพลตฟอร์มคลาวด์ระดับไฮเปอร์สเกลแห่งแรกนอก Google Cloud ที่นำเสนอชิปดังกล่าว นี่ไม่ใช่เพียงการเพิ่มตัวเลือกฮาร์ดแวร์ แต่เป็นสัญญาณว่าการวางแผน enterprise cloud infrastructure กำลังขยับจากการพึ่งพาตัวเร่งประมวลผลชนิดเดียว ไปสู่การเลือกสถาปัตยกรรมให้ตรงกับงานมากขึ้น

เลือกชิปตามงาน แทนการคาดหวังว่าชิปเดียวทำได้ดีที่สุดทุกอย่าง
หัวใจของ AI compute options ที่เพิ่มขึ้นคือความต่างระหว่าง GPU กับ TPU ไม่ใช่การประกาศว่าชิปชนิดหนึ่งชนะทุกกรณี GPU ออกแบบให้รองรับงานคอมพิวเตอร์ได้กว้าง ส่วน TPU เป็นตัวเร่งเฉพาะทางที่อาจให้ประสิทธิภาพและความคุ้มค่าด้านพลังงานต่างกันตามสถาปัตยกรรมโมเดล ลักษณะงาน และชุดซอฟต์แวร์ที่ใช้ ดังนั้นแนวทาง GPU vs TPU selection ควรเริ่มจากคำถามว่าองค์กรกำลังฝึกโมเดลขนาดใหญ่ หรือให้บริการอนุมานจำนวนมาก และซอฟต์แวร์ที่ใช้อยู่เข้ากับตัวเร่งชนิดใด การประกาศของทั้งสองบริษัทระบุว่าลูกค้าจะเลือก TPU บน OCI ให้สอดคล้องกับเวิร์กโหลด ข้อกำหนดด้านประสิทธิภาพ และเป้าหมายด้านต้นทุนได้ ทางเลือกที่เพิ่มขึ้นมีความหมายก็ต่อเมื่อทีมทดสอบงานจริงและวัดผลทั้งความเร็ว การใช้พลังงาน และความยุ่งยากในการดูแลระบบ ไม่ใช่ตัดสินจากชื่อชิปเพียงอย่างเดียว
ต้นทุนการอนุมานทำให้ตัวเลือกใหม่มีความสำคัญ
เหตุผลที่การเพิ่ม TPU เกิดขึ้นในเวลานี้ชัดเจนขึ้นเมื่อมองภาระงานจริง องค์กรต้องรับมือทั้งต้นทุนที่สูงขึ้นและความต้องการโครงสร้างพื้นฐานสำหรับฝึกโมเดลขนาดใหญ่ ตลอดจนการอนุมานในระดับใช้งานจริง สเตฟานี วอลเตอร์ ผู้นำด้าน AI stack จาก HyperFrame Research ชี้ว่าการอนุมานเป็นภาระประจำวัน เพราะทุกครั้งที่พนักงานใช้ผู้ช่วย AI หรือเอเจนต์เรียกโมเดลก็ใช้กำลังประมวลผล ประเด็นนี้กระทบผู้ใช้ทั่วไปในองค์กรโดยตรง ตั้งแต่เวลาตอบสนองของผู้ช่วย ไปจนถึงความสามารถในการรองรับคำขอพร้อมกันจำนวนมาก หาก TPU เหมาะกับโมเดลและซอฟต์แวร์ที่องค์กรใช้ ก็อาจเป็นอีกทางเลือกสำหรับงานอนุมานที่กินทรัพยากรต่อเนื่อง ขณะเดียวกัน TPU ยังรองรับการฝึกและการฝึกต่อยอดโมเดล รวมถึงโมเดลแบบหนาแน่นและแบบผสมผู้เชี่ยวชาญตามข้อมูลที่บริษัทประกาศ การเพิ่มตัวเลือกจึงตอบโจทย์ความต้องการด้านกำลังประมวลผลที่โตขึ้น มากกว่าจะเป็นเพียงข่าวเปิดตัวชิปใหม่
ตัวเลขประสิทธิภาพน่าสนใจ แต่ต้องพิสูจน์กับงานขององค์กร
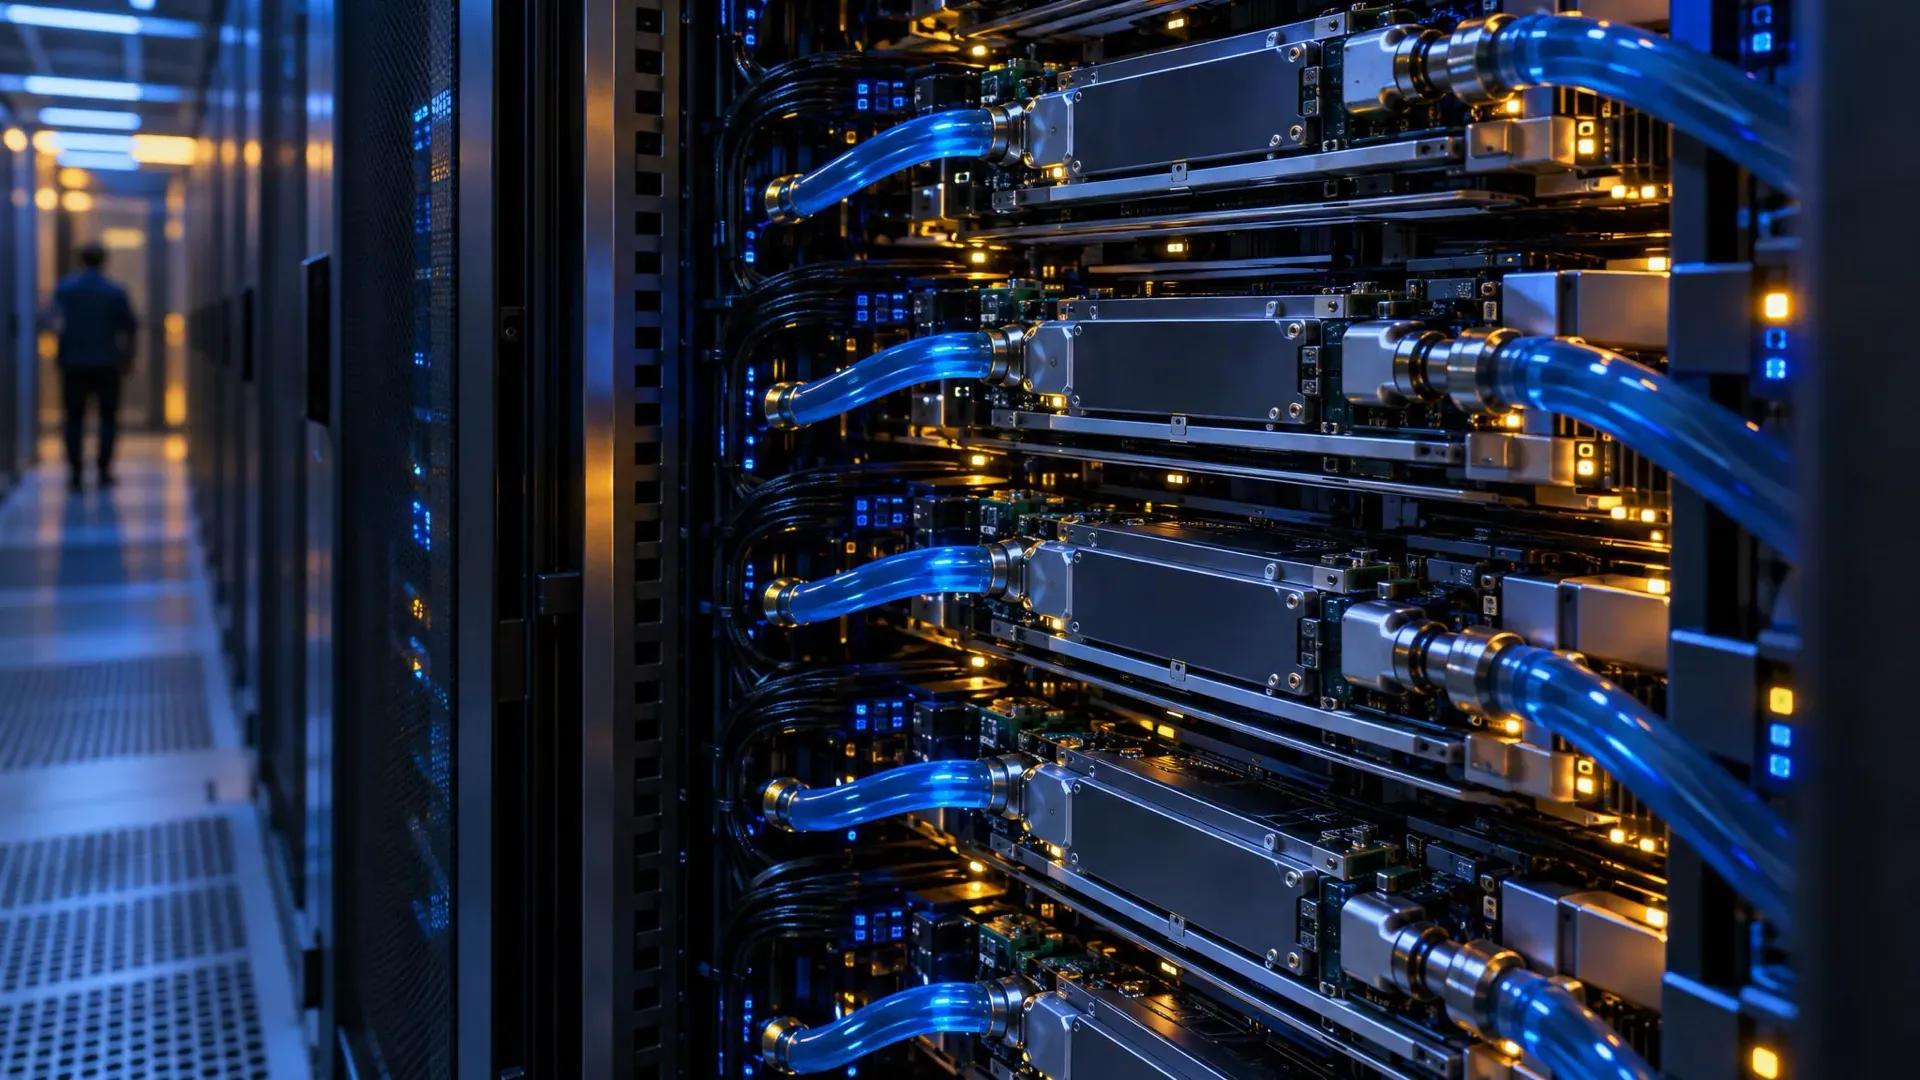
ข้อมูลของ TPU รุ่นที่ 8 แสดงให้เห็นว่าการออกแบบเฉพาะงานอาจเปลี่ยนขีดจำกัดของการฝึกโมเดลได้ โดย TPU 8t ซึ่งออกแบบมาสำหรับงานฝึก มีประสิทธิภาพการประมวลผลต่อพ็อดสูงกว่ารุ่นก่อนเกือบ 3 เท่า และบริษัทระบุว่าอาจลดเวลาพัฒนาโมเดลแนวหน้าจากหลายเดือนเหลือหลายสัปดาห์ ตัวเลขนี้น่าจับตา แต่ยังไม่ใช่คำตอบสำหรับทุกองค์กร เพราะผลลัพธ์จริงขึ้นกับเวิร์กโหลด ซอฟต์แวร์ และการออกแบบระบบโดยรวม OCI จะจัดหาพลังงาน ระบบระบายความร้อน และเครือข่ายดาต้าเซ็นเตอร์เพื่อรองรับการติดตั้ง TPU ในระดับขนาดใหญ่ นี่คือทิศทางที่ควรจับตา: องค์กรกำลังมองหาตัวเร่งประมวลผลหลายแบบเพื่อรองรับ AI ทั้งการฝึกและการใช้งานจริง แทนการยึดติดกับสมมติฐานว่ามีชิปชนิดเดียวเหมาะกับทุกงาน ข้อสรุปของดีลนี้จึงไม่ใช่ให้ทุกทีมรีบเปลี่ยนระบบ แต่คือวางแผนประเมินทางเลือกให้เป็นส่วนหนึ่งของกลยุทธ์คลาวด์